
SUR CETTE PAGE
Exemple : Configuration d’homologues EBGP à saut unique pour accepter des sauts suivants distants
Exemple : équilibrage de charge du trafic BGP avec une bande passante inégale allouée aux chemins
Comprendre la publication de plusieurs chemins vers une destination unique dans BGP
Configuration de la résolution récursive sur multichemin BGP
Configuration des prochains sauts ECMP pour les LSP RSVP et LDP pour l’équilibrage de charge
Configuration d’un équilibrage de charge cohérent pour les groupes ECMP
Améliorer la résilience du réseau en utilisant plusieurs homologues ECMP BGP
Comprendre l’étiquette d’entropie pour les LSP unicast étiquetés BGP
Configurer une étiquette d’entropie pour un LSP unicast étiqueté BGP
Exemple : Configuration d’une étiquette d’entropie pour un LSP unicast étiqueté BGP
Cas d’utilisation de la convergence indépendante du préfixe BGP pour Inet, inet6 ou unicast étiqueté
Configuration de la convergence indépendante du préfixe BGP pour Inet
Exemple : Configuration de la convergence indépendante du préfixe BGP pour Inet
Présentation de la périphérie PIC BGP utilisant l’unicast étiqueté BGP
Configuration de BGP PIC Edge à l’aide d’une unicast étiquetée BGP pour les services de couche 2
Exemple : Protection du trafic IPv4 sur un VPN de couche 3 exécutant un unicast étiqueté BGP
Prise en charge de FAT Pseudowire pour BGP, L2VPN et VPLS Présentation
Équilibrage de charge pour une session BGP
Comprendre le multichemin BGP
BGP Multichemin vous permet d’installer plusieurs chemins BGP internes et plusieurs chemins BGP externes vers la table de transfert. La sélection de plusieurs chemins permet à BGP d’équilibrer la charge du trafic sur plusieurs liaisons.
Un chemin est considéré comme un chemin à coût égal BGP (et est utilisé pour le transfert) si le processus de sélection du chemin BGP effectue un départage après comparaison du coût IGP au saut suivant. Par défaut, tous les chemins avec le même AS voisin, appris par un voisin BGP compatible avec les chemins multiples, sont pris en compte dans le processus de sélection des chemins multiples.
En règle générale, le BGP ne sélectionne qu’un seul meilleur chemin pour chaque préfixe et installe cette route dans la table de transfert. Lorsque le multichemin BGP est activé, l’équipement sélectionne plusieurs chemins BGP à coût égal pour atteindre une destination donnée, et tous ces chemins sont installés dans la table de transfert. BGP annonce uniquement le chemin actif à ses voisins, sauf si add-path est utilisé.
La fonction multichemin BGP de Junos OS prend en charge les applications suivantes :
Équilibrage de charge sur plusieurs liaisons entre deux équipements de routage appartenant à des systèmes autonomes (AS) différents
Équilibrage de charge sur un ou plusieurs sous-réseaux communs vers différents périphériques de routage appartenant au même homologue AS
Équilibrage de charge sur plusieurs liaisons entre deux équipements de routage appartenant à des homologues de confédération externes différents
Équilibrage de charge sur un ou plusieurs sous-réseaux communs vers différents équipements de routage appartenant à des homologues de confédération externes
Dans un scénario courant d’équilibrage de charge, un client est multihébergé sur plusieurs routeurs ou commutateurs dans un point de présence (POP). Le comportement par défaut consiste à envoyer tout le trafic sur une seule des liaisons disponibles. Avec l’équilibrage de charge, le trafic utilise au moins deux liaisons.
Le multichemin BGP ne s’applique pas aux chemins qui partagent le même coût MED-plus-IGP, mais dont le coût IGP diffère. La sélection des chemins multichemins est basée sur la métrique de coût IGP, même si deux chemins ont le même coût MED-plus-IGP.
À partir de la version 18.1R1 de Junos OS, le multichemin BGP est pris en charge globalement au [edit protocols bgp] niveau de la hiérarchie. Vous pouvez désactiver sélectivement le multichemin sur certains groupes BGP et voisins. Inclure disable au [edit protocols bgp group group-name multipath] niveau de la hiérarchie pour désactiver l’option multichemin pour un groupe ou un voisin BGP spécifique.
À partir de la version 18.1R1 de Junos OS, vous pouvez différer le calcul des chemins multichemins jusqu’à ce que toutes les routes BGP soient reçues. Lorsque le routage multichemin est activé, BGP insère l’itinéraire dans la file d’attente à chemins multiples chaque fois qu’un nouvel itinéraire est ajouté ou chaque fois qu’un itinéraire existant change. Lorsque plusieurs chemins sont reçus via la fonctionnalité d’add-path de BGP, BGP peut calculer plusieurs fois un chemin multichemin. Le calcul par trajets multiples ralentit le taux d’apprentissage RIB (également appelé table de routage). Pour accélérer l’apprentissage RIB, le calcul des chemins multiples peut être différé jusqu’à ce que les routes BGP soient reçues, ou vous pouvez abaisser la priorité du travail de génération de chemins multichemins selon vos besoins jusqu’à ce que les routes BGP soient résolues. Pour différer le calcul du chemin multichemin, configurez defer-initial-multipath-build au [edit protocols bgp] niveau de la hiérarchie. Vous pouvez également réduire la priorité de la tâche de construction BGP multichemin à l’aide d’une multipath-build-priority instruction de configuration au [edit protocols bgp] niveau de la hiérarchie pour accélérer l’apprentissage RIB.
Voir aussi
Exemple : équilibrage de charge du trafic BGP
Cet exemple montre comment configurer BGP pour sélectionner plusieurs chemins EBGP (Equal-Cost External BGP) ou IBGP (Internal BGP) comme chemins actifs.
Exigences
Avant de commencer :
Configurez les interfaces des appareils.
Configurez un Interior Gateway Protocol (IGP).
Configurez BGP.
Configurez une politique de routage qui exporte les routes (telles que les routes directes ou les routes IGP) de la table de routage vers BGP.
Vue d’ensemble
Les étapes suivantes montrent comment configurer l’équilibrage de charge par paquet :
Définir une politique de routage d’équilibrage de charge en incluant une ou plusieurs
policy-statementinstructions au niveau de la[edit policy-options]hiérarchie, définissant une action deload-balance per-packet:policy-statement policy-name { from { match-conditions; route-filter destination-prefix match-type <actions>; prefix-list name; } then { load-balance per-packet; } }Remarque :Pour permettre l’équilibrage de charge entre plusieurs chemins EBGP et plusieurs chemins IBGP , incluez l’instruction
multipathglobalement au niveau de la[edit protocols bgp]hiérarchie. Vous ne pouvez pas activer l’équilibrage de charge du trafic BGP sans inclure l’instructionmultipathglobalement, ou pour un groupe BGP au niveau de la[edit protocols bgp group group-namehiérarchie, ou pour des voisins BGP spécifiques au niveau de la[edit protocols bgp group group-name neighbor address]hiérarchie.Appliquez la stratégie aux routes exportées de la table de routage vers la table de transfert. Pour ce faire, incluez les
forwarding-tableinstructions etexport:forwarding-table { export policy-name; }
Vous ne pouvez pas appliquer la stratégie d’exportation aux instances de routage VRF.
Spécifiez tous les sauts suivants de cet itinéraire, s’il en existe plusieurs, lors de l’attribution d’une étiquette correspondant à un itinéraire annoncé.
Configurez la clé de hachage forwarding-options pour MPLS afin d’inclure la charge utile IP.
Sur certaines plates-formes, vous pouvez augmenter le nombre de chemins équilibrés en charge à l’aide de l’instruction chassis maximum-ecmp .
Avec cette instruction, vous pouvez modifier le nombre maximal de chemins à charge équilibrée à coût égal par 32, 64, 128, 256 ou 512 (le nombre maximal varie selon la plate-forme - voir maximum-ecmp).
La fonctionnalité de multichemin est prise en charge sur toutes les plates-formes qui prennent en charge BGP. Certaines améliorations ont été apportées aux plateformes QFX :
-
- À partir de la version 19.1R1 de Junos OS, vous pouvez spécifier un nombre maximum de 128 chemins à coût égal sur les commutateurs QFX10000.
-
- À partir de la version 19.2R1 de Junos OS, vous pouvez spécifier un nombre maximum de 512 chemins à coût égal sur les commutateurs QFX10000 (voir Présentation de la configuration de 512 chemins à coût égal maximum avec équilibrage de charge cohérent en option).
Dans cet exemple, l’appareil R1 se trouve dans l’AS 64500 et est connecté à l’appareil R2 et à l’appareil R3, qui sont dans l’AS 64501. Cet exemple montre la configuration sur l’appareil R1.
Topologie
La figure 1 illustre la topologie utilisée dans cet exemple.
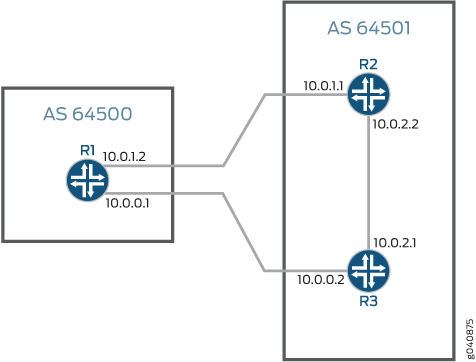 de charge BGP
La configuration
Procédure
Configuration rapide de la CLI
Pour configurer rapidement cet exemple, copiez les commandes suivantes, collez-les dans un fichier texte, supprimez les sauts de ligne, modifiez tous les détails nécessaires pour qu’ils correspondent à votre configuration réseau, puis copiez-collez les commandes dans le CLI au niveau de la [edit] hiérarchie.
set protocols bgp group external type external
set protocols bgp group external peer-as 64501
set protocols bgp group external multipath
set protocols bgp group external neighbor 10.0.1.1
set protocols bgp group external neighbor 10.0.0.2
set policy-options policy-statement loadbal from route-filter 10.0.0.0/16 orlonger
set policy-options policy-statement loadbal then load-balance per-packet
set routing-options forwarding-table export loadbal
set routing-options autonomous-system 64500
Procédure étape par étape
L’exemple suivant nécessite que vous naviguiez à différents niveaux dans la hiérarchie de configuration. Pour plus d’informations sur la navigation dans la CLI, reportez-vous à la section Utilisation de l’éditeur CLI en mode configuration dans le Guide de l’utilisateur de la CLI de Junos OS.
Pour configurer les sessions d’pair BGP :
Configurez le groupe BGP.
[edit protocols bgp group external]
user@R1# set type external
user@R1# set peer-as 64501
user@R1# set neighbor 10.0.1.1
user@R1# set neighbor 10.0.0.2
Activez le groupe BGP pour utiliser plusieurs chemins.
Remarque :Pour désactiver la vérification par défaut exigeant que les chemins acceptés par le multichemin BGP aient le même système autonome voisin (AS), incluez l’option
multiple-as.[edit protocols bgp group external] user@R1# set multipath
Configurez la stratégie d’équilibrage de charge.
[edit policy-options policy-statement loadbal]
user@R1# set from route-filter 10.0.0.0/16 orlonger
user@R1# set then load-balance per-packet
Appliquez la politique d’équilibrage de charge.
[edit routing-options]
user@R1# set forwarding-table export loadbal
Configurez le numéro du système autonome local (AS).
[edit routing-options]
user@R1# set autonomous-system 64500
Résultats
En mode configuration, confirmez votre configuration en entrant les show protocolscommandes , show policy-optionset . show routing-options Si la sortie n’affiche pas la configuration prévue, répétez les instructions de cet exemple pour corriger la configuration.
[edit]
user@R1# show protocols
bgp {
    group external {
        type external;
        peer-as 64501;
        multipath;
        neighbor 10.0.1.1;
        neighbor 10.0.0.2;
    }
}
[edit]
user@R1# show policy-options
policy-statement loadbal {
    from {
        route-filter 10.0.0.0/16 orlonger;
    }
    then {
        load-balance per-packet;
    }
}
[edit]
user@R1# show routing-options
autonomous-system 64500;
forwarding-table {
    export loadbal;
}
Si vous avez terminé de configurer l’appareil, entrez en commit mode configuration.
Vérification
Confirmez que la configuration fonctionne correctement :
Vérification des routes
Objet
Vérifiez que les routes sont apprises à partir des deux routeurs de l’AS voisin.
Mesures à prendre
À partir du mode opérationnel, exécutez la show route commande.
user@R1> show route 10.0.2.0
inet.0: 12 destinations, 15 routes (12 active, 0 holddown, 0 hidden)
+ = Active Route, - = Last Active, * = Both

10.0.2.0/30        *[BGP/170] 03:12:32, localpref 100
                      AS path: 64501 I
                      to 10.0.1.1 via ge-1/2/0.0
                    > to 10.0.0.2 via ge-1/2/1.0
                    [BGP/170] 03:12:32, localpref 100
                      AS path: 64501 I
                    > to 10.0.1.1 via ge-1/2/0.0
user@R1> show route 10.0.2.0 detail
inet.0: 12 destinations, 15 routes (12 active, 0 holddown, 0 hidden)
10.0.2.0/30 (2 entries, 1 announced)
        *BGP    Preference: 170/-101
                Next hop type: Router, Next hop index: 262142
                Next-hop reference count: 3
                Source: 10.0.0.2
                Next hop: 10.0.1.1 via ge-1/2/0.0
                Next hop: 10.0.0.2 via ge-1/2/1.0, selected
                State: <Active Ext>
                Local AS: 64500 Peer AS: 64501
                Age: 3:18:30
                Task: BGP_64501.10.0.0.2+55402
                Announcement bits (1): 2-KRT
                AS path: 64501 I
                Accepted Multipath
                Localpref: 100
                Router ID: 192.168.2.1
         BGP    Preference: 170/-101
                Next hop type: Router, Next hop index: 602
                Next-hop reference count: 5
                Source: 10.0.1.1
                Next hop: 10.0.1.1 via ge-1/2/0.0, selected
                State: <NotBest Ext>
                Inactive reason: Not Best in its group - Active preferred
                Local AS: 64500 Peer AS: 64501
                Age: 3:18:30
                Task: BGP_64501.10.0.1.1+53135
                AS path: 64501 I
                Accepted
                Localpref: 100
                Router ID: 192.168.3.1
Signification
Le chemin actif, indiqué par un astérisque (*), comporte deux sauts suivants : 10.0.1.1 et 10.0.0.2 vers la destination 10.0.2.0. Le saut suivant 10.0.1.1 est copié du chemin inactif vers le chemin actif.
La show route detail sortie de la commande désigne une passerelle comme selected. Ce résultat peut prêter à confusion dans le contexte de l’équilibrage de charge. La passerelle sélectionnée est utilisée à de nombreuses fins, en plus de décider quelle passerelle installer dans le noyau lorsque Junos OS n’effectue pas d’équilibrage de charge par paquet. Par exemple, la ping mpls commande utilise la passerelle sélectionnée lors de l’envoi de paquets. Les protocoles multicast utilisent la passerelle sélectionnée dans certains cas pour déterminer l’interface en amont. Par conséquent, même lorsque Junos OS effectue un équilibrage de charge par paquet par le biais d’une politique de table de transfert, les informations de passerelle sélectionnées sont toujours nécessaires à d’autres fins. Il est utile d’afficher la passerelle sélectionnée à des fins de dépannage. De plus, il est possible d’utiliser la politique de table de transfert pour remplacer ce qui est installé dans le noyau (par exemple, en utilisant l’action install-nexthop ). Dans ce cas, la passerelle de saut suivant installée dans la table de transfert peut être un sous-ensemble du nombre total de passerelles affichées dans la show route commande.
Vérification du transfert
Objet
Vérifiez que les deux sauts suivants sont installés dans la table de transfert.
Mesures à prendre
À partir du mode opérationnel, exécutez la show route forwarding-table commande.
user@R1> show route forwarding-table destination 10.0.2.0
Routing table: default.inet
Internet:
Destination        Type RtRef Next hop           Type Index NhRef Netif
10.0.2.0/30        user     0                    ulst 262142     2
                              10.0.1.1           ucst   602     5 ge-1/2/0.0
                              10.0.0.2           ucst   522     6 ge-1/2/1.0
Comprendre la configuration de 512 chemins à coût égal maximum avec équilibrage de charge cohérent en option
Vous pouvez configurer la fonctionnalité ECMP (Equal-Cost Multipath) avec jusqu’à 512 chemins pour les homologues BGP externes. La possibilité de configurer jusqu’à 512 sauts suivants ECMP vous permet d’augmenter le nombre de connexions directes entre pairs BGP avec le périphérique de routage spécifié, améliorant ainsi la latence et optimisant le flux de données. Vous pouvez éventuellement inclure un équilibrage de charge cohérent dans cette configuration ECMP. Un équilibrage de charge cohérent garantit qu’en cas de défaillance d’un membre ECMP (c’est-à-dire un chemin), seuls les flux circulant à travers le membre défaillant sont redistribués aux autres membres ECMP actifs. Un équilibrage de charge cohérent garantit également que si un membre ECMP est ajouté, la redistribution des flux des membres EMCP existants vers le nouveau membre ECMP est minime.
- Directives et limitations pour la configuration de 256 à 512 chemins à coût égal, éventuellement avec un équilibrage de charge cohérent
- Instructions pour configurer jusqu’à 512 sauts suivants ECMP et, si vous le souhaitez, un équilibrage de charge cohérent
Directives et limitations pour la configuration de 256 à 512 chemins à coût égal, éventuellement avec un équilibrage de charge cohérent
La fonctionnalité s’applique uniquement aux homologues BGP externes à saut unique. (Cette fonctionnalité ne s’applique pas aux routes MPLS.)
Le processus de routage de l’appareil (RPD) doit prendre en charge le mode 64 bits ; RPD 32 bits n’est pas pris en charge.
La fonctionnalité s’applique uniquement au trafic unicast.
La répartition du trafic peut varier de manière uniforme entre tous les membres du groupe, car elle dépend du modèle de trafic et de l’organisation de la table de définition des flux de hachage dans le matériel. Le hachage cohérent minimise le remappage des flux vers les liens de destination lorsque des membres sont ajoutés ou supprimés du groupe.
Si vous configurez
set forwarding-options enhanced-hash-keyavec l’une des optionshash-mode, ,inetinet6oulayer2, certains flux peuvent modifier les liens de destination, car les nouveaux paramètres de hachage peuvent générer de nouveaux index de hachage pour les flux, entraînant de nouveaux liens de destination.Pour obtenir la meilleure précision de hachage possible, cette fonctionnalité utilise une topologie en cascade pour implémenter la structure de saut suivant pour les configurations de plus de 128 sauts suivants. La précision de hachage est donc légèrement inférieure à celle des configurations ECMP next-hop inférieures à 128, qui ne nécessitent pas de topologie en cascade.
Les flux existants sur les chemins ECMP affectés et les nouveaux flux circulant sur ces chemins ECMP affectés peuvent changer de chemin lors de la réparation d’une route locale, et une distorsion du trafic peut être perceptible. Cependant, une telle inclinaison est corrigée lors de la réparation ultérieure de l’itinéraire global.
Lorsque vous augmentez la valeur, le
maximum-ecmphachage de cohérence est perdu lors du prochain événement de changement de saut suivant pour le préfixe de route.Si vous ajoutez un nouveau chemin à un groupe ECMP existant, certains flux sur des chemins non affectés peuvent être déplacés vers le chemin nouvellement ajouté.
Le reroutage rapide (FRR) peut ne pas fonctionner avec un hachage cohérent.
Il est impossible d’obtenir une distribution parfaite du trafic de type ECMP. Les chemins qui ont plus de « compartiments » que les autres chemins ont plus de flux de trafic que les chemins avec moins de compartiments (un compartiment est une entrée de la liste de distribution de la table d’équilibrage de charge qui est mappée à un index membre ECMP).
Lors d’événements de modification de la topologie du réseau, un hachage cohérent est perdu pour les préfixes réseau dans certains cas, car ces préfixes pointent vers un nouveau saut suivant ECMP qui n’a pas toutes les propriétés des sauts suivants ECMP précédents des préfixes.
Si plusieurs préfixes réseau pointent vers le même saut suivant ECMP et qu’un ou plusieurs de ces préfixes sont activés avec l’instruction
consistent-hash, tous les préfixes réseau pointant vers ce même saut suivant ECMP affichent un comportement de hachage cohérent.Le hachage cohérent est pris en charge sur le groupe ECMP basé sur des routes BGP à coût égal uniquement. Lorsque d’autres protocoles ou routes statiques sont configurés et ont la priorité sur les routes BGP, le hachage cohérent n’est pas pris en charge.
Un hachage cohérent peut avoir des limites lorsque la configuration est combinée avec des configurations pour les fonctionnalités suivantes, car ces fonctionnalités ont des terminaisons tunnel ou une ingénierie de trafic qui n’utilise pas le hachage pour sélectionner les chemins : tunnelisation GRE ; Trafic BUM ; EVPN-VXLAN ; et MPLS TE, la bande passante automatique.
Instructions pour configurer jusqu’à 512 sauts suivants ECMP et, si vous le souhaitez, un équilibrage de charge cohérent
Lorsque vous êtes prêt à configurer jusqu’à 512 sauts suivants, suivez les instructions de configuration suivantes :
Configurez le nombre maximal de sauts suivants ECMP (par exemple, configurez 512 sauts suivants ECMP) :
[edit]
user@host# set chassis maximum-ecmp 512
Création d’une politique de routage et activation de l’équilibrage de charge par paquet, permettant ainsi ECMP globalement sur le système :
[edit]
user@host# set routing-options forwarding-table export load-balancing-policy
user@host# set policy-options policy-statement load-balancing-policy then load-balance per-packet
Activez la résilience sur les préfixes sélectionnés en créant une politique de routage distincte pour faire correspondre les routes entrantes à un ou plusieurs préfixes de destination, par exemple :
[edit]
user@host# set policy-options policy-statement c-hash from route-filter 20.0.0.0/24 orlonger
 user@host# set policy-options policy-statement c-hash then load-balance consistent-hash
Appliquez une stratégie d’importation eBGP (par exemple, « c-hash ») au groupe BGP de pairs externes :
[edit]
user@host# set protocols bgp import c-hash
Pour plus d’informations sur la configuration de chemins à coût égal, consultez Exemple : Équilibrage de charge du trafic BGP, qui apparaît plus haut dans ce document.
(Facultatif) Pour plus d’informations sur la configuration de l’équilibrage de charge cohérent (également appelé hachage cohérent), consultez Configuration de l’équilibrage de charge cohérent pour les groupes ECMP
Voir aussi
Exemple : Configuration d’homologues EBGP à saut unique pour accepter des sauts suivants distants
Cet exemple montre comment configurer un homologue BGP externe (EBGP) à saut unique pour accepter un saut suivant distant avec lequel il ne partage pas un sous-réseau commun.
Exigences
Aucune configuration spéciale au-delà de l’initialisation de l’appareil n’est requise avant de configurer cet exemple.
Vue d’ensemble
Dans certaines situations, il est nécessaire de configurer un homologue EBGP à saut unique pour accepter un saut suivant distant avec lequel il ne partage pas de sous-réseau commun. Par défaut, toute adresse de saut suivant reçue d’un homologue EBGP à saut unique qui n’est pas reconnu comme partageant un sous-réseau commun doit être ignorée. La possibilité pour un homologue EBGP à saut unique d’accepter un saut suivant distant auquel il n’est pas directement connecté vous évite également d’avoir à configurer le voisin EBGP à saut unique en tant que session à sauts multiples. Lorsque vous configurez une session à sauts multiples dans cette situation, toutes les routes de saut suivant apprises via cet homologue EBGP sont étiquetées indirectes, même lorsqu’elles partagent un sous-réseau commun. Cette situation interrompt la fonctionnalité de chemins multichemins pour les itinéraires qui sont résolus de manière récursive sur les itinéraires qui incluent ces adresses de saut suivant. La configuration de l’instruction accept-remote-nexthop permet à un homologue EBGP à saut unique d’accepter un saut suivant distant, ce qui rétablit la fonctionnalité de chemin multichemin pour les routes résolues sur ces adresses de saut suivant. Vous pouvez configurer cette instruction au niveau de la hiérarchie globale, du groupe et du voisinage pour BGP. L’instruction est également prise en charge sur les systèmes logiques et le type d’instance de routage VRF (VPN routing and forwarding). Le saut suivant distant et l’homologue EBGP doivent tous deux prendre en charge l’actualisation BGP route, comme défini dans la RFC 2918, Route Actualiser Capability in BGP-4. Si l’homologue distant ne prend pas en charge l’actualisation de la route BGP, la session est réinitialisée.
Par défaut, un homologue EBGP à saut unique annonce sa propre adresse comme le saut suivant. Si vous souhaitez publier un saut suivant différent, vous devez définir une politique de routage d’importation sur l’homologue EBGP. Lorsque vous activez un homologue EBGP à saut unique pour accepter un saut suivant distant, vous pouvez également configurer une politique de routage d’importation sur l’homologue EBGP. Toutefois, une politique de routage n’est pas nécessaire si vous avez configuré un saut suivant distant.
Cet exemple inclut une politique de routage d’importation, agg_route, qui permet à un pair BGP externe à saut unique (équipement R1) d’accepter le saut suivant distant 10.1.10.10 pour la route vers le réseau 10.1.230.0/23. Au niveau de la [edit protocols bgp] hiérarchie, l’exemple inclut l’instruction d’appliquer import agg_route la stratégie au pair BGP externe et inclut l’instruction accept-remote-nexthop permettant à l’homologue EBGP à saut unique d’accepter le saut suivant distant.
La figure 2 montre un exemple de topologie.
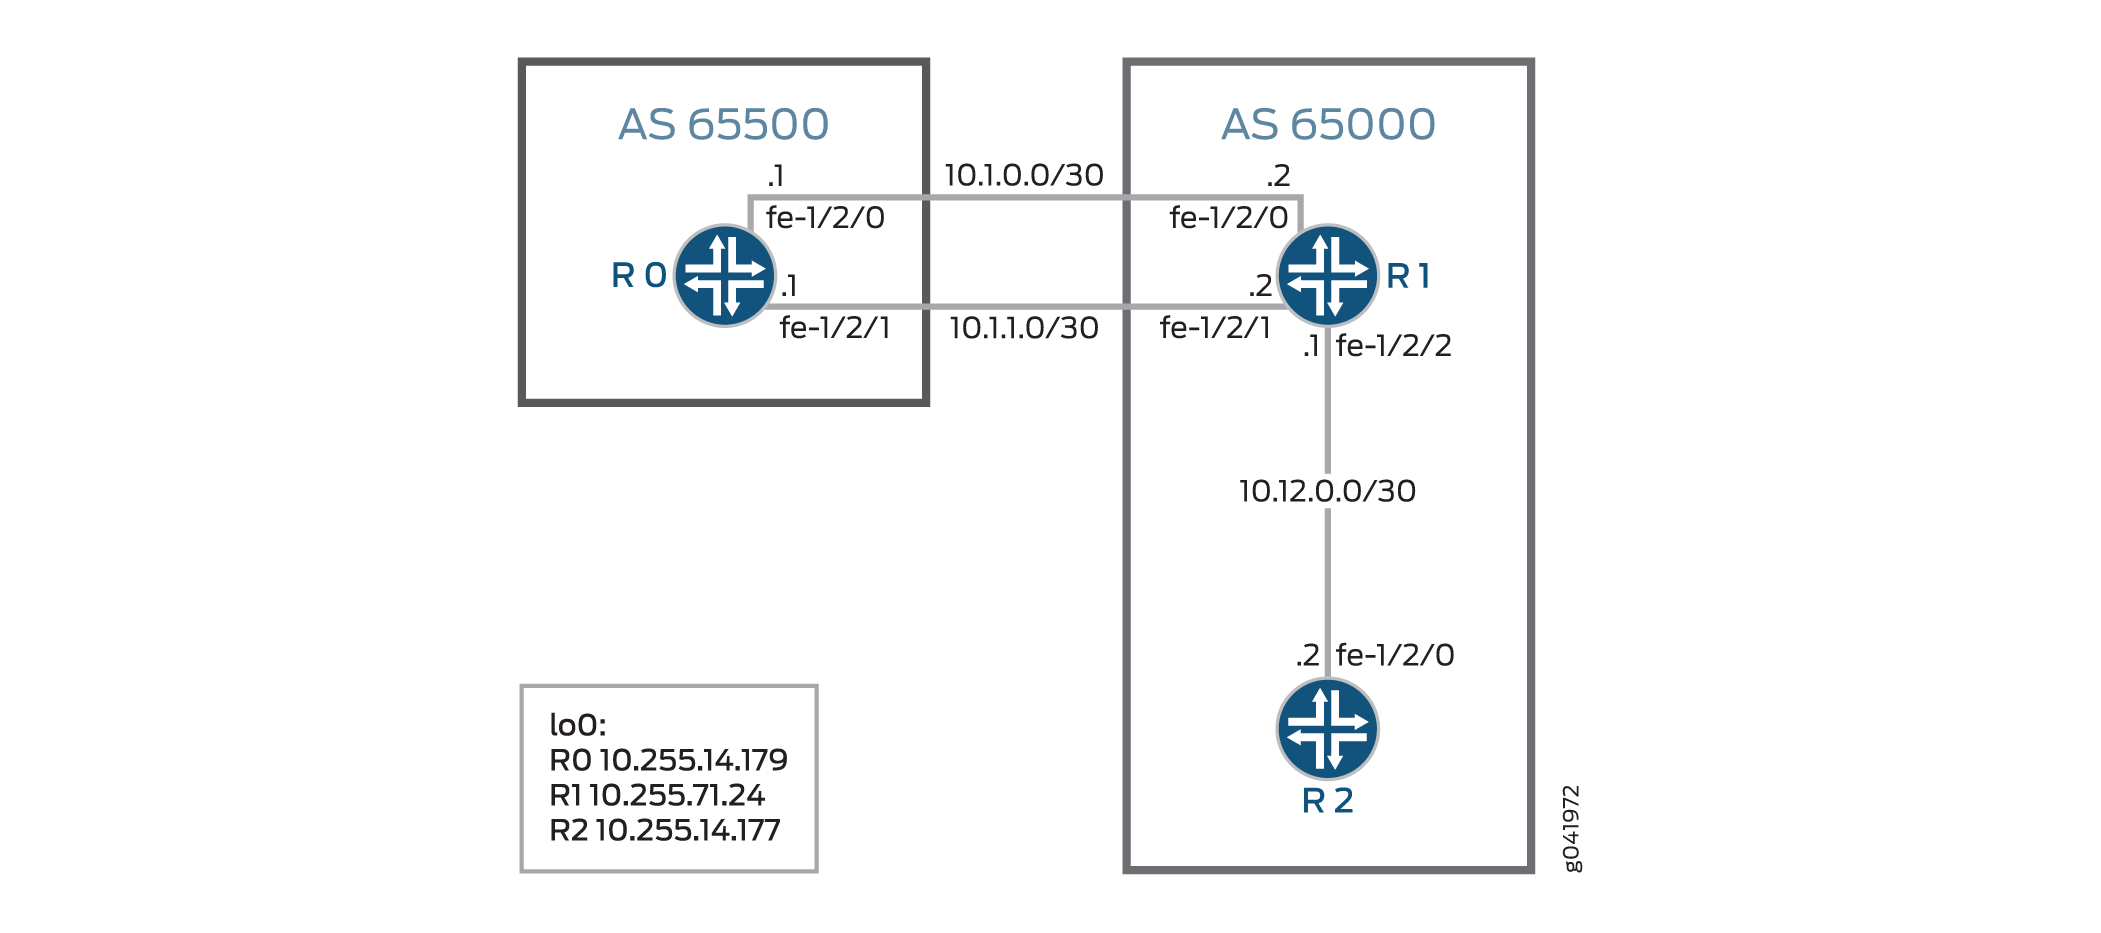 suivant distant
La configuration
- Configuration rapide de la CLI
- Équipement R0
- Configuration de l’équipement R1
- Configuration de l’équipement R2
Configuration rapide de la CLI
Pour configurer rapidement cet exemple, copiez les commandes suivantes, collez-les dans un fichier texte, supprimez les sauts de ligne, modifiez tous les détails nécessaires pour qu’ils correspondent à votre configuration réseau, puis copiez et collez les commandes dans le CLI au niveau de la [edit] hiérarchie.
Équipement R0
set interfaces fe-1/2/0 unit 0 family inet address 10.1.0.1/30
set interfaces fe-1/2/1 unit 0 family inet address 10.1.1.1/30
set interfaces lo0 unit 0 family inet address 10.255.14.179/32
set protocols bgp group ext type external
set protocols bgp group ext export test_route
set protocols bgp group ext export agg_route
set protocols bgp group ext peer-as 65000
set protocols bgp group ext multipath
set protocols bgp group ext neighbor 10.1.0.2
set protocols bgp group ext neighbor 10.1.1.2
set policy-options policy-statement agg_route term 1 from protocol static
set policy-options policy-statement agg_route term 1 from route-filter 10.1.230.0/23 exact
set policy-options policy-statement agg_route term 1 then accept
set policy-options policy-statement test_route term 1 from protocol static
set policy-options policy-statement test_route term 1 from route-filter 10.1.10.10/32 exact
set policy-options policy-statement test_route term 1 then accept
set routing-options static route 10.1.10.10/32 reject
set routing-options static route 10.1.230.0/23 reject
set routing-options autonomous-system 65500
Appareil R1
set interfaces fe-1/2/0 unit 0 family inet address 10.1.0.2/30
set interfaces fe-1/2/1 unit 0 family inet address 10.1.1.2/30
set interfaces fe-1/2/2 unit 0 family inet address 10.12.0.1/30
set interfaces lo0 unit 2 family inet address 10.255.71.24/32
set protocols bgp accept-remote-nexthop
set protocols bgp group ext type external
set protocols bgp group ext import agg_route
set protocols bgp group ext peer-as 65500
set protocols bgp group ext multipath
set protocols bgp group ext neighbor 10.1.0.1
set protocols bgp group ext neighbor 10.1.1.1
set protocols bgp group int type internal
set protocols bgp group int local-address 10.255.71.24
set protocols bgp group int neighbor 10.255.14.177
set protocols ospf area 0.0.0.0 interface fe-1/2/1.4
set protocols ospf area 0.0.0.0 interface 10.255.71.24
set policy-options policy-statement agg_route term 1 from protocol bgp
set policy-options policy-statement agg_route term 1 from route-filter 10.1.230.0/23 exact
set policy-options policy-statement agg_route term 1 then next-hop 10.1.10.10
set policy-options policy-statement agg_route term 1 then accept
set routing-options autonomous-system 65000
Appareil R2
set interfaces fe-1/2/0 unit 0 family inet address 10.12.0.2/30
set interfaces lo0 unit 0 family inet address 10.255.14.177/32
set protocols bgp group int type internal
set protocols bgp group int local-address 10.255.14.177
set protocols bgp group int neighbor 10.255.71.24
set protocols ospf area 0.0.0.0 interface fe-1/2/0.6
set protocols ospf area 0.0.0.0 interface 10.255.14.177
set routing-options autonomous-system 65000
Équipement R0
Procédure étape par étape
L’exemple suivant vous oblige à naviguer à différents niveaux dans la hiérarchie de configuration. Pour plus d’informations sur la navigation dans la CLI, reportez-vous à la section Utilisation de l’éditeur CLI en mode configuration dans le Guide de l’utilisateur de la CLI de Junos OS.
Pour configurer l’appareil R0 :
-
Configurez les interfaces.
[edit interfaces fe-1/2/0 unit 0]
user@R0# set family inet address 10.1.0.1/30
[edit interfaces fe-1/2/1 unit 0]
user@R0# set family inet address 10.1.1.1/30
[edit interfaces lo0 unit 0]
user@R0# set family inet address 10.255.14.179/32
-
Configurez EBGP.
[edit protocols bgp group ext]
user@R0# set type external
user@R0# set peer-as 65000
user@R0# set neighbor 10.1.0.2
user@R0# set neighbor 10.1.1.2
-
Activez le protocole BGP multichemin entre l’équipement R0 et l’équipement R1.
[edit protocols bgp group ext]
user@R0# set multipath
-
Configurez des routes statiques vers des réseaux distants. Ces routes ne font pas partie de la topologie. Le but de ces routes est de démontrer la fonctionnalité de cet exemple.
[edit routing-options]
user@R0# set static route 10.1.10.10/32 reject
user@R0# set static route 10.1.230.0/23 reject
-
Configurez des stratégies de routage qui acceptent les routes statiques.
[edit policy-options policy-statement agg_route term 1]
user@R0# set from protocol static
user@R0# set from route-filter 10.1.230.0/23 exact
user@R0# set then accept
[edit policy-options policy-statement test_route term 1]
user@R0# set from protocol static
user@R0# set from route-filter 10.1.10.10/32 exact
user@R0# set then accept
-
Exportez les
agg_routestratégies ettest_routede la table de routage vers BGP.[edit protocols bgp group ext] user@R0# set export test_route user@R0# set export agg_route
-
Configurez le numéro du système autonome (AS).
[edit routing-options]
user@R0# set autonomous-system 65500
Résultats
En mode configuration, confirmez votre configuration en entrant les show interfacescommandes , show policy-optionsshow protocols, , et show routing-options . Si la sortie n’affiche pas la configuration prévue, répétez les instructions de cet exemple pour corriger la configuration.
user@R0# show interfaces
fe-1/2/0 {
    unit 0 {
        family inet {
            address 10.1.0.1/30;
        }
    }
}
fe-1/2/1 {
    unit 0 {
        family inet {
            address 10.1.1.1/30;
        }
    }
}
lo0 {
    unit 0 {
        family inet {
            address 10.255.14.179/32;
        }
    }
}
user@R0# show policy-options
policy-statement agg_route {
    term 0 {
        from {
            protocol static;
            route-filter 10.1.230.0/23 exact;
        }
        then accept;
    }
}
policy-statement test_route {
    term 1 {
        from {
            protocol static;
            route-filter 10.1.10.10/32 exact;
        }
        then accept;
    }
}
user@R0# show protocols
bgp {
    group ext {
        type external;
        export [ test_route agg_route ];
        peer-as 65000;
        multipath;
        neighbor 10.1.0.2;
        neighbor 10.1.1.2;
    }
}
user@R0# show routing-options
static {
    route 10.1.10.10/32 reject;
    route 10.1.230.0/23 reject;
}
autonomous-system 65500;
Si vous avez terminé de configurer l’appareil, entrez en commit mode configuration.
Configuration de l’équipement R1
Procédure étape par étape
L’exemple suivant vous oblige à naviguer à différents niveaux dans la hiérarchie de configuration. Pour plus d’informations sur la navigation dans la CLI, reportez-vous à la section Utilisation de l’éditeur CLI en mode configuration dans le Guide de l’utilisateur de la CLI de Junos OS.
Pour configurer l’appareil R1 :
-
Configurez les interfaces.
[edit interfaces fe-1/2/0 unit 0]
user@R1# set family inet address 10.1.0.2/30
[edit interfaces fe-1/2/1 unit 0]
user@R1# set family inet address 10.1.1.2/30
[edit interfaces fe-1/2/2 unit 0]
user@R1# set family inet address 10.12.0.1/30
[edit interfaces lo0 unit 0]
user@R1# set family inet address 10.255.71.24/32
-
Configurez OSPF.
[edit protocols ospf area 0.0.0.0]
user@R1# set interface fe-1/2/1.0
user@R1# set interface 10.255.71.24
-
Activez l’appareil R1 pour accepter le saut suivant distant.
[edit protocols bgp]
user@R1# set accept-remote-nexthop
-
Configurez IBGP.
[edit protocols bgp group int]
user@R1# set type internal
user@R1# set local-address 10.255.71.24
user@R1# set neighbor 10.255.14.177
-
Configurez EBGP.
[edit protocols bgp group ext]
user@R1# set type external
user@R1# set peer-as 65500
user@R1# set neighbor 10.1.0.1
user@R1# set neighbor 10.1.1.1
-
Activez le protocole BGP multichemin entre l’équipement R0 et l’équipement R1.
[edit protocols bgp group ext]
user@R1# set multipath
-
Configurez une politique de routage qui permet à un pair BGP externe à saut unique (équipement R1) d’accepter le saut suivant distant 10.1.10.10 pour la route vers le réseau 10.1.230.0/23.
[edit policy-options policy-statement agg_route term 1]
user@R1# set from protocol bgp
user@R1# set from route-filter 10.1.230.0/23 exact
user@R1# set then next-hop 10.1.10.10
user@R1# set then accept
-
Importez la
agg_routestratégie dans la table de routage sur l’appareil R1.[edit protocols bgp group ext] user@R1# set import agg_route
-
Configurez le numéro du système autonome (AS).
[edit routing-options]
user@R1# set autonomous-system 65000
Résultats
En mode configuration, confirmez votre configuration en entrant les show interfacescommandes , show policy-optionsshow protocols, , et show routing-options . Si la sortie n’affiche pas la configuration prévue, répétez les instructions de cet exemple pour corriger la configuration.
user@R1# show interfaces
fe-1/2/0 {
    unit 0 {
        family inet {
            address 10.1.0.2/30;
        }
    }
}
fe-1/2/1 {
    unit 0 {
        family inet {
            address 10.1.1.2/30;
        }
    }
}
fe-1/2/2 {
    unit 0 {
        family inet {
            address 10.12.0.1/30;
        }
    }
}
lo0 {
    unit 0 {
        family inet {
            address 10.255.71.24/32;
        }
    }
}
user@R1# show policy-options
policy-statement agg_route {
    term 1 {
        from {
            protocol bgp;
            route-filter 10.1.230.0/23 exact;
        }
        then {
            next-hop 10.1.10.10;
            accept;
        }
    }
}
user@R1# show protocols
bgp {
    accept-remote-nexthop;
    group ext {
        type external;
        import agg_route;
        peer-as 65500;
        multipath;
        neighbor 10.1.0.1;
        neighbor 10.1.1.1;
    }
    group int {
        type internal;
        local-address 10.255.71.24;
        neighbor 10.255.14.177;
    }
}
ospf {
    area 0.0.0.0 {
        interface fe-1/2/1.0;
        interface 10.255.71.24;
    }
}
user@R1# show routing-options
autonomous-system 65000;
Si vous avez terminé de configurer l’appareil, entrez en commit mode configuration.
Configuration de l’équipement R2
Procédure étape par étape
L’exemple suivant vous oblige à naviguer à différents niveaux dans la hiérarchie de configuration. Pour plus d’informations sur la navigation dans la CLI, reportez-vous à la section Utilisation de l’éditeur CLI en mode configuration dans le Guide de l’utilisateur de la CLI de Junos OS.
Pour configurer l’appareil R2 :
-
Configurez les interfaces.
[edit interfaces fe-1/2/0 unit 0]
user@R2# set family inet address 10.12.0.2/30
[edit  interfaces lo0 unit 0]
user@R2# set family inet address 10.255.14.177/32
-
Configurez OSPF.
[edit protocols ospf area 0.0.0.0]
user@R2# set interface fe-1/2/0.0
user@R2# set interface 10.255.14.177
-
Configurez IBGP.
[edit protocols bgp group int]
user@R2# set type internal
user@R2# set local-address 10.255.14.177
user@R2# set neighbor 10.255.71.24
-
Configurez le numéro du système autonome (AS).
[edit routing-options]
user@R1# set autonomous-system 65000
Résultats
En mode configuration, confirmez votre configuration en entrant les show interfacescommandes , show protocolset . show routing-options Si la sortie n’affiche pas la configuration prévue, répétez les instructions de cet exemple pour corriger la configuration.
user@R2# show interfaces
fe-1/2/0 {
    unit 0 {
        family inet {
            address 10.12.0.2/30;
        }
    }
}
lo0 {
    unit 0 {
        family inet {
            address 10.255.14.177/32;
        }
    }
}
user@R2# show protocols
bgp {
    group int {
        type internal;
        local-address 10.255.14.177;
        neighbor 10.255.71.24;
    }
}
ospf {
    area 0.0.0.0 {
        interface fe-1/2/0.0;
        interface 10.255.14.177;
    }
}
user@R2# show routing-options
autonomous-system 65000;
Si vous avez terminé de configurer l’appareil, entrez en commit mode configuration.
Vérification
Vérifiez que la configuration fonctionne correctement.
- Vérification de la présence de la route multichemin avec le saut suivant indirect dans la table de routage
- Désactivation et réactivation de l’instruction accept-remote-nexthop
Vérification de la présence de la route multichemin avec le saut suivant indirect dans la table de routage
Objet
Vérifiez que l’appareil R1 dispose d’une route vers le réseau 10.1.230.0/23.
Mesures à prendre
À partir du mode opérationnel, entrez la show route 10.1.230.0 extensive commande.
user@R1> show route 10.1.230.0 extensive
inet.0: 11 destinations, 13 routes (11 active, 0 holddown, 0 hidden)
Restart Complete
10.1.230.0/23 (2 entries, 1 announced)
TSI:
KRT in-kernel 10.1.230.0/23 -> {indirect(262142)}
Page 0 idx 1 Type 1 val 9168f6c
    Nexthop: 10.1.10.10
    Localpref: 100
    AS path: [65000] 65500 I
    Communities:
Path 10.1.230.0 from 10.1.0.1 Vector len 4.  Val: 1
        *BGP    Preference: 170/-101
                Next hop type: Indirect
                Address: 0x90c44d8
                Next-hop reference count: 4
                Source: 10.1.0.1
                Next hop type: Router, Next hop index: 262143
                Next hop: 10.1.0.1 via fe-1/2/0.0, selected
                Next hop: 10.1.1.1 via fe-1/2/2.0
                Protocol next hop: 10.1.10.10
                Indirect next hop: 91c0000 262142
                State: <Active Ext>
                Local AS: 65000 Peer AS: 65500
                Age: 2:55:31    Metric2: 0
                Task: BGP_65500.10.1.0.1+64631
                Announcement bits (3): 2-KRT 3-BGP_RT_Background 4-Resolve tree 1
                AS path: 65500 I
                Accepted Multipath
                Localpref: 100
                Router ID: 10.255.14.179
                Indirect next hops: 1
                        Protocol next hop: 10.1.10.10
                        Indirect next hop: 91c0000 262142
                        Indirect path forwarding next hops: 2
                                Next hop type: Router
                                Next hop: 10.1.0.1 via fe-1/2/0.0
                                Next hop: 10.1.1.1 via fe-1/2/2.0
                        10.1.10.10/32 Originating RIB: inet.0
                          Node path count: 1
                          Forwarding nexthops: 2
                                Nexthop: 10.1.0.1 via fe-1/2/0.0
                                Nexthop: 10.1.1.1 via fe-1/2/2.0
         BGP    Preference: 170/-101
                Next hop type: Indirect
                Address: 0x90c44d8
                Next-hop reference count: 4
                Source: 10.1.1.1
                Next hop type: Router, Next hop index: 262143
                Next hop: 10.1.0.1 via fe-1/2/0.0, selected
                Next hop: 10.1.1.1 via fe-1/2/2.0
                Protocol next hop: 10.1.10.10
                Indirect next hop: 91c0000 262142
                State: <NotBest Ext>
                Inactive reason: Not Best in its group - Update source
                Local AS: 65000 Peer AS: 65500
                Age: 2:55:27    Metric2: 0
                Task: BGP_65500.10.1.1.1+53260
                AS path: 65500 I
                Accepted
                Localpref: 100
                Router ID: 10.255.14.179
                Indirect next hops: 1
                        Protocol next hop: 10.1.10.10
                        Indirect next hop: 91c0000 262142
                        Indirect path forwarding next hops: 2
                                Next hop type: Router
                                Next hop: 10.1.0.1 via fe-1/2/0.0
                                Next hop: 10.1.1.1 via fe-1/2/2.0
                        10.1.10.10/32 Originating RIB: inet.0
                          Node path count: 1
                          Forwarding nexthops: 2
                                Nexthop: 10.1.0.1 via fe-1/2/0.0
                                Nexthop: 10.1.1.1 via fe-1/2/2.0
Signification
La sortie montre que l’appareil R1 dispose d’une route vers le réseau 10.1.230.0 avec la fonction de chemin multichemin activée (Accepted Multipath). La sortie indique également que l’itinéraire a un saut suivant indirect de 10.1.10.10.
Désactivation et réactivation de l’instruction accept-remote-nexthop
Objet
Assurez-vous que la route à trajets multiples avec le saut suivant indirect est supprimée de la table de routage lorsque vous désactivez l’instruction accept-remote-nexthop .
Mesures à prendre
-
Dans le mode configuration, entrez la
deactivate protocols bgp accept-remote-nexthopcommande.user@R1# deactivate protocols bgp accept-remote-nexthop user@R1# commit
-
À partir du mode opérationnel, entrez la
show route 10.1.230.0commande.user@R1> show route 10.1.230.0
-
En mode configuration, réactivez l’instruction en entrant la
activate protocols bgp accept-remote-nexthopcommande.user@R1# activate protocols bgp accept-remote-nexthop user@R1# commit
-
Depuis le mode opérationnel, saisissez à nouveau la
show route 10.1.230.0commande.user@R1> show route 10.1.230.0 inet.0: 11 destinations, 13 routes (11 active, 0 holddown, 0 hidden) Restart Complete + = Active Route, - = Last Active, * = Both 10.1.230.0/23 *[BGP/170] 03:13:19, localpref 100 AS path: 65500 I > to 10.1.0.1 via fe-1/2/0.0 to 10.1.1.1 via fe-1/2/2.0 [BGP/170] 03:13:15, localpref 100, from 10.1.1.1 AS path: 65500 I > to 10.1.0.1 via fe-1/2/0.0 to 10.1.1.1 via fe-1/2/2.0
Signification
Lorsque l’instruction accept-remote-nexthop est désactivée, la route multichemin vers le réseau 10.1.230.0 est supprimée de la table de routage .
Comprendre l’équilibrage de charge pour le trafic BGP avec une bande passante inégale allouée aux chemins
L’option multichemin supprime les points de départage du processus de décision de routage actif, ce qui permet d’installer dans la table de transfert des routes BGP apprises à partir de sources multiples, autrement à coût égal. Toutefois, lorsque le coût des chemins disponibles n’est pas égal, vous pouvez équilibrer la charge du trafic de manière asymétrique.
Une fois que plusieurs sauts suivants sont installés dans la table de transfert, un saut suivant spécifique est sélectionné par l’algorithme d’équilibrage de charge par préfixe de Junos OS. Ce processus hache en fonction des adresses source et de destination d’un paquet pour mapper de manière déterministe l’appariement de préfixes sur l’un des sauts suivants disponibles. Le mappage par préfixe fonctionne mieux lorsque la fonction de hachage est présentée avec un grand nombre de préfixes, comme cela peut se produire sur un échange d’appairage Internet, et il sert à empêcher la réorganisation des paquets entre les paires de nœuds communicants.
En règle générale, un réseau d’entreprise souhaite modifier le comportement par défaut pour déclencher un algorithme d’équilibrage de charge par paquet . L’accent est mis ici sur le terme « par paquet » car son utilisation est un terme impropre qui découle du comportement historique de l’ASIC Internet Processor original. En réalité, les routeurs Juniper Networks actuels prennent en charge l’équilibrage de charge par préfixe (par défaut) et par flux. Ce dernier implique le hachage sur divers en-têtes de couche 3 et de couche 4, y compris des parties de l’adresse source, de l’adresse de destination, du protocole de transport, de l’interface entrante et des ports d’application. Ainsi, les flux individuels sont désormais hachés en un saut suivant spécifique, ce qui permet une distribution plus uniforme entre les sauts suivants disponibles, en particulier lors du routage entre moins de paires source/destination.
Avec l’équilibrage de charge par paquet, les paquets comprenant un flux de communication entre deux points de terminaison peuvent être reséquencés, mais les paquets dans les flux individuels conservent un séquençage correct. Que vous optiez pour un équilibrage de charge par préfixe ou par paquet, l’asymétrie des liens d’accès peut représenter un défi technique. Dans tous les cas, les préfixes ou les flux mappés, par exemple, à une liaison T1 présenteront des performances dégradées par rapport aux flux mappés, par exemple, à une liaison d’accès Fast Ethernet. Pire encore, avec de lourdes charges de trafic, toute tentative d’équilibrage de charge égal est susceptible d’entraîner une saturation totale de la liaison T1 et une interruption de session résultant de la perte de paquets.
Heureusement, l’implémentation BGP de Juniper Networks prend en charge la notion de communauté de bande passante. Cette communauté étendue code la bande passante d’un saut suivant donné et, lorsqu’il est combiné avec un saut multichemin, l’algorithme d’équilibrage de charge distribue les flux sur l’ensemble des sauts suivants proportionnellement à leur bande passante relative. En d’autres termes, si vous avez un saut suivant de 10 Mbit/s et un saut suivant de 1 Mbit/s, en moyenne, neuf flux seront mappés au saut suivant à grande vitesse pour chaque saut qui utilise le saut à faible vitesse.
L’utilisation de la communauté de bande passante BGP n’est prise en charge qu’avec l’équilibrage de charge par paquet.
La tâche de configuration comporte deux parties :
Configurez les sessions d’appairage BGP (EBGP) externe, activez les chemins multichemins et définissez une stratégie d’importation pour marquer les routes avec une communauté de bande passante qui reflète la vitesse des liaisons.
Activez l’équilibrage de charge par paquet (ou vraiment par flux) pour une répartition optimale du trafic.
Voir aussi
Communauté Link-Bandwidth BGP
Vue d’ensemble
Dans une implémentation BGP, une communauté étendue de bande passante de liaison code la bande passante d’un saut suivant donné. Le BGP aide à équilibrer la charge du trafic en communiquant la vitesse des liaisons BGP à des pairs distants. Lorsque vous (l’administrateur réseau) combinez une communauté de bande passante de liaison avec un réseau multichemin, l’algorithme d’équilibrage de charge de votre choix distribue les flux de trafic sur l’ensemble des sauts suivants proportionnellement à leur bande passante relative.
Lorsque la communauté étendue de bande passante de liaison BGP est un attribut transitif entre les systèmes autonomes (AS), le groupe BGP annonce la communauté étendue de bande passante de liaison aux AS voisins. Vous pouvez choisir d’utiliser la communauté de bande passante de liens BGP en tant qu’attribut non transitif afin que les routeurs déposent la communauté de bande passante de liens à la limite de l’AS. Le groupe BGP ne fait pas de publicité pour les communautés de bande passante de liaison non transitives à des voisins BGP (EBGP) externes.
Vous pouvez également configurer BGP pour détecter automatiquement la bande passante et importer la communauté au niveau d’un groupe ou d’un voisin. Grâce à cette fonctionnalité de détection automatique de la bande passante de liaison, votre réseau peut définir automatiquement la valeur de la bande passante de liaison sur la vitesse de l’interface sur laquelle l’équipement a reçu le routage BGP.
Seul l’équilibrage de charge par paquet prend en charge la communauté de bande passante de liaison BGP.
Avantages
-
Lorsque le multichemin est activé, la bande passante de liaison fournit un multichemin à coût égal pondéré (WECMP) pour un équilibrage de charge inégal.
-
Garantit que les liaisons à large bande passante transportent plus de flux que les liaisons à faible bande passante.
-
Réduit le risque de congestion du trafic.
La configuration
Bande passante
Par défaut, la communauté de bande passante est transitive. Vous pouvez utiliser l’une de ces instructions pour configurer la communauté link-bandwidth comme transitive :
set policy-options community name members bandwidth:value
set policy-options community name members bandwidth-transitive:value
Pour le rendre non transitif, utilisez la configuration suivante :
set policy-options community policy-name members bandwidth-non-transitive:value
Remplacement non transitif
Vous pouvez remplacer une configuration non transitive afin qu’un groupe BGP envoie la communauté étendue de bande passante sur une session EBGP, même lorsque la bande passante de liaison n’est pas transitive. Pour envoyer la communauté de bande passante de liaison non transitive sur un voisin EBGP, incluez la configuration suivante :
set protocols bgp group group-name send-non-transitive-link-bandwidth
La send-non-transitive-link-bandwidth déclaration ne fait pas de distinction entre la communauté de bande passante de liaison d’origine et celle qui a été reçue et annoncée de nouveau. Lorsque vous activez cette option, BGP annonce toutes les communautés de bande passante de liaison non transitives au voisin EBGP.
Bande passante agrégée
Par défaut, la communauté link-bande passante agrégée est transitive. Vous pouvez utiliser l’une de ces instructions pour configurer la communauté link-bandwidth comme transitive :
set policy-options policy-statement name then aggregate-bandwidth
set policy-options policy-statement name then aggregate-bandwidth transitive
Pour le rendre non transitif, utilisez la configuration suivante :
set policy-options policy-statement policy-name then aggregate-bandwidth non-transitive
Pour diviser la bande passante totale par le nombre de pairs dans le groupe de publicité, activez l’instruction divide-equal :
set policy-options policy-statement policy-name then aggregate-bandwidth divide-equal
Détection automatique
Vous ne pouvez activer la détection automatique que pour les sessions EBGP à saut unique.
Configurez autosense pour le groupe BGP.
Configurez l’instruction
auto-senseau niveau de laneighborhiérarchie pour détecter et stocker la bande passante vers ce voisin BGP. Configurez-le au niveau de lagrouphiérarchie pour détecter et stocker la bande passante de tous les voisins sous ce groupe BGP :set protocols bgp group group-name link-bandwith auto-sense set protocols bgp group group-name neighbor link-bandwith auto-sense
Configurez la stratégie d’importation avec
auto-link-bandwidthla valeur définie surtransitiveounon-transitive. Si vous ne spécifiez pas, par défautauto-link-bandwidthest transitif :set protocols bgp group group-name import policy-name set policy-options policy-statement policy-name then auto-link-bandwidth non-transitive
(Facultatif) Pour supprimer les changements fréquents de la valeur de la bande passante de liaison lorsque la bande passante augmente, vous pouvez configurer le minuteur de maintien de la détection automatique. Le minuteur de maintien n’est déclenché que lorsque la bande passante augmente. Par défaut, la minuterie est réglée sur 60 secondes :
set protocols bgp group group-name link-bandwith auto-sense hold-down time-in-seconds
Vérification
Vérifiez que la configuration a réussi à l’aide des commandes suivantes :
-
show route receive-protocol bgp peer-ip-address extensive -
show route advertising-protocol bgp peer-ip-address extensive -
show route address extensive -
show bgp neighbor address
Exemple : équilibrage de charge du trafic BGP avec une bande passante inégale allouée aux chemins
Cet exemple montre comment configurer BGP pour sélectionner plusieurs chemins à coût inégal comme chemins actifs.
Les communautés BGP peuvent vous aider à contrôler la politique de routage. Un exemple de bonne utilisation pour les communautés BGP est l’équilibrage de charge inégal. Lorsqu’un ASBR (Autonomous System Border routeur) reçoit des routes de voisins EBGP (BGP externes directement connectés), l’ASBR les envoie ensuite aux voisins internes à l’aide des annonces IBGP. Dans les publicités IBGP, vous pouvez rattacher la communauté link-bandwidth pour communiquer la bande passante du lien externe annoncé. Ceci est utile lorsque plusieurs liaisons externes sont disponibles et que vous souhaitez effectuer un équilibrage de charge inégal sur les liaisons. Vous configurez la communauté étendue link-bandwidth sur toutes les liaisons entrantes de l’AS. Les informations de bande passante dans la communauté étendue link-bandwidth sont basées sur la bande passante configurée de la liaison EBGP. Il n’est pas basé sur la quantité de trafic sur la liaison. Junos OS prend en charge la bande passante de liaison BGP et l’équilibrage de charge multichemin, comme décrit dans le projet Internet draft-ietf-idr-link-bandwidth-06, Communauté étendue de bande passante de liaison BGP.
Exigences
Avant de commencer :
Configurez les interfaces des appareils.
Configurez un Interior Gateway Protocol (IGP).
Configurez BGP.
Configurez une politique de routage qui exporte les routes (telles que les routes directes ou les routes IGP) de la table de routage vers BGP.
Vue d’ensemble
Dans cet exemple, l’appareil R1 se trouve dans l’AS 64500 et est connecté à l’appareil R2 et à l’appareil R3, qui sont dans l’AS 64501.
L’exemple utilise la communauté étendue de bande passante.
Par défaut, lorsque le multichemin BGP est utilisé, le trafic est réparti de manière égale entre les différents chemins calculés. La communauté étendue de bande passante permet d’ajouter un attribut supplémentaire aux chemins BGP, permettant ainsi une répartition inégale du trafic. L’application principale est un scénario dans lequel plusieurs chemins externes existent pour un réseau donné avec des capacités de bande passante asymétrique. Dans un tel scénario, vous pouvez marquer les routes reçues avec la communauté étendue de bande passante. Lorsque le multichemin BGP (interne ou externe) opère parmi des routes contenant l’attribut bande passante, le moteur de transfert peut répartir le trafic de manière inégale en fonction de la bande passante correspondant à chaque chemin.
Lorsque BGP dispose de plusieurs chemins candidats disponibles à des fins de chemins multichemins, BGP n’effectue pas d’équilibrage de charge à coût inégal en fonction de la communauté de bande passante, sauf si tous les chemins candidats ont cet attribut.
L’applicabilité de la communauté étendue de bande passante est limitée par les restrictions en vertu desquelles le BGP multichemin accepte plusieurs chemins pour examen. Explicitement, la distance IGP, en ce qui concerne BGP, entre le routeur effectuant l’équilibrage de charge et les multiples points de sortie doit être la même. Pour ce faire, il suffit d’utiliser un maillage complet de chemins à commutation d’étiquettes (LSP) qui ne suivent pas la métrique IGP correspondante. Cependant, dans un réseau dans lequel le retard de propagation des circuits est important (par exemple, si des circuits longue distance sont présents), il est souvent utile de prendre en compte les caractéristiques de retard des différents trajets.
Configurez la communauté de bande passante comme suit :
[edit policy-options]
user@host# set community members bandwidth:[1-65535]:[0-4294967295]
Le premier nombre de 16 bits représente le système autonome local. Le deuxième nombre de 32 bits représente la bande passante de la liaison en octets par seconde.
Par exemple :
[edit policy-options]
user@host# show
community bw-t1 members bandwidth:10458:193000;
community bw-t3 members bandwidth:10458:5592000;
community bw-oc3 members bandwidth:10458:19440000;
Où 10458 est le numéro AS local. Les valeurs correspondent à la bande passante des chemins T1, T3 et OC-3 en octets par seconde. La valeur spécifiée comme valeur de bande passante n’a pas besoin de correspondre à la bande passante réelle d’une interface spécifique. Les facteurs d’équilibre utilisés sont calculés en fonction de la bande passante totale spécifiée. Pour baliser une route avec cette communauté étendue, définissez une déclaration de stratégie comme suit :
[edit policy-options]
user@host# show
policy-statement link-bw-t1 {
    then {
        community set bw-t1;
    }
    accept;
}
Appliquez cette stratégie d’importation aux sessions d’appairage BGP confrontées aux liaisons de bande passante asymétriques. Bien qu’en théorie, l’attribut community puisse être ajouté ou supprimé à n’importe quel endroit du réseau, dans le scénario décrit ci-dessus, l’application de la communauté en tant que stratégie d’importation dans la session d’appairage EBGP faisant face au lien externe permet à cet attribut d’influencer la décision du multichemin local et est potentiellement plus facile à gérer.
Topologie
La figure 3 illustre la topologie utilisée dans cet exemple.
de charge BGP
La configuration rapide de la CLI montre la configuration de tous les appareils de la Figure 3. La section#d15e120__d15e383 décrit les étapes sur l’appareil R1.
La configuration
Procédure
Configuration rapide de la CLI
Pour configurer rapidement cet exemple, copiez les commandes suivantes, collez-les dans un fichier texte, supprimez les sauts de ligne, modifiez tous les détails nécessaires pour qu’ils correspondent à votre configuration réseau, puis copiez-collez les commandes dans le CLI au niveau de la [edit] hiérarchie.
Appareil R1
set interfaces ge-1/2/0 unit 0 description R1->R3
set interfaces ge-1/2/0 unit 0 family inet address 10.0.0.1/30
set interfaces ge-1/2/1 unit 0 description R1->R2
set interfaces ge-1/2/1 unit 0 family inet address 10.0.1.2/30
set interfaces lo0 unit 0 family inet address 192.168.0.1/32
set protocols bgp group external type external
set protocols bgp group external import bw-dis
set protocols bgp group external peer-as 64501
set protocols bgp group external multipath
set protocols bgp group external neighbor 10.0.1.1
set protocols bgp group external neighbor 10.0.0.2
set policy-options policy-statement bw-dis term a from protocol bgp
set policy-options policy-statement bw-dis term a from neighbor 10.0.1.1
set policy-options policy-statement bw-dis term a then community add bw-high
set policy-options policy-statement bw-dis term a then accept
set policy-options policy-statement bw-dis term b from protocol bgp
set policy-options policy-statement bw-dis term b from neighbor 10.0.0.2
set policy-options policy-statement bw-dis term b then community add bw-low
set policy-options policy-statement bw-dis term b then accept
set policy-options policy-statement loadbal from route-filter 10.0.0.0/16 orlonger
set policy-options policy-statement loadbal then load-balance per-packet
set policy-options community bw-high members bandwidth:65000:60000000
set policy-options community bw-low members bandwidth:65000:40000000
set routing-options autonomous-system 64500
set routing-options forwarding-table export loadbal
Appareil R2
set interfaces ge-1/2/0 unit 0 description R2->R1
set interfaces ge-1/2/0 unit 0 family inet address 10.0.1.1/30
set interfaces ge-1/2/1 unit 0 description R2->R3
set interfaces ge-1/2/1 unit 0 family inet address 10.0.2.2/30
set interfaces ge-1/2/1 unit 0 family iso
set interfaces lo0 unit 0 family inet address 192.168.0.2/32
set interfaces lo0 unit 0 family iso address 49.0001.1921.6800.0002.00
set protocols bgp group external type external
set protocols bgp group external export bgp-default
set protocols bgp group external export send-direct
set protocols bgp group external peer-as 64500
set protocols bgp group external multipath
set protocols bgp group external neighbor 10.0.1.2
set protocols isis interface ge-1/2/1.0
set protocols isis interface lo0.0
set policy-options policy-statement bgp-default from protocol static
set policy-options policy-statement bgp-default from route-filter 172.16.0.0/16 exact
set policy-options policy-statement bgp-default then accept
set policy-options policy-statement send-direct term 1 from protocol direct
set policy-options policy-statement send-direct term 1 then accept
set routing-options static route 172.16.0.0/16 discard
set routing-options static route 172.16.0.0/16 no-install
set routing-options autonomous-system 64501
Appareil R3
set interfaces ge-1/2/0 unit 0 description R3->R2
set interfaces ge-1/2/0 unit 0 family inet address 10.0.2.1/30
set interfaces ge-1/2/0 unit 0 family iso
set interfaces ge-1/2/1 unit 0 description R3->R1
set interfaces ge-1/2/1 unit 0 family inet address 10.0.0.2/30
set interfaces lo0 unit 0 family inet address 192.168.0.3/32
set interfaces lo0 unit 0 family iso address 49.0001.1921.6800.0003.00
set protocols bgp group external type external
set protocols bgp group external export send-direct
set protocols bgp group external export bgp-default
set protocols bgp group external peer-as 64500
set protocols bgp group external multipath
set protocols bgp group external neighbor 10.0.0.1
set protocols isis interface ge-1/2/0.0
set protocols isis interface lo0.0
set policy-options policy-statement bgp-default from protocol static
set policy-options policy-statement bgp-default from route-filter 172.16.0.0/16 exact
set policy-options policy-statement bgp-default then accept
set policy-options policy-statement send-direct term 1 from protocol direct
set policy-options policy-statement send-direct term 1 then accept
set routing-options static route 172.16.0.0/16 discard
set routing-options static route 172.16.0.0/16 no-install
set routing-options autonomous-system 64501
Procédure étape par étape
L’exemple suivant nécessite que vous naviguiez à différents niveaux dans la hiérarchie de configuration. Pour plus d’informations sur la navigation dans la CLI, reportez-vous à la section Utilisation de l’éditeur CLI en mode configuration dans le Guide de l’utilisateur de la CLI de Junos OS.
Pour configurer les sessions d’pair BGP :
Configurez les interfaces.
user@R1# set ge-1/2/0 unit 0 description R1->R3
user@R1# set ge-1/2/0 unit 0 family inet address 10.0.0.1/30
user@R1# set ge-1/2/1 unit 0 description R1->R2
user@R1# set ge-1/2/1 unit 0 family inet address 10.0.1.2/30
user@R1# set lo0 unit 0 family inet address 192.168.0.1/32
Configurez le groupe BGP.
[edit protocols bgp group external]
user@R1# set type external
user@R1# set import bw-dis
user@R1# set peer-as 64501
user@R1# set neighbor 10.0.1.1
user@R1# set neighbor 10.0.0.2
Activez le groupe BGP pour utiliser plusieurs chemins.
Remarque :Pour désactiver la vérification par défaut exigeant que les chemins acceptés par le multichemin BGP aient le même système autonome voisin (AS), incluez l’option
multiple-as. Utilisez l’optionmultiple-assi les voisins se trouvent dans des AS différents.[edit protocols bgp group external] user@R1# set multipath
Configurez la stratégie d’équilibrage de charge.
[edit policy-options policy-statement loadbal]
user@R1# set from route-filter 10.0.0.0/16 orlonger
user@R1# set then load-balance per-packet
Appliquez la politique d’équilibrage de charge.
[edit routing-options]
user@R1# set forwarding-table export loadbal
Configurez les membres de la communauté BGP.
Cet exemple suppose une bande passante de 1 Gbit/s et alloue 60 % au bw-high et 40 % au bw-low. Il n’est pas nécessaire que la bande passante de référence soit la même que la bande passante de la liaison.
[edit policy-options]
user@R1# set community bw-high members bandwidth:65000:60000000
user@R1# set community bw-low members bandwidth:65000:40000000
Configurez la politique de distribution de la bande passante.
[edit policy-options bw-dis]
user@R1# set term a from protocol bgp
user@R1# set term a from neighbor 10.0.1.1
user@R1# set term a then community add bw-high
user@R1# set term a then accept
user@R1# set term b from protocol bgp
user@R1# set term b from neighbor 10.0.0.2
user@R1# set term b then community add bw-low
user@R1# set term b then accept
Configurez le numéro du système autonome local (AS).
[edit routing-options]
user@R1# set autonomous-system 64500
Résultats
En mode configuration, confirmez votre configuration en entrant les show interfacescommandes , show protocolsshow policy-options, , et show routing-options . Si la sortie n’affiche pas la configuration prévue, répétez les instructions de cet exemple pour corriger la configuration.
user@R1# show interfaces
ge-1/2/0 {
    unit 0 {
        description R1->R3;
        family inet {
            address 10.0.0.1/30;
        }
    }
}
ge-1/2/1 {
    unit 0 {
        description R1->R2;
        family inet {
            address 10.0.1.2/30;
        }
    }
}
lo0 {
    unit 0 {
        family inet {
            address 192.168.0.1/32;
        }
    }
}
user@R1# show protocols
bgp {
    group external {
        type external;
        import bw-dis;
        peer-as 64501;
        multipath;
        neighbor 10.0.1.1;
        neighbor 10.0.0.2;
    }
}
user@R1# show policy-options
policy-statement bw-dis {
    term a {
        from {
            protocol bgp;
            neighbor 10.0.1.1;
        }
        then {
            community add bw-high;
            accept;
        }
    }
    term b {
        from {
            protocol bgp;
            neighbor 10.0.0.2;
        }
        then {
            community add bw-low;
            accept;
        }
    }
}
policy-statement loadbal {
    from {
        route-filter 10.0.0.0/16 orlonger;
    }
    then {
        load-balance per-packet;
    }
}
community bw-high members bandwidth:65000:60000000;
community bw-low members bandwidth:65000:40000000;
user@R1# show routing-options
autonomous-system 64500;
forwarding-table {
    export loadbal;
}
Si vous avez terminé de configurer l’appareil, entrez en commit mode configuration.
Vérification
Confirmez que la configuration fonctionne correctement :
Vérification des routes
Objet
Vérifiez que les deux itinéraires sont sélectionnés et que les sauts suivants sur les itinéraires présentent un solde de 60 %/40 %.
Mesures à prendre
À partir du mode opérationnel, exécutez la show route protocol bgp detail commande.
user@R1> show route 172.16/16 protocol bgp detail
inet.0: 9 destinations, 13 routes (9 active, 0 holddown, 0 hidden)
172.16.0.0/16 (2 entries, 1 announced)
        *BGP    Preference: 170/-101
                Next hop type: Router, Next hop index: 262143
                Address: 0x93fc078
                Next-hop reference count: 3
                Source: 10.0.0.2
                Next hop: 10.0.0.2 via ge-1/2/0.0 balance 40%
                Next hop: 10.0.1.1 via ge-1/2/1.0 balance 60%, selected
                State: **Active Ext>
                Local AS: 64500 Peer AS: 64501
                Age: 3:22:55
                Task: BGP_64501.10.0.0.2+55344
                Announcement bits (1): 0-KRT
                AS path: 64501 I
                Communities: bandwidth:65000:40000000
                Accepted Multipath
                Localpref: 100
                Router ID: 192.168.0.3
         BGP    Preference: 170/-101
                Next hop type: Router, Next hop index: 658
                Address: 0x9260520
                Next-hop reference count: 4
                Source: 10.0.1.1
                Next hop: 10.0.1.1 via ge-1/2/1.0, selected
                State: <NotBest Ext>
                Inactive reason: Not Best in its group - Active preferred
                Local AS: 64500 Peer AS: 64501
                Age: 3:22:55
                Task: BGP_65001.10.0.1.1+62586
                AS path: 64501 I
                Communities: bandwidth:65000:60000000
                Accepted MultipathContrib
                Localpref: 100
                Router ID: 192.168.0.2
user@R1> show route 10.0.2.0 protocol bgp detail
inet.0: 9 destinations, 13 routes (9 active, 0 holddown, 0 hidden)
10.0.2.0/30 (2 entries, 1 announced)
        *BGP    Preference: 170/-101
                Next hop type: Router, Next hop index: 262143
                Address: 0x93fc078
                Next-hop reference count: 3
                Source: 10.0.1.1
                Next hop: 10.0.0.2 via ge-1/2/0.0 balance 40%
                Next hop: 10.0.1.1 via ge-1/2/1.0 balance 60%, selected
                State: <Active Ext>
                Local AS: 64500 Peer AS: 64501
                Age: 3:36:37
                Task: BGP_65001.10.0.1.1+62586
                Announcement bits (1): 0-KRT
                AS path: 64501 I
                Communities: bandwidth:65000:60000000
                Accepted Multipath
                Localpref: 100
                Router ID: 192.168.0.2
         BGP    Preference: 170/-101
                Next hop type: Router, Next hop index: 657
                Address: 0x92604d8
                Next-hop reference count: 4
                Source: 10.0.0.2
                Next hop: 10.0.0.2 via ge-1/2/0.0, selected
                State: <NotBest Ext>
                Inactive reason: Not Best in its group - Active preferred
                Local AS: 64500 Peer AS: 65001
                Age: 3:36:36
                Task: BGP_65001.10.0.0.2+55344
                AS path: 64501 I
                Communities: bandwidth:65000:40000000
                Accepted MultipathContrib
                Localpref: 100
                Router ID: 192.168.0.3
Signification
Le chemin actif, indiqué par un astérisque (*), comporte deux sauts suivants : 10.0.1.1 et 10.0.0.2 vers la destination 172.16/16.
De même, le chemin actif, indiqué par un astérisque (*), comporte deux sauts suivants : 10.0.1.1 et 10.0.0.2 vers la destination 10.0.2.0.
Dans les deux cas, le saut suivant 10.0.1.1 est copié du chemin inactif vers le chemin actif.
Le solde de 40 % et 60 % est indiqué dans la show route production. Cela indique que le trafic est réparti entre deux sauts suivants et que 60 % du trafic suit le premier chemin, tandis que 40 % suit le second chemin.
Publicité de la bande passante agrégée sur les liens BGP externes pour l’équilibrage de charge Présentation
Un pair BGP qui reçoit plusieurs chemins de ses homologues internes équilibre la charge entre ces chemins. Dans les versions antérieures à 17.4 de Junos OS, un interlocuteur BGP recevant plusieurs chemins de ses homologues internes annonçait uniquement la bande passante associée à la route active. BGP utilise la communauté étendue de bande passante de liens pour annoncer la bande passante agrégée de plusieurs routes sur des liens externes. Le BGP calcule la bande passante agrégée des trajets multiples dont l’allocation de bande passante est inégale et annonce la bande passante agrégée aux homologues BGP externes. Un seuil de bande passante agrégée peut être configuré pour restreindre l’utilisation de la bande passante d’un groupe BGP. Les routes IPv4 et IPv6, y compris les adresses anycast, prennent en charge la bande passante agrégée.
Pour annoncer la bande passante agrégée des routes multichemins et définir un seuil maximal, configurez une stratégie aggregate-bandwidth avec et limit-bandwidth des actions au niveau de la hiérarchie [edit policy-options, policy-statement name then].
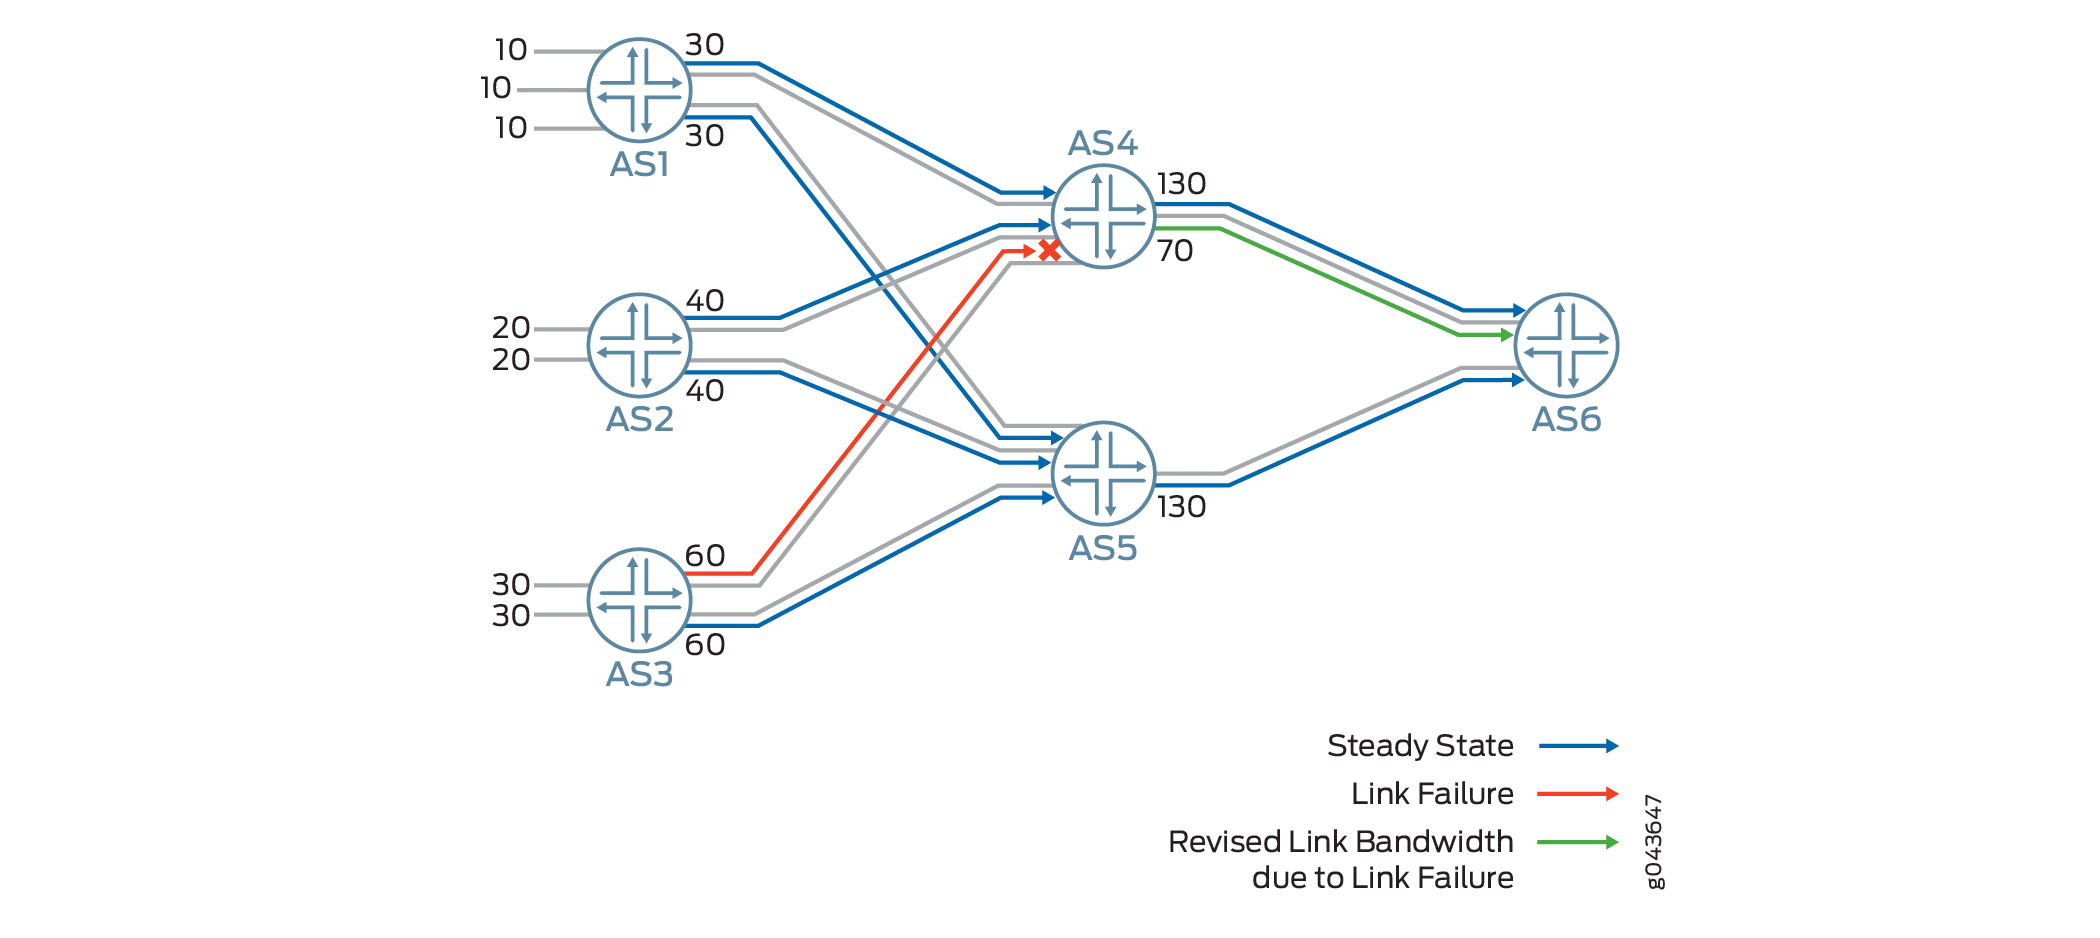 charge
Sur la Figure 4, le système autonome 1 (AS1) agrège la bande passante de ses 3 routes multichemins vers un préfixe distant et l’annonce au système autonome 4 (AS4) avec une bande passante de 30 en utilisant la communauté étendue de bande passante de liaison. En cas de défaillance de liaison entre AS3 et AS4, AS4 soustrait 60 de la bande passante annoncée à AS6 et modifie la bande passante annoncée de 130 à 70.
Lorsque l’une des liaisons multichemins tombe en panne, BGP réannonce la route en soustrayant la bande passante de la liaison défaillante de la communauté de bande passante de la liaison sortante. S’il s’avère que la bande passante agrégée des liens dépasse la limite configurée, la bande passante agrégée annoncée est tronquée à la limite de bande passante configurée entre les deux pairs.
Lorsqu’un pair BGP propage des routes multichemins configurées avec une communauté de bande passante agrégée, une nouvelle communauté de bande passante de liaison est ajoutée avec la somme de la bande passante des communautés de bande passante entrantes ou de ce préfixe. La bande passante de liaison disponible est dérivée dynamiquement de la vitesse de l’interface. La bande passante de la liaison est envoyée sous forme de communauté étendue transitive.
BGP peut communiquer les vitesses de liaison à des pairs distants, ce qui permet une meilleure optimisation de la distribution du trafic pour l’équilibrage de charge. Un groupe BGP peut envoyer la communauté étendue non transitive de bande passante de liaison sur une session EBGP pour les communautés étendues de bande passante de liens créées ou reçues et réannoncées. Pour configurer la communauté étendue de bande passante de liaison non transitive :
-
Inclure le
bandwidth-non-transitive:valuedans la stratégie d’exportation au niveau de la[edit policy-options community name members community-ids]hiérarchie. -
Incluez l’option
send-non-transitive-link-bandwidthau niveau de la[edit protocols bgp group (Protocols BGP) group-name]hiérarchie d’envoyer une communauté étendue de bande passante de liaison non transitive vers des voisins EBGP uniquement pour les communautés de bande passante de lien.
Pour permettre à l’appareil de détecter et de connecter automatiquement la communauté link-bandwidth sur une route lors de l’importation, incluez l’instruction auto-sense au niveau de la [edit protocols bgp group link-bandwidth] hiérarchie. Cette fonctionnalité facilite l’intégration d’appareils ayant différentes vitesses de transmission au sein du réseau, permettant une distribution efficace du trafic en fonction de la vitesse de la liaison.
Voir aussi
Exemple : configuration d’une stratégie pour annoncer la bande passante agrégée sur des liens BGP externes pour l’équilibrage de charge
Cet exemple montre comment configurer une stratégie pour annoncer la bande passante agrégée sur les liaisons BGP externes pour l’équilibrage de charge et pour spécifier un seuil pour la bande passante agrégée configurée. Le BGP additionne la bande passante disponible pour les liaisons par trajets multiples et calcule la bande passante agrégée. En cas de défaillance d’une liaison, la bande passante agrégée est ajustée pour refléter l’état actuel de la bande passante disponible.
Exigences
Cet exemple utilise les composants matériels et logiciels suivants :
-
Quatre routeurs avec capacité d’équilibrage de charge
-
Junos OS version 17.4 ou ultérieure s’exécutant sur tous les équipements
Vue d’ensemble
À partir de la version 17.4R1 de Junos OS, un interlocuteur BGP qui reçoit plusieurs chemins de ses homologues internes équilibre la charge du trafic entre ces chemins. Dans les versions antérieures de Junos OS, un interlocuteur BGP recevant plusieurs chemins de ses homologues internes annonçait uniquement la bande passante associée à la route active. BGP utilise une nouvelle communauté étendue de bande passante de liaison avec la bande passante agrégée pour baliser les chemins multiples et annonce la bande passante agrégée pour ces routes multiples sur sa liaison DMZ. Pour publier des routes multiples agrégées, configurez une stratégie aggregate-bandwidth avec et limit bandwidth des actions au niveau de la hiérarchie [edit policy-options, policy-statement name then].
Topologie
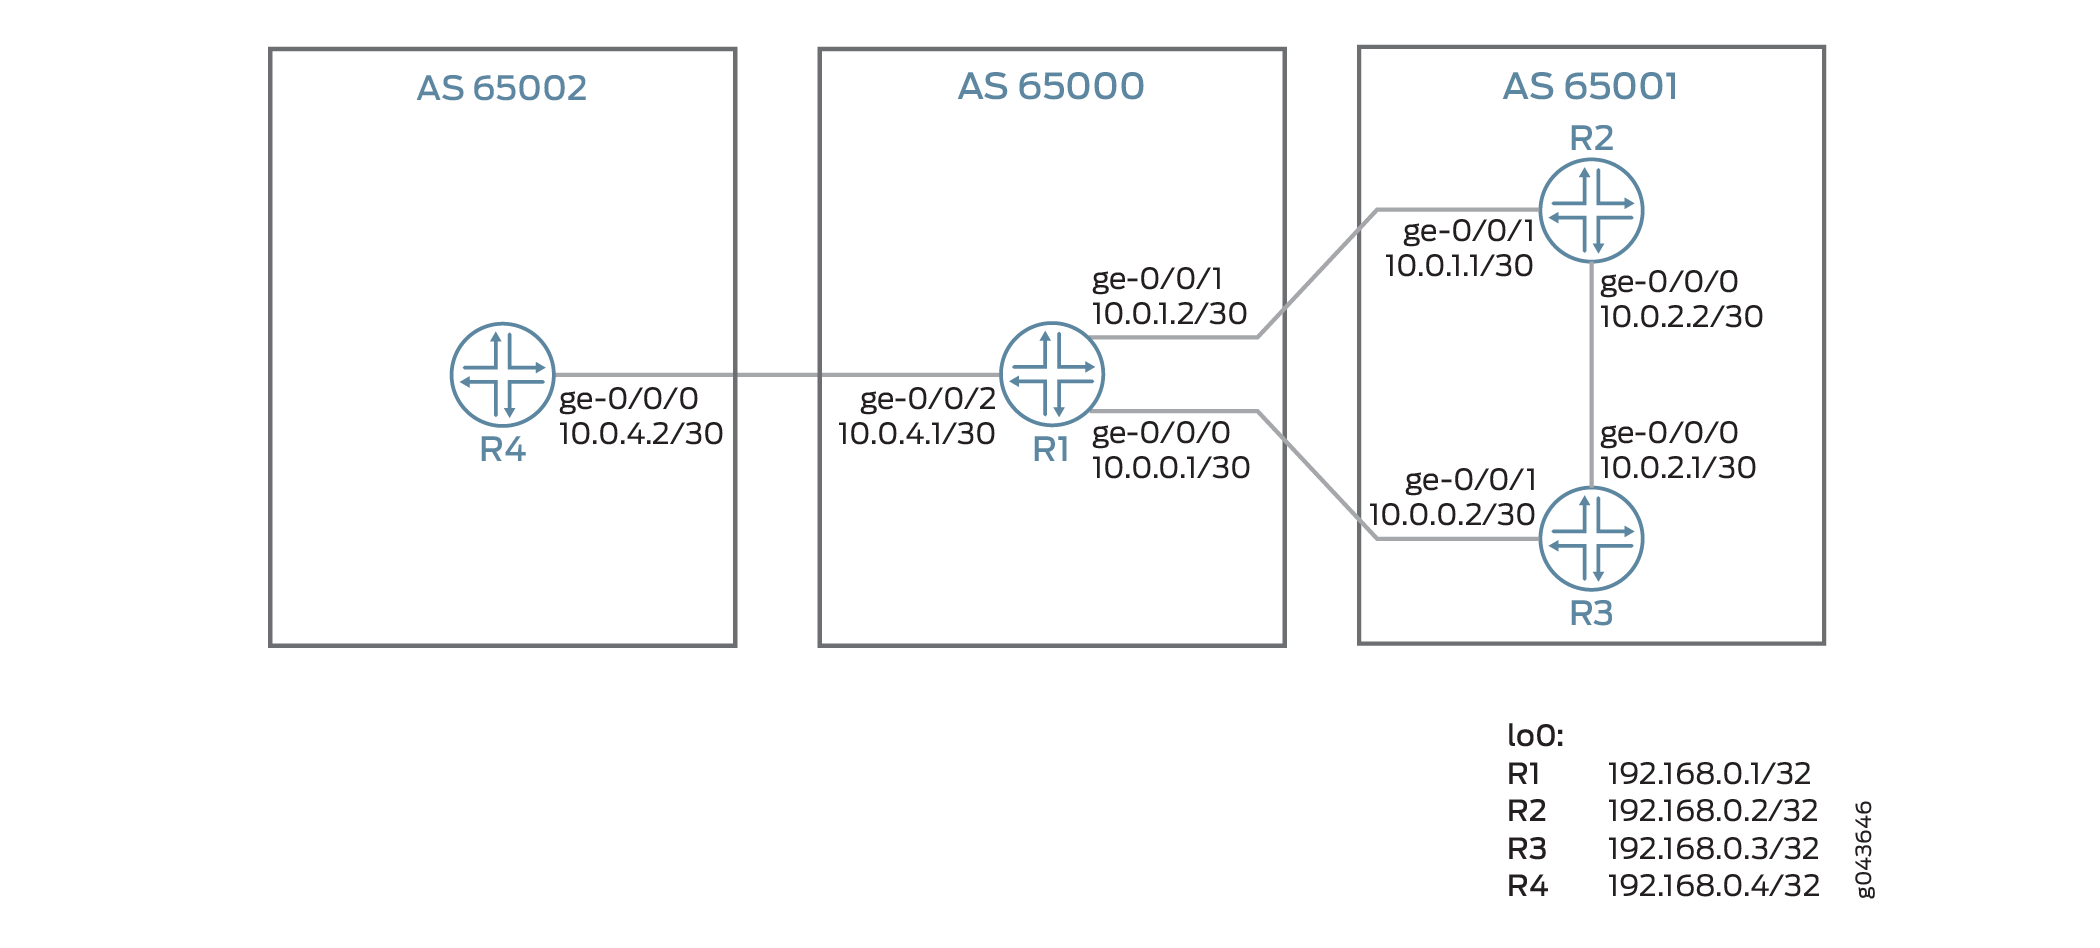 de charge
Sur la Figure 5, le routeur R1 équilibre la charge du trafic vers une destination distante via le saut suivant 10.0.1.1 dans le routeur R2 à 60 000 000 octets par seconde et via 10.0.0.2 dans le routeur R3 à 40 000 000 octets par seconde. Le routeur R1 annonce la destination 10.0.2.0 au routeur R4. Le routeur R1 calcule l’agrégation de la bande passante disponible, qui est de 10000000 octets par seconde. Cependant, une stratégie configurée sur le routeur R1 définit le seuil de bande passante agrégée à 80 000 000 octets par seconde. Par conséquent, R1 annonce 80 000 000 octets par seconde au lieu des 10 000 000 octets par seconde.
Si l’une des liaisons multichemin tombe en panne, la bande passante de la liaison défaillante n’est pas ajoutée à la bande passante agrégée annoncée aux voisins BGP.
La configuration
Configuration rapide de la CLI
Pour configurer rapidement cet exemple, copiez les commandes suivantes, collez-les dans un fichier texte, supprimez les sauts de ligne, modifiez tous les détails nécessaires pour qu’ils correspondent à votre configuration réseau, copiez et collez les commandes dans la CLI au niveau de la [edit] hiérarchie, puis entrez commit en mode configuration.
Routeur R1
set interfaces ge-0/0/0 unit 0 description R1->R3
set interfaces ge-0/0/0 unit 0 family inet address 10.0.0.1/30
set interfaces ge-0/0/1 unit 0 description R1->R2
set interfaces ge-0/0/1 unit 0 family inet address 10.0.1.2/30
set interfaces ge-0/0/2 unit 0 description R1->R4
set interfaces ge-0/0/2 unit 0 family inet address 10.0.4.1/30
set interfaces lo0 unit 0 family inet address 192.168.0.1/32
set routing-options autonomous-system 65000
set protocols bgp group external type external
set protocols bgp group external import bw-dis
set protocols bgp group external peer-as 65001
set protocols bgp group external multipath
set protocols bgp group external neighbor 10.0.1.1
set protocols bgp group external neighbor 10.0.0.2
set protocols bgp group external2 type external
set protocols bgp group external2 peer-as 65002
set policy-options policy-statement bw-dis term a from protocol bgp
set policy-options policy-statement bw-dis term a from neighbor 10.0.1.1
set policy-options policy-statement bw-dis term a then community add bw-high
set policy-options policy-statement bw-dis term a then accept
set policy-options policy-statement bw-dis term b from protocol bgp
set policy-options policy-statement bw-dis term b from neighbor 10.0.0.2
set policy-options policy-statement bw-dis term b then community add bw-low
set policy-options policy-statement bw-dis term b then accept
set policy-options policy-statement aggregate_bw_and_limit_capacity then aggregate-bandwidth
set policy-options policy-statement aggregate_bw_and_limit_capacity then limit-bandwidth 80000000
set policy-options policy-statement aggregate_bw_and_limit_capacity then accept
set protocols bgp group external2 neighbor 10.0.4.2 export aggregate_bw_and_limit_capacity
set policy-options policy-statement loadbal from route-filter 10.0.0.0/16 orlonger
set policy-options policy-statement loadbal then load-balance per-packet
set routing-options forwarding-table export loadbal
set policy-options community bw-high members bandwidth:65000:60000000
set policy-options community bw-low members bandwidth:65000:40000000
Routeur R2
set interfaces ge-0/0/0 unit 0 description R2->R3
set interfaces ge-0/0/0 unit 0 family inet address 10.0.2.2/30
set interfaces ge-0/0/0 unit 0 family iso
set interfaces ge-0/0/1 unit 0 description R2->R1
set interfaces ge-0/0/1 unit 0 family inet address 10.0.1.1/30
set interfaces lo0 unit 0 family inet address 192.168.0.2/32
set interfaces lo0 unit 0 family iso address 49.0001.1921.6800.0002.00
set routing-options static route 172.16.0.0/16 discard
set routing-options static route 172.16.0.0/16 no-install
set routing-options autonomous-system 65001
set protocols bgp group external type external
set protocols bgp group external export bgp-default
set protocols bgp group external export send-direct
set protocols bgp group external peer-as 65000
set protocols bgp group external multipath
set protocols bgp group external neighbor 10.0.1.2
set protocols isis interface ge-0/0/0.0
set protocols isis interface lo0.0
set policy-options policy-statement bgp-default from protocol static
set policy-options policy-statement bgp-default from route-filter 172.16.0.0/16 exact
set policy-options policy-statement bgp-default then accept
set policy-options policy-statement send-direct term 1 from protocol direct
set policy-options policy-statement send-direct term 1 then accept
Routeur R3
set interfaces ge-0/0/0 description R3->R2
set interfaces ge-0/0/0 unit 0 family inet address 10.0.2.1/30
set interfaces ge-0/0/0 unit 0 family iso
set interfaces ge-0/0/1 unit 0 description R3->R1
set interfaces ge-0/0/1 unit 0 family inet address 10.0.0.2/30
set interfaces lo0 unit 0 family inet address 192.168.0.3/32
set interfaces lo0 unit 0 family iso address 49.0001.1921.6800.0003.00
set routing-options static route 172.16.0.0/16 discard
set routing-options static route 172.16.0.0/16 no-install
set routing-options autonomous-system 65001
set protocols bgp group external type external
set protocols bgp group external export bgp-default
set protocols bgp group external export send-direct
set protocols bgp group external peer-as 65000
set protocols bgp group external multipath
set protocols bgp group external neighbor 10.0.0.1
set protocols isis interface ge-0/0/0.0
set protocols isis interface lo0.0
set policy-options policy-statement bgp-default from protocol static
set policy-options policy-statement bgp-default from route-filter 172.16.0.0/16 exact
set policy-options policy-statement bgp-default then accept
set policy-options policy-statement send-direct term 1 from protocol direct
set policy-options policy-statement send-direct term 1 then accept
Routeur R4
set interfaces ge-0/0/0 unit 0 description R4->R1
set interfaces ge-0/0/0 unit 0 family inet address 10.0.4.2/30
set interfaces lo0 unit 0 family inet address 192.168.0.4/32
set routing-options autonomous-system 65002
set protocols bgp group external type external
set protocols bgp group external peer-as 65000
set protocols bgp group external neighbor 10.0.4.1
Configuration des routeurs, à partir de R1
Procédure étape par étape
L’exemple suivant nécessite que vous naviguiez à différents niveaux dans la hiérarchie de configuration. Pour plus d’informations sur la navigation dans la CLI, consultez Utilisation de l’éditeur CLI en mode configuration dans le Guide de l’utilisateur de la CLI.
Pour configurer une stratégie d’annonce d’une bande passante agrégée aux homologues BGP (en commençant par le routeur R1) :
Répétez cette procédure sur les routeurs R2, R3 et R4 après avoir modifié les noms, adresses et autres paramètres d’interface appropriés.
-
Configurez les interfaces avec des adresses IPv4.
>[edit interfaces]
user@R1# set ge-0/0/0 unit 0 description R1->R3
user@R1# set ge-0/0/0 unit 0 family inet address 10.0.0.1/30
user@R1# set ge-0/0/1 unit 0 description R1->R2
user@R1# set ge-0/0/1 unit 0 family inet address 10.0.1.2/30
user@R1# set ge-0/0/2 unit 0 description R1->R4
user@R1# set ge-0/0/2 unit 0 family inet address 10.0.4.1/30
-
Configurez l’adresse de bouclage.
[edit interfaces]
user@R1# set lo0 unit 0 family inet address 192.168.0.1/32
-
Configurez le système autonome pour les hôtes BGP.
[edit routing-options]
user@R1# set autonomous-system 65000
-
Configurez EBGP sur les routeurs de périphérie externes.
[edit protocols]
user@R1# set bgp group external type external
user@R1# set bgp group external import bw-dis
user@R1# set bgp group external peer-as 65001
user@R1# set bgp group external multipath
user@R1# set bgp group external neighbor 10.0.1.1
user@R1# set bgp group external neighbor 10.0.0.2
user@R1# set bgp group external2 type external
user@R1# set bgp group external2 peer-as 65002
-
Définissez une stratégie de distribution de bande passante pour affecter une communauté à large bande passante au trafic destiné au routeur R3.
[edit policy-options]
user@R1# set policy-statement bw-dis term a from protocol bgp
user@R1# set policy-statement bw-dis term a from neighbor 10.0.1.1
user@R1# set policy-statement bw-dis term a then community add bw-high
user@R1# set policy-statement bw-dis term a then accept
-
Définissez une stratégie de distribution de bande passante pour affecter une communauté à faible bande passante au trafic destiné au routeur R2.
[edit policy-options]
user@R1# set policy-statement bw-dis term b from protocol bgp
user@R1# set policy-statement bw-dis term b from neighbor 10.0.0.2
user@R1# set policy-statement bw-dis term b then community add bw-low
user@R1# set policy-statement bw-dis term b then accept
-
Activez la fonctionnalité pour annoncer une bande passante agrégée de 80 000 000 octets au routeur homologue EBGP R4 sur des sessions BGP.
[edit policy-options]
user@R1# set policy-statement aggregate_bw_and_limit_capacity then aggregate-bandwidth
user@R1# set policy-statement aggregate_bw_and_limit_capacity then limit-bandwidth 80000000
user@R1# set policy-statement aggregate_bw_and_limit_capacity then accept
-
Appliquez la stratégie aggregate_bw_and limit_capacity au groupe
external2EBGP .[edit protocols] user@R1# set bgp group external2 neighbor 10.0.4.2 export aggregate_bw_and_limit_capacity
-
Définir une stratégie d’équilibrage de charge.
[edit policy-options]
user@R1# set policy-statement loadbal from route-filter 10.0.0.0/16 orlonger
user@R1# set policy-statement loadbal then load-balance per-packet
-
Appliquez la politique d’équilibrage de charge.
[edit routing-options]
user@R1# set forwarding-table export loadbal
-
Configurez les membres de la communauté BGP. Le premier nombre de 16 bits représente le système autonome local. Le deuxième nombre de 32 bits représente la bande passante de la liaison en octets par seconde. Configurez une communauté avec 60 % d’une liaison 1 Gbit/s et une
bw-highautre communautébw-lowavec 40 % d’une liaison 1 Gbit/s.Configurez 60 % d’une liaison 1 Gbit/s vers la communauté bw-high et 40 % vers la communauté bw-low.
[edit policy-options]
user@R1# set community bw-high members bandwidth:65000:60000000
user@R1# set community bw-low members bandwidth:65000:40000000
Résultats
En mode configuration, confirmez votre configuration en entrant les show interfacescommandes , show protocolsshow routing-options, , et show policy-options . Si la sortie n’affiche pas la configuration prévue, répétez les instructions de cet exemple pour corriger la configuration.
[edit]
user@R1# show interfaces
interfaces {
    ge-0/0/0 {
        unit 0 {
            description R1->R3;
            family inet {
                address 10.0.0.1/30;
            }
        }
    }
    ge-0/0/1 {
        unit 0 {
            description R1->R2;
            family inet {
                address 10.0.1.2/30;
            }
        }
    }
    ge-0/0/2 {
        unit 0 {
            description R1->R4;
            family inet {
                address 10.0.4.1/30;
            }
        }
    }
    lo0 {
        unit 0 {
            family inet {
                address 192.168.0.1/32;
            }
        }
    }
}
[edit]
user@R1# show protocols
protocols {
    bgp {
        group external {
            type external;
            import bw-dis;
            peer-as 65001;
            multipath;
            neighbor 10.0.1.1;
            neighbor 10.0.0.2;
        }
        group external2 {
            type external;
            peer-as 65002;
            neighbor 10.0.4.2 {
                export aggregate_bw_and_limit_capacity;
            }
        }
    }
}
[edit]
user@R1# show routing-options
routing-options {
    autonomous-system 65000;
    forwarding-table {
        export loadbal;
    }
}
[edit]
user@R1# show policy-options
policy-options {
    policy-statement bw-dis {
        term a {
            from {
                protocol bgp;
                neighbor 10.0.1.1;
            }
            then {
                community add bw-high;
                accept;
            }
        }
        term b {
            from {
                protocol bgp;
                neighbor 10.0.0.2;
            }
            then {
                community add bw-low;
                accept;
            }
        }
    }
    policy-statement aggregate_bw_and_limit_capacity {
        then {
            aggregate-bandwidth;
            limit-bandwidth 80000000;
            accept;
        }
    }
    policy-statement loadbal {
        from {
            route-filter 10.0.0.0/16 orlonger;
        }
        then {
            load-balance per-packet;
        }
    }
    community bw-high members bandwidth:65000:60000000;
    community bw-low members bandwidth:65000:40000000;
}
Vérification
- Vérification de l’établissement d’une session BGP
- Vérification de la présence de la bande passante agrégée dans chaque chemin
- Vérifier que le routeur R1 annonce la bande passante agrégée à son voisin R4
Vérification de l’établissement d’une session BGP
Objet
Pour vérifier que l’appairage BGP est terminé et qu’une session BGP est établie entre les routeurs,
Mesures à prendre
user@R1> show bgp summary
Groups: 2 Peers: 3 Down peers: 0
Table          Tot Paths  Act Paths Suppressed    History Damp State    Pending
inet.0
                      12          8          0          0          0          0
Peer                     AS      InPkt     OutPkt    OutQ   Flaps Last Up/Dwn State|#Active/Received/Accepted/Damped...
10.0.0.2              65001        153        149       0       0     1:07:23 4/6/6/0            0/0/0/0
10.0.1.1              65001        229        226       0       0     1:41:44 4/6/6/0            0/0/0/0
10.0.4.2              65002       1227       1227       0       0     9:10:27 0/0/0/0            0/0/0/0
Signification
Le routeur R1 a terminé l’appairage avec les routeurs R2, R3 et R4.
Vérification de la présence de la bande passante agrégée dans chaque chemin
Objet
Pour vérifier que la communauté étendue est présente pour chaque chemin de route.
Mesures à prendre
À partir du mode opérationnel, exécutez la show route protocol bgp detail commande.
user@R1> show route 10.0.2.0 protocol bgp detail
inet.0: 20 destinations, 26 routes (20 active, 0 holddown, 0 hidden)
10.0.2.0/30 (2 entries, 1 announced)
        *BGP    Preference: 170/-101
                Next hop type: Router, Next hop index: 0
                Address: 0xb618990
                Next-hop reference count: 3
                Source: 10.0.1.1
                Next hop: 10.0.0.2 via ge-0/0/0.0 balance 40%
                Session Id: 0x0
                Next hop: 10.0.1.1 via ge-0/0/1.0 balance 60%, selected
                Session Id: 0x0
                State: <Active Ext>
                Local AS: 65000 Peer AS: 65001
                Age: 20:33
                Validation State: unverified
                Task: BGP_65001.10.0.1.1
                Announcement bits (3): 0-KRT 2-BGP_Listen.0.0.0.0+179 3-BGP_RT_Background
                AS path: 65001 I
                Communities: bandwidth:65000:60000000
                Accepted Multipath
                Localpref: 100
                Router ID: 128.49.121.137
         BGP    Preference: 170/-101
                Next hop type: Router, Next hop index: 595
                Address: 0xb7a1330
                Next-hop reference count: 9
                Source: 10.0.0.2
                Next hop: 10.0.0.2 via ge-0/0/0.0, selected
                Session Id: 0x141
                State: <NotBest Ext>
                Inactive reason: Not Best in its group - Active preferred
                Local AS: 65000 Peer AS: 65001
                Age: 20:33
                Validation State: unverified
                Task: BGP_65001.10.0.0.2
                AS path: 65001 I
                Communities: bandwidth:65000:40000000
                Accepted MultipathContrib
                Localpref: 100
                Router ID: 128.49.121.132
Signification
Vérifier que le routeur R1 annonce la bande passante agrégée à son voisin R4
Objet
Pour vérifier que le routeur R1 annonce la bande passante agrégée à ses voisins externes.
Mesures à prendre
user@R1> show route advertising-protocol bgp 10.0.4.2 10.0.2.0/30 detail
inet.0: 20 destinations, 26 routes (20 active, 0 holddown, 0 hidden)
* 10.0.2.0/30 (2 entries, 1 announced)
 BGP group external2 type External
     Nexthop: Self
     AS path: [65000] 65001 I
     Communities: bandwidth:65000:80000000
Signification
Le routeur R1 annonce la bande passante agrégée de 80 000 000 octets à ses voisins.
Comprendre la publication de plusieurs chemins vers une destination unique dans BGP
Les homologues BGP annoncent des routes les uns vers les autres dans les messages de mise à jour. BGP stocke ses routes dans la table de routage de Junos OS (inet.0). Pour chaque préfixe de la table de routage, le processus de protocole de routage sélectionne un seul meilleur chemin, appelé chemin actif. À moins que vous ne configuriez BGP pour annoncer plusieurs chemins vers la même destination, BGP annonce uniquement le chemin actif.
Au lieu de publier uniquement le chemin actif vers une destination, vous pouvez configurer BGP pour annoncer plusieurs chemins vers la destination. Dans un système autonome (AS), la disponibilité de plusieurs points de sortie pour atteindre une destination offre les avantages suivants :
Tolérance aux pannes : la diversité des chemins permet de réduire le temps de restauration après une panne. Par exemple, après avoir reçu plusieurs chemins vers la même destination, une bordure peut précalculer un chemin de secours et l’avoir prêt de sorte que lorsque le chemin principal devient invalide, le périphérique de routage de bordure puisse l’utiliser pour rétablir rapidement la connectivité. Sans chemin de secours, le temps de restauration dépend de la reconvergence BGP, qui inclut les messages de retrait et d’annonce dans le réseau avant qu’un nouveau meilleur chemin puisse être appris.
Équilibrage de charge : la disponibilité de plusieurs chemins pour atteindre la même destination permet l’équilibrage de charge du trafic, si le routage au sein de l’AS répond à certaines contraintes.
Maintenance : la disponibilité d’autres points de sortie permet un fonctionnement de maintenance fluide des routeurs.
Les limitations suivantes s’appliquent à la publication de routes multiples dans BGP :
-
Familles d’adresses prises en charge :
-
IPv4 unicast (
family inet unicast) -
IPv6 unicast (
family inet6 unicast) -
IPv4 étiqueté unicast (
family inet labeled-unicast) -
IPv6 étiqueté unicast (
family inet6 labeled-unicast) -
VPN IPv4 unicast (
family inet-vpn unicast) -
VPN IPv6 unicast (
family inet6-vpn unicast)
L’exemple suivant illustre la configuration des familles de unicast VPN IPv4 unicast et VPN IPv6 :
bgp { group <group-name> { family inet-vpn unicast { add-path { send { include-backup-path include-backup-path; multipath; path-count path-count; path-selection-mode { (all-paths | equal-cost-paths); } prefix-policy [ policy-names ... ]; } receive; } family inet6-vpn unicast { add-path { send { include-backup-path include-backup-path; multipath; path-count path-count; path-selection-mode { (all-paths | equal-cost-paths); } prefix-policy [ policy-names ... ]; } receive; } } } -
-
Nous prenons en charge
add-pathles homologues internes BGP (IBGP) et externes BGP (EBGP).Remarque :-
Nous prenons en charge la réception d’add-path pour les homologues IBGP et EBGP.
-
Nous ne prenons en charge add-path send que pour les pairs IBGP.
-
Nous ne prenons pas en charge l’envoi d’add-path pour les pairs EBGP. Lorsque vous essayez de valider la configuration pour add-path send pour les homologues EBGP, la CLI génère une erreur de validation.
-
-
Instance principale uniquement. Pas de prise en charge des instances de routage.
-
Le redémarrage progressif et le routage actif ininterrompu (NSR) sont pris en charge.
-
Pas de prise en charge du protocole de surveillance BGP (BMP).
-
Les stratégies de préfixe vous permettent de filtrer les routes sur un routeur configuré pour annoncer plusieurs chemins vers une destination. Les stratégies de préfixe ne peuvent correspondre qu’aux préfixes. Ils ne peuvent pas correspondre aux attributs de route et ils ne peuvent pas modifier les attributs des routes.
À partir de la version 18.4R1 de Junos OS, BGP peut annoncer un maximum de 2 routes d’add-path en plus des multiples chemins ECMP.
Pour publier tous les chemins d’accès d’ajout jusqu’à 64 chemins d’accès ou uniquement les chemins d’accès à coût égal, incluez path-selection-mode au niveau de la [edit protocols bgp group group-name family name addpath send] hiérarchie. Vous ne pouvez pas activer les deux multipath et path-selection-mode en même temps.
Voir aussi
Exemple : publication de plusieurs chemins dans BGP
Dans cet exemple, les routeurs BGP sont configurés pour annoncer plusieurs chemins au lieu d’annoncer uniquement le chemin actif. La publication de plusieurs chemins dans BGP est spécifiée dans RFC 7911, Publication de plusieurs chemins dans BGP.
Exigences
Cet exemple utilise les composants matériels et logiciels suivants :
Huit appareils compatibles BGP.
Cinq des équipements compatibles BGP n’ont pas nécessairement besoin d’être des routeurs. Il peut s’agir, par exemple, de commutateurs Ethernet EX Series.
Trois des équipements compatibles BGP sont configurés pour envoyer ou recevoir plusieurs chemins (ou les deux envoyer et recevoir plusieurs chemins). Ces trois équipements compatibles BGP doivent être des routeurs de périphérie multiservice M Series, des plates-formes de routage universelles MX Series 5G ou des routeurs centraux T Series.
Les trois routeurs doivent exécuter Junos OS version 11.4 ou ultérieure.
Vue d’ensemble
Les instructions suivantes sont utilisées pour configurer plusieurs chemins d’accès à une destination :
[edit protocols bgp group group-name family family]
add-path {
    receive;
    send {
        include-backup-path include-backup-path;
        multipath;
        path-count path-count;
        path-selection-mode {
            (all-paths | equal-cost-paths);
        }
        prefix-policy [ policy-names ... ];
    }
}
Dans cet exemple, les routeurs R5, R6 et R7 redistribuent les routes statiques dans BGP. Le routeur R1 et le routeur R4 sont des réflecteurs de route. Le routeur R2 et le routeur R3 sont des clients du réflecteur de route R1. Le routeur R8 est un client du réflecteur de route R4.
La réflexion de route est facultative lorsque la publication de chemins multiples est activée dans BGP.
Avec cette add-path send path-count 6 configuration, le routeur R1 est configuré pour envoyer jusqu’à six chemins (par destination) au routeur R4.
Avec cette add-path receive configuration, le routeur R4 est configuré pour recevoir plusieurs chemins du routeur R1.
Avec cette add-path send path-count 6 configuration, le routeur R4 est configuré pour envoyer jusqu’à six chemins au routeur R8.
Avec cette add-path receive configuration, le routeur R8 est configuré pour recevoir plusieurs chemins du routeur R4.
La add-path send prefix-policy allow_199 configuration de la stratégie (ainsi que le filtre de route correspondant) limite le routeur R4 à l’envoi de plusieurs chemins pour la route 172.16.199.1/32 uniquement.
Diagramme de topologie
La figure 6 illustre la topologie utilisée dans cet exemple.
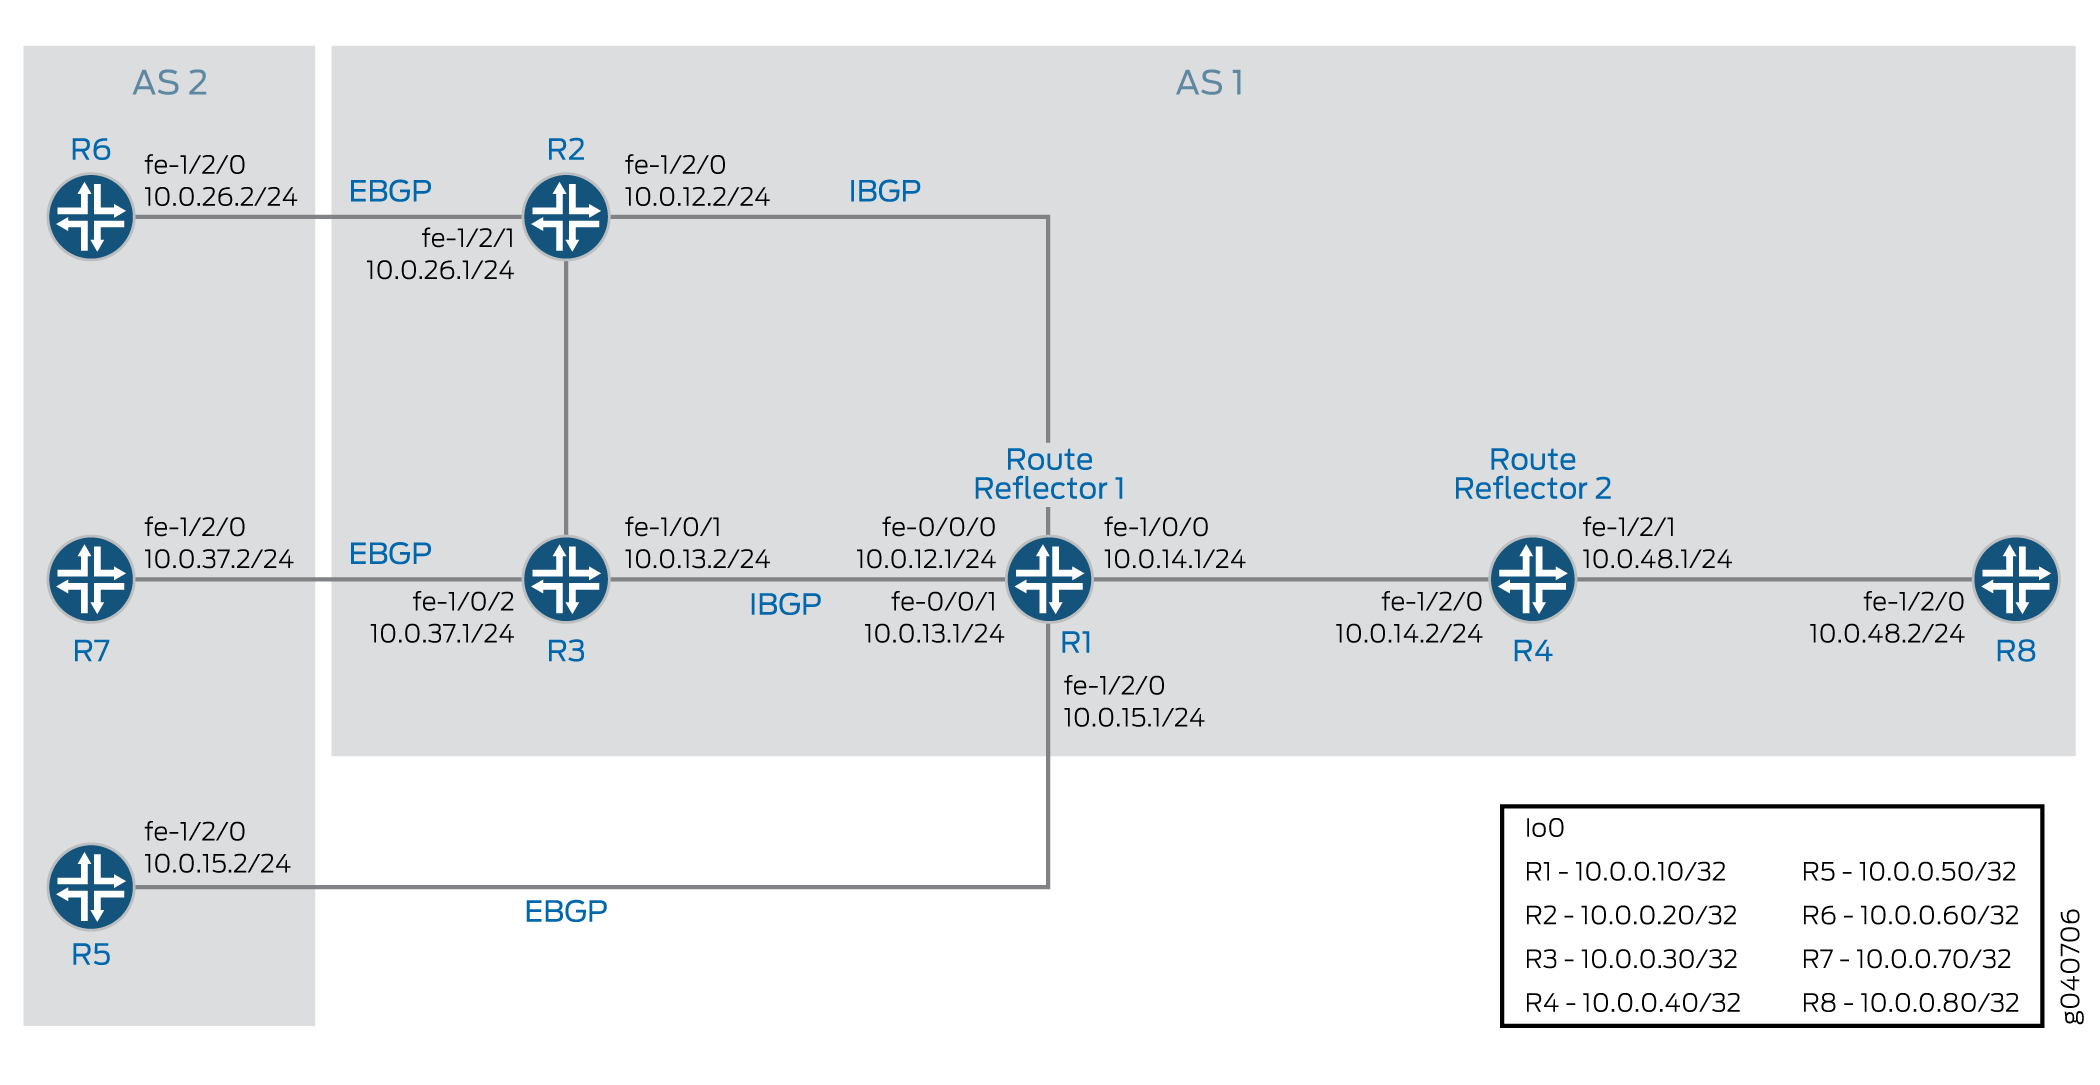
La configuration
- Configuration rapide de la CLI
- Configuration du routeur R1
- Configuration du routeur R2
- Configuration du routeur R3
- Configuration du routeur R4
- Configuration du routeur R5
- Configuration du routeur R6
- Configuration du routeur R7
- Configuration du routeur R8
- Résultats
Configuration rapide de la CLI
Pour configurer rapidement cet exemple, copiez les commandes suivantes, collez-les dans un fichier texte, supprimez les sauts de ligne, modifiez tous les détails nécessaires pour qu’ils correspondent à votre configuration réseau, puis copiez et collez les commandes dans le CLI au niveau de la [edit] hiérarchie.
Routeur R1
set interfaces fe-0/0/0 unit 12 family inet address 10.0.12.1/24
set interfaces fe-0/0/1 unit 13 family inet address 10.0.13.1/24
set interfaces fe-1/0/0 unit 14 family inet address 10.0.14.1/24
set interfaces fe-1/2/0 unit 15 family inet address 10.0.15.1/24
set interfaces lo0 unit 10 family inet address 10.0.0.10/32
set protocols bgp group rr type internal
set protocols bgp group rr local-address 10.0.0.10
set protocols bgp group rr cluster 10.0.0.10
set protocols bgp group rr neighbor 10.0.0.20
set protocols bgp group rr neighbor 10.0.0.30
set protocols bgp group e1 type external
set protocols bgp group e1 neighbor 10.0.15.2 local-address 10.0.15.1
set protocols bgp group e1 neighbor 10.0.15.2 peer-as 2
set protocols bgp group rr_rr type internal
set protocols bgp group rr_rr local-address 10.0.0.10
set protocols bgp group rr_rr neighbor 10.0.0.40 family inet unicast add-path send path-count 6
set protocols ospf area 0.0.0.0 interface lo0.10 passive
set protocols ospf area 0.0.0.0 interface fe-0/0/0.12
set protocols ospf area 0.0.0.0 interface fe-0/0/1.13
set protocols ospf area 0.0.0.0 interface fe-1/0/0.14
set protocols ospf area 0.0.0.0 interface fe-1/2/0.15
set routing-options router-id 10.0.0.10
set routing-options autonomous-system 1
Routeur R2
set interfaces fe-1/2/0 unit 21 family inet address 10.0.12.2/24
set interfaces fe-1/2/1 unit 26 family inet address 10.0.26.1/24
set interfaces lo0 unit 20 family inet address 10.0.0.20/32
set protocols bgp group rr type internal
set protocols bgp group rr local-address 10.0.0.20
set protocols bgp group rr neighbor 10.0.0.10 export set_nh_self
set protocols bgp group e1 type external
set protocols bgp group e1 neighbor 10.0.26.2 peer-as 2
set protocols ospf area 0.0.0.0 interface lo0.20 passive
set protocols ospf area 0.0.0.0 interface fe-1/2/0.21
set protocols ospf area 0.0.0.0 interface fe-1/2/1.28
set policy-options policy-statement set_nh_self then next-hop self
set routing-options autonomous-system 1
Routeur R3
set interfaces fe-1/0/1 unit 31 family inet address 10.0.13.2/24
set interfaces fe-1/0/2 unit 37 family inet address 10.0.37.1/24
set interfaces lo0 unit 30 family inet address 10.0.0.30/32
set protocols bgp group rr type internal
set protocols bgp group rr local-address 10.0.0.30
set protocols bgp group rr neighbor 10.0.0.10 export set_nh_self
set protocols bgp group e1 type external
set protocols bgp group e1 neighbor 10.0.37.2 peer-as 2
set protocols ospf area 0.0.0.0 interface lo0.30 passive
set protocols ospf area 0.0.0.0 interface fe-1/0/1.31
set protocols ospf area 0.0.0.0 interface fe-1/0/2.37
set policy-options policy-statement set_nh_self then next-hop self
set routing-options autonomous-system 1
Routeur R4
set interfaces fe-1/2/0 unit 41 family inet address 10.0.14.2/24
set interfaces fe-1/2/1 unit 48 family inet address 10.0.48.1/24
set interfaces lo0 unit 40 family inet address 10.0.0.40/32
set protocols bgp group rr type internal
set protocols bgp group rr local-address 10.0.0.40
set protocols bgp group rr family inet unicast add-path receive
set protocols bgp group rr neighbor 10.0.0.10
set protocols bgp group rr_client type internal
set protocols bgp group rr_client local-address 10.0.0.40
set protocols bgp group rr_client cluster 10.0.0.40
set protocols bgp group rr_client neighbor 10.0.0.80 family inet unicast add-path send path-count 6
set protocols bgp group rr_client neighbor 10.0.0.80 family inet unicast add-path send prefix-policy allow_199
set protocols ospf area 0.0.0.0 interface fe-1/2/0.41
set protocols ospf area 0.0.0.0 interface lo0.40 passive
set protocols ospf area 0.0.0.0 interface fe-1/2/1.48
set policy-options policy-statement allow_199 from route-filter 172.16.199.1/32 exact
set policy-options policy-statement allow_199 term match_199 from prefix-list match_199
set policy-options policy-statement allow_199 then add-path send-count 20
set policy-options policy-statement allow_199 then accept
set routing-options autonomous-system 1
Routeur R5
set interfaces fe-1/2/0 unit 51 family inet address 10.0.15.2/24
set interfaces lo0 unit 50 family inet address 10.0.0.50/32
set protocols bgp group e1 type external
set protocols bgp group e1 neighbor 10.0.15.1 export s2b
set protocols bgp group e1 neighbor 10.0.15.1 peer-as 1
set policy-options policy-statement s2b from protocol static
set policy-options policy-statement s2b from protocol direct
set policy-options policy-statement s2b then as-path-expand 2
set policy-options policy-statement s2b then accept
set routing-options autonomous-system 2
set routing-options static route 172.16.199.1/32 reject
set routing-options static route 172.16.198.1/32 reject
Routeur R6
set interfaces fe-1/2/0 unit 62 family inet address 10.0.26.2/24
set interfaces lo0 unit 60 family inet address 10.0.0.60/32
set protocols bgp group e1 type external
set protocols bgp group e1 neighbor 10.0.26.1 export s2b
set protocols bgp group e1 neighbor 10.0.26.1 peer-as 1
set policy-options policy-statement s2b from protocol static
set policy-options policy-statement s2b from protocol direct
set policy-options policy-statement s2b then accept
set routing-options autonomous-system 2
set routing-options static route 172.16.199.1/32 reject
set routing-options static route 172.16.198.1/32 reject
Routeur R7
set interfaces fe-1/2/0 unit 73 family inet address 10.0.37.2/24
set interfaces lo0 unit 70 family inet address 10.0.0.70/32
set protocols bgp group e1 type external
set protocols bgp group e1 neighbor 10.0.37.1 export s2b
set protocols bgp group e1 neighbor 10.0.37.1 peer-as 1
set policy-options policy-statement s2b from protocol static
set policy-options policy-statement s2b from protocol direct
set policy-options policy-statement s2b then accept
set routing-options autonomous-system 2
set routing-options static route 172.16.199.1/32 reject
Routeur R8
set interfaces fe-1/2/0 unit 84 family inet address 10.0.48.2/24
set interfaces lo0 unit 80 family inet address 10.0.0.80/32
set protocols bgp group rr type internal
set protocols bgp group rr local-address 10.0.0.80
set protocols bgp group rr neighbor 10.0.0.40 family inet unicast add-path receive
set protocols ospf area 0.0.0.0 interface lo0.80 passive
set protocols ospf area 0.0.0.0 interface fe-1/2/0.84
set routing-options autonomous-system 1
Configuration du routeur R1
Procédure étape par étape
L’exemple suivant vous oblige à naviguer à différents niveaux dans la hiérarchie de configuration. Pour plus d’informations sur la navigation dans la CLI, reportez-vous à la section Utilisation de l’éditeur CLI en mode configuration dans le Guide de l’utilisateur de la CLI de Junos OS.
Pour configurer le routeur R1 :
Configurez les interfaces vers le routeur R2, le routeur R3, le routeur R4 et le routeur R5, et configurez l’interface de bouclage (lo0).
[edit interfaces]
user@R1# set fe-0/0/0 unit 12 family inet address 10.0.12.1/24
user@R1# set fe-0/0/1 unit 13 family inet address 10.0.13.1/24
user@R1# set fe-1/0/0 unit 14 family inet address 10.0.14.1/24
user@R1# set fe-1/2/0 unit 15 family inet address 10.0.15.1/24
user@R1#set lo0 unit 10 family inet address 10.0.0.10/32
Configurez BGP sur les interfaces et configurez la réflexion de route IBGP.
[edit protocols bgp]
user@R1# set group rr type internal
user@R1# set group rr local-address 10.0.0.10
user@R1# set group rr cluster 10.0.0.10
user@R1# set group rr neighbor 10.0.0.20
user@R1# set group rr neighbor 10.0.0.30
user@R1# set group rr_rr type internal
user@R1# set group rr_rr local-address 10.0.0.10
user@R1# set group e1 type external
user@R1# set group e1 neighbor 10.0.15.2 local-address 10.0.15.1
user@R1# set group e1 neighbor 10.0.15.2 peer-as 2
Configurez le routeur R1 pour envoyer jusqu’à six chemins à son voisin, le routeur R4.
La destination des chemins peut être n’importe quelle destination que le routeur R1 peut atteindre via plusieurs chemins.
[edit protocols bgp]
user@R1# set group rr_rr neighbor 10.0.0.40 family inet unicast add-path send path-count 6
Configurez OSPF sur les interfaces.
[edit protocols ospf]
user@R1# set area 0.0.0.0 interface lo0.10 passive
user@R1# set area 0.0.0.0 interface fe-0/0/0.12
user@R1# set area 0.0.0.0 interface fe-0/0/1.13
user@R1# set area 0.0.0.0 interface fe-1/0/0.14
user@R1# set area 0.0.0.0 interface fe-1/2/0.15
Configurez l’ID du routeur et le numéro du système autonome.
[edit routing-options]
user@R1# set router-id 10.0.0.10
user@R1# set autonomous-system 1
Si vous avez terminé de configurer l’appareil, validez la configuration.
user@R1# commit
Résultats
En mode configuration, confirmez votre configuration en entrant les show interfacescommandes , show protocolsshow policy-options, , et show routing-options . Si la sortie n’affiche pas la configuration prévue, répétez les instructions de cet exemple pour corriger la configuration.
user@R1# show interfaces
fe-0/0/0 {
    unit 12 {
        family inet {
            address 10.0.12.1/24;
        }
    }
}
fe-0/0/1 {
    unit 13 {
        family inet {
            address 10.0.13.1/24;
        }
    }
}
fe-1/0/0 {
    unit 14 {
        family inet {
            address 10.0.14.1/24;
        }
    }
}
fe-1/2/0 {
    unit 15 {
        family inet {
            address 10.0.15.1/24;
        }
    }
}
lo0 {
    unit 10 {
        family inet {
            address 10.0.0.10/32;
        }
    }
}
user@R1# show protocols
bgp {
    group rr {
        type internal;
        local-address 10.0.0.10;
        cluster 10.0.0.10;
        neighbor 10.0.0.20;
        neighbor 10.0.0.30;
    }
    group e1 {
        type external;
        neighbor 10.0.15.2 {
            local-address 10.0.15.1;
            peer-as 2;
        }
    }
    group rr_rr {
        type internal;
        local-address 10.0.0.10;
        neighbor 10.0.0.40 {
            family inet {
                unicast {
                    add-path {
                        send {
                            path-count 6;
                        }
                    }
                }
            }
        }
    }
}
ospf {
    area 0.0.0.0 {
        interface lo0.10 {
            passive;
        }
        interface fe-0/0/0.12;
        interface fe-0/0/1.13;
        interface fe-1/0/0.14;
        interface fe-1/2/0.15;
    }
}
user@R1# show routing-options
router-id 10.0.0.10;
 autonomous-system 1;
Configuration du routeur R2
Procédure étape par étape
Pour configurer le routeur R2 :
Configurez l’interface de bouclage (lo0) et les interfaces vers le routeur R6 et le routeur R1.
[edit interfaces]
user@R2# set fe-1/2/0 unit 21 family inet address 10.0.12.2/24
user@R2# set fe-1/2/1 unit 26 family inet address 10.0.26.1/24
user@R2# set lo0 unit 20 family inet address 10.0.0.20/32
Configurez BGP et OSPF sur les interfaces du routeur R2.
[edit protocols]
user@R2# set bgp group rr type internal
user@R2# set bgp group rr local-address 10.0.0.20
user@R2# set bgp group e1 type external
user@R2# set bgp group e1 neighbor 10.0.26.2 peer-as 2
user@R2# set ospf area 0.0.0.0 interface lo0.20 passive
user@R2# set ospf area 0.0.0.0 interface fe-1/2/0.21
user@R2# set ospf area 0.0.0.0 interface fe-1/2/1.28
Pour les routes envoyées du routeur R2 au routeur R1, annoncez le routeur R2 comme le saut suivant, car le routeur R1 n’a pas de route vers l’adresse du routeur R6 sur le réseau 10.0.26.0/24.
[edit]
user@R2# set policy-options policy-statement set_nh_self then next-hop self
user@R2# set protocols bgp group rr neighbor 10.0.0.10 export set_nh_self
Configurez le numéro du système autonome.
[edit]
user@R2# set routing-options autonomous-system 1
Si vous avez terminé de configurer l’appareil, validez la configuration.
user@R2# commit
Résultats
En mode configuration, confirmez votre configuration en entrant les show interfacescommandes , show protocolsshow policy-options, et show routing-options . Si la sortie n’affiche pas la configuration prévue, répétez les instructions de cet exemple pour corriger la configuration.
user@R2# show interfaces
fe-1/2/0 {
    unit 21 {
        family inet {
            address 10.0.12.2/24;
        }
    }
}
fe-1/2/1 {
    unit 26 {
        family inet {
            address 10.0.26.1/24;
        }
    }
}
lo0 {
    unit 20 {
        family inet {
            address 10.0.0.20/32;
        }
    }
}
user@R2# show protocols
bgp {
    group rr {
        type internal;
        local-address 10.0.0.20;
        neighbor 10.0.0.10 {
            export set_nh_self;
        }
    }
    group e1 {
        type external;
        neighbor 10.0.26.2 {
            peer-as 2;
        }
    }
}
ospf {
    area 0.0.0.0 {
        interface lo0.20 {
            passive;
        }
        interface fe-1/2/0.21;
        interface fe-1/2/1.28;
    }
}
user@R2# show policy-options
policy-statement set_nh_self {
    then {
        next-hop self;
    }
}
user@R2# show routing-options
 autonomous-system 1;
Configuration du routeur R3
Procédure étape par étape
Pour configurer le routeur R3 :
Configurez l’interface de bouclage (lo0) et les interfaces vers les routeurs R7 et R1.
[edit interfaces]
user@R3# set fe-1/0/1 unit 31 family inet address 10.0.13.2/24
user@R3# set fe-1/0/2 unit 37 family inet address 10.0.37.1/24
user@R3# set lo0 unit 30 family inet address 10.0.0.30/32
Configurez BGP et OSPF sur les interfaces du routeur R3.
[edit protocols]
user@R3# set bgp group rr type internal
user@R3# set bgp group rr local-address 10.0.0.30
user@R3# set bgp group e1 type external
user@R3# set bgp group e1 neighbor 10.0.37.2 peer-as 2
user@R3# set ospf area 0.0.0.0 interface lo0.30 passive
user@R3# set ospf area 0.0.0.0 interface fe-1/0/1.31
user@R3# set ospf area 0.0.0.0 interface fe-1/0/2.37
Pour les routes envoyées du routeur R3 au routeur R1, annoncez le routeur R3 comme le saut suivant, car le routeur R1 n’a pas de route vers l’adresse du routeur R7 sur le réseau 10.0.37.0/24.
[edit]
user@R3# set policy-options policy-statement set_nh_self then next-hop self
user@R3# set protocols bgp group rr neighbor 10.0.0.10 export set_nh_self
Configurez le numéro du système autonome.
[edit]
user@R3# set routing-options autonomous-system 1
Si vous avez terminé de configurer l’appareil, validez la configuration.
user@R3# commit
Résultats
En mode configuration, confirmez votre configuration en entrant les show interfacescommandes , show protocolsshow policy-options, , et show routing-options . Si la sortie n’affiche pas la configuration prévue, répétez les instructions de cet exemple pour corriger la configuration.
user@R3# show interfaces
fe-1/0/1 {
    unit 31 {
        family inet {
            address 10.0.13.2/24;
        }
    }
}
fe-1/0/2 {
    unit 37 {
        family inet {
            address 10.0.37.1/24;
        }
    }
}
lo0 {
    unit 30 {
        family inet {
            address 10.0.0.30/32;
        }
    }
}
user@R3# show protocols
bgp {
    group rr {
        type internal;
        local-address 10.0.0.30;
        neighbor 10.0.0.10 {
            export set_nh_self;
        }
    }
    group e1 {
        type external;
        neighbor 10.0.37.2 {
            peer-as 2;
        }
    }
}
ospf {
    area 0.0.0.0 {
        interface lo0.30 {
            passive;
        }
        interface fe-1/0/1.31;
        interface fe-1/0/2.37;
    }
}
user@R3# show policy-options
policy-statement set_nh_self {
    then {
        next-hop self;
    }
}
user@R3# show routing-options
 autonomous-system 1;
Configuration du routeur R4
Procédure étape par étape
Pour configurer le routeur R4 :
Configurez les interfaces vers le routeur R1 et le routeur R8, puis configurez l’interface de bouclage (lo0).
[edit interfaces]
user@R4# set fe-1/2/0 unit 41 family inet address 10.0.14.2/24
user@R4# set fe-1/2/1 unit 48 family inet address 10.0.48.1/24
user@R4# set lo0 unit 40 family inet address 10.0.0.40/32
Configurez BGP sur les interfaces et configurez la réflexion de route IBGP.
[edit protocols bgp]
user@R4# set group rr type internal
user@R4# set group rr local-address 10.0.0.40
user@R4# set group rr neighbor 10.0.0.10
user@R4# set group rr_client type internal
user@R4# set group rr_client local-address 10.0.0.40
user@R4# set group rr_client cluster 10.0.0.40
Configurez le routeur R4 pour envoyer jusqu’à six chemins à son voisin, le routeur R8.
La destination des chemins peut être n’importe quelle destination que le routeur R4 peut atteindre via plusieurs chemins.
[edit protocols bgp]
user@R4# set group rr_client neighbor 10.0.0.80 family inet unicast add-path send path-count 6
Configurez le routeur R4 pour recevoir plusieurs chemins de son voisin, le routeur R1.
La destination des chemins peut être n’importe quelle destination que le routeur R1 peut atteindre via plusieurs chemins.
[edit protocols bgp group rr family inet unicast]
user@R4# set add-path receive
Configurez OSPF sur les interfaces.
[edit protocols ospf area 0.0.0.0]
user@R4# set interface fe-1/2/0.41
user@R4# set interface lo0.40 passive
user@R4# set interface fe-1/2/1.48
Configurez une stratégie qui permet au routeur R4 d’envoyer plusieurs chemins au routeur R8 vers la route 172.16.199.1/32.
Le routeur R4 reçoit plusieurs chemins pour la route 172.16.198.1/32 et la route 172.16.199.1/32. Toutefois, en raison de cette stratégie, le routeur R4 n’envoie que plusieurs chemins pour la route 172.16.199.1/32.
[edit protocols bgp group rr_client neighbor 10.0.0.80 family inet unicast]
user@R4# set add-path send prefix-policy allow_199
[edit policy-options policy-statement allow_199]
user@R4# set from route-filter 172.16.199.1/32 exact
user@R4# set then accept
Le routeur R4 peut également être configuré pour envoyer jusqu’à 20 routes BGP
add-pathpour un sous-ensemble de préfixes annoncés par add-path.[edit policy-options policy-statement allow_199] user@R4# set term match_199 from prefix-list match_199 user@R4# set then add-path send-count 20
Configurez le numéro du système autonome.
[edit routing-options]
user@R4# set autonomous-system 1
Si vous avez terminé de configurer l’appareil, validez la configuration.
user@R4# commit
Résultats
En mode configuration, confirmez votre configuration en entrant les show interfacescommandes , show protocolsshow policy-options, , et show routing-options . Si la sortie n’affiche pas la configuration prévue, répétez les instructions de cet exemple pour corriger la configuration.
user@R4# show interfaces
fe-1/2/0 {
    unit 41 {
        family inet {
            address 10.0.14.2/24;
        }
    }
}
fe-1/2/1 {
    unit 48 {
        family inet {
            address 10.0.48.1/24;
        }
    }
}
lo0 {
    unit 40 {
        family inet {
            address 10.0.0.40/32;
        }
    }
}
user@R4# show protocols
bgp {
    group rr {
        type internal;
        local-address 10.0.0.40;
        family inet {
            unicast {
                add-path {
                    receive;
                }
            }
        }
        neighbor 10.0.0.10;
    }
    group rr_client {
        type internal;
        local-address 10.0.0.40;
        cluster 10.0.0.40;
        neighbor 10.0.0.80 {
            family inet {
                unicast {
                    add-path {
                        send {
                            path-count 6;
                            prefix-policy allow_199;
                        }
                    }
                }
            }
        }
    }
}
ospf {
    area 0.0.0.0 {
        interface lo0.40 {
            passive;
        }
        interface fe-1/2/0.41;
        interface fe-1/2/1.48;
    }
}
user@R4# show policy-options
policy-statement allow_199 {
    from {
        route-filter 172.16.199.1/32 exact;
    }
    from term match_199 {
        prefix-list match_199;
    }
        then add-path send-count 20;
    then accept;
}
user@R4# show routing-options
 autonomous-system 1;
Configuration du routeur R5
Procédure étape par étape
Pour configurer le routeur R5 :
Configurez l’interface de bouclage (lo0) et l’interface vers le routeur R1.
[edit interfaces]
user@R5# set fe-1/2/0 unit 51 family inet address 10.0.15.2/24
user@R5# set lo0 unit 50 family inet address 10.0.0.50/32
Configurez BGP sur l’interface du routeur R5.
[edit protocols bgp group e1]
user@R5# set type external
user@R5# set neighbor 10.0.15.1 peer-as 1
Créez des routes statiques pour la redistribution dans BGP.
[edit routing-options]
user@R5# set static route 172.16.199.1/32 reject
user@R5# set static route 172.16.198.1/32 reject
Redistribuez les routes statiques et directes dans BGP.
[edit protocols bgp group e1 neighbor 10.0.15.1]
user@R5# set export s2b
[edit policy-options policy-statement s2b]
user@R5# set from protocol static
user@R5# set from protocol direct
user@R5# set then as-path-expand 2
user@R5# set then accept
Configurez le numéro du système autonome.
[edit routing-options]
user@R5# set autonomous-system 2
Si vous avez terminé de configurer l’appareil, validez la configuration.
user@R5# commit
Résultats
En mode configuration, confirmez votre configuration en entrant les show interfacescommandes , show protocolsshow policy-options, , et show routing-options . Si la sortie n’affiche pas la configuration prévue, répétez les instructions de cet exemple pour corriger la configuration.
user@R5# show interfaces
fe-1/2/0 {
    unit 51 {

        family inet {
            address 10.0.15.2/24;
        }
    }
}
lo0 {
    unit 50 {
        family inet {
            address 10.0.0.50/32;
        }
    }
}
user@R5# show protocols
bgp {
    group e1 {
        type external;
        neighbor 10.0.15.1 {
            export s2b;
            peer-as 1;
        }
    }
}
user@R5# show policy-options
policy-statement s2b {
    from protocol [ static direct ];
    then {
        as-path-expand 2;
        accept;
    }
}
user@R5# show routing-options
static {
    route 172.16.198.1/32 reject;
    route 172.16.199.1/32 reject;
}
 autonomous-system 2;
Configuration du routeur R6
Procédure étape par étape
Pour configurer le routeur R6 :
Configurez l’interface de bouclage (lo0) et l’interface vers le routeur R2.
[edit interfaces]
user@R6# set fe-1/2/0 unit 62 family inet address 10.0.26.2/24
user@R6# set lo0 unit 60 family inet address 10.0.0.60/32
Configurez BGP sur l’interface du routeur R6.
[edit protocols]
user@R6# set bgp group e1 type external
user@R6# set bgp group e1 neighbor 10.0.26.1 peer-as 1
Créez des routes statiques pour la redistribution dans BGP.
[edit]
user@R6# set routing-options static route 172.16.199.1/32 reject
user@R6# set routing-options static route 172.16.198.1/32 reject
Redistribuez les routes statiques et directes de la table de routage du routeur R6 vers BGP.
[edit protocols bgp group e1 neighbor 10.0.26.1]
user@R6# set export s2b
[edit policy-options policy-statement s2b]
user@R6# set from protocol static
user@R6# set from protocol direct
user@R6# set then accept
Configurez le numéro du système autonome.
[edit routing-options]
user@R6# set autonomous-system 2
Si vous avez terminé de configurer l’appareil, validez la configuration.
user@R6# commit
Résultats
En mode configuration, confirmez votre configuration en entrant les show interfacescommandes , show protocolsshow policy-options, , et show routing-options . Si la sortie n’affiche pas la configuration prévue, répétez les instructions de cet exemple pour corriger la configuration.
user@R6# show interfaces
fe-1/2/0 {
    unit 62 {

        family inet {
            address 10.0.26.2/24;
        }
    }
}
lo0 {
    unit 60 {
        family inet {
            address 10.0.0.60/32;
        }
    }
}
user@R6# show protocols
bgp {
    group e1 {
        type external;
        neighbor 10.0.26.1 {
            export s2b;
            peer-as 1;
        }
    }
}
user@R6# show policy-options
policy-statement s2b {
    from protocol [ static direct ];
    then accept;
}
user@R6# show routing-options
static {
    route 172.16.198.1/32 reject;
    route 172.16.199.1/32 reject;
}
 autonomous-system 2;
Configuration du routeur R7
Procédure étape par étape
Pour configurer le routeur R7 :
Configurez l’interface de bouclage (lo0) et l’interface vers le routeur R3.
[edit interfaces]
user@R7# set fe-1/2/0 unit 73 family inet address 10.0.37.2/24
user@R7# set lo0 unit 70 family inet address 10.0.0.70/32
Configurez BGP sur l’interface du routeur R7.
[edit protocols bgp group e1]
user@R7# set type external
user@R7# set neighbor 10.0.37.1 peer-as 1
Créez une route statique pour la redistribution dans BGP.
[edit]
user@R7# set routing-options static route 172.16.199.1/32 reject
Redistribuez les routes statiques et directes de la table de routage du routeur R7 vers BGP.
[edit protocols bgp group e1 neighbor 10.0.37.1]
user@R7# set export s2b
[edit policy-options policy-statement s2b]
user@R7# set from protocol static
user@R7# set from protocol direct
user@R7# set then accept
Configurez le numéro du système autonome.
[edit routing-options]
user@R7# set autonomous-system 2
Si vous avez terminé de configurer l’appareil, validez la configuration.
user@R7# commit
Résultats
En mode configuration, confirmez votre configuration en entrant les show interfacescommandes , show protocolsshow policy-options, , et show routing-options . Si la sortie n’affiche pas la configuration prévue, répétez les instructions de cet exemple pour corriger la configuration.
user@R7# show interfaces
fe-1/2/0 {
    unit 73 {

        family inet {
            address 10.0.37.2/24;
        }
    }
}
lo0 {
    unit 70 {
        family inet {
            address 10.0.0.70/32;
        }
    }
}
user@R7# show protocols
bgp {
    group e1 {
        type external;
        neighbor 10.0.37.1 {
            export s2b;
            peer-as 1;
        }
    }
}
user@R7# show policy-options
policy-statement s2b {
    from protocol [ static direct ];
    then accept;
}
user@R7# show routing-options
static {
    route 172.16.199.1/32 reject;
}
 autonomous-system 2;
Configuration du routeur R8
Procédure étape par étape
Pour configurer le routeur R8 :
Configurez l’interface de bouclage (lo0) et l’interface vers le routeur R4.
[edit interfaces]
user@R8# set fe-1/2/0 unit 84 family inet address 10.0.48.2/24
user@R8# set lo0 unit 80 family inet address 10.0.0.80/32
Configurez BGP et OSPF sur l’interface du routeur R8.
[edit protocols]
user@R8# set bgp group rr type internal
user@R8# set bgp group rr local-address 10.0.0.80
user@R8# set ospf area 0.0.0.0 interface lo0.80 passive
user@R8# set ospf area 0.0.0.0 interface fe-1/2/0.84
Configurez le routeur R8 pour recevoir plusieurs chemins de son voisin, le routeur R4.
La destination des chemins peut être n’importe quelle destination que le routeur R4 peut atteindre via plusieurs chemins.
[edit protocols]
user@R8# set bgp group rr neighbor 10.0.0.40 family inet unicast add-path receive
Configurez le numéro du système autonome.
[edit]
user@R8# set routing-options autonomous-system 1
Si vous avez terminé de configurer l’appareil, validez la configuration.
user@R8# commit
Résultats
En mode configuration, confirmez votre configuration en entrant les show interfacescommandes , show protocolsshow policy-options, , et show routing-options . Si la sortie n’affiche pas la configuration prévue, répétez les instructions de cet exemple pour corriger la configuration.
user@R8# show interfaces
fe-1/2/0 {

    unit 84 {

        family inet {
            address 10.0.48.2/24;
        }
    }
}
lo0 {
    unit 80 {
        family inet {
            address 10.0.0.80/32;
        }
    }
}
user@R8# show protocols
bgp {
    group rr {
        type internal;
        local-address 10.0.0.80;
        neighbor 10.0.0.40 {
            family inet {
                unicast {
                    add-path {
                        receive;
                    }
                }
            }
        }
    }
}
ospf {
    area 0.0.0.0 {
        interface lo0.80 {
            passive;
        }
        interface fe-1/2/0.84;
    }
}
user@R8# show routing-options
 autonomous-system 1;
Vérification
Vérifiez que la configuration fonctionne correctement.
- Vérifier que les homologues BGP ont la capacité d’envoyer et de recevoir plusieurs chemins
- Vérifier que le routeur R1 annonce plusieurs chemins
- Vérifier que le routeur R4 reçoit et annonce plusieurs chemins
- Vérifier que le routeur R8 reçoit plusieurs chemins
- Vérification de l’ID du chemin
Vérifier que les homologues BGP ont la capacité d’envoyer et de recevoir plusieurs chemins
Objet
Assurez-vous que l’une ou les deux chaînes suivantes apparaissent dans la sortie de la show bgp neighbor commande :
NLRI's for which peer can receive multiple paths: inet-unicastNLRI's for which peer can send multiple paths: inet-unicast
Mesures à prendre
user@R1> show bgp neighbor 10.0.0.40
Peer: 10.0.0.40+179 AS 1       Local: 10.0.0.10+64227 AS 1
  Type: Internal    State: Established    Flags: <Sync>
...  NLRI's for which peer can receive multiple paths: inet-unicast
...
user@R4> show bgp neighbor 10.0.0.10
Peer: 10.0.0.10+64227 AS 1     Local: 10.0.0.40+179 AS 1
  Type: Internal    State: Established    Flags: <Sync>
...
  NLRI's for which peer can send multiple paths: inet-unicast
...
user@R4> show bgp neighbor 10.0.0.80
Peer: 10.0.0.80+55416 AS 1     Local: 10.0.0.40+179 AS 1
  Type: Internal    State: Established  (route reflector client)Flags: <Sync>
  ,,,
  NLRI's for which peer can receive multiple paths: inet-unicast
  ...
user@R8> show bgp neighbor 10.0.0.40
Peer: 10.0.0.40+179 AS 1       Local: 10.0.0.80+55416 AS 1
  Type: Internal    State: Established    Flags: <Sync>
  ...
  NLRI's for which peer can send multiple paths: inet-unicast
  ...
Vérifier que le routeur R1 annonce plusieurs chemins
Objet
Assurez-vous que plusieurs chemins vers la destination 172.16.198.1/32 et plusieurs chemins vers la destination 172.16.199.1/32 sont annoncés au routeur R4.
Mesures à prendre
user@R1> show route advertising-protocol bgp 10.0.0.40
inet.0: 21 destinations, 25 routes (21 active, 0 holddown, 0 hidden)
  Prefix                  Nexthop              MED     Lclpref    AS path
* 10.0.0.50/32            10.0.15.2                    100        2 2 I
* 10.0.0.60/32            10.0.0.20                    100        2 I
* 10.0.0.70/32            10.0.0.30                    100        2 I
* 172.16.198.1/32            10.0.0.20                    100        2 I
                          10.0.15.2                    100        2 2 I
* 172.16.199.1/32            10.0.0.20                    100        2 I
                          10.0.0.30                    100        2 I
                          10.0.15.2                    100        2 2 I
* 172.16.200.0/30            10.0.0.20                    100        2 I
Signification
Lorsque vous voyez un préfixe et plusieurs sauts suivants, cela signifie que plusieurs chemins sont annoncés au routeur R4.
Vérifier que le routeur R4 reçoit et annonce plusieurs chemins
Objet
Assurez-vous que plusieurs chemins vers la destination 172.16.199.1/32 sont reçus du routeur R1 et annoncés au routeur R8. Assurez-vous que plusieurs chemins vers la destination 172.16.198.1/32 sont reçus du routeur R1, mais qu’un seul chemin vers cette destination est annoncé au routeur R8.
Mesures à prendre
user@R4> show route receive-protocol bgp 10.0.0.10
inet.0: 19 destinations, 22 routes (19 active, 0 holddown, 0 hidden)
  Prefix                  Nexthop              MED     Lclpref    AS path
* 10.0.0.50/32            10.0.15.2                    100        2 2 I
* 10.0.0.60/32            10.0.0.20                    100        2 I
* 10.0.0.70/32            10.0.0.30                    100        2 I
* 172.16.198.1/32            10.0.0.20                    100        2 I
                          10.0.15.2                    100        2 2 I
* 172.16.199.1/32            10.0.0.20                    100        2 I
                          10.0.0.30                    100        2 I
                          10.0.15.2                    100        2 2 I
* 172.16.200.0/30            10.0.0.20                    100        2 I
user@R4> show route advertising-protocol bgp 10.0.0.80
inet.0: 19 destinations, 22 routes (19 active, 0 holddown, 0 hidden)
  Prefix                  Nexthop              MED     Lclpref    AS path
* 10.0.0.50/32            10.0.15.2                    100        2 2 I
* 10.0.0.60/32            10.0.0.20                    100        2 I
* 10.0.0.70/32            10.0.0.30                    100        2 I
* 172.16.198.1/32            10.0.0.20                    100        2 I
* 172.16.199.1/32            10.0.0.20                    100        2 I
                          10.0.0.30                    100        2 I
                          10.0.15.2                    100        2 2 I
* 172.16.200.0/30            10.0.0.20                    100        2 I
Signification
La show route receive-protocol commande indique que le routeur R4 reçoit deux chemins vers la destination 172.16.198.1/32 et trois chemins vers la destination 172.16.199.1/32. La show route advertising-protocol commande indique que le routeur R4 n’annonce qu’un seul chemin vers la destination 172.16.198.1/32 et annonce les trois chemins vers la destination 172.16.199.1/32.
En raison de la stratégie de préfixe appliquée au routeur R4, le routeur R4 n’annonce pas plusieurs chemins vers la destination 172.16.198.1/32. Le routeur R4 n’annonce qu’un seul chemin vers la destination 172.16.198.1/32, même s’il reçoit plusieurs chemins vers cette destination.
Vérifier que le routeur R8 reçoit plusieurs chemins
Objet
Assurez-vous que le routeur R8 reçoit plusieurs chemins vers la destination 172.16.199.1/32 via le routeur R4. Assurez-vous que le routeur R8 ne reçoit qu’un seul chemin vers la destination 172.16.198.1/32 via le routeur R4.
Mesures à prendre
user@R8> show route receive-protocol bgp 10.0.0.40
inet.0: 18 destinations, 20 routes (18 active, 0 holddown, 0 hidden)
  Prefix                  Nexthop              MED     Lclpref    AS path
* 10.0.0.50/32            10.0.15.2                    100        2 2 I
* 10.0.0.60/32            10.0.0.20                    100        2 I
* 10.0.0.70/32            10.0.0.30                    100        2 I
* 172.16.198.1/32            10.0.0.20                    100        2 I
* 172.16.199.1/32            10.0.0.20                    100        2 I
                          10.0.0.30                    100        2 I
                          10.0.15.2                    100        2 2 I
* 200.1.1.0/30            10.0.0.20                    100        2 I
Vérification de l’ID du chemin
Objet
Sur les appareils en aval, routeur R4 et routeur R8, vérifiez qu’un ID de chemin identifie le chemin de manière unique. Cherchez la Addpath Path ID: ficelle.
Mesures à prendre
user@R4> show route 172.16.199.1/32 detail

inet.0: 18 destinations, 20 routes (18 active, 0 holddown, 0 hidden)
172.16.199.1/32 (3 entries, 3 announced)
        *BGP    Preference: 170/-101
                Next hop type: Indirect
                Next-hop reference count: 9
                Source: 10.0.0.10
                Next hop type: Router, Next hop index: 676
                Next hop: 10.0.14.1 via lt-1/2/0.41, selected
                Protocol next hop: 10.0.0.20
                Indirect next hop: 92041c8 262146
                State: <Active Int Ext>
                Local AS:     1 Peer AS:     1
                Age: 1:44:37    Metric2: 2
                Task: BGP_1.10.0.0.10+64227
                Announcement bits (3): 2-KRT 3-BGP RT Background 4-Resolve tree 1
                AS path: 2 I (Originator) Cluster list:  10.0.0.10
                AS path:  Originator ID: 10.0.0.20
                Accepted
                Localpref: 100
                Router ID: 10.0.0.10
                Addpath Path ID: 1
         BGP    Preference: 170/-101
                Next hop type: Indirect
                Next-hop reference count: 4
                Source: 10.0.0.10
                Next hop type: Router, Next hop index: 676
                Next hop: 10.0.14.1 via lt-1/2/0.41, selected
                Protocol next hop: 10.0.0.30
                Indirect next hop: 92042ac 262151
                State: <NotBest Int Ext>
                Inactive reason: Not Best in its group - Router ID
                Local AS:     1 Peer AS:     1
                Age: 1:44:37    Metric2: 2
                Task: BGP_1.10.0.0.10+64227
                Announcement bits (1): 3-BGP RT Background
                AS path: 2 I (Originator) Cluster list:  10.0.0.10
                AS path:  Originator ID: 10.0.0.30
                Accepted
                Localpref: 100
                Router ID: 10.0.0.10
                Addpath Path ID: 2
         BGP    Preference: 170/-101
                Next hop type: Indirect
                Next-hop reference count: 4
                Source: 10.0.0.10
                Next hop type: Router, Next hop index: 676
                Next hop: 10.0.14.1 via lt-1/2/0.41, selected
                Protocol next hop: 10.0.15.2
                Indirect next hop: 92040e4 262150
                State: <Int Ext>
                Inactive reason: AS path
                Local AS:     1 Peer AS:     1
                Age: 1:44:37    Metric2: 2
                Task: BGP_1.10.0.0.10+64227
                Announcement bits (1): 3-BGP RT Background
                AS path: 2 2 I
                Accepted
                Localpref: 100
                Router ID: 10.0.0.10
                Addpath Path ID: 3
user@R8> show route 172.16.199.1/32 detail

inet.0: 17 destinations, 19 routes (17 active, 0 holddown, 0 hidden)
172.16.199.1/32 (3 entries, 1 announced)
        *BGP    Preference: 170/-101
                Next hop type: Indirect
                Next-hop reference count: 9
                Source: 10.0.0.40
                Next hop type: Router, Next hop index: 1045
                Next hop: 10.0.48.1 via lt-1/2/0.84, selected
                Protocol next hop: 10.0.0.20
                Indirect next hop: 91fc0e4 262148
                State: <Active Int Ext>
                Local AS:     1 Peer AS:     1
                Age: 1:56:51    Metric2: 3
                Task: BGP_1.10.0.0.40+179
                Announcement bits (2): 2-KRT 4-Resolve tree 1
                AS path: 2 I (Originator) Cluster list:  10.0.0.40 10.0.0.10
                AS path:  Originator ID: 10.0.0.20
                Accepted
                Localpref: 100
                Router ID: 10.0.0.40
                Addpath Path ID: 1
         BGP    Preference: 170/-101
                Next hop type: Indirect
                Next-hop reference count: 4
                Source: 10.0.0.40
                Next hop type: Router, Next hop index: 1045
                Next hop: 10.0.48.1 via lt-1/2/0.84, selected
                Protocol next hop: 10.0.0.30
                Indirect next hop: 91fc1c8 262152
                State: <NotBest Int Ext>
                Inactive reason: Not Best in its group - Router ID
                Local AS:     1 Peer AS:     1
                Age: 1:56:51    Metric2: 3
                Task: BGP_1.10.0.0.40+179
                AS path: 2 I (Originator) Cluster list:  10.0.0.40 10.0.0.10
                AS path:  Originator ID: 10.0.0.30
                Accepted
                Localpref: 100
                Router ID: 10.0.0.40
                Addpath Path ID: 2
         BGP    Preference: 170/-101
                Next hop type: Indirect
                Next-hop reference count: 4
                Source: 10.0.0.40
                Next hop type: Router, Next hop index: 1045
                Next hop: 10.0.48.1 via lt-1/2/0.84, selected
                Protocol next hop: 10.0.15.2
                Indirect next hop: 91fc2ac 262153
                State: <Int Ext>
                Inactive reason: AS path
                Local AS:     1 Peer AS:     1
                Age: 1:56:51    Metric2: 3
                Task: BGP_1.10.0.0.40+179
                AS path: 2 2 I (Originator) Cluster list:  10.0.0.40
                AS path:  Originator ID: 10.0.0.10
                Accepted
                Localpref: 100
                Router ID: 10.0.0.40
                Addpath Path ID: 3
Exemple : Configuration de la publicité sélective de plusieurs chemins BGP pour l’équilibrage de charge
Cet exemple montre comment configurer la publicité sélective de plusieurs chemins BGP. La publication de tous les chemins multiples disponibles peut entraîner une surcharge de traitement importante sur la mémoire de l’appareil et constitue également une considération d’évolutivité. Vous pouvez configurer un réflecteur de route BGP pour annoncer uniquement les trajets multiples des contributeurs pour l’équilibrage de charge.
Exigences
Aucune configuration spéciale au-delà de l’initialisation de l’appareil n’est requise avant de configurer cet exemple.
Cet exemple utilise les composants matériels et logiciels suivants :
-
Huit routeurs pouvant être une combinaison de routeurs M Series, MX Series ou T Series
-
Junos OS version 16.1R2 ou ultérieure sur l’équipement
Vue d’ensemble
À partir de la version 16.1R2 de Junos OS, vous pouvez restreindre BGP add-path à la publication de chemins multiples pour les contributeurs uniquement. Vous pouvez limiter et configurer jusqu’à six préfixes sélectionnés par l’algorithme BGP multipath . La publicité sélective de chemins multiples facilite les fournisseurs de services Internet et les centres de données qui utilisent le réflecteur de route pour diversifier les chemins dans les IBGP. Vous pouvez activer un réflecteur de route BGP pour annoncer des trajets multiples qui sont des chemins contributeurs pour l’équilibrage de charge.
Topologie
Sur la figure 7, RR1 et RR4 sont des réflecteurs de route. Les routeurs R2 et R3 sont les clients du réflecteur de route RR1. Le routeur R8 est un client pour router le réflecteur RR4. Le groupe RR1 avec les voisins R2 et R3 est configuré pour le multichemin. Les routeurs R5, R6 et R7 redistribuent les routes statiques 199.1.1.1/32 et 198.1.1.1/32 dans BGP.
Une stratégie d’équilibrage de charge est configurée au niveau du routeur RR1 de sorte que les routes 199.1.1.1/32 ont des chemins multichemins calculés. La fonctionnalité multichemin est configurée sous add-path pour le RR4 voisin. Toutefois, le routeur RR4 n’a pas configuré de multichemin d’équilibrage de charge. Le routeur RR1 est configuré pour envoyer au routeur RR4 jusqu’à six routes d’ajout de chemin à 199.1.1.1/32 choisies parmi les routes candidates à trajets multiples.
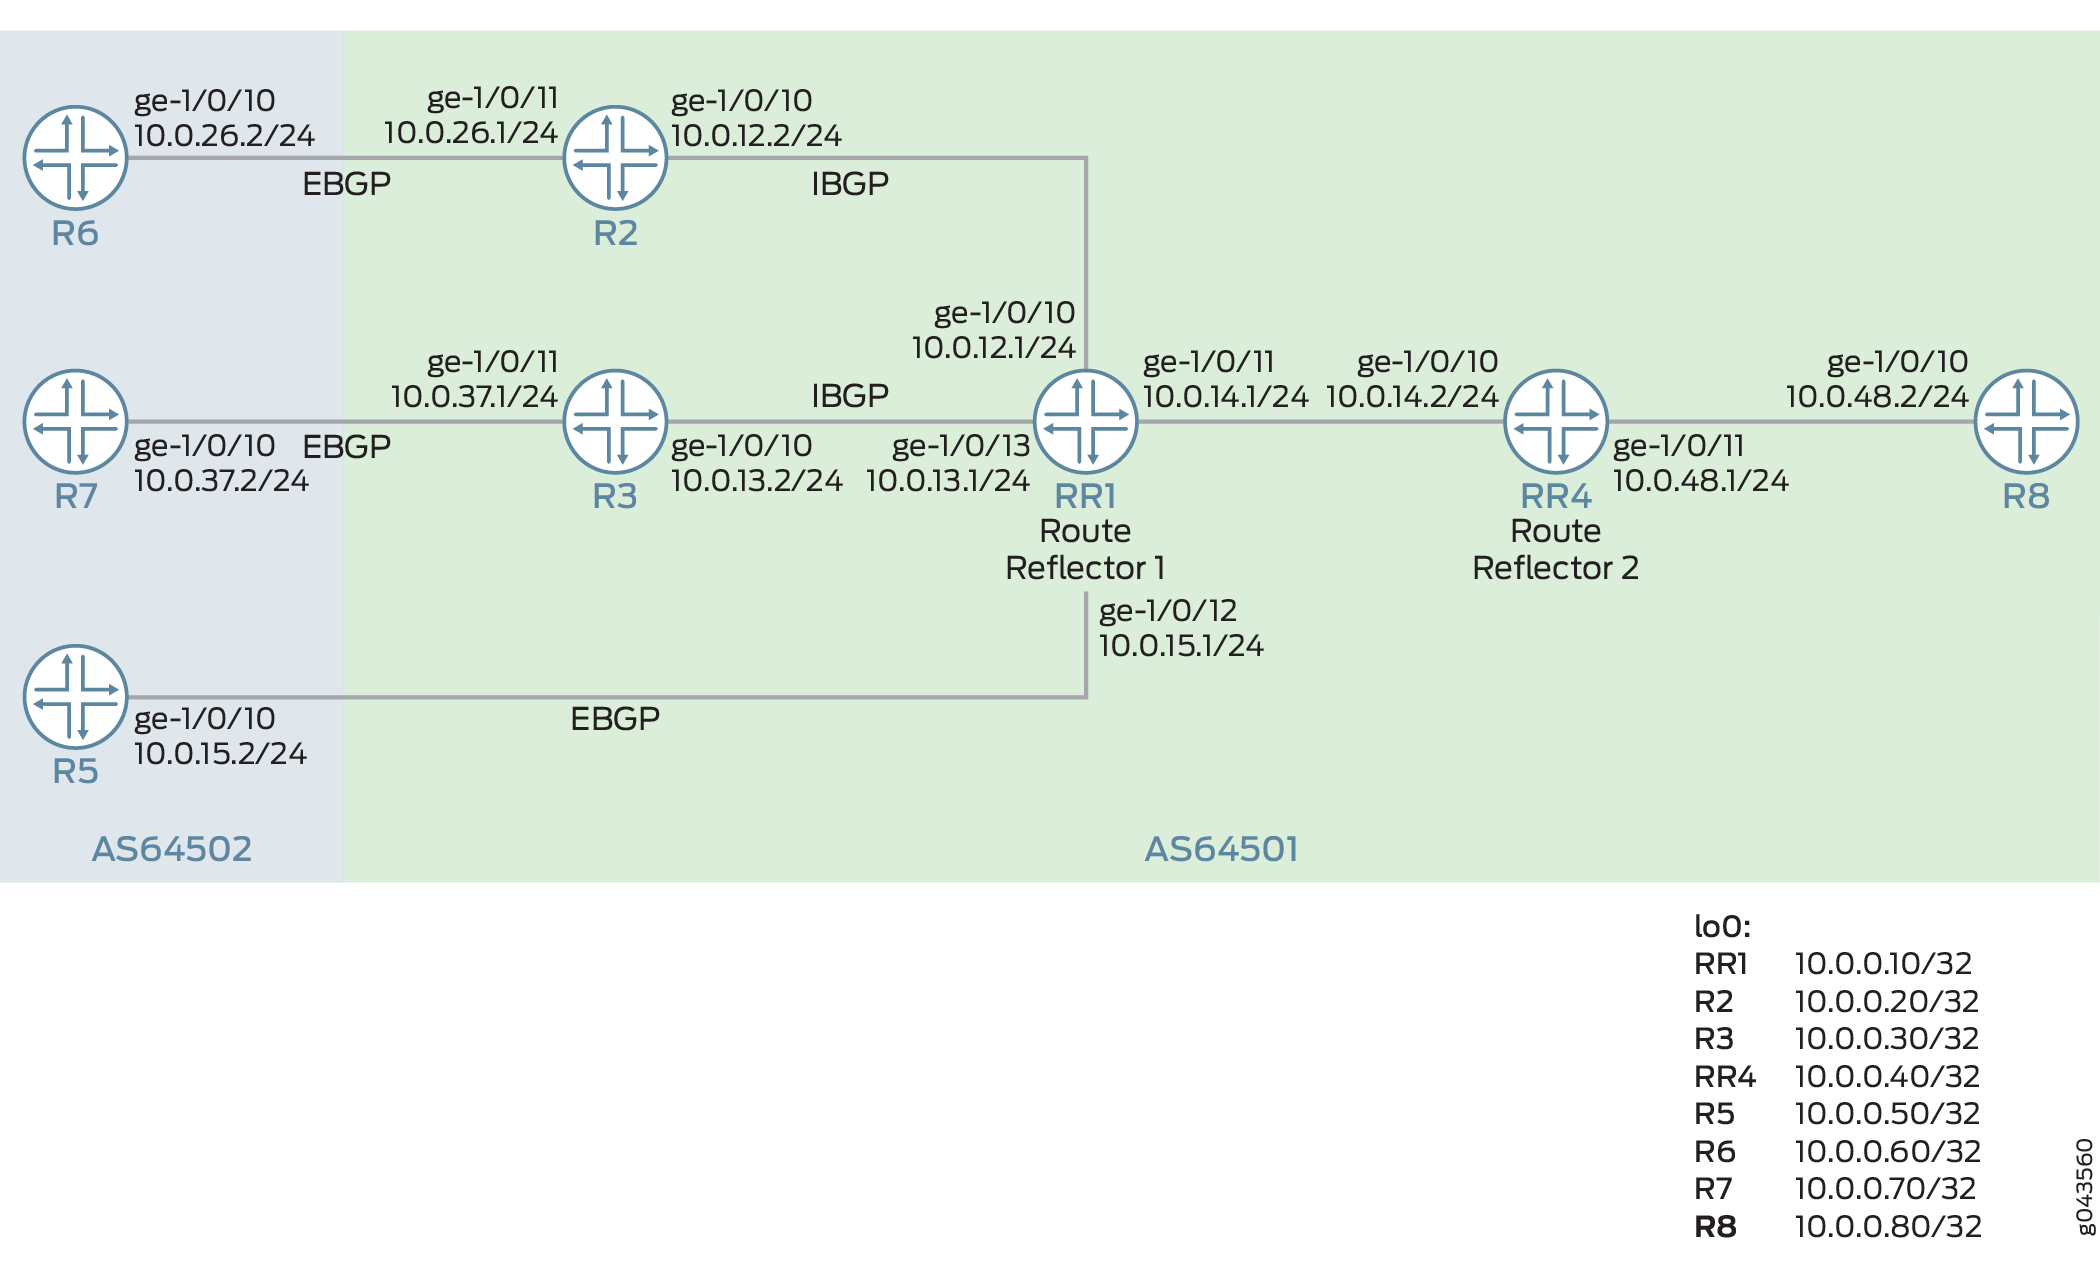 de charge
La configuration
Configuration rapide de la CLI
Pour configurer rapidement cet exemple, copiez les commandes suivantes, collez-les dans un fichier texte, supprimez les sauts de ligne, modifiez tous les détails nécessaires pour qu’ils correspondent à votre configuration réseau, copiez et collez les commandes dans la CLI au niveau de la [edit] hiérarchie, puis entrez Valider à partir du mode de configuration.
Routeur RR1
set interfaces ge-1/0/10 unit 0 description RR1->R2
set interfaces ge-1/0/10 unit 0 family inet address 10.0.12.1/24
set interfaces ge-1/0/11 unit 0 description RR1->RR4
set interfaces ge-1/0/11 unit 0 family inet address 10.0.14.1/24
set interfaces ge-1/0/12 unit 0 description RR1->R5
set interfaces ge-1/0/12 unit 0 family inet address 10.0.15.1/24
set interfaces ge-1/0/13 unit 0 description RR1->R3
set interfaces ge-1/0/13 unit 0 family inet address 10.0.13.1/24
set interfaces lo0 unit 0 family inet address 10.0.0.10/32
set protocols bgp group rr type internal
set protocols bgp group rr local-address 10.0.0.10
set protocols bgp group rr cluster 10.0.0.10
set protocols bgp group rr multipath
set protocols bgp group rr neighbor 10.0.0.20
set protocols bgp group rr neighbor 10.0.0.30
set protocols bgp group e1 type external
set protocols bgp group e1 neighbor 10.0.15.2 local-address 10.0.15.1
set protocols bgp group e1 neighbor 10.0.15.2 peer-as 64502
set protocols bgp group rr_rr type internal
set protocols bgp group rr_rr local-address 10.0.0.10
set protocols bgp group rr_rr neighbor 10.0.0.40 family inet unicast add-path send path-count 6
set protocols bgp group rr_rr neighbor 10.0.0.40 family inet unicast add-path send multipath
set protocols ospf area 0.0.0.0 interface lo0.10 passive
set protocols ospf area 0.0.0.0 interface ge-1/0/10
set protocols ospf area 0.0.0.0 interface ge-1/0/13
set protocols ospf area 0.0.0.0 interface ge-1/0/11
set protocols ospf area 0.0.0.0 interface ge-1/0/12
set policy-options prefix-list match_199 199.1.1.1/32
set policy-options policy-statement loadbal_199 term match_100 from prefix-list match_199
set policy-options policy-statement loadbal_199 from route-filter 199.1.1.1/32 exact
set policy-options policy-statement loadbal_199 then load-balance per-packet
set routing-options router-id 10.0.0.10
set routing-options autonomous-system 64501
set routing-options forwarding-table export loadbal_199
Routeur R2
set interfaces ge-1/0/10 unit 0 description R2->RR1
set interfaces ge-1/0/10 unit 0 family inet address 10.0.12.2/24
set interfaces ge-1/0/11 unit 0 description R2->R6
set interfaces ge-1/0/11 unit 0 family inet address 10.0.26.1/24
set interfaces lo0 unit 0 family inet address 10.0.0.20/32
set protocols bgp group rr local-address 10.0.0.20
set protocols bgp group rr neighbor 10.0.0.10 export set_nh_self
set protocols bgp group e1 type external
set protocols bgp group e1 neighbor 10.0.26.2 peer-as 64502
set protocols ospf area 0.0.0.0 interface lo0.20 passive
set protocols ospf area 0.0.0.0 interface ge-1/0/10
set protocols ospf area 0.0.0.0 interface ge-1/0/11
set policy-options policy-statement set_nh_self then next-hop self
set routing-options autonomous-system 64501
Routeur R3
set interfaces ge-1/0/10 unit 0 description R3->RR1
set interfaces ge-1/0/10 unit 0 family inet address 10.0.13.2/24
set interfaces ge-1/0/11 unit 0 description R3->R7
set interfaces ge-1/0/11 unit 0 family inet address 10.0.37.1/24
set interfaces lo0 unit 0 family inet address 10.0.0.30/32
set protocols bgp group rr type internal
set protocols bgp group rr local-address 10.0.0.30
set protocols bgp group rr neighbor 10.0.0.10 export set_nh_self
set protocols bgp group e1 type external
set protocols bgp group e1 neighbor 10.0.37.2 peer-as 64502
set protocols ospf area 0.0.0.0 interface lo0.30 passive
set protocols ospf area 0.0.0.0 interface ge-1/0/10
set protocols ospf area 0.0.0.0 interface ge-1/0/13
set policy-options policy-statement set_nh_self then next-hop self
set routing-options autonomous-system 64501
Routeur RR4
set interfaces ge-1/0/10 unit 0 description RR4->RR1
set interfaces ge-1/0/10 unit 0 family inet address 10.0.14.2/24
set interfaces ge-1/0/11 unit 0 description RR4->R8
set interfaces ge-1/0/11 unit 0 family inet address 10.0.48.1/24
set interfaces lo0 unit 0 family inet address 10.0.0.40/32
set protocols bgp group rr type internal
set protocols bgp group rr local-address 10.0.0.40
set protocols bgp group rr family inet unicast add-path receive
set protocols bgp group rr neighbor 10.0.0.10
set protocols bgp group rr_client type internal
set protocols bgp group rr_client local-address 10.0.0.40
set protocols bgp group rr_client cluster 10.0.0.40
set protocols bgp group rr_client neighbor 10.0.0.80 family inet unicast add-path send prefix-policy addpath-communities-send-4713-100
set protocols bgp group rr_client neighbor 10.0.0.80 family inet unicast add-path send path-count 2
set protocols bgp group rr_client neighbor 10.0.0.80 family inet unicast add-path send multipath
set protocols ospf area 0.0.0.0 interface ge-1/0/10
set protocols ospf area 0.0.0.0 interface lo0.40 passive
set protocols ospf area 0.0.0.0 interface ge-1/0/11
set policy-options prefix-list match_199 199.1.1.1/32
set routing-options autonomous-system 64501
Routeur R5
set interfaces ge-1/0/10 unit 0 description R5->RR1
set interfaces ge-1/0/10 unit 0 family inet address 10.0.15.2/24
set interfaces lo0 unit 0 family inet address 10.0.0.50/32
set protocols bgp group e1 type external
set protocols bgp group e1 neighbor 10.0.15.1 export s2b
set protocols bgp group e1 neighbor 10.0.15.1 peer-as 64501
set policy-options policy-statement s2b from protocol static
set policy-options policy-statement s2b from protocol direct
set policy-options policy-statement s2b then community add addpath-community
set policy-options policy-statement s2b then as-path-expand 2
set policy-options policy-statement s2b then accept
set policy-options community addpath-community members 4713:100
set routing-options static route 199.1.1.1/32 reject
set routing-options static route 198.1.1.1/32 reject
set routing-options autonomous-system 64502
Routeur R6
set interfaces ge-1/0/10 unit 0 description R6->R2
set interfaces ge-1/0/10 unit 0 family inet address 10.0.26.2/24
set interfaces lo0 unit 0 family inet address 10.0.0.60/32
set protocols bgp group e1 type external
set protocols bgp group e1 neighbor 10.0.26.1 export s2b
set protocols bgp group e1 neighbor 10.0.26.1 peer-as 64501
set policy-options policy-statement s2b from protocol static
set policy-options policy-statement s2b from protocol direct
set policy-options policy-statement s2b then community add addpath-community
set policy-options policy-statement s2b then accept
set policy-options community addpath-community members 4713:100
set routing-options static route 199.1.1.1/32 reject
set routing-options static route 198.1.1.1/32 reject
set routing-options autonomous-system 64502
Routeur R7
set interfaces ge-1/0/10 unit 0 description R7->R3
set interfaces ge-1/0/10 unit 0 family inet address 10.0.37.2/24
set interfaces lo0 unit 0 family inet address 10.0.0.70/32
set protocols bgp group e1 type external
set protocols bgp group e1 neighbor 10.0.37.1 export s2b
set protocols bgp group e1 neighbor 10.0.37.1 peer-as 64501
set policy-options policy-statement s2b from protocol static
set policy-options policy-statement s2b from protocol direct
set policy-options policy-statement s2b then community add addpath-community
set policy-options policy-statement s2b then accept
set policy-options community addpath-community members 4713:100
set routing-options static route 199.1.1.1/32 reject
set routing-options autonomous-system 64502
Routeur R8
set interfaces ge-1/0/10 unit 0 description R8->RR4
set interfaces ge-1/0/10 unit 0 family inet address 10.0.48.2/24
set interfaces lo0 unit 0 family inet address 10.0.0.80/32
set protocols bgp group rr type internal
set protocols bgp group rr local-address 10.0.0.80
set protocols bgp group rr neighbor 10.0.0.40 family inet unicast add-path receive
set protocols ospf area 0.0.0.0 interface lo0.0 passive
set protocols ospf area 0.0.0.0 interface ge-1/0/10.8
set routing-options autonomous-system 64501
set chassis fpc 1 pic 0 tunnel-services bandwidth 1g
Configuration du routeur RR1
Procédure étape par étape
L’exemple suivant nécessite que vous naviguiez à différents niveaux dans la hiérarchie de configuration. Pour plus d’informations sur la navigation dans la CLI, consultez Utilisation de l’éditeur CLI en mode configuration dans le Guide de l’utilisateur de la CLI.
Pour configurer le routeur RR1 :
Répétez cette procédure pour d’autres routeurs après avoir modifié les noms d’interface, les adresses et d’autres paramètres appropriés.
-
Configurez les interfaces avec des adresses IPv4.
[edit interfaces]
user@RR1# set ge-1/0/10 unit 0 description RR1->R2
user@RR1# set ge-1/0/10 unit 0 family inet address 10.0.12.1/24
user@RR1# set ge-1/0/11 unit 0 description RR1->RR4
user@RR1# set ge-1/0/11 unit 0 family inet address 10.0.14.1/24
user@RR1# set ge-1/0/12 unit 0 description RR1->R5
user@RR1# set ge-1/0/12 unit 0 family inet address 10.0.15.1/24
user@RR1# set ge-1/0/13 unit 0 description RR1->R3
user@RR1# set ge-1/0/13 unit 0 family inet address 10.0.13.1/24
-
Configurez l’adresse de bouclage.
[edit interfaces]
user@RR1# set lo0 unit 0 family inet address 10.0.0.10/32
-
Configurez le protocole de passerelle intérieure (IGP) tel que OSPF ou IS-IS.
[edit protocols]
user@RR1# set ospf area 0.0.0.0 interface lo0.10 passive
user@RR1# set ospf area 0.0.0.0 interface ge-1/0/10
user@RR1# set ospf area 0.0.0.0 interface ge-1/0/13
user@RR1# set ospf area 0.0.0.0 interface ge-1/0/11
user@RR1# set ospf area 0.0.0.0 interface ge-1/0/12
-
Configurez le groupe interne rr pour les interfaces se connectant aux routeurs internes R2 et R3.
[edit protocols] user@RR1# set bgp group rr type internal user@RR1# set bgp group rr local-address 10.0.0.10 user@RR1# set bgp group rr cluster 10.0.0.10 user@RR1# set bgp group rr neighbor 10.0.0.20 user@RR1# set bgp group rr neighbor 10.0.0.30
-
Configurer l’équilibrage de charge pour le groupe BGP interne rr.
[edit protocols] user@RR1# set bgp group rr multipath
-
Configurez les rr_rr de groupe internes pour les réflecteurs de route.
[edit protocols] user@RR1# set bgp group rr_rr type internal user@RR1# set bgp group rr_rr local-address 10.0.0.10
-
Configurez la fonctionnalité de multichemin addpath pour annoncer les chemins multiples des contributeurs uniquement et limiter le nombre de chemins multiples annoncés à 6.
[edit protocols] user@RR1# set bgp group rr_rr neighbor 10.0.0.40 family inet unicast add-path send multipath user@RR1# set bgp group rr_rr neighbor 10.0.0.40 family inet unicast add-path send path-count 6
-
Configurez EBGP sur les interfaces se connectant aux routeurs de périphérie externes.
[edit protocols] user@RR1# set bgp group e1 type external user@RR1# set bgp group e1 neighbor 10.0.15.2 local-address 10.0.15.1 user@RR1# set bgp group e1 neighbor 10.0.15.2 peer-as 64502
-
Définir une stratégie loadbal_199 pour les équilibrage de charge de paquets.
[edit policy-options] user@RR1# set prefix-list match_199 199.1.1.1/32 user@RR1# set policy-statement loadbal_199 term match_100 from prefix-list match_199 user@RR1# set policy-statement loadbal_199 from route-filter 199.1.1.1/32 exact user@RR1# set policy-statement loadbal_199 then load-balance per-packet
-
Appliquez la stratégie d’exportation définie loadbal_199.
[edit routing-options] user@RR1# set forwarding-table export loadbal_199
-
Configurez l’ID de routeur et le système autonome pour les hôtes BGP.
[edit routing-options] user@RR1# set router-id 10.0.0.10 user@RR1# set autonomous-system 64501
Résultats
En mode configuration, confirmez votre configuration en entrant les show interfacescommandes , show protocolsshow routing-options, , et show policy-options . Si la sortie n’affiche pas la configuration prévue, répétez les instructions de cet exemple pour corriger la configuration.
[edit]
user@RR1# show interfaces
ge-1/0/10 {
unit 0 {
description RR1->R2;
family inet {
address 10.0.12.1/24;
}
}
}
ge-1/0/11 {
unit 0 {
description RR1->RR4;
family inet {
address 10.0.14.1/24;
}
}
}
ge-1/0/12 {
unit 0 {
description RR1->R5;
family inet {
address 10.0.15.1/24;
}
}
}
ge-1/0/13 {
unit 0 {
description RR1->R3;
family inet {
address 10.0.13.1/24;
}
}
}
lo0 {
unit 0 {
family inet {
address 10.0.0.10/32;
}
}
}
[edit]
user@RR1# show protocols
bgp {
group rr {
type internal;
local-address 10.0.0.10;
cluster 10.0.0.10;
multipath;
neighbor 10.0.0.20;
neighbor 10.0.0.30;
}
group e1 {
type external;
neighbor 10.0.15.2 {
local-address 10.0.15.1;
peer-as 64502;
}
}
group rr_rr {
type internal;
local-address 10.0.0.10;
neighbor 10.0.0.40 {
family inet {
unicast {
add-path {
send {
path-count 6;
multipath;
}
}
}
}
}
}
}
ospf {
area 0.0.0.0 {
interface all;
interface fxp0.0 {
disable;
}
interface lo0.10 {
passive;
}
interface ge-1/0/10;
interface ge-1/0/13;
interface ge-1/0/11;
interface ge-1/0/12;
}
}
[edit]
user@RR1# show routing-options
router-id 10.0.0.10;
autonomous-system 64501;
forwarding-table {
export load-bal_199;
}
[edit]
user@RR1# show policy-options
prefix-list match_199 {
199.1.1.1/32;
}
policy-statement loadbal_199 {
term match_100 {
from {
prefix-list match_199;
}
}
from {
route-filter 199.1.1.1/32 exact;
}
then {
load-balance per-packet;
}
}
Si vous avez terminé de configurer l’appareil, validez la configuration.
user@RR1# commit
Vérification
Vérifiez que la configuration fonctionne correctement.
- Vérification des routes à trajets multiples pour la route statique 199.1.1.1/32
- Vérification que les routes multichemin sont annoncées du routeur RR1 au routeur RR4
- Vérification que le routeur RR4 annonce une route pour 199.1.1.1/32 vers le routeur R8
Vérification des routes à trajets multiples pour la route statique 199.1.1.1/32
Objet
Vérifiez les itinéraires multichemins disponibles pour la destination 199.1.1.1/32.
Mesures à prendre
À partir du mode opérationnel, exécutez la commande sur le show route 199.1.1.1/32 detail routeur RR1.
user@RR1> show route 199.1.1.1/32 detail
inet.0: 22 destinations, 26 routes (22 active, 0 holddown, 0 hidden)
199.1.1.1/32 (3 entries, 2 announced)
*BGP Preference: 170/-101
Next hop type: Indirect, Next hop index: 0
Address: 0xae5cc90
Next-hop reference count: 1
Source: 10.0.0.20
Next hop type: Router, Next hop index: 1118
Next hop: 10.0.12.2 via lt-1/0/10.1, selected
Session Id: 0x0
Next hop type: Router, Next hop index: 1115
Next hop: 10.0.13.2 via lt-1/0/10.9
Session Id: 0x0
Protocol next hop: 10.0.0.20
Indirect next hop: 0xc409410 1048574 INH Session ID: 0x0
Protocol next hop: 10.0.0.30
Indirect next hop: 0xc409520 1048575 INH Session ID: 0x0
State: <Active Int Ext>
Local AS: 1 Peer AS: 1
Age: 4:03:29 Metric2: 1
Validation State: unverified
Task: BGP_1.10.0.0.20
Announcement bits (3): 2-KRT 3-BGP_RT_Background 4-Resolve tree 2
AS path: 2 I
Communities: 4713:100
Accepted Multipath
Localpref: 100
Router ID: 10.0.0.20
BGP Preference: 170/-101
Next hop type: Indirect, Next hop index: 0
Address: 0xae0ec10
Next-hop reference count: 4
Source: 10.0.0.30
Next hop type: Router, Next hop index: 1115
Next hop: 10.0.13.2 via lt-1/0/10.9, selected
Session Id: 0x0
Protocol next hop: 10.0.0.30
Indirect next hop: 0xc409520 1048575 INH Session ID: 0x0
State: <NotBest Int Ext>
Inactive reason: Not Best in its group - Router ID
Local AS: 64501 Peer AS: 64501
Age: 4:03:29 Metric2: 1
Validation State: unverified
Task: BGP_1.10.0.0.30
Announcement bits (1): 3-BGP_RT_Background
AS path: 2 I
Communities: 4713:100
Accepted MultipathContrib
Localpref: 100
Router ID: 10.0.0.30
BGP Preference: 170/-101
Next hop type: Router, Next hop index: 1105
Address: 0xae0e970
Next-hop reference count: 5
Source: 10.0.15.2
Next hop: 10.0.15.2 via lt-1/0/10.6, selected
Session Id: 0x0
State: <Ext>
Inactive reason: AS path
Local AS: 1 Peer AS: 2
Age: 4:05:01
Validation State: unverified
Task: BGP_2.10.0.15.2
AS path: 2 2 I
Communities: 4713:100
Accepted
Localpref: 100
Router ID: 10.0.0.50
Signification
La fonctionnalité de publicité sélective par trajets multichemins est activée sur le routeur RR1 et il y a plus d’un saut suivant disponible pour la route 199.1.1.1/32. Les deux prochains sauts disponibles pour la route 199.1.1.1/32 sont 10.0.0.20 et 10.0.0.30.
Vérification que les routes multichemin sont annoncées du routeur RR1 au routeur RR4
Objet
Vérifiez que le routeur RR1 annonce les routes multichemins.
Mesures à prendre
À partir du mode opérationnel, exécutez la commande sur le show route advertising-protocol bgp 10.0.0.40 routeur RR1.
user@RR1> show route advertising-protocol bgp 10.0.0.40
inet.0: 22 destinations, 26 routes (22 active, 0 holddown, 0 hidden)
Prefix Nexthop MED Lclpref AS path
* 10.0.0.50/32 10.0.15.2 100 2 2 I
* 10.0.0.60/32 10.0.0.20 100 2 I
* 10.0.0.70/32 10.0.0.30 100 2 I
* 198.1.1.1/32 10.0.0.20 100 2 I
* 199.1.1.1/32 10.0.0.20 100 2 I
10.0.0.30 100 2 I
user@RR1> show route advertising-protocol bgp 10.0.0.40 detail
inet.0: 22 destinations, 26 routes (22 active, 0 holddown, 0 hidden)
* 10.0.0.50/32 (1 entry, 1 announced)
BGP group rr_rr type Internal
Nexthop: 10.0.15.2
Localpref: 100
AS path: [1] 2 2 I
Communities: 4713:100
Addpath Path ID: 1
….* 199.1.1.1/32 (3 entries, 2 announced)
BGP group rr_rr type Internal
Nexthop: 10.0.0.20
Localpref: 100
AS path: [1] 2 I
Communities: 4713:100
Cluster ID: 10.0.0.10
Originator ID: 10.0.0.20
Addpath Path ID: 1
BGP group rr_rr type Internal
Nexthop: 10.0.0.30
Localpref: 100
AS path: [1] 2 I
Communities: 4713:100
Cluster ID: 10.0.0.10
Originator ID: 10.0.0.30
Addpath Path ID: 2
Signification
Le routeur RR1 annonce deux sauts suivants 10.0.0.20 et 10.0.0.30 pour la route 199.1.1.1/32 vers le routeur RR4.
Vérification que le routeur RR4 annonce une route pour 199.1.1.1/32 vers le routeur R8
Objet
Multipath n’est pas configuré sur le routeur RR4, donc la route 199.1.1.1/32 n’est pas éligible pour add-path. Vérifiez que le routeur RR4 n’annonce qu’une seule route pour 199.1.1.1/32 vers le routeur R8.
Mesures à prendre
À partir du mode opérationnel, exécutez la commande sur le show route advertising-protocol bgp 10.0.0.80 routeur RR4.
user@RR4> show route advertising-protocol bgp 10.0.0.80 detail
inet.0: 20 destinations, 21 routes (20 active, 0 holddown, 0 hidden)
* 10.0.0.50/32 (1 entry, 1 announced)
BGP group rr_client type Internal
Nexthop: 10.0.15.2
Localpref: 100
AS path: [1] 2 2 I
Communities: 4713:100
Cluster ID: 10.0.0.40
Originator ID: 10.0.0.10
Addpath Path ID: 1
…
* 198.1.1.1/32 (1 entry, 1 announced)
BGP group rr_client type Internal
Nexthop: 10.0.0.20
Localpref: 100
AS path: [1] 2 I (Originator)
Cluster list: 10.0.0.10
Originator ID: 10.0.0.20
Communities: 4713:100
Cluster ID: 10.0.0.40
Addpath Path ID: 1
* 199.1.1.1/32 (2 entries, 1 announced)
BGP group rr_client type Internal
Nexthop: 10.0.0.20
Localpref: 100
AS path: [1] 2 I (Originator)
Cluster list: 10.0.0.10
Originator ID: 10.0.0.20
Communities: 4713:100
Cluster ID: 10.0.0.40
Addpath Path ID: 1
Signification
Étant donné que le multichemin n’est pas activé sur le routeur RR4, un seul chemin 10.0.0.20 est annoncé au routeur R8.
Exemple : configuration d’une stratégie de routage pour sélectionner et annoncer des chemins multiples en fonction de la valeur communautaire BGP
La publication de tous les chemins multiples disponibles peut entraîner une surcharge importante du traitement sur la mémoire de l’appareil. Si vous souhaitez publier un sous-ensemble limité de préfixes sans connaître les préfixes à l’avance, vous pouvez utiliser la valeur de la communauté BGP pour identifier les routes de préfixe qui doivent être annoncées aux voisins BGP. Cet exemple montre comment définir une politique de routage pour filtrer et annoncer plusieurs chemins en fonction d’une valeur connue de la communauté BGP.
Exigences
Aucune configuration spéciale au-delà de l’initialisation de l’appareil n’est requise avant de configurer cet exemple.
Cet exemple utilise les composants matériels et logiciels suivants :
-
Huit routeurs pouvant être une combinaison de routeurs M Series, MX Series ou T Series
-
Junos OS version 16.1R2 ou ultérieure sur l’équipement
Vue d’ensemble
À partir de Junos OS 16.1R2, vous pouvez définir une stratégie pour identifier les préfixes de chemins multiples éligibles en fonction des valeurs de la communauté. Le BGP annonce ces routes balisées par la communauté en plus du chemin actif vers une destination donnée. Si la valeur communautaire d’une route ne correspond pas à la valeur communautaire définie dans la stratégie, BGP ne publie pas cette route. Cette fonctionnalité permet à BGP d’annoncer un maximum de 20 chemins vers une destination donnée. Vous pouvez limiter et configurer le nombre de préfixes pris en compte par BGP pour plusieurs chemins sans connaître les préfixes à l’avance. Au lieu de cela, une valeur de communauté BGP connue détermine si un préfixe est annoncé ou non.
Topologie
Sur la Figure 8, RR1 et RR4 sont des réflecteurs de route. Les routeurs R2 et R3 sont les clients du réflecteur de route RR1. Le routeur R8 est un client pour router le réflecteur RR4. Les routeurs R5, R6 et R7 redistribuent les routes statiques dans BGP. Le routeur R5 annonce les routes statiques 199.1.1.1/32 et 198.1.1.1/32 avec une valeur communautaire 4713:100.
Le routeur RR1 est configuré pour envoyer jusqu’à six chemins (par destination) au routeur RR4. Le routeur RR4 est configuré pour envoyer jusqu’à six chemins vers le routeur R8. Le routeur R8 est configuré pour recevoir plusieurs chemins du routeur RR4. La configuration de la communauté add-path limite le routeur RR4 à envoyer plusieurs chemins pour les routes qui contiennent uniquement la valeur de communauté 4713:100. Le routeur RR4 filtre et annonce les trajets multiples qui ne contiennent que 4714:100 de valeur communautaire.
communautaire
La configuration
Configuration rapide de la CLI
Pour configurer rapidement cet exemple, copiez les commandes suivantes, collez-les dans un fichier texte, supprimez les sauts de ligne, modifiez tous les détails nécessaires pour qu’ils correspondent à votre configuration réseau, copiez et collez les commandes dans la CLI au niveau de la [edit] hiérarchie, puis entrez Valider à partir du mode de configuration.
Routeur RR1
set interfaces ge-1/0/10 unit 0 description RR1->R2 set interfaces ge-1/0/10 unit 0 family inet address 10.0.12.1/24 set interfaces ge-1/0/11 unit 0 description RR1->RR4 set interfaces ge-1/0/11 unit 0 family inet address 10.0.14.1/24 set interfaces ge-1/0/12 unit 0 description RR1->R5 set interfaces ge-1/0/12 unit 0 family inet address 10.0.15.1/24 set interfaces ge-1/0/13 unit 0 description RR1->R3 set interfaces ge-1/0/13 unit 0 family inet address 10.0.13.1/24 set interfaces lo0 unit 0 family inet address 10.0.0.10/32 set protocols bgp group rr type internal set protocols bgp group rr local-address 10.0.0.10 set protocols bgp group rr cluster 10.0.0.10 set protocols bgp group rr multipath set protocols bgp group rr neighbor 10.0.0.20 set protocols bgp group rr neighbor 10.0.0.30 set protocols bgp group e1 type external set protocols bgp group e1 neighbor 10.0.15.2 local-address 10.0.15.1 set protocols bgp group e1 neighbor 10.0.15.2 peer-as 64502 set protocols bgp group rr_rr type internal set protocols bgp group rr_rr local-address 10.0.0.10 set protocols bgp group rr_rr neighbor 10.0.0.40 family inet unicast add-path send path-count 6 set protocols ospf area 0.0.0.0 interface lo0.10 passive set protocols ospf area 0.0.0.0 interface ge-1/0/10 set protocols ospf area 0.0.0.0 interface ge-1/0/13 set protocols ospf area 0.0.0.0 interface ge-1/0/11 set protocols ospf area 0.0.0.0 interface ge-1/0/12 set routing-options router-id 10.0.0.10 set routing-options autonomous-system 64501
Routeur R2
set interfaces ge-1/0/10 unit 0 description R2->RR1 set interfaces ge-1/0/10 unit 0 family inet address 10.0.12.2/24 set interfaces ge-1/0/11 unit 0 description R2->R6 set interfaces ge-1/0/11 unit 0 family inet address 10.0.26.1/24 set interfaces lo0 unit 0 family inet address 10.0.0.20/32 set protocols bgp group rr local-address 10.0.0.20 set protocols bgp group rr neighbor 10.0.0.10 export set_nh_self set protocols bgp group e1 type external set protocols bgp group e1 neighbor 10.0.26.2 peer-as 64502 set protocols ospf area 0.0.0.0 interface lo0.20 passive set protocols ospf area 0.0.0.0 interface ge-1/0/10 set protocols ospf area 0.0.0.0 interface ge-1/0/11 set policy-options policy-statement set_nh_self then next-hop self set routing-options autonomous-system 64501
Routeur R3
set interfaces ge-1/0/10 unit 0 description R3->RR1 set interfaces ge-1/0/10 unit 0 family inet address 10.0.13.2/24 set interfaces ge-1/0/11 unit 0 description R3->R7 set interfaces ge-1/0/11 unit 0 family inet address 10.0.37.1/24 set interfaces lo0 unit 0 family inet address 10.0.0.30/32 set protocols bgp group rr type internal set protocols bgp group rr local-address 10.0.0.30 set protocols bgp group rr neighbor 10.0.0.10 export set_nh_self set protocols bgp group e1 type external set protocols bgp group e1 neighbor 10.0.37.2 peer-as 64502 set protocols ospf area 0.0.0.0 interface lo0.30 passive set protocols ospf area 0.0.0.0 interface ge-1/0/10 set protocols ospf area 0.0.0.0 interface ge-1/0/13 set policy-options policy-statement set_nh_self then next-hop self set routing-options autonomous-system 64501
Routeur RR4
set interfaces ge-1/0/10 unit 0 description RR4->RR1 set interfaces ge-1/0/10 unit 0 family inet address 10.0.14.2/24 set interfaces ge-1/0/11 unit 0 description RR4->R8 set interfaces ge-1/0/11 unit 0 family inet address 10.0.48.1/24 set interfaces lo0 unit 0 family inet address 10.0.0.40/32 set protocols bgp group rr type internal set protocols bgp group rr local-address 10.0.0.40 set protocols bgp group rr family inet unicast add-path receive set protocols bgp group rr neighbor 10.0.0.10 set protocols bgp group rr_client type internal set protocols bgp group rr_client local-address 10.0.0.40 set protocols bgp group rr_client cluster 10.0.0.40 set protocols bgp group rr_client neighbor 10.0.0.80 family inet unicast add-path send prefix-policy addpath-communities-send-4713-100 set protocols bgp group rr_client neighbor 10.0.0.80 family inet unicast add-path send path-count 6 set protocols ospf area 0.0.0.0 interface ge-1/0/10 set protocols ospf area 0.0.0.0 interface lo0.40 passive set protocols ospf area 0.0.0.0 interface ge-1/0/11 set policy-options community addpath-communities-send members 4713:100 set policy-options policy-statement addpath-communities-send-4713-100 term term1 from protocol bgp set policy-options policy-statement addpath-communities-send-4713-100 term term1 from community addpath-communities-send set policy-options policy-statement addpath-communities-send-4713-100 term term1 then add-path send-count 16 set policy-options policy-statement addpath-communities-send-4713-100 term term1 then accept set routing-options autonomous-system 64501
Routeur R5
set interfaces ge-1/0/10 unit 0 description R5->RR1 set interfaces ge-1/0/10 unit 0 family inet address 10.0.15.2/24 set interfaces lo0 unit 0 family inet address 10.0.0.50/32 set protocols bgp group e1 type external set protocols bgp group e1 neighbor 10.0.15.1 export s2b set protocols bgp group e1 neighbor 10.0.15.1 peer-as 64501 set policy-options policy-statement s2b from protocol static set policy-options policy-statement s2b from protocol direct set policy-options policy-statement s2b then community add addpath-community set policy-options policy-statement s2b then as-path-expand 2 set policy-options policy-statement s2b then accept set policy-options community addpath-community members 4713:100 set routing-options static route 199.1.1.1/32 reject set routing-options static route 198.1.1.1/32 reject set routing-options autonomous-system 64502
Routeur R6
set interfaces ge-1/0/10 unit 0 description R6->R2 set interfaces ge-1/0/10 unit 0 family inet address 10.0.26.2/24 set interfaces lo0 unit 0 family inet address 10.0.0.60/32 set protocols bgp group e1 type external set protocols bgp group e1 neighbor 10.0.26.1 export s2b set protocols bgp group e1 neighbor 10.0.26.1 peer-as 64501 set policy-options policy-statement s2b from protocol static set policy-options policy-statement s2b from protocol direct set policy-options policy-statement s2b then community add addpath-community set policy-options policy-statement s2b then accept set policy-options community addpath-community members 4713:100 set routing-options static route 199.1.1.1/32 reject set routing-options static route 198.1.1.1/32 reject set routing-options autonomous-system 64502
Routeur R7
set interfaces ge-1/0/10 unit 0 description R7->R3 set interfaces ge-1/0/10 unit 0 family inet address 10.0.37.2/24 set interfaces lo0 unit 0 family inet address 10.0.0.70/32 set protocols bgp group e1 type external set protocols bgp group e1 neighbor 10.0.37.1 export s2b set protocols bgp group e1 neighbor 10.0.37.1 peer-as 64501 set policy-options policy-statement s2b from protocol static set policy-options policy-statement s2b from protocol direct set policy-options policy-statement s2b then community add addpath-community set policy-options policy-statement s2b then accept set policy-options community addpath-community members 4713:100 set routing-options static route 199.1.1.1/32 reject set routing-options autonomous-system 64502
Routeur R8
set interfaces ge-1/0/10 unit 0 description R8->RR4 set interfaces ge-1/0/10 unit 0 family inet address 10.0.48.2/24 set interfaces lo0 unit 0 family inet address 10.0.0.80/32 set protocols bgp group rr type internal set protocols bgp group rr local-address 10.0.0.80 set protocols bgp group rr neighbor 10.0.0.40 family inet unicast add-path receive set protocols ospf area 0.0.0.0 interface lo0.0 passive set protocols ospf area 0.0.0.0 interface ge-1/0/10.8 set routing-options autonomous-system 64501 set chassis fpc 1 pic 0 tunnel-services bandwidth 1g
Configuration du routeur RR4
Procédure étape par étape
L’exemple suivant nécessite que vous naviguiez à différents niveaux dans la hiérarchie de configuration. Pour plus d’informations sur la navigation dans la CLI, consultez Utilisation de l’éditeur CLI en mode configuration dans le Guide de l’utilisateur de la CLI.
Pour configurer le routeur RR4 :
Répétez cette procédure pour d’autres routeurs après avoir modifié les noms d’interface, les adresses et d’autres paramètres appropriés.
-
Configurez les interfaces avec des adresses IPv4.
[edit interfaces] user@RR4# set ge-1/0/10 unit 0 description RR4->RR1 user@RR4# set ge-1/0/10 unit 0 family inet address 10.0.14.2/24 user@RR4# set ge-1/0/11 unit 0 description RR4->R8 user@RR4# set ge-1/0/11 unit 0 family inet address 10.0.48.1/24
-
Configurez l’adresse de bouclage.
[edit interfaces] user@RR4# set lo0 unit 0 family inet address 10.0.0.40/32
-
Configurez OSPF ou tout autre protocole de passerelle intérieure (IGP).
[edit protocols] user@RR4# set ospf area 0.0.0.0 interface lo0.40 passive user@RR4# set ospf area 0.0.0.0 interface ge-1/0/10 user@RR4# set ospf area 0.0.0.0 interface ge-1/0/11
-
Configurez deux groupes IBGP : rr pour les réflecteurs de route et rr_client pour les clients des réflecteurs de route.
[edit protocols] user@RR4# set bgp group rr type internal user@RR4# set bgp group rr local-address 10.0.0.40 user@RR4# set bgp group rr family inet unicast add-path receive user@RR4# set bgp group rr neighbor 10.0.0.10 user@RR4# set bgp group rr_client type internal user@RR4# set bgp group rr_client local-address 10.0.0.40 user@RR4# set bgp group rr_client cluster 10.0.0.40
-
Configurez la fonctionnalité pour envoyer plusieurs chemins contenant uniquement la valeur de communauté 4713:100 et limitez le nombre de chemins multiples annoncés à 6.
[edit protocols] user@RR4# set bgp group rr_client neighbor 10.0.0.80 family inet unicast add-path send prefix-policy addpath-communities-send-4713-100 user@RR4# set bgp group rr_client neighbor 10.0.0.80 family inet unicast add-path send path-count 6
-
Définissez une stratégie
addpath-community-members 4713:100pour filtrer les préfixes avec la valeur de communauté 4713:100 et restreindre l’envoi de l’appareil à un maximum de 16 chemins vers le routeur R8. Cette limite remplace le nombre de chemins d’envoi d’add-path précédemment configuré de 6 au niveau de la hiérarchie de groupe BGP.[edit policy-options] user@RR4# set community addpath-communities-send members 4713:100 user@RR4# set policy-statement addpath-communities-send-4713-100 term term1 from protocol bgp user@RR4# set policy-statement addpath-communities-send-4713-100 term term1 from community addpath-communities-send user@RR4# set policy-statement addpath-communities-send-4713-100 term term1 then add-path send-count 16 user@RR4# set policy-statement addpath-communities-send-4713-100 term term1 then accept
-
Configurez l’ID de routeur et le système autonome pour les hôtes BGP.
[edit routing-options] user@RR4# set router-id 10.0.0.40 user@RR4# set autonomous-system 64501
Résultats
En mode configuration, confirmez votre configuration en entrant les show interfacescommandes , show protocolsshow routing-options, , et show policy-options . Si la sortie n’affiche pas la configuration prévue, répétez les instructions de cet exemple pour corriger la configuration.
[edit]
user@RR4# show interfaces
ge-1/0/10 {
unit 0 {
description RR4->RR1;
family inet {
address 10.0.14.2/24;
}
}
}
ge-1/0/11 {
unit 0 {
description RR4->R8;
family inet {
address 10.0.48.1/24;
}
}
}
lo0 {
unit 0 {
family inet {
address 10.0.0.10/32;
}
}
}
[edit]
user@RR4# show protocols
bgp {
group rr {
type internal;
local-address 10.0.0.40;
family inet {
unicast {
add-path {
receive;
}
}
}
neighbor 10.0.0.10;
}
group rr_client {
type internal;
local-address 10.0.0.40;
cluster 10.0.0.40;
neighbor 10.0.0.80 {
family inet {
unicast {
add-path {
send {
prefix-policy addpath-communities-send-4713-100;
path-count 6;
}
}
}
}
}
}
}
ospf {
area 0.0.0.0 {
interface ge-1/0/10.0;
interface lo0.40 {
passive;
}
interface ge-1/0/11.0;
}
}
[edit]
user@RR4# show policy-options
policy-statement addpath-communities-send-4713-100 {
term term1 {
from {
protocol bgp;
community addpath-communities-send;
}
then {
add-path send-count 16;
accept;
}
}
}
community addpath-communities-send members 4713:100;
[edit] user@RR4# show routing-options router-id 10.0.0.40; autonomous-system 64501;
Si vous avez terminé de configurer l’appareil, validez la configuration.
user@RR4# commit
Vérification
Vérifiez que la configuration fonctionne correctement.
- Vérification de l’annonce des routes multichemin du routeur RR4 vers le routeur R8
- Vérification de la capacité du routeur R8 à recevoir les routes à trajets multiples annoncées par le routeur RR4
- Vérification de la disponibilité du routeur RR4 uniquement pour les routes multichemin ayant une valeur communautaire 4713:100 vers le routeur R8
Vérification de l’annonce des routes multichemin du routeur RR4 vers le routeur R8
Objet
Vérifiez que le routeur RR4 peut envoyer plusieurs chemins au routeur R8.
Mesures à prendre
À partir du mode opérationnel, exécutez la commande sur le show route advertising-protocol bgp neighbor-address routeur RR4.
user@RR4> show route advertising-protocol bgp 10.0.0.80
inet.0: 20 destinations, 23 routes (20 active, 0 holddown, 0 hidden)
Prefix Nexthop MED Lclpref AS path
* 10.0.0.50/32 10.0.15.2 100 2 2 I
* 10.0.0.60/32 10.0.0.20 100 2 I
* 10.0.0.70/32 10.0.0.30 100 2 I
* 198.1.1.1/32 10.0.0.20 100 2 I
10.0.15.2 100 2 2 I
* 199.1.1.1/32 10.0.0.20 100 2 I
10.0.0.30 100 2 I
10.0.15.2 100 2 2 I
Signification
Le routeur RR4 annonce plusieurs chemins 10.0.0.20, 10.0.0.30 et 10.0.15.2 vers le routeur R8.
Vérification de la capacité du routeur R8 à recevoir les routes à trajets multiples annoncées par le routeur RR4
Objet
Vérifiez que le routeur R8 reçoit les routes multichemins du routeur RR4.
Mesures à prendre
À partir du mode opérationnel, exécutez la commande sur le show route receive-protocol bgp neighbor-address routeur R8.
user@R8> show route receive-protocol bgp 10.0.0.40
inet.0: 19 destinations, 22 routes (19 active, 0 holddown, 0 hidden)
Prefix Nexthop MED Lclpref AS path
* 10.0.0.50/32 10.0.15.2 100 2 2 I
* 10.0.0.60/32 10.0.0.20 100 2 I
* 10.0.0.70/32 10.0.0.30 100 2 I
* 198.1.1.1/32 10.0.0.20 100 2 I
10.0.15.2 100 2 2 I
* 199.1.1.1/32 10.0.0.20 100 2 I
10.0.0.30 100 2 I
10.0.15.2 100 2 2 I
Signification
Le routeur R8 reçoit plusieurs sauts suivants 10.0.0.20, 10.0.0.30 et 10.0.15.2 pour la route 199.1.1.1/32 du routeur RR4.
Vérification de la disponibilité du routeur RR4 uniquement pour les routes multichemin ayant une valeur communautaire 4713:100 vers le routeur R8
Objet
Le routeur RR4 doit annoncer des routes multichemins avec une valeur communautaire de 4713:100 uniquement au routeur R8.
Mesures à prendre
À partir du mode opérationnel, exécutez la commande sur le show route 199.1.1.1/32 detail routeur RR4.
user@RR4> show route 199.1.1.1/32 detail
inet.0: 20 destinations, 23 routes (20 active, 0 holddown, 0 hidden)
199.1.1.1/32 (3 entries, 3 announced)
*BGP Preference: 170/-101
Next hop type: Indirect, Next hop index: 0
Address: 0xae0ea90
Next-hop reference count: 6
Source: 10.0.0.10
Next hop type: Router, Next hop index: 1115
Next hop: 10.0.14.1 via ge-1/0/10.4, selected
Session Id: 0x0
Protocol next hop: 10.0.0.20
Indirect next hop: 0xc4091f0 1048581 INH Session ID: 0x0
State: <Active Int Ext>
Local AS: 1 Peer AS: 1
Age: 4d 20:56:53 Metric2: 2
Validation State: unverified
Task: BGP_1.10.0.0.10
Announcement bits (3): 2-KRT 3-BGP_RT_Background 4-Resolve tree 2
AS path: 2 I (Originator)
Cluster list: 10.0.0.10
Originator ID: 10.0.0.20
Communities: 4713:100
Accepted
Localpref: 100
Router ID: 10.0.0.10
Addpath Path ID: 1
BGP Preference: 170/-101
Next hop type: Indirect, Next hop index: 0
Address: 0xae0eb50
Next-hop reference count: 3
Source: 10.0.0.10
Next hop type: Router, Next hop index: 1115
Next hop: 10.0.14.1 via lt-1/0/10.4, selected
Session Id: 0x0
Protocol next hop: 10.0.0.30
Indirect next hop: 0xc409300 1048582 INH Session ID: 0x0
State: <NotBest Int Ext>
Inactive reason: Not Best in its group - Router ID
Local AS: 1 Peer AS: 1
Age: 4d 20:56:53 Metric2: 2
Validation State: unverified
Task: BGP_1.10.0.0.10
Announcement bits (1): 3-BGP_RT_Background
AS path: 2 I (Originator)
Cluster list: 10.0.0.10
Originator ID: 10.0.0.30
Communities: 4713:100
Accepted
Localpref: 100
Router ID: 10.0.0.10
Addpath Path ID: 2
BGP Preference: 170/-101
Next hop type: Indirect, Next hop index: 0
Address: 0xae0e9d0
Next-hop reference count: 4
Source: 10.0.0.10
Next hop type: Router, Next hop index: 1115
Next hop: 10.0.14.1 via lt-1/0/10.4, selected
Session Id: 0x0
Protocol next hop: 10.0.15.2
Indirect next hop: 0xc4090e0 1048580 INH Session ID: 0x0
State: <Int Ext>
Inactive reason: AS path
Local AS: 1 Peer AS: 1
Age: 4d 20:56:53 Metric2: 2
Validation State: unverified
Task: BGP_1.10.0.0.10
Announcement bits (1): 3-BGP_RT_Background
AS path: 2 2 I
Communities: 4713:100
Accepted
Localpref: 100
Router ID: 10.0.0.10
Addpath Path ID: 3
Signification
Le routeur RR4 annonce trois chemins avec une valeur communautaire de 4713:100 vers le routeur R8.
Configuration de la résolution récursive sur multichemin BGP
À partir de Junos OS version 17.3R1, lorsqu’un préfixe BGP qui a un seul saut suivant de protocole est résolu sur un autre préfixe BGP qui a plusieurs chemins résolus (uniliste), tous les chemins sont sélectionnés pour la résolution de saut suivant de protocole. Dans les versions antérieures de Junos OS, un seul des chemins était choisi pour la résolution du prochain saut du protocole, car le résolveur ne prenait pas en charge l’équilibrage de charge sur tous les chemins de la route multichemin IBGP. Dans le processus rpd (routing protocol process), le résolveur résout l’adresse de prochain saut (PNH) du protocole en transfert immédiat des sauts suivants. La fonctionnalité de résolution récursive BGP améliore le résolveur pour résoudre les routes sur la route multichemin IBGP et utiliser tous les chemins possibles comme sauts suivants. Cette fonctionnalité profite aux réseaux densément connectés où BGP est utilisée pour établir la connectivité de l’infrastructure, par exemple les réseaux WAN avec des multichemin à coût élevé et une topologie MPLS transparente.
Avant de commencer à configurer la résolution récursive du multichemin BGP, vous devez procéder comme suit :
Configurez les interfaces des appareils.
Configurez OSPF ou tout autre protocole IGP.
Configurez MPLS et LDP.
Configurez BGP.
Pour configurer la résolution récursive sur des chemins multichemins,
Voir aussi
Configuration des prochains sauts ECMP pour les LSP RSVP et LDP pour l’équilibrage de charge
Le Junos OS prend en charge les configurations de 16, 32, 64 ou 128 sauts suivants ECMP (Equal-Cost multichemin) pour RSVP et LDP LSP.s. Pour les réseaux avec un trafic élevé, cela offre plus de flexibilité pour équilibrer la charge du trafic sur un maximum de 128 LSP.
Pour configurer la limite maximale des sauts suivants ECMP, incluez l’instruction maximum-ecmp next-hops au niveau de la [edit chassis] hiérarchie :
[edit chassis] maximum-ecmp next-hops;
Vous pouvez configurer une limite ECMP maximale de saut suivant de 16, 32, 64 ou 128 à l’aide de cette instruction. La limite par défaut est de 16.
Les routeurs MX Series avec une ou plusieurs cartes MPC (Modular Port Concentrator) et sur lesquels Junos OS 11.4 ou une version antérieure est installé, prennent en charge la configuration de l’instruction maximum-ecmp avec seulement 16 sauts suivants. Vous ne devez pas configurer l’instruction maximum-ecmp avec 32 ou 64 sauts suivants. Lorsque vous validez la configuration avec 32 ou 64 sauts suivants, le message d’avertissement suivant s’affiche :
Error: Number of members in Unilist NH exceeds the maximum supported 16 on Trio.
Les types de routes suivants prennent en charge la configuration de saut suivant maximale ECMP pour un maximum de 128 passerelles ECMP :
-
Routes IPv4 et IPv6 statiques avec ECMP de saut suivant direct et indirect
-
Routes d’entrée et de transit LDP apprises via les routes IGP associées
-
RSVP ECMP prochains sauts créés pour les LSP
-
ECMP de route IPv4 et IPv6 OSPF
-
ECMP de route IPv4 et IPv6 IS-IS
-
ECMP de route EBGP IPv4 et IPv6
-
IBGP (résolution via des routes IGP), routes IPv4 et IPv6, ECMP
La limite ECMP améliorée de 128 sauts suivants ECMP maximum s’applique également aux VPN de couche 3, aux VPN de couche 2, aux circuits de couche 2 et aux services VPLS qui se résolvent sur une route MPLS, car les chemins ECMP disponibles dans la route MPLS peuvent également être utilisés par ce trafic.
Si les LSP RSVP sont configurés avec une allocation de bande passante, pour les sauts suivants ECMP avec plus de 16 LSP, le trafic n’est pas distribué de manière optimale en fonction des bandes passantes configurées. Certains LSP avec des bandes passantes allouées plus petites reçoivent plus de trafic que ceux configurés avec des bandes passantes plus élevées. La répartition du trafic n’est pas strictement conforme à l’allocation de bande passante configurée. Cette mise en garde s’applique aux routeurs suivants :
-
Routeurs MX Series avec tous les types de FPC et DPC, à l’exception des MPC. Cette mise en garde ne s’applique pas aux routeurs MX Series avec des cartes de ligne basées sur la puce Junos Trio.
Pour afficher les détails des sauts suivants ECMP, exécutez la show route commande. Le show route summary command affiche également la configuration actuelle pour la limite ECMP maximale. Pour afficher le détail des chemins LDP ECMP, exécutez la traceroute mpls ldp commande.
Voir aussi
Configuration d’un équilibrage de charge cohérent pour les groupes ECMP
L’équilibrage de charge par paquet vous permet de répartir le trafic sur plusieurs chemins à coût égal. Par défaut, lorsqu’une défaillance se produit dans un ou plusieurs chemins, l’algorithme de hachage recalcule le saut suivant pour tous les chemins, ce qui entraîne généralement la redistribution de tous les flux. Un équilibrage de charge cohérent vous permet de remplacer ce comportement afin que seuls les flux des liens inactifs soient redirigés. Tous les flux actifs existants sont maintenus sans interruption. Dans un environnement de datacenter, la redistribution de tous les flux lorsqu’une liaison tombe en panne peut entraîner des pertes de trafic importantes ou une perte de service pour les serveurs dont les liaisons restent actives. Un équilibrage de charge cohérent maintient toutes les liaisons actives et ne mappe que les flux affectés par une ou plusieurs défaillances de liaison. Cette fonctionnalité garantit que les flux connectés aux liens qui restent actifs se poursuivent sans interruption.
Cette fonctionnalité s’applique aux topologies où les membres d’un groupe ECMP (Equal-Cost multichemin) sont des voisins BGP externes dans une session BGP à saut unique. L’équilibrage de charge cohérent ne s’applique en aucun cas lorsque vous ajoutez un nouveau chemin ECMP ou modifiez un chemin existant. Pour ajouter un nouveau chemin avec un minimum de perturbations, définissez un nouveau groupe ECMP sans modifier les chemins existants. De cette façon, les clients peuvent être déplacés progressivement vers le nouveau groupe sans mettre fin aux connexions existantes.
(Sur MX Series) Seuls les concentrateurs de ports modulaires (MPC) sont pris en charge.
Les chemins IPv4 et IPv6 sont pris en charge.
Les groupes ECMP qui font partie d’une instance VRF (Virtual Routing and Forwarding) ou d’une autre instance de routage sont également pris en charge.
Le trafic multicast n’est pas pris en charge.
Les interfaces agrégées sont prises en charge, mais aucun équilibrage de charge cohérent n’est pris en charge entre les membres du bundle d’agrégation de liens (LAG). Le trafic des membres actifs du bundle LAG peut être déplacé vers un autre membre actif en cas de défaillance d’une ou plusieurs liaisons membres. Les flux sont remaniés lorsqu’une ou plusieurs liaisons membres LAG échouent.
Nous vous recommandons vivement d’appliquer un équilibrage de charge cohérent à un maximum de 1 000 préfixes IP par routeur ou commutateur.
L’adjacence de couche 3 sur les interfaces IRB (Integrated Routing and Bridging) est prise en charge.
Vous pouvez configurer la fonctionnalité d’ajout de chemin d’accès de BGP pour permettre le remplacement d’un chemin d’accès défaillant par un nouveau chemin actif en cas de défaillance d’un ou de plusieurs chemins du groupe ECMP. La configuration du remplacement des chemins ayant échoué garantit que le flux de trafic sur les chemins ayant échoué est redirigé uniquement. Le flux de trafic sur les chemins actifs restera inchangé.
Lorsque vous configurez un équilibrage de charge cohérent sur des interfaces de tunnel d’encapsulation de routage générique (GRE), vous devez spécifier l’adresse inet de l’interface GRE distante afin que les contiguïtés de couche 3 sur les interfaces de tunnel GRE soient correctement installées dans la table de transfert. Toutefois, le reroutage rapide (FRR) ECMP sur des interfaces de tunnel GRE n’est pas pris en charge lors de l’équilibrage de charge cohérent. Vous pouvez spécifier l’adresse de destination sur le routeur configuré avec un équilibrage de charge cohérent au niveau de la
[edit interfaces interface name unit unit name family inet address address]hiérarchie. Par exemple :[edit interfaces] user@host# set interfaces gr-4/0/0 unit 21 family inet address 10.10.31.2/32 destination 10.10.31.1
Pour plus d’informations sur l’encapsulation de routage générique, consultez Configuration du tunneling d’encapsulation de routage générique.
L’équilibrage de charge cohérent ne prend pas en charge le saut multiple BGP pour les voisins EBGP. Par conséquent, n’activez pas l’option sur les
multihopéquipements configurés avec un équilibrage de charge cohérent.
Pour configurer un équilibrage de charge cohérent pour les groupes ECMP :
Améliorer la résilience du réseau en utilisant plusieurs homologues ECMP BGP
Vue d’ensemble
Le routage ECMP (Equal-Cost Multipath) est une stratégie de routage réseau qui permet de transmettre le trafic d’une même session, ou d’un même flux, sur plusieurs chemins de coût égal. Un flux est un trafic dont la source et la destination sont identiques. Le processus ECMP identifie les routeurs qui sont légitimes à coût égal et qui effectuent les prochains sauts vers la destination du flux. L’équipement utilise ensuite l’équilibrage de charge pour répartir uniformément le trafic sur ces multiples sauts suivants à coût égal. ECMP est un mécanisme qui vous permet (l’administrateur réseau) d’équilibrer la charge du trafic et d’augmenter la bande passante en utilisant pleinement la bande passante inutilisée sur les liaisons vers la même destination.
Vous utilisez souvent ECMP avec BGP. Chaque route BGP peut avoir plusieurs sauts ECMP suivants. La stratégie d’exportation BGP détermine s’il faut annoncer la route BGP vers ces sauts suivants. En tant qu’administrateur réseau, vous pouvez contrôler la publication et le retrait des préfixes BGP vers et depuis ces homologues ECMP. La stratégie d’exportation BGP détermine s’il faut annoncer un préfixe BGP en fonction du nombre d’homologues BGP ECMP dont la stratégie reçoit le préfixe.
Vous pouvez configurer la stratégie d’exportation BGP pour retirer une route BGP, sauf si elle reçoit le préfixe de route BGP d’un nombre minimal d’homologues ECMP BGP. Exiger que la route BGP ait plusieurs homologues ECMP BGP améliore la résilience en cas de défaillance de liaison.
Avantages
-
Améliore la résilience de votre réseau
-
Empêche la surcharge accidentelle des liaisons
-
Aide à l’équilibrage de charge
La configuration
La stratégie d’exportation BGP compare le nombre de sauts suivants ECMP pour la route BGP à la valeur que vous configurez avec l’instruction à l’une from nexthop-ecmp de ces hiérarchies : [edit policy-options policy-statement policy-name] ou [edit policy-options policy-statement policy-name term term-name].
Les options pour cette déclaration sont les suivantes :
-
value: Le nombre exact de passerelles ECMP (1 à 512) requises pour répondre à la condition. -
equal: Le nombre de passerelles doit être égal à la valeur configurée. -
greater-than: Le nombre de passerelles doit être supérieur à la valeur configurée. -
greater-than-equal: Le nombre de passerelles doit être supérieur ou égal à la valeur configurée. -
less-than: Le nombre de passerelles doit être inférieur à la valeur configurée. -
less-than-equal: Le nombre de passerelles doit être inférieur ou égal à la valeur configurée.
Comprendre l’étiquette d’entropie pour les LSP unicast étiquetés BGP
- Qu’est-ce qu’une étiquette d’entropie ?
- Étiquette d’entropie pour unicast étiqueté BGP
- Fonctionnalités prises en charge et non prises en charge
Qu’est-ce qu’une étiquette d’entropie ?
Une étiquette d’entropie est une étiquette spéciale d’équilibrage de charge qui améliore la capacité du routeur à équilibrer la charge du trafic sur des chemins ECMP (Equal-Cost Multipath) ou des groupes d’agrégation de liens (LAG). L’étiquette d’entropie permet aux routeurs d’équilibrer efficacement le trafic en utilisant uniquement la pile d’étiquettes plutôt que l’inspection approfondie des paquets (DPI). La résolution (DPI) nécessite une plus grande partie de la puissance de traitement du routeur et n’est pas une capacité partagée par tous les routeurs.
Lorsqu’un paquet IP comporte plusieurs chemins pour atteindre sa destination, Junos OS utilise certains champs des en-têtes de paquet pour hacher le paquet selon un chemin déterministe. Les adresses source ou de destination et les numéros de port du paquet sont utilisés pour hacher, afin d’éviter la réorganisation des paquets d’un flux donné. Si un routeur de commutation d’étiquettes (LSR) central n’est pas capable d’effectuer une DPI pour identifier le flux ou ne peut pas le faire au débit de ligne, la pile d’étiquettes seule est utilisée pour le hachage ECMP. Cela nécessite une étiquette d’entropie, une étiquette spéciale d’équilibrage de charge qui peut transporter les informations de flux. Le LSR d’entrée contient plus de contexte et d’informations sur les paquets entrants que les LSR de transit. Par conséquent, le routeur de périphérie d’étiquettes entrantes (LER) peut inspecter les informations de flux d’un paquet, les mapper à une étiquette d’entropie et les insérer dans la pile d’étiquettes. Les LSR du cœur utilisent simplement l’étiquette entropie comme clé pour hacher le paquet vers le bon chemin.
Une étiquette d’entropie peut être n’importe quelle valeur d’étiquette comprise entre 16 et 1048575 (plage d’étiquette normale de 20 bits). Étant donné que cette plage chevauche la plage d’étiquettes standard existante, une étiquette spéciale appelée indicateur d’étiquette d’entropie (ELI) est insérée avant l’étiquette d’entropie. ELI est un label spécial attribué par l’IANA avec la valeur de 7.
La figure 9 illustre l’étiquette d’entropie dans une pile d’étiquettes de paquet RSVP Label-switched path (LSP). La pile d’étiquettes se compose de l’indicateur d’étiquette d’entropie (ELI), de l’étiquette d’entropie et du paquet IP.
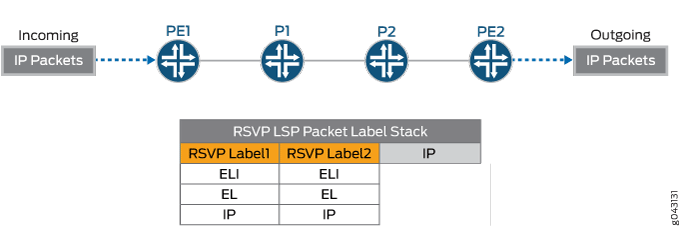
Étiquette d’entropie pour unicast étiqueté BGP
BGP unicasts étiquetés concaténent des LSP RSVP ou LDP dans plusieurs zones de IGP ou plusieurs systèmes autonomes (LSP inter-AS). Les BGP interzones étiquetées unicast les LSP transportent généralement du trafic VPN et IP lorsque les PE entrants et sortants se trouvent dans des zones IGP différentes. Lorsque BGP unicast étiquetés concaténent des LSP RSVP ou LDP, Junos OS insère les étiquettes d’entropie au niveau de la BGP étiquetée unicast entrée LSP pour obtenir une équilibrage de charge d’étiquette d’entropie de bout en bout. En effet, les étiquettes d’entropie RSVP ou LDP sont généralement affichées à l’avant-dernier nœud de saut, avec l’étiquette RSVP ou LDP, et il n’y a pas d’étiquettes d’entropie aux points d’assemblage, c’est-à-dire les routeurs entre deux zones ou deux AS. Par conséquent, en l’absence d’étiquettes d’entropie, le routeur au point d’assemblage utilise les étiquettes BGP pour transférer les paquets. La figure 10 illustre la pile d’étiquettes de paquets unicast étiquetées BGP avec l’étiquette entropie dans une pile d’étiquettes RSVP. La pile d’étiquettes RSVP se compose de l’indicateur d’étiquette d’entropie (ELI), de l’étiquette d’entropie, de l’étiquette BGP et du paquet IP. Les étiquettes d’entropie RSVP apparaissent à l’avant-dernier nœud de saut.
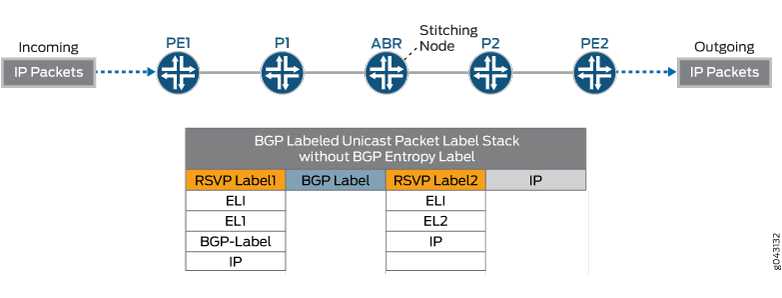 RSVP
Le nœud d’assemblage unicast étiqueté BGP ne peut pas utiliser les étiquettes d’entropie pour l’équilibrage de charge, sauf si le nœud d’assemblage signale la capacité d’étiquette d’entropie à la sortie du BGP. Si le nœud d’assemblage unicast BGP étiqueté signale BGP capacité d’étiquette d’entropie (ELC) aux routeurs de périphérie du fournisseur, le BGP étiqueté unicast entrée LSP sait que le BGP étiqueté unicast sortie LSP peut gérer les étiquettes d’entropie et insère un indicateur d’étiquette d’entropie et une étiquette d’entropie sous l’étiquette BGP. Tous les LSR sont capables d’utiliser l’étiquette entropie pour l’équilibrage de charge. Bien que BGP unicast LSP étiqueté puisse traverser de nombreux routeurs dans différentes zones et AS, il est possible que certains segments prennent en charge les étiquettes d’entropie et d’autres non. La figure 11 illustre l’étiquette d’entropie dans la pile d’étiquettes BGP. La pile d’étiquettes au niveau du nœud d’assemblage se compose de l’ELI, de l’étiquette d’entropie et du paquet IP.
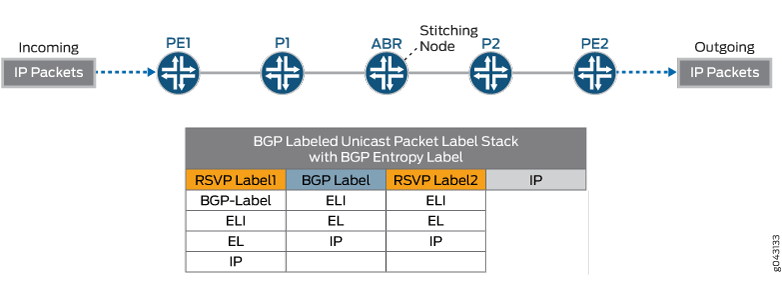 d’assemblage
Pour désactiver la fonctionnalité d’étiquette d’entropie pour l’unicast étiqueté BGP au niveau du nœud de sortie, définissez une stratégie avec l’option no-entropy-label-capability au niveau de la [edit policy-options policy-statement policy-name then] hiérarchie.
[edit policy-options policy-statement policy-name then]user@PE#no-entropy-label-capability
Par défaut, les routeurs qui prennent en charge les étiquettes d’entropie sont configurés avec l’instruction load-balance-label-capability au niveau de la [edit forwarding-options] hiérarchie pour signaler les étiquettes par LSP. Si le routeur homologue n’est pas équipé pour gérer les étiquettes d’équilibrage de charge, vous pouvez empêcher la signalisation de la capacité d’étiquette d’entropie en configurant l’instruction no-load-balance-label-capability au niveau de la [edit forwarding-options] hiérarchie.
[edit forwarding-options]user@PE#no-load-balance-label-capability
Par défaut, un interlocuteur BGP utilise l’attribut ELCv3 (Entropy Label Capability) défini dans l’attribut de capacité de routeur (RCA) IETF BGP pour l’équilibrage de charge. Il envoie et reçoit uniquement l’attribut ELCv3. Si vous avez besoin d’utiliser l’attribut ELCv2 de manière interopérable avec le brouillon RCA, configurez explicitement le elc-v2-compatible bouton dans la hiérarchie entropie-étiquette labeled-unicast. Dans un tel scénario, ELCv3 et ELCv2 sont envoyés et reçus.
Fonctionnalités prises en charge et non prises en charge
Junos OS prend en charge une étiquette d’entropie pour les BGP étiquetées unicast dans les scénarios suivants :
-
Tous les nœuds des LSP ont une capacité d’étiquette d’entropie.
-
Certains nœuds des LSP ont une capacité d’étiquette d’entropie.
-
Les LSP utilisent un tunnel via le VPN d’un autre opérateur.
-
Définissez une stratégie entrante pour sélectionner un sous-ensemble de LSP unicast étiquetés BGP afin d’insérer une étiquette d’entropie à l’entrée.
-
Définir une stratégie de sortie pour désactiver la publication de la capacité d’étiquette d’entropie.
Junos OS ne prend pas en charge les fonctionnalités suivantes pour une étiquette d’entropie pour un unicast étiqueté BGP :
-
Lorsque BGP unicast les LSP étiquetés passent par le VPN d’un autre opérateur, il n’y a pas de véritable étiquette d’entropie de bout en bout, car Junos OS n’insère pas d’indicateur d’étiquette d’entropie ou d’étiquette d’entropie sous les étiquettes VPN sur le réseau de l’opérateur des opérateurs.
-
Actuellement, Junos OS ne prend pas en charge les BGP IPv6 étiquetés unicast LSP avec leurs propres étiquettes d’entropie. Toutefois, les BGP IPv6 étiquetés unicast LSP peuvent utiliser les étiquettes d’entropie des LSP RSVP, LDP ou BGP sous-jacents.
Voir aussi
Configurer une étiquette d’entropie pour un LSP unicast étiqueté BGP
Configurez une étiquette d’entropie pour un LSP unicast étiqueté BGP afin d’obtenir un équilibrage de charge d’étiquette d’entropie de bout en bout. Une étiquette d’entropie est une étiquette spéciale d’équilibrage de charge qui peut transporter les informations de flux des paquets. Les unicasts marqués BGP concatènent généralement des LSP RSVP ou LDP sur plusieurs zones IGP ou plusieurs systèmes autonomes (AS). Les étiquettes d’entropie RSVP ou LDP sont placées sur l’avant-dernier nœud de saut, en même temps que l’étiquette RSVP ou LDP. Cette fonctionnalité permet l’utilisation d’une étiquette d’entropie au point d’assemblage, c’est-à-dire les routeurs entre deux zones ou AS, afin d’obtenir un équilibrage de charge d’étiquette d’entropie de bout en bout pour le trafic BGP. Cette fonctionnalité permet d’insérer des étiquettes d’entropie à l’entrée LSP unicast étiquetée BGP.
Une étiquette d’entropie peut être n’importe quelle valeur d’étiquette comprise entre 16 et 1048575 (plage d’étiquette normale de 20 bits). Étant donné que cette plage chevauche la plage d’étiquettes standard existante, une étiquette spéciale appelée indicateur d’étiquette d’entropie (ELI) est insérée avant l’étiquette d’entropie. ELI est un label spécial attribué par l’IANA avec la valeur de 7.
Avant de configurer une étiquette d’entropie pour un unicast étiqueté BGP, assurez-vous de :
Configurez les interfaces des appareils.
Configurez OSPF ou tout autre protocole IGP.
Configurez BGP.
Configurez LDP.
Configurez RSVP.
Configurez le MPLS.
Pour configurer une étiquette d’entropie pour un LSP unicast étiqueté BGP :
Voir aussi
Exemple : Configuration d’une étiquette d’entropie pour un LSP unicast étiqueté BGP
Cet exemple montre comment configurer une étiquette d’entropie pour un unicast étiqueté BGP afin d’obtenir un équilibrage de charge de bout en bout à l’aide d’étiquettes d’entropie. Lorsqu’un paquet IP comporte plusieurs chemins pour atteindre sa destination, Junos OS utilise certains champs des en-têtes de paquet pour hacher le paquet selon un chemin déterministe. Cela nécessite une étiquette d’entropie, une étiquette spéciale d’équilibrage de charge qui peut transporter les informations de flux. Les LSR du cœur utilisent simplement l’étiquette entropie comme clé pour hacher le paquet jusqu’au bon chemin. Une étiquette d’entropie peut être n’importe quelle valeur d’étiquette comprise entre 16 et 1048575 (plage d’étiquette normale de 20 bits). Étant donné que cette plage chevauche la plage d’étiquettes standard existante, une étiquette spéciale appelée indicateur d’étiquette d’entropie (ELI) est insérée avant l’étiquette d’entropie. ELI est un label spécial attribué par l’IANA avec la valeur de 7.
Les unicasts marqués BGP concatènent généralement des LSP RSVP ou LDP sur plusieurs zones IGP ou plusieurs systèmes autonomes. Les étiquettes d’entropie RSVP ou LDP sont placées sur l’avant-dernier nœud de saut, en même temps que l’étiquette RSVP ou LDP. Cette fonctionnalité permet l’utilisation d’étiquettes d’entropie aux points d’assemblage pour combler l’écart entre l’avant-dernier nœud de saut et le point d’assemblage, afin d’obtenir un équilibrage de charge d’étiquette d’entropie de bout en bout pour le trafic BGP.
Exigences
Cet exemple utilise les composants matériels et logiciels suivants :
-
Sept routeurs MX Series avec MPC
-
Junos OS version 15.1 ou ultérieure s’exécutant sur tous les équipements
-
Revalidé à l’aide de Junos OS Relese 22.4
-
Avant de configurer une étiquette d’entropie pour un unicast étiqueté BGP, assurez-vous de :
-
Configurez les interfaces des appareils.
-
Configurez OSPF ou tout autre protocole IGP.
-
Configurez BGP.
-
Configurez RSVP.
-
Configurez le MPLS.
Vue d’ensemble
Lorsque des unicasts marqués BGP concatènent des LSP RSVP ou LDP sur plusieurs zones IGP ou plusieurs systèmes autonomes, des étiquettes d’entropie RSVP ou LDP sont affichées à l’avant-dernier nœud de saut, avec l’étiquette RSVP ou LDP. Cependant, il n’y a pas d’étiquettes d’entropie aux points d’assemblage, c’est-à-dire les routeurs entre deux zones. Par conséquent, les routeurs aux points d’assemblage utilisaient les étiquettes BGP pour transférer les paquets.
À partir de la version 15.1 de Junos OS, vous pouvez configurer une étiquette d’entropie pour l’unicast étiqueté BGP afin d’obtenir un équilibrage de charge d’étiquette d’entropie de bout en bout. Cette fonctionnalité permet l’utilisation d’une étiquette d’entropie aux points d’assemblage afin d’obtenir un équilibrage de charge d’étiquette d’entropie de bout en bout pour le trafic BGP. Junos OS permet d’insérer des étiquettes d’entropie au niveau de la BGP étiquetée unicast entrée LSP.
Par défaut, les routeurs qui prennent en charge les étiquettes d’entropie sont configurés avec l’instruction load-balance-label-capability au niveau de la [edit forwarding-options] hiérarchie pour signaler les étiquettes par LSP. Si le routeur homologue n’est pas équipé pour gérer les étiquettes d’équilibrage de charge, vous pouvez empêcher la signalisation de la capacité d’étiquette d’entropie en configurant le no-load-balance-label-capability au niveau de la [edit forwarding-options] hiérarchie.
[edit forwarding-options]user@PE#no-load-balance-label-capability
Vous pouvez désactiver explicitement la fonctionnalité d’étiquette d’entropie publicitaire à la sortie pour les routes spécifiées dans la stratégie avec l’option no-entropy-label-capability au niveau de la [edit policy-options policy-statement policy name then] hiérarchie.
[edit policy-options policy-statement policy-name then]user@PE#no-entropy-label-capability
Topologie
Sur la Figure 12 , le routeur PE1 est le routeur entrant et le routeur PE2 est le routeur de sortie. Les routeurs P1 et P2 sont les routeurs de transit. Le routeur ABR est le routeur de pont de zone entre la zone 0 et la zone 1. Deux LSP sont configurés sur l’ABR à PE2 pour l’équilibrage de charge du trafic. La capacité d’étiquette d’entropie pour BGP unicast étiquetée est activée sur le routeur entrant PE1. L’hôte 1 est connecté à P1 pour les captures de paquets afin que nous puissions afficher l’étiquette d’entropie.
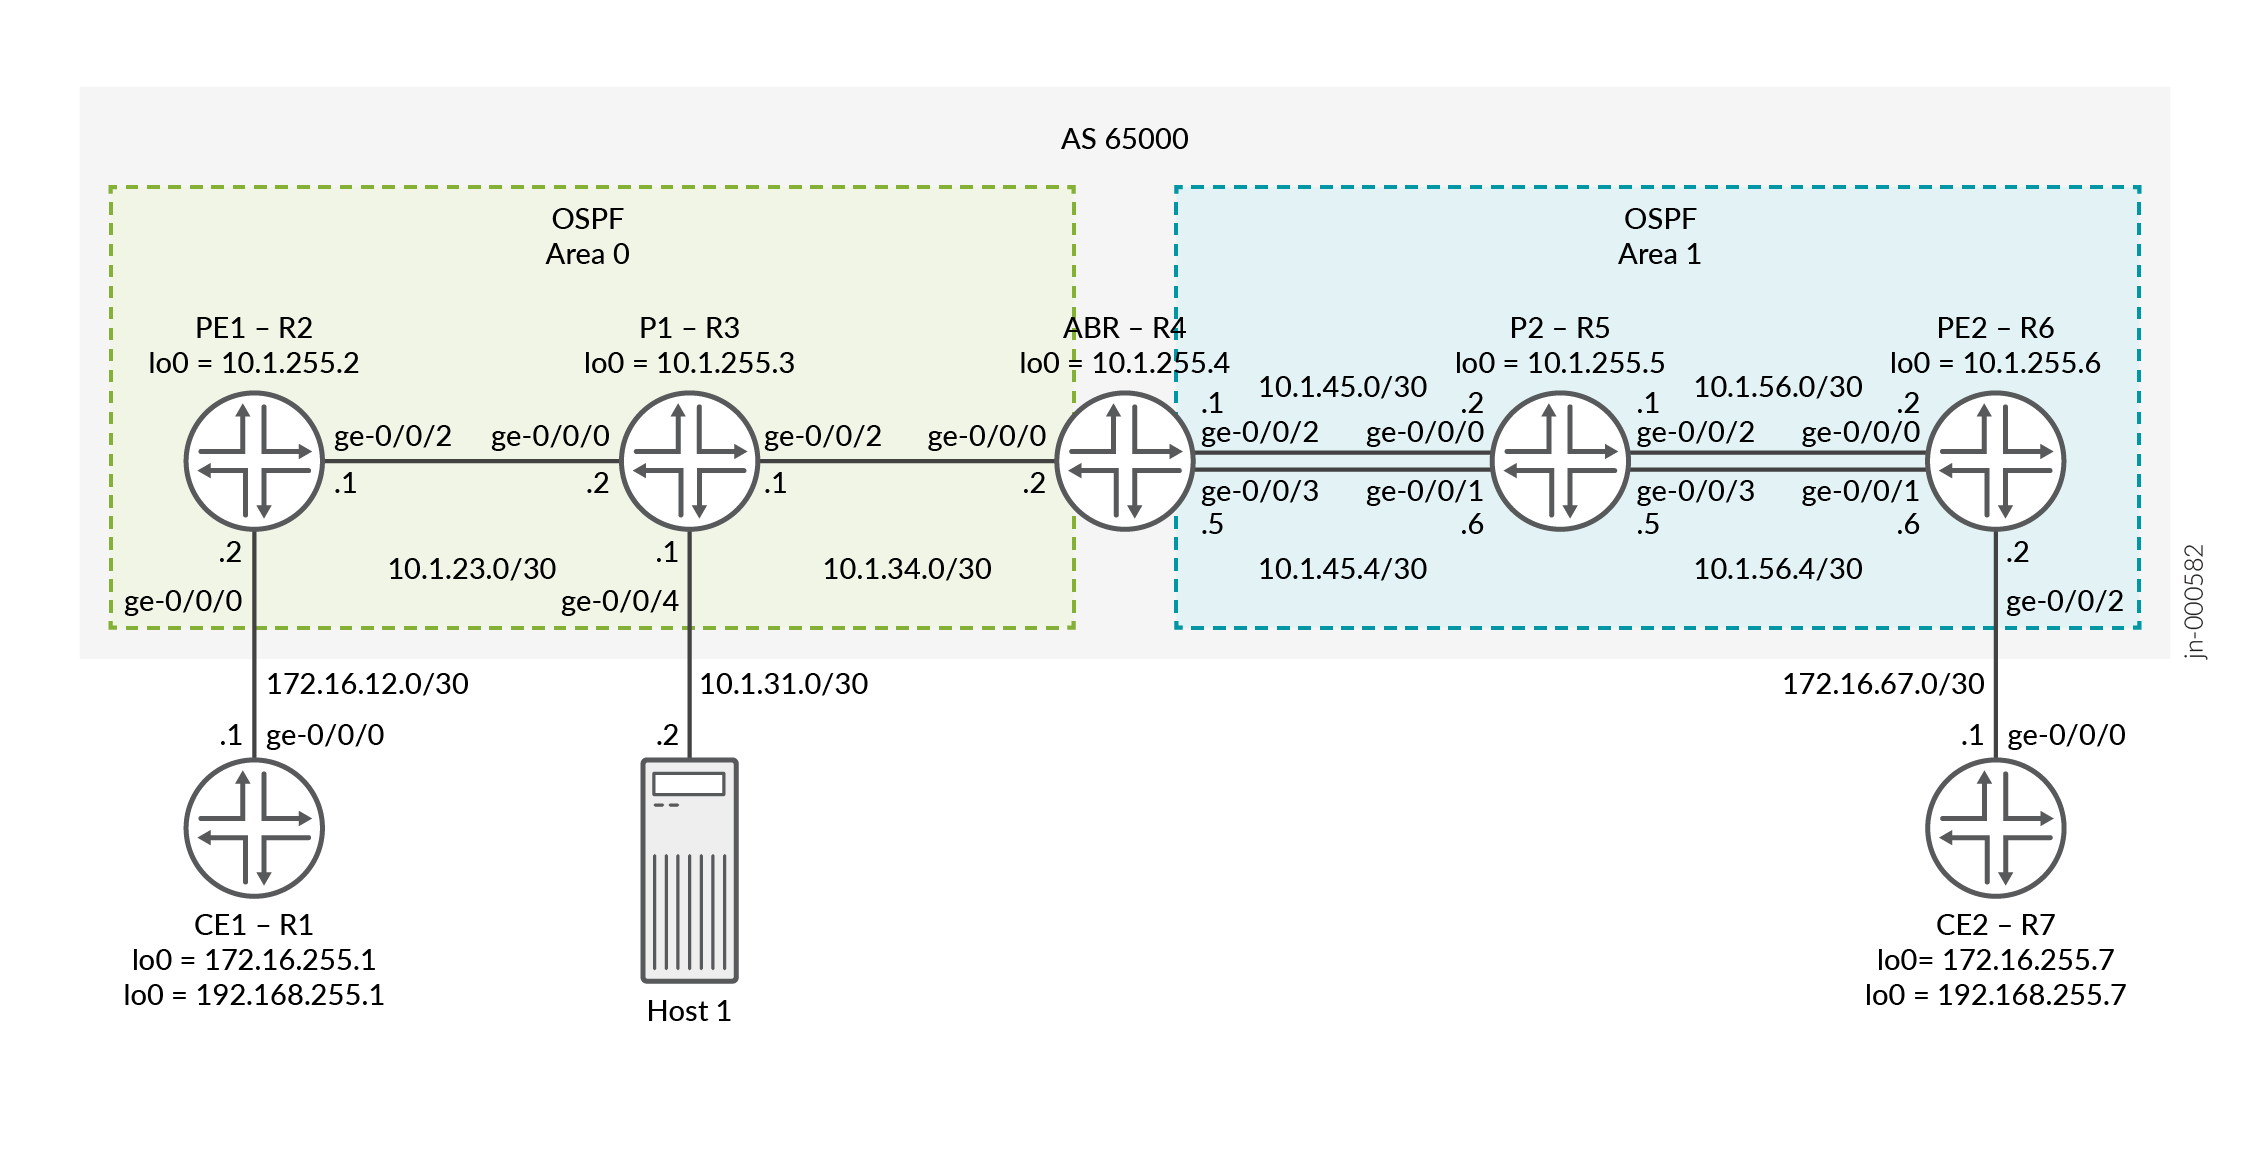 étiqueté BGP
La configuration
- Configuration rapide de la CLI
- Configuration du routeur PE1
- Configuration du routeur P1
- Configuration de l’ABR du routeur
- (Facultatif) Configuration de la mise en miroir des ports
Configuration rapide de la CLI
Pour configurer rapidement cet exemple, copiez les commandes suivantes, collez-les dans un fichier texte, supprimez les sauts de ligne, modifiez tous les détails nécessaires pour qu’ils correspondent à votre configuration réseau, copiez et collez les commandes dans la CLI au niveau de la [edit] hiérarchie, puis entrez commit en mode configuration.
Routeur CE1
set interfaces ge-0/0/0 unit 0 family inet address 172.16.12.1/30 set interfaces lo0 unit 0 family inet address 172.16.255.1/32 primary set interfaces lo0 unit 0 family inet address 192.168.255.1/32 set routing-options router-id 172.16.255.1 set protocols ospf area 0.0.0.0 interface ge-0/0/0.0 set protocols ospf area 0.0.0.0 interface lo0.0 passive
Routeur PE1
set interfaces ge-0/0/0 unit 0 family inet address 172.16.12.2/30 set interfaces ge-0/0/2 unit 0 family inet address 10.1.23.1/30 set interfaces ge-0/0/2 unit 0 family mpls set interfaces lo0 unit 0 family inet address 10.1.255.2/32 primary set interfaces lo0 unit 1 family inet address 10.1.255.22/32 set policy-options policy-statement bgp-to-ospf from protocol bgp set policy-options policy-statement bgp-to-ospf then accept set policy-options policy-statement pplb then load-balance per-packet set routing-instances VPN-l3vpn instance-type vrf set routing-instances VPN-l3vpn protocols ospf area 0.0.0.0 interface ge-0/0/0.0 set routing-instances VPN-l3vpn protocols ospf area 0.0.0.0 interface lo0.1 passive set routing-instances VPN-l3vpn protocols ospf export bgp-to-ospf set routing-instances VPN-l3vpn interface ge-0/0/0.0 set routing-instances VPN-l3vpn interface lo0.1 set routing-instances VPN-l3vpn route-distinguisher 10.1.255.2:1 set routing-instances VPN-l3vpn vrf-target target:65000:1 set routing-options router-id 10.1.255.2 set routing-options autonomous-system 65000 set routing-options forwarding-table export pplb set protocols bgp group ibgp type internal set protocols bgp group ibgp local-address 10.1.255.2 set protocols bgp group ibgp family inet labeled-unicast entropy-label set protocols bgp group ibgp neighbor 10.1.255.4 family inet labeled-unicast rib inet.3 set protocols bgp group ibgp neighbor 10.1.255.6 family inet-vpn unicast set protocols mpls icmp-tunneling set protocols mpls label-switched-path pe1-abr to 10.1.255.4 set protocols mpls label-switched-path pe1-abr entropy-label set protocols mpls interface ge-0/0/2.0 set protocols mpls interface lo0.0 set protocols ospf traffic-engineering set protocols ospf area 0.0.0.0 interface ge-0/0/2.0 set protocols ospf area 0.0.0.0 interface lo0.0 passive set protocols rsvp interface ge-0/0/2.0 set protocols rsvp interface lo0.0
Routeur P1
set interfaces ge-0/0/0 unit 0 family inet address 10.1.23.2/30 set interfaces ge-0/0/0 unit 0 family mpls set interfaces ge-0/0/2 unit 0 family inet address 10.1.34.1/30 set interfaces ge-0/0/2 unit 0 family mpls set interfaces lo0 unit 0 family inet address 10.1.255.3/32 primary set routing-options router-id 10.1.255.3 set protocols mpls icmp-tunneling set protocols mpls interface ge-0/0/0.0 set protocols mpls interface lo0.0 set protocols mpls interface ge-0/0/2.0 set protocols ospf traffic-engineering set protocols ospf area 0.0.0.0 interface lo0.0 passive set protocols ospf area 0.0.0.0 interface ge-0/0/0.0 set protocols ospf area 0.0.0.0 interface ge-0/0/2.0 set protocols rsvp interface ge-0/0/0.0 set protocols rsvp interface lo0.0 set protocols rsvp interface ge-0/0/2.0
Routeur ABR
set interfaces ge-0/0/0 unit 0 family inet address 10.1.34.2/30 set interfaces ge-0/0/0 unit 0 family mpls set interfaces ge-0/0/2 unit 0 family inet address 10.1.45.1/30 set interfaces ge-0/0/2 unit 0 family mpls set interfaces ge-0/0/3 unit 0 family inet address 10.1.45.5/30 set interfaces ge-0/0/3 unit 0 family mpls set interfaces lo0 unit 0 family inet address 10.1.255.4/32 primary set forwarding-options hash-key family mpls label-1 set forwarding-options hash-key family mpls label-2 set forwarding-options hash-key family mpls label-3 set forwarding-options enhanced-hash-key family mpls no-payload set policy-options policy-statement pplb then load-balance per-packet set policy-options policy-statement send-inet3-pe1 from route-filter 10.1.255.2/32 exact set policy-options policy-statement send-inet3-pe1 then accept set policy-options policy-statement send-inet3-pe2 from route-filter 10.1.255.6/32 exact set policy-options policy-statement send-inet3-pe2 then accept set routing-options router-id 10.1.255.4 set routing-options autonomous-system 65000 set routing-options forwarding-table export pplb set protocols bgp group ibgp type internal set protocols bgp group ibgp local-address 10.1.255.4 set protocols bgp group ibgp family inet labeled-unicast rib inet.3 set protocols bgp group ibgp neighbor 10.1.255.2 export send-inet3-pe2 set protocols bgp group ibgp neighbor 10.1.255.6 export send-inet3-pe1 set protocols mpls icmp-tunneling set protocols mpls label-switched-path abr-pe1 to 10.1.255.2 set protocols mpls label-switched-path abr-pe1 entropy-label set protocols mpls label-switched-path abr-pe2 to 10.1.255.6 set protocols mpls label-switched-path abr-pe2 entropy-label set protocols mpls label-switched-path abr-pe2 primary to-r6-1 set protocols mpls label-switched-path abr-pe2-2 to 10.1.255.6 set protocols mpls label-switched-path abr-pe2-2 entropy-label set protocols mpls label-switched-path abr-pe2-2 primary to-r6-2 set protocols mpls path to-r6-1 10.1.45.2 strict set protocols mpls path to-r6-1 10.1.56.2 strict set protocols mpls path to-r6-2 10.1.45.6 strict set protocols mpls path to-r6-2 10.1.56.6 strict set protocols mpls interface lo0.0 set protocols mpls interface ge-0/0/0.0 set protocols mpls interface ge-0/0/2.0 set protocols mpls interface ge-0/0/3.0 set protocols ospf traffic-engineering set protocols ospf area 0.0.0.0 interface lo0.0 passive set protocols ospf area 0.0.0.0 interface ge-0/0/0.0 set protocols ospf area 0.0.0.1 interface ge-0/0/2.0 set protocols ospf area 0.0.0.1 interface ge-0/0/3.0 set protocols rsvp interface lo0.0 set protocols rsvp interface ge-0/0/0.0 set protocols rsvp interface ge-0/0/2.0 set protocols rsvp interface ge-0/0/3.0
Routeur P2
set interfaces ge-0/0/0 unit 0 family inet address 10.1.45.2/30 set interfaces ge-0/0/0 unit 0 family mpls set interfaces ge-0/0/1 unit 0 family inet address 10.1.45.6/30 set interfaces ge-0/0/1 unit 0 family mpls set interfaces ge-0/0/2 unit 0 family inet address 10.1.56.1/30 set interfaces ge-0/0/2 unit 0 family mpls set interfaces ge-0/0/3 unit 0 family inet address 10.1.56.5/30 set interfaces ge-0/0/3 unit 0 family mpls set interfaces lo0 unit 0 family inet address 10.1.255.5/32 primary set forwarding-options hash-key family mpls label-1 set forwarding-options hash-key family mpls label-2 set forwarding-options hash-key family mpls label-3 set forwarding-options enhanced-hash-key family mpls no-payload set policy-options policy-statement pplb then load-balance per-packet set routing-options router-id 10.1.255.5 set routing-options forwarding-table export pplb set protocols mpls icmp-tunneling set protocols mpls interface ge-0/0/2.0 set protocols mpls interface lo0.0 set protocols mpls interface ge-0/0/0.0 set protocols mpls interface ge-0/0/1.0 set protocols mpls interface ge-0/0/3.0 set protocols ospf traffic-engineering set protocols ospf area 0.0.0.1 interface lo0.0 passive set protocols ospf area 0.0.0.1 interface ge-0/0/2.0 set protocols ospf area 0.0.0.1 interface ge-0/0/0.0 set protocols ospf area 0.0.0.1 interface ge-0/0/1.0 set protocols ospf area 0.0.0.1 interface ge-0/0/3.0 set protocols rsvp interface ge-0/0/2.0 set protocols rsvp interface lo0.0 set protocols rsvp interface ge-0/0/0.0 set protocols rsvp interface ge-0/0/1.0 set protocols rsvp interface ge-0/0/3.0
Routeur PE2
set interfaces ge-0/0/0 unit 0 family inet address 10.1.56.2/30 set interfaces ge-0/0/0 unit 0 family mpls set interfaces ge-0/0/1 unit 0 family inet address 10.1.56.6/30 set interfaces ge-0/0/1 unit 0 family mpls set interfaces ge-0/0/2 unit 0 family inet address 172.16.67.2/30 set interfaces lo0 unit 0 family inet address 10.1.255.6/32 primary set interfaces lo0 unit 1 family inet address 10.1.255.66/32 set forwarding-options hash-key family mpls label-1 set forwarding-options hash-key family mpls label-2 set forwarding-options hash-key family mpls label-3 set forwarding-options enhanced-hash-key family mpls no-payload set policy-options policy-statement bgp-to-ospf from protocol bgp set policy-options policy-statement bgp-to-ospf then accept set policy-options policy-statement pplb then load-balance per-packet set routing-instances VPN-l3vpn instance-type vrf set routing-instances VPN-l3vpn protocols ospf area 0.0.0.0 interface ge-0/0/2.0 set routing-instances VPN-l3vpn protocols ospf area 0.0.0.0 interface lo0.1 passive set routing-instances VPN-l3vpn protocols ospf export bgp-to-ospf set routing-instances VPN-l3vpn interface ge-0/0/2.0 set routing-instances VPN-l3vpn interface lo0.1 set routing-instances VPN-l3vpn route-distinguisher 10.1.255.6:1 set routing-instances VPN-l3vpn vrf-target target:65000:1 set routing-options router-id 10.1.255.6 set routing-options autonomous-system 65000 set routing-options forwarding-table export pplb set protocols bgp group ibgp type internal set protocols bgp group ibgp local-address 10.1.255.6 set protocols bgp group ibgp family inet labeled-unicast entropy-label set protocols bgp group ibgp neighbor 10.1.255.4 family inet labeled-unicast rib inet.3 set protocols bgp group ibgp neighbor 10.1.255.2 family inet-vpn unicast set protocols mpls icmp-tunneling set protocols mpls label-switched-path pe2-abr to 10.1.255.4 set protocols mpls label-switched-path pe2-abr entropy-label set protocols mpls interface ge-0/0/0.0 set protocols mpls interface lo0.0 set protocols mpls interface ge-0/0/1.0 set protocols ospf traffic-engineering set protocols ospf area 0.0.0.1 interface ge-0/0/0.0 set protocols ospf area 0.0.0.1 interface lo0.0 passive set protocols ospf area 0.0.0.1 interface ge-0/0/1.0 set protocols rsvp interface ge-0/0/0.0 set protocols rsvp interface lo0.0 set protocols rsvp interface ge-0/0/1.0
Routeur CE2
set interfaces ge-0/0/0 unit 0 family inet address 172.16.67.1/30 set interfaces lo0 unit 0 family inet address 172.16.255.7/32 primary set interfaces lo0 unit 0 family inet address 192.168.255.7/32 set routing-options router-id 172.16.255.7 set protocols ospf area 0.0.0.0 interface ge-0/0/0.0 set protocols ospf area 0.0.0.0 interface lo0.0 passive
Configuration du routeur PE1
Procédure étape par étape
L’exemple suivant nécessite que vous naviguiez à différents niveaux dans la hiérarchie de configuration. Pour plus d’informations sur la navigation dans la CLI, consultez Utilisation de l’éditeur CLI en mode configuration dans le Guide de l’utilisateur de la CLI.
Pour configurer le routeur PE1 :
Répétez cette procédure pour le routeur PE2 après avoir modifié les noms d’interface, les adresses et d’autres paramètres appropriés.
-
Configurez les interfaces physiques. Assurez-vous de configurer
family mplssur l’interface principale.[edit] user@PE1# set interfaces ge-0/0/0 unit 0 family inet address 172.16.12.2/30 user@PE1# set interfaces ge-0/0/2 unit 0 family inet address 10.1.23.1/30 user@PE1# set interfaces ge-0/0/2 unit 0 family mpls
-
Configurez les interfaces de bouclage. Le bouclage secondaire est facultatif et est appliqué à l’instance de routage dans une étape ultérieure.
[edit] user@PE1# set interfaces lo0 unit 0 family inet address 10.1.255.2/32 primary user@PE1# set interfaces lo0 unit 1 family inet address 10.1.255.22/32
-
Configurez l’ID du routeur et le numéro du système autonome.
[edit] user@PE1# set routing-options router-id 10.1.255.2 user@PE1# set routing-options autonomous-system 65000
-
Configurez le protocole OSPF.
[edit] user@PE1# set protocols ospf traffic-engineering user@PE1# set protocols ospf area 0.0.0.0 interface ge-0/0/2.0 user@PE1# set protocols ospf area 0.0.0.0 interface lo0.0 passive
-
Configurez le protocole RSVP.
[edit] user@PE1# set protocols rsvp interface ge-0/0/2.0 user@PE1# set protocols rsvp interface lo0.0
-
Configurez le protocole MPLS et un LSP vers l’ABR. Incluez l’option
entropy-labelpermettant d’ajouter l’étiquette d’entropie à la pile d’étiquettes MPLS.[edit protocols] user@PE1# set protocols mpls icmp-tunneling user@PE1# set protocols mpls label-switched-path pe1-abr to 10.1.255.4 user@PE1# set protocols mpls label-switched-path pe1-abr entropy-label user@PE1# set protocols mpls interface ge-0/0/2.0 user@PE1# set protocols mpls interface lo0.0
-
Configurez IBGP à l’aide de l’appairage
family inet labeled-unicastABR etfamily inet-vpnde l’appairage PE2. Activez la fonctionnalité d’étiquette d’entropie pour les unicast étiquetés BGP.[edit] user@PE1# set protocols bgp group ibgp type internal user@PE1# set protocols bgp group ibgp local-address 10.1.255.2 user@PE1# set protocols bgp group ibgp family inet labeled-unicast entropy-label user@PE1# set protocols bgp group ibgp neighbor 10.1.255.4 family inet labeled-unicast rib inet.3 user@PE1# set protocols bgp group ibgp neighbor 10.1.255.6 family inet-vpn unicast
-
Définissez une stratégie pour exporter les routes VPN BGP vers OSPF. La stratégie est appliquée sous OSPF dans l’instance de routage.
[edit] user@PE1# set policy-options policy-statement bgp-to-ospf from protocol bgp user@PE1# set policy-options policy-statement bgp-to-ospf then accept
-
Définissez une stratégie d’équilibrage de charge et appliquez-la sous le
routing-options forwarding-table. PE1 n’a qu’un seul chemin dans l’exemple, donc cette étape n’est pas nécessaire, mais pour cet exemple, nous appliquons la même politique d’équilibrage de charge sur tous les appareils.[edit] user@PE1# set policy-options policy-statement pplb then load-balance per-packet user@PE1# set routing-options forwarding-table export pplb
-
Configurez l’instance de routage VPN de couche 3.
[edit] user@PE1# set routing-instances VPN-l3vpn instance-type vrf
-
Assignez les interfaces à l’instance de routage.
[edit] user@PE1# set routing-instances VPN-l3vpn interface ge-0/0/0.0 user@PE1# set routing-instances VPN-l3vpn interface lo0.1
-
Configurez le distinguisher de route pour l’instance de routage.
[edit] user@PE1# set routing-instances VPN-l3vpn route-distinguisher 10.1.255.2:1
-
Configurez une cible VRF (VPN Routing and Forwarding) pour l’instance de routage.
[edit] user@PE1# set routing-instances VPN-l3vpn vrf-target target:65000:1
-
Configurez le protocole OSPF sous l’instance de routage et appliquez la stratégie configurée
bgp-to-ospfprécédemment.[edit] user@PE1# set routing-instances VPN-l3vpn protocols ospf area 0.0.0.0 interface ge-0/0/0.0 user@PE1# set routing-instances VPN-l3vpn protocols ospf area 0.0.0.0 interface lo0.1 passive user@PE1# set routing-instances VPN-l3vpn protocols ospf export bgp-to-ospf
Configuration du routeur P1
Procédure étape par étape
L’exemple suivant nécessite que vous naviguiez à différents niveaux dans la hiérarchie de configuration. Pour plus d’informations sur la navigation dans la CLI, consultez Utilisation de l’éditeur CLI en mode configuration dans le Guide de l’utilisateur de la CLI.
Pour configurer le routeur P1 :
Répétez cette procédure pour le routeur P2 après avoir modifié les noms d’interface, les adresses et d’autres paramètres appropriés.
-
Configurez les interfaces physiques.
[edit] user@P1# set interfaces ge-0/0/0 unit 0 family inet address 10.1.23.2/30 user@P1# set interfaces ge-0/0/0 unit 0 family mpls user@P1# set interfaces ge-0/0/2 unit 0 family inet address 10.1.34.1/30 user@P1# set interfaces ge-0/0/2 unit 0 family mpls
-
Configurez l’interface de bouclage.
[edit] user@P1# set interfaces lo0 unit 0 family inet address 10.1.255.3/32 primary
-
Configurez l’ID du routeur.
[edit] user@P1# set routing-options router-id 10.1.255.3
-
Configurez le protocole OSPF.
[edit] user@P1# set protocols ospf traffic-engineering user@P1# set protocols ospf area 0.0.0.0 interface lo0.0 passive user@P1# set protocols ospf area 0.0.0.0 interface ge-0/0/0.0 user@P1# set protocols ospf area 0.0.0.0 interface ge-0/0/2.0
-
Configurez le protocole RSVP.
[edit] user@P1# set protocols rsvp interface ge-0/0/0.0 user@P1# set protocols rsvp interface lo0.0 user@P1# set protocols rsvp interface ge-0/0/2.0
-
Configurez le protocole MPLS.
[edit] user@P1# set protocols mpls icmp-tunneling user@P1# set protocols mpls interface ge-0/0/0.0 user@P1# set protocols mpls interface lo0.0 user@P1# set protocols mpls interface ge-0/0/2.0
Configuration de l’ABR du routeur
Procédure étape par étape
L’exemple suivant nécessite que vous naviguiez à différents niveaux dans la hiérarchie de configuration. Pour plus d’informations sur la navigation dans la CLI, consultez Utilisation de l’éditeur CLI en mode configuration dans le Guide de l’utilisateur de la CLI.
Pour configurer le routeur ABR :
-
Configurez les interfaces physiques.
[edit] user@ABR# set interfaces ge-0/0/0 unit 0 family inet address 10.1.34.2/30 user@ABR# set interfaces ge-0/0/0 unit 0 family mpls user@ABR# set interfaces ge-0/0/2 unit 0 family inet address 10.1.45.1/30 user@ABR# set interfaces ge-0/0/2 unit 0 family mpls user@ABR# set interfaces ge-0/0/3 unit 0 family inet address 10.1.45.5/30 user@ABR# set interfaces ge-0/0/3 unit 0 family mpls
-
Configurez l’interface de bouclage.
[edit] user@ABR# set interfaces lo0 unit 0 family inet address 10.1.255.4/32 primary
-
Configurez les étiquettes MPLS que le routeur utilise pour hacher les paquets vers leur destination pour l’équilibrage de charge.
[edit] user@ABR# set forwarding-options hash-key family mpls label-1 user@ABR# set forwarding-options hash-key family mpls label-2 user@ABR# set forwarding-options hash-key family mpls label-3 user@ABR# set forwarding-options enhanced-hash-key family mpls no-payload
-
Configurez l’ID du routeur et le numéro du système autonome.
[edit] user@ABR# set routing-options router-id 10.1.255.4 user@ABR# set routing-options autonomous-system 65000
-
Configurez le protocole OSPF.
[edit] user@ABR# set protocols ospf traffic-engineering user@ABR# set protocols ospf area 0.0.0.0 interface lo0.0 passive user@ABR# set protocols ospf area 0.0.0.0 interface ge-0/0/0.0 user@ABR# set protocols ospf area 0.0.0.1 interface ge-0/0/2.0 user@ABR# set protocols ospf area 0.0.0.1 interface ge-0/0/3.0
-
Configurez le protocole RSVP.
[edit] user@ABR# set protocols rsvp interface lo0.0 user@ABR# set protocols rsvp interface ge-0/0/0.0 user@ABR# set protocols rsvp interface ge-0/0/2.0 user@ABR# set protocols rsvp interface ge-0/0/3.0
-
Configurez le protocole MPLS et spécifiez les LSP vers PE1 et PE2. Deux LSP sont créés vers PE2 dans le but d’équilibrer le trafic d’équilibrage de charge afin de montrer que différents LSP et interfaces sont utilisés.
[edit] user@ABR# set protocols mpls icmp-tunneling user@ABR# set protocols mpls label-switched-path abr-pe1 to 10.1.255.2 user@ABR# set protocols mpls label-switched-path abr-pe1 entropy-label user@ABR# set protocols mpls label-switched-path abr-pe2 to 10.1.255.6 user@ABR# set protocols mpls label-switched-path abr-pe2 entropy-label user@ABR# set protocols mpls label-switched-path abr-pe2 primary to-r6-1 user@ABR# set protocols mpls label-switched-path abr-pe2-2 to 10.1.255.6 user@ABR# set protocols mpls label-switched-path abr-pe2-2 entropy-label user@ABR# set protocols mpls label-switched-path abr-pe2-2 primary to-r6-2 user@ABR# set protocols mpls path to-r6-1 10.1.45.2 strict user@ABR# set protocols mpls path to-r6-1 10.1.56.2 strict user@ABR# set protocols mpls path to-r6-2 10.1.45.6 strict user@ABR# set protocols mpls path to-r6-2 10.1.56.6 strict user@ABR# set protocols mpls interface lo0.0 user@ABR# set protocols mpls interface ge-0/0/0.0 user@ABR# set protocols mpls interface ge-0/0/2.0 user@ABR# set protocols mpls interface ge-0/0/3.0
-
Configurez IBGP sur PE1 et PE2 à l’aide de
family inet labeled-unicast. Appliquez la stratégie pour annoncer la route de bouclage inet.3 à partir de PE1 et PE2. Nous affichons la stratégie à l’étape suivante.[edit] user@ABR# set protocols bgp group ibgp type internal user@ABR# set protocols bgp group ibgp local-address 10.1.255.4 user@ABR# set protocols bgp group ibgp family inet labeled-unicast rib inet.3 user@ABR# set protocols bgp group ibgp neighbor 10.1.255.2 export send-inet3-pe2 user@ABR# set protocols bgp group ibgp neighbor 10.1.255.6 export send-inet3-pe1
-
Définissez une stratégie à faire correspondre sur les adresses de bouclage pour PE1 et PE2.
[edit] user@ABR# set policy-options policy-statement send-inet3-pe1 from route-filter 10.1.255.2/32 exact user@ABR# set policy-options policy-statement send-inet3-pe1 then accept user@ABR# set policy-options policy-statement send-inet3-pe2 from route-filter 10.1.255.6/32 exact user@ABR# set policy-options policy-statement send-inet3-pe2 then accept
-
Définissez une stratégie d’équilibrage de charge et appliquez-la en vertu de la
routing-options forwarding-table.[edit] user@ABR# set policy-options policy-statement pplb then load-balance per-packet user@ABR# set routing-options forwarding-table export pplb
(Facultatif) Configuration de la mise en miroir des ports
Pour voir l’étiquette d’entropie qui est appliquée, vous pouvez capturer le trafic. Dans cet exemple, un filtre est appliqué sur l’interface PE1 de P1 pour capturer le trafic CE1 vers CE2. Le trafic est envoyé à l’hôte 1 pour consultation. Il existe différentes méthodes de capture du trafic que nous utilisons dans cet exemple. Pour plus d’informations, consultez Mise en miroir des ports et analyseurs.
Procédure étape par étape
L’exemple suivant nécessite que vous naviguiez à différents niveaux dans la hiérarchie de configuration. Pour plus d’informations sur la navigation dans la CLI, consultez Utilisation de l’éditeur CLI en mode configuration dans le Guide de l’utilisateur de la CLI.
Pour configurer le routeur P1 :
-
Configurez les interfaces. Dans cet exemple, nous plaçons l’interface connectée à Host1 dans un domaine de pont et créons une interface IRB pour vérifier la connectivité à Host1.
[edit] user@P1# set interfaces ge-0/0/4 unit 0 family bridge interface-mode access user@P1# set interfaces ge-0/0/4 unit 0 family bridge vlan-id 100 user@P1# set interfaces irb unit 0 family inet address 10.1.31.1/30
-
Configurez le domaine de pont.
[edit] user@P1# set bridge-domains v100 vlan-id 100 user@P1# set bridge-domains v100 routing-interface irb.0
-
Configurez un filtre pour capturer le trafic. Pour cet exemple, nous capturons l’ensemble du trafic.
[edit] user@P1# set firewall family any filter test term 1 then count test user@P1# set firewall family any filter test term 1 then port-mirror user@P1# set firewall family any filter test term 1 then accept
-
Appliquez le filtre à l’interface PE1.
[edit] user@P1# set interfaces ge-0/0/0 unit 0 filter input test
-
Configurez les options de mise en miroir des ports. Pour cet exemple, nous mettons en miroir tout le trafic et l’envoyons à l’hôte 1 connecté à l’interface ge-0/0/4.
[edit] user@P1# set forwarding-options port-mirroring input rate 1 user@P1# set forwarding-options port-mirroring family any output interface ge-0/0/4.0
Vérification
Vérifiez que la configuration fonctionne correctement.
- Vérification de l’annonce de la capacité d’étiquette Entropy
- Vérification de la réception de l’étiquette d’entropie pour le routeur PE1
- Vérification ECMP à l’ABR à PE2
- Afficher les itinéraires vers CE2 sur PE1
- Ping CE2 à partir de CE1
- Vérifier l’équilibrage de charge
- Vérifiez l’étiquette d’entropie
Vérification de l’annonce de la capacité d’étiquette Entropy
Objet
Vérifiez que l’attribut de chemin de capacité d’étiquette d’entropie est annoncé à partir de l’ABR vers PE1 pour la route vers PE2.
Mesures à prendre
À partir du mode opérationnel, exécutez la commande sur le show route advertising-protocol bgp 10.1.255.2 detail routeur ABR.
user@ABR> show route advertising-protocol bgp 10.1.255.2 detail
inet.3: 2 destinations, 2 routes (2 active, 0 holddown, 0 hidden)
* 10.1.255.6/32 (1 entry, 1 announced)
BGP group ibgp type Internal
Route Label: 299952
Nexthop: Self
Flags: Nexthop Change
MED: 2
Localpref: 4294967294
AS path: [65000] I
Entropy label capable
Signification
La sortie montre que l’hôte PE2 avec l’adresse IP 10.1.255.6 a la capacité d’étiquette d’entropie et l’étiquette de route utilisée. L’hôte annonce la capacité d’étiquette d’entropie à ses voisins BGP.
Vérification de la réception de l’étiquette d’entropie pour le routeur PE1
Objet
Vérifiez que le routeur PE1 reçoit l’annonce de l’étiquette d’entropie pour le routeur PE2.
Mesures à prendre
À partir du mode opérationnel, exécutez la commande sur le show route protocol bgp 10.1.255.6 extensive routeur PE1.
user@PE1> show route protocol bgp 10.1.255.6 extensive
inet.0: 19 destinations, 19 routes (19 active, 0 holddown, 0 hidden)
inet.3: 2 destinations, 2 routes (2 active, 0 holddown, 0 hidden)
10.1.255.6/32 (1 entry, 1 announced)
*BGP Preference: 170/1
Next hop type: Indirect, Next hop index: 0
Address: 0x7b3ffd4
Next-hop reference count: 2, key opaque handle: 0x0, non-key opaque handle: 0x0
Source: 10.1.255.4
Next hop type: Router, Next hop index: 0
Next hop: 10.1.23.2 via ge-0/0/2.0, selected
Label-switched-path pe1-abr
Label operation: Push 299952, Push 299808(top)
Label TTL action: prop-ttl, prop-ttl(top)
Load balance label: Label 299952: Entropy label; Label 299808: None;
Label element ptr: 0x93d6bf8
Label parent element ptr: 0x93d6c20
Label element references: 3
Label element child references: 2
Label element lsp id: 0
Session Id: 0
Protocol next hop: 10.1.255.4
Label operation: Push 299952
Label TTL action: prop-ttl
Load balance label: Label 299952: Entropy label;
Indirect next hop: 0x758c05c - INH Session ID: 0
State: <Active Int Ext>
Local AS: 65000 Peer AS: 65000
Age: 1:33:11 Metric: 2 Metric2: 2
Validation State: unverified
Task: BGP_65000.10.1.255.4
Announcement bits (2): 3-Resolve tree 1 4-Resolve_IGP_FRR task
AS path: I
Accepted
Route Label: 299952
Localpref: 4294967294
Router ID: 10.1.255.4
Session-IDs associated:
Session-id: 324 Version: 3
Thread: junos-main
Indirect next hops: 1
Protocol next hop: 10.1.255.4 Metric: 2 ResolvState: Resolved
Label operation: Push 299952
Label TTL action: prop-ttl
Load balance label: Label 299952: Entropy label;
Indirect next hop: 0x758c05c - INH Session ID: 0
Indirect path forwarding next hops: 1
Next hop type: Router
Next hop: 10.1.23.2 via ge-0/0/2.0
Session Id: 0
10.1.255.4/32 Originating RIB: inet.3
Metric: 2 Node path count: 1
Forwarding nexthops: 1
Next hop type: Router
Next hop: 10.1.23.2 via ge-0/0/2.0
Session Id: 0
Signification
Le routeur PE1 reçoit l’annonce de capacité d’étiquette d’entropie de son voisin BGP.
Vérification ECMP à l’ABR à PE2
Objet
Vérifiez le multichemin à coût égal (ECMP) par rapport au PE2.
Mesures à prendre
À partir du mode opérationnel, exécutez les commandes et show route forwarding-table label <label>sur le show route table mpls.0 routeur ABR.
user@ABR> show route table mpls.0
mpls.0: 6 destinations, 6 routes (6 active, 0 holddown, 0 hidden)
+ = Active Route, - = Last Active, * = Both
0 *[MPLS/0] 2w1d 23:02:11, metric 1
Receive
1 *[MPLS/0] 2w1d 23:02:11, metric 1
Receive
2 *[MPLS/0] 2w1d 23:02:11, metric 1
Receive
13 *[MPLS/0] 2w1d 23:02:11, metric 1
Receive
299936 *[VPN/170] 2d 21:47:02
> to 10.1.34.1 via ge-0/0/0.0, label-switched-path abr-pe1
299952 *[VPN/170] 2d 21:47:02
> to 10.1.45.2 via ge-0/0/2.0, label-switched-path abr-pe2
to 10.1.45.6 via ge-0/0/3.0, label-switched-path abr-pe2-2
ruser@ABR> show route forwarding-table label 299952
Routing table: default.mpls
MPLS:
Destination Type RtRef Next hop Type Index NhRef Netif
299952 user 0 ulst 1048575 2
10.1.45.2 Swap 299824 516 2 ge-0/0/2.0
10.1.45.6 Swap 299840 572 2 ge-0/0/3.0
...
Signification
La sortie affiche un ECMP pour l’étiquette utilisée pour la route unicast étiquetée BGP.
Afficher les itinéraires vers CE2 sur PE1
Objet
Vérifiez les routes vers CE2.
Mesures à prendre
À partir du mode opérationnel, exécutez les commandes et show route table VPN-l3vpn.inet.0 192.168.255.7 extensivesur le show route table VPN-l3vpn.inet.0 172.16.255.7 extensive routeur PE1.
user@PE1> show route table VPN-l3vpn.inet.0 172.16.255.7 extensive
VPN-l3vpn.inet.0: 10 destinations, 10 routes (10 active, 0 holddown, 0 hidden)
172.16.255.7/32 (1 entry, 1 announced)
TSI:
OSPF area : 0.0.0.0, LSA ID : 172.16.255.7, LSA type : Summary
KRT in-kernel 172.16.255.7/32 -> {indirect(1048574)}
*BGP Preference: 170/-101
Route Distinguisher: 10.1.255.6:1
Next hop type: Indirect, Next hop index: 0
Address: 0x7b40434
Next-hop reference count: 9, key opaque handle: 0x0, non-key opaque handle: 0x0
Source: 10.1.255.6
Next hop type: Router, Next hop index: 515
Next hop: 10.1.23.2 via ge-0/0/2.0, selected
Label-switched-path pe1-abr
Label operation: Push 299824, Push 299952, Push 299808(top)
Label TTL action: prop-ttl, prop-ttl, prop-ttl(top)
Load balance label: Label 299824: None; Label 299952: Entropy label; Label 299808: None;
Label element ptr: 0x93d6c98
Label parent element ptr: 0x93d6bf8
Label element references: 1
Label element child references: 0
Label element lsp id: 0
Session Id: 140
Protocol next hop: 10.1.255.6
Label operation: Push 299824
Label TTL action: prop-ttl
Load balance label: Label 299824: None;
...
user@PE1> show route table VPN-l3vpn.inet.0 192.168.255.7 extensive
VPN-l3vpn.inet.0: 10 destinations, 10 routes (10 active, 0 holddown, 0 hidden)
192.168.255.7/32 (1 entry, 1 announced)
TSI:
OSPF area : 0.0.0.0, LSA ID : 192.168.255.7, LSA type : Summary
KRT in-kernel 192.168.255.7/32 -> {indirect(1048574)}
*BGP Preference: 170/-101
Route Distinguisher: 10.1.255.6:1
Next hop type: Indirect, Next hop index: 0
Address: 0x7b40434
Next-hop reference count: 9, key opaque handle: 0x0, non-key opaque handle: 0x0
Source: 10.1.255.6
Next hop type: Router, Next hop index: 515
Next hop: 10.1.23.2 via ge-0/0/2.0, selected
Label-switched-path pe1-abr
Label operation: Push 299824, Push 299952, Push 299808(top)
Label TTL action: prop-ttl, prop-ttl, prop-ttl(top)
Load balance label: Label 299824: None; Label 299952: Entropy label; Label 299808: None;
Label element ptr: 0x93d6c98
Label parent element ptr: 0x93d6bf8
Label element references: 1
Label element child references: 0
Label element lsp id: 0
Session Id: 140
Protocol next hop: 10.1.255.6
Label operation: Push 299824
Label TTL action: prop-ttl
Load balance label: Label 299824: None;
...
Signification
La sortie montre que les mêmes étiquettes sont utilisées pour les deux itinéraires.
Ping CE2 à partir de CE1
Objet
Vérifiez la connectivité et à utiliser pour vérifier l’équilibrage de charge.
Mesures à prendre
À partir du mode opérationnel, exécutez les commandes et ping 192.168.255.7 source 192.168.255.1 rapid count 200sur le ping 172.16.255.7 source 172.16.12.1 rapid count 100 routeur PE1.
user@CE1> ping 172.16.255.7 source 172.16.12.1 rapid count 100 PING 172.16.255.7 (172.16.255.7): 56 data bytes !!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!! --- 172.16.255.7 ping statistics --- 100 packets transmitted, 100 packets received, 0% packet loss round-trip min/avg/max/stddev = 5.369/6.070/8.828/0.612 ms user@CE1> ping 192.168.255.7 source 192.168.255.1 rapid count 200 PING 192.168.255.7 (192.168.255.7): 56 data bytes !!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!! --- 192.168.255.7 ping statistics --- 200 packets transmitted, 200 packets received, 0% packet loss round-trip min/avg/max/stddev = 5.086/5.994/10.665/0.649 ms
Signification
La sortie indique que les pings sont réussis.
Vérifier l’équilibrage de charge
Objet
Vérifiez l’équilibrage de charge.
Mesures à prendre
En mode opérationnel, exécutez la show mpls lsp ingress statistics commande sur l’ABR.
user@ABR> show mpls lsp ingress statistics Ingress LSP: 3 sessions To From State Packets Bytes LSPname 10.1.255.2 10.1.255.4 Up 300 30000 abr-pe1 10.1.255.6 10.1.255.4 Up 200 20000 abr-pe2 10.1.255.6 10.1.255.4 Up 100 10000 abr-pe2-2 Total 3 displayed, Up 3, Down 0
Signification
La sortie affiche le premier ping de la commande précédente used LSP abr-pe2-2 et le second ping used LSP abr-pe2.
Vérifiez l’étiquette d’entropie
Objet
Vérifiez que l’étiquette d’entropie est différente entre les pings utilisés.
Mesures à prendre
Sur l’hôte 1, exécutez le tcpdump -i eth1 -nfichier .
user@Host1# tcpdump -i eth1 -n ... 13:42:31.993274 MPLS (label 299808, exp 0, ttl 63) (label 299952, exp 0, ttl 63) (label 7, exp 0, ttl 63) (label 1012776, exp 0, ttl 0) (label 299824, exp 0, [S], ttl 63) IP 172.16.12.1 > 172.16.255.7: ICMP echo request, id 32813, seq 9, length 64 ... 13:43:19.570260 MPLS (label 299808, exp 0, ttl 63) (label 299952, exp 0, ttl 63) (label 7, exp 0, ttl 63) (label 691092, exp 0, ttl 0) (label 299824, exp 0, [S], ttl 63) IP 192.168.255.1 > 192.168.255.7: ICMP echo request, id 46381, seq 9, length 64
Signification
La sortie affiche la valeur différente de l’étiquette d’entropie pour les deux commandes ping différentes.
Cas d’utilisation de la convergence indépendante du préfixe BGP pour Inet, inet6 ou unicast étiqueté
En cas de défaillance d’un routeur, la récupération d’un réseau BGP peut prendre de quelques secondes à quelques minutes, en fonction de paramètres tels que la taille du réseau ou les performances du routeur. Lorsque la fonctionnalité de convergence indépendante des préfixes (PIC) de BGP est activée sur un routeur, BGP installe sur le moteur de transfert de paquets le deuxième meilleur chemin en plus du meilleur chemin calculé vers une destination. Le routeur utilise ce chemin de secours lorsqu’un routeur de sortie tombe en panne dans un réseau et réduit considérablement le temps d’arrêt. Vous pouvez activer cette fonctionnalité pour réduire le temps d’arrêt du réseau en cas de défaillance du routeur de sortie.
Lorsque l’accessibilité à un routeur de sortie dans un réseau échoue, l’IGP détecte cette panne et l’état du lien propage cette information dans tout le réseau et annonce le saut suivant BGP pour ce préfixe comme inaccessible. Le BGP réévalue les chemins alternatifs et, si un chemin alternatif est disponible, réinstalle ce prochain saut alternatif dans le moteur de transfert de paquets. Ce type d’échec de sortie affecte généralement plusieurs préfixes en même temps, et BGP doit mettre à jour tous ces préfixes un par un. Sur les routeurs entrants, l’IGP effectue d’abord le chemin le plus court (SPF) et met à jour les sauts suivants. Junos OS détermine ensuite les préfixes devenus inaccessibles et signale au protocole qu’ils doivent être mis à jour. BGP reçoit la notification et met à jour le saut suivant pour chaque préfixe qui n’est plus valide. Ce processus pouvait avoir un impact sur la connectivité et la récupération de la panne pouvait prendre quelques minutes. Le PIC BGP peut réduire ce temps d’arrêt, car le chemin de sauvegarde est déjà installé dans le moteur de transfert de paquets.
À partir de la version 15.1 de Junos OS, la fonctionnalité PIC de BGP, qui était initialement prise en charge pour les routeurs VPN de couche 3, est étendue à BGP avec plusieurs routes dans les tables globales, telles que inet et inet6 unicast, et inet et inet6 étiquetés unicast. Sur un routeur compatible PIC BGP, Junos OS installe le chemin de secours pour le saut suivant indirect sur le moteur de routage et fournit également cette route vers le moteur de transfert de paquets et l’IGP. Lorsqu’un IGP perd l’accessibilité d’un préfixe avec une ou plusieurs routes, il signale au moteur de routage un seul message avant de mettre à jour les tables de routage. Le moteur de routage signale au moteur de transfert de paquets qu’un saut suivant indirect a échoué et que le trafic doit être réacheminé à l’aide du chemin de secours. Le routage vers le préfixe de destination affecté continue d’utiliser le chemin de sauvegarde avant même que BGP ne commence à recalculer les nouveaux sauts suivants pour les préfixes BGP. Le routeur utilise ce chemin de secours pour réduire la perte de trafic jusqu’à ce que la convergence globale via le BGP soit résolue.
Le moment où la panne se produit jusqu’à ce que la perte d’accessibilité soit signalée dépend en fait du temps de détection de défaillance du routeur le plus proche et du temps de convergence IGP. Une fois que le routeur local détecte la panne, la convergence des routes sans la fonctionnalité PIC BGP activée dépend fortement du nombre de préfixes affectés et des performances du routeur dues au recalcul de chaque préfixe affecté. Toutefois, lorsque la fonctionnalité PIC BGP est activée, avant même que BGP ne recalcule le meilleur chemin pour ces préfixes affectés, le moteur de routage signale au plan de données de basculer vers le meilleur chemin de secours. Par conséquent, la perte de trafic est minimale. Les nouvelles routes sont calculées pendant même que le trafic est transféré, et ces nouvelles routes sont poussées vers le plan de données. Par conséquent, le nombre de préfixes BGP affectés n’a pas d’impact sur le temps écoulé entre le moment où la panne de trafic se produit et le moment où BGP signale la perte d’accessibilité.
Voir aussi
Configuration de la convergence indépendante du préfixe BGP pour Inet
Sur un routeur compatible PIC (Prefix Independent Convergence) BGP, Junos OS installe le chemin de sauvegarde pour le saut suivant indirect sur le moteur de routage et fournit également cette route vers le moteur de transfert de paquets et l’IGP. Lorsqu’un IGP perd l’accessibilité d’un préfixe avec une ou plusieurs routes, il signale au moteur de routage un seul message avant de mettre à jour les tables de routage. Le moteur de routage signale au moteur de transfert de paquets qu’un saut suivant indirect a échoué et que le trafic doit être réacheminé à l’aide du chemin de secours. Le routage vers le préfixe de destination affecté continue d’utiliser le chemin de sauvegarde avant même que BGP ne commence à recalculer les nouveaux sauts suivants pour les préfixes BGP. Le routeur utilise ce chemin de secours pour réduire la perte de trafic jusqu’à ce que la convergence globale via le BGP soit résolue. La fonctionnalité PIC de BGP, qui était initialement prise en charge pour les routeurs VPN de couche 3, est étendue à BGP avec plusieurs routes dans les tables globales, telles que inet et inet6 unicast, et inet et inet6 étiquetés unicast.
Avant de commencer :
Configurez les interfaces des appareils.
Configurez OSPF ou tout autre protocole IGP.
Configurez MPLS et LDP.
Configurez BGP.
La fonctionnalité PIC BGP n’est prise en charge que sur les routeurs dotés d’interfaces MPC.
Sur les routeurs équipés de concentrateurs de ports modulaires (MPC), activez des services de réseau IP améliorés, comme indiqué ici :
[edit chassis network-services] user@host# set enhanced-ip
Pour configurer le PIC BGP pour inet :
Voir aussi
Exemple : Configuration de la convergence indépendante du préfixe BGP pour Inet
Cet exemple montre comment configurer le PIC BGP pour inet. En cas de défaillance d’un routeur, la récupération d’un réseau BGP peut prendre de quelques secondes à quelques minutes, en fonction de paramètres tels que la taille du réseau ou les performances du routeur. Lorsque la fonctionnalité de convergence indépendante des préfixes BGP (PIC) est activée sur un routeur, BGP avec plusieurs routes dans les tables globales, telles que inet et inet6 unicast, et inet et inet6 étiquetées unicast, installe sur le moteur de transfert de paquets le deuxième meilleur chemin en plus du meilleur chemin calculé vers une destination. Le routeur utilise ce chemin de secours lorsqu’un routeur de sortie tombe en panne dans un réseau et réduit considérablement le temps d’arrêt.
Exigences
Aucune configuration spéciale au-delà de l’initialisation de l’appareil n’est requise avant de configurer cet exemple.
Cet exemple utilise les composants matériels et logiciels suivants :
-
Un routeur MX Series avec MPC pour configurer la fonctionnalité PIC BGP
-
Sept routeurs pouvant être une combinaison de routeurs M Series, MX Series, T Series ou PTX Series
-
Junos OS version 15.1 ou ultérieure sur l’équipement avec le PIC BGP configuré
Vue d’ensemble
À partir de Junos OS version 15.1, BGP PIC, qui était initialement pris en charge pour les routeurs VPN de couche 3, est étendu à BGP avec plusieurs routes dans les tables globales, telles que inet et inet6 unicast, et inet et inet6 étiquetés unicast. BGP installe sur le moteur de transfert de paquets le deuxième meilleur chemin en plus du meilleur chemin calculé vers une destination. Lorsqu’un IGP perd l’accessibilité au profit d’un préfixe, le routeur utilise ce chemin de secours pour réduire la perte de trafic jusqu’à ce que la convergence globale via le BGP soit résolue, réduisant ainsi la durée de la panne.
La fonctionnalité PIC BGP n’est prise en charge que sur les routeurs équipés de MPC.
Topologie
Cet exemple montre trois routeurs de périphérie client (CE), Device CE0, CE1 et CE2. Les routeurs PE0, PE1 et PE2 sont les routeurs de périphérie des fournisseurs (PE). Les routeurs P0 et P1 sont les routeurs centraux du fournisseur. Le PIC BGP est configuré sur le routeur PE0. Pour le test, l’adresse 192.168.1.5 est ajoutée en tant que deuxième adresse d’interface de bouclage sur le périphérique CE1. L’adresse est annoncée aux routeurs PE1 et PE2 et est relayée par le BGP interne (IBGP) au routeur PE0. Sur le routeur PE0, il existe deux chemins vers le réseau 192.168.1.5. Il s’agit du chemin principal et d’un chemin de secours. La figure 13 montre le réseau exemple.
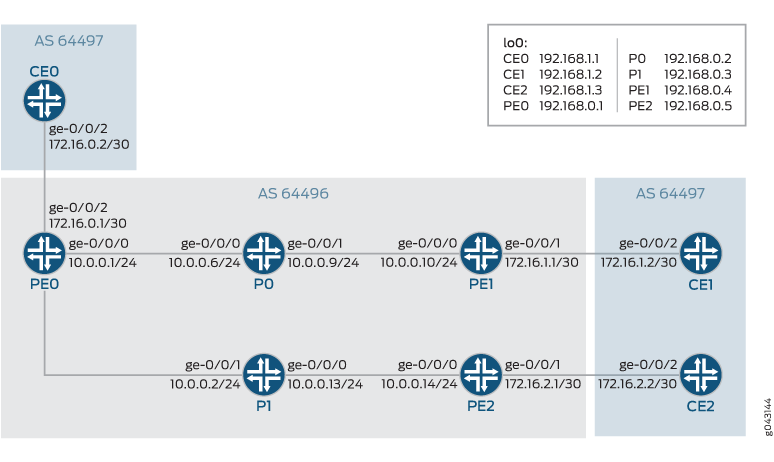
La configuration
Configuration rapide de la CLI
Pour configurer rapidement cet exemple, copiez les commandes suivantes, collez-les dans un fichier texte, supprimez les sauts de ligne, modifiez tous les détails nécessaires pour qu’ils correspondent à votre configuration réseau, copiez et collez les commandes dans la CLI au niveau de la [edit] hiérarchie, puis entrez Valider à partir du mode de configuration.
Routeur PE0
set chassis network-services enhanced-ip set interfaces ge-0/0/0 unit 0 description PE0->P0 set interfaces ge-0/0/0 unit 0 family inet address 10.0.0.5/24 set interfaces ge-0/0/0 unit 0 family iso set interfaces ge-0/0/0 unit 0 family inet6 address 2001:db8::1/32 set interfaces ge-0/0/0 unit 0 family mpls set interfaces ge-0/0/1 unit 0 description PE0->P1 set interfaces ge-0/0/1 unit 0 family inet address 10.0.0.1/24 set interfaces ge-0/0/1 unit 0 family iso set interfaces ge-0/0/1 unit 0 family inet6 address 2001:db8::2/32 set interfaces ge-0/0/1 unit 0 family mpls set interfaces lo0 unit 0 family inet address 192.168.0.1/32 set interfaces ge-0/0/2 unit 0 description PE0->CE0 set interfaces ge-0/0/2 unit 0 family inet address 172.16.0.1/30 set interfaces ge-0/0/2 unit 0 family inet6 address 2001:db8::10/32 set interfaces ge-0/0/2 unit 0 family mpls set protocols mpls ipv6-tunneling set protocols mpls interface all set protocols mpls interface fxp0.0 disable set protocols bgp group ibgp type internal set protocols bgp group ibgp local-address 192.168.0.1 set protocols bgp group ibgp family inet labeled-unicast per-prefix-label set protocols bgp group ibgp family inet6 labeled-unicast explicit-null set protocols bgp group ibgp export nhself set protocols bgp group ibgp neighbor 192.168.0.4 description PE1 set protocols bgp group ibgp neighbor 192.168.0.5 description PE2 set protocols bgp group ebgp type external set protocols bgp group ebgp local address 192.168.0.1 set protocols bgp group ebgp family inet labeled-unicast set protocols bgp group ebgp family inet6 labeled-unicast set protocols bgp group ebgp peer-as 64497 set protocols bgp group ebgp neighbor 172.16.0.2 description CE0 set protocols ospf area 0.0.0.0 interface all set protocols ospf area 0.0.0.0 interface fxp0.0 disable set protocols ospf area 0.0.0.0 interface lo0.0 passive set protocols ospf area 0.0.0.0 interface ge-0/0/1.0 metric 1000 set protocols ospf3 area 0.0.0.0 interface all set protocols ospf3 area 0.0.0.0 interface fxp0.0 disable set protocols ospf3 area 0.0.0.0 interface lo0.0 passive set protocols ospf3 area 0.0.0.0 interface ge-0/0/1.0 metric 1000 set protocols ldp track-igp-metric set protocols ldp interface all set protocols ldp interface fxp0.0 disable set policy-options policy-statement lb then load-balance per-packet set policy-options policy-statement nhself then next-hop self set routing-options protect core set routing-options forwarding-table export lb set routing-options router-id 192.168.0.1 set routing-options autonomous-system 64496
Routeur P0
set chassis network-services enhanced-ip set interfaces ge-0/0/0 unit 0 description P0->PE0 set interfaces ge-0/0/0 unit 0 family inet address 10.0.0.6/24 set interfaces ge-0/0/0 unit 0 family inet6 address 2001:db8::3/32 set interfaces ge-0/0/0 unit 0 family mpls set interfaces ge-0/0/1 unit 0 description P0->PE1 set interfaces ge-0/0/1 unit 0 family inet address 10.0.0.9/24 set interfaces ge-0/0/1 unit 0 family inet6 address 2001:db8::4/32 set interfaces ge-0/0/1 unit 0 family mpls set interfaces lo0 unit 0 family inet address 192.168.0.2/32 set protocols ospf area 0.0.0.0 interface all set protocols ospf area 0.0.0.0 interface fxp0.0 disable set protocols ospf area 0.0.0.0 interface lo0.0 passive set protocols bgp group ibgp type internal set protocols bgp group ibgp local address 192.168.0.1 set protocols bgp group ibgp neighbor 192.168.0.4 description PE1 set protocols bgp group ibgp neighbor 192.168.0.5 description PE2 set routing-options router-id 192.168.0.2 set routing-options autonomous-system 64496
Routeur P1
set chassis network-services enhanced-ip set interfaces ge-0/0/1 unit 0 description P1->PE0 set interfaces ge-0/0/1 unit 0 family inet address 10.0.0.2/24 set interfaces ge-0/0/1 unit 0 family inet6 address 2001:db8::5/32 set interfaces ge-0/0/1 unit 0 family mpls set interfaces ge-0/0/0 unit 0 description P1->PE2 set interfaces ge-0/0/0 unit 0 family inet address 10.0.0.13/24 set interfaces ge-0/0/0 unit 0 family inet6 address 2001:db8::6/32 set interfaces ge-0/0/0 unit 0 family mpls set interfaces lo0 unit 0 family inet address 192.168.0.3/32 set protocols ospf area 0.0.0.0 interface all set protocols ospf area 0.0.0.0 interface fxp0.0 disable set protocols ospf area 0.0.0.0 interface lo0.0 passive set protocols bgp group ibgp type internal set protocols bgp group ibgp local address 192.168.0.3 set protocols bgp group ibgp neighbor 192.168.0.1 description PE0 set protocols bgp group ibgp neighbor 192.168.0.5 description PE2 set routing-options router-id 192.168.0.3 set routing-options autonomous-system 64496
Routeur PE1
set chassis network-services enhanced-ip set interfaces ge-0/0/0 unit 0 description PE1->P0 set interfaces ge-0/0/0 unit 0 family inet address 10.0.0.10/24 set interfaces ge-0/0/0 unit 0 family inet6 address 2001:db8::7/32 set interfaces ge-0/0/0 unit 0 family mpls set interfaces ge-0/0/0 unit 0 family iso set interfaces ge-0/0/1 unit 0 description PE1->CE1 set interfaces ge-0/0/1 unit 0 family inet address 172.16.1.1/30 set interfaces ge-0/0/1 unit 0 family inet6 address 2001:db8::12/32 set interfaces ge-0/0/1 unit 0 family mpls set interfaces lo0 unit 0 family inet address 192.168.0.4/32 set protocols bgp group ibgp type internal set protocols bgp group ibgp local address 192.168.0.4 set protocols bgp group ibgp family inet labeled-unicast per-prefix-label set protocols bgp group ibgp family inet6 labeled-unicast explicit-null set protocols bgp group ibgp export nhself set protocols bgp group ibgp neighbor 192.168.0.1 description PE0 set protocols bgp group ibgp neighbor 192.168.0.5 description PE2 set protocols bgp group ebgp type external set protocols bgp group ebgp local address 192.168.0.4 set protocols bgp group ebgp peer-as 64497 set protocols bgp group ebgp neighbor 172.16.1.2 description CE1 set protocols ospf area 0.0.0.0 interface all set protocols ospf area 0.0.0.0 interface fxp0.0 disable set protocols ospf area 0.0.0.0 interface lo0.0 passive set protocols ospf area 0.0.0.0 interface ge-0/0/1.0 metric 1000 set protocols ospf3 area 0.0.0.0 interface all set protocols ospf3 area 0.0.0.0 interface fxp0.0 disable set protocols ospf3 area 0.0.0.0 interface lo0.0 passive set protocols ospf3 area 0.0.0.0 interface ge-0/0/0.0 metric 1000 set protocols ldp track-igp-metric set protocols ldp interface all set protocols ldp interface fxp0.0 disable set policy-options policy-statement PE1-v6-nh_CE1 from family inet6 set policy-options policy-statement PE1-v6-nh_CE1 then next-hop 2001:DB8::13 set policy-options policy-statement nhself then next-hop self set routing-options router-id 192.168.0.4 set routing-options autonomous-system 64496 set routing-options static route 192.168.1.2 next-hop 172.16.1.2
Routeur PE2
set chassis network-services enhanced-ip set interfaces ge-0/0/0 unit 0 description PE2->P1 set interfaces ge-0/0/0 unit 0 family inet address 10.0.0.14/24 set interfaces ge-0/0/0 unit 0 family inet6 address 2001:db8::8/32 set interfaces ge-0/0/0 unit 0 family mpls set interfaces ge-0/0/0 unit 0 family iso set interfaces ge-0/0/1 unit 0 description PE2->CE2 set interfaces ge-0/0/1 unit 0 family inet address 172.16.2.1/30 set interfaces ge-0/0/1 unit 0 family inet6 address 2001:db8::14/32 set interfaces ge-0/0/1 unit 0 family mpls set interfaces lo0 unit 0 family inet address 192.168.0.5/32 set protocols mpls ipv6-tunneling set protocols mpls interface all set protocols mpls interface fxp0.0 disable set protocols bgp group ibgp type internal set protocols bgp group ibgp local address 192.168.0.5 set protocols bgp group ibgp family inet labeled-unicast per-prefix-label set protocols bgp group ibgp family inet6 labeled-unicast explicit-null set protocols bgp group ibgp export nhself set protocols bgp group ibgp neighbor 192.168.0.4 description PE1 set protocols bgp group ibgp neighbor 192.168.0.1 description PE0 set protocols bgp group ebgp type external set protocols bgp group ebgp local address 192.168.0.5 set protocols bgp group ebgp peer-as 64497 set protocols bgp group ebgp family inet labeled-unicast set protocols bgp group ebgp family inet6 labeled-unicast set protocols bgp group ebgp neighbor 172.16.2.2 description CE2 set protocols ospf area 0.0.0.0 interface all set protocols ospf area 0.0.0.0 interface fxp0.0 disable set protocols ospf area 0.0.0.0 interface lo0.0 passive set protocols ospf area 0.0.0.0 interface ge-0/0/1.0 metric 1000 set protocols ospf3 area 0.0.0.0 interface all set protocols ospf3 area 0.0.0.0 interface fxp0.0 disable set protocols ospf3 area 0.0.0.0 interface lo0.0 passive set protocols ospf3 area 0.0.0.0 interface ge-0/0/0.0 metric 1000 set protocols ldp track-igp-metric set protocols ldp interface all set protocols ldp interface fxp0.0 disable set policy-options policy-statement nhself then next-hop self set routing-options router-id 192.168.0.5 set routing-options autonomous-system 64496 set routing-options static route 192.168.1.3 next-hop 172.16.2.2
Appareil CE0
set chassis network-services enhanced-ip set interfaces ge-0/0/2 unit 0 description CE0->PE0 set interfaces ge-0/0/2 unit 0 family inet address 172.16.0.2/30 set interfaces ge-0/0/2 unit 0 family inet6 address 2001:db8::11/32 set interfaces lo0 unit 0 family inet address 192.168.1.1/32 set protocols mpls interface all set protocols bgp group ebgp type external set protocols bgp group ebgp peer-as 64496 set protocols bgp group ebgp family inet labeled-unicast set protocols bgp group ebgp family inet6 labeled-unicast set protocols bgp group ebgp neighbor 172.16.0.1 description PE0 set protocols bgp group ebgp local-address 192.168.1.1 set routing-options autonomous-system 64497 set routing-options router-id 192.168.1.1
Appareil CE1
set chassis network-services enhanced-ip set interfaces ge-0/0/2 unit 0 description CE1->PE1 set interfaces ge-0/0/2 unit 0 family inet address 172.16.1.2/30 set interfaces ge-0/0/2 unit 0 family inet6 address 2001:db8::13/32 set interfaces ge-0/0/2 unit 0 family mpls set interfaces lo0 unit 0 family inet address 192.168.1.2/32 set interfaces lo0 unit 0 family inet address 192.168.1.5/24 set protocols mpls interface all set protocols bgp group ebgp type external set protocols bgp group ebgp peer-as 64496 set protocols bgp group ebgp family inet labeled-unicast set protocols bgp group ebgp family inet6 labeled-unicast set protocols bgp group ebgp export send-direct set protocols bgp group ebgp neighbor 172.16.1.1 description PE1 set policy-options policy statement send-direct from protocol direct then accept set routing-options autonomous-system 64497 set routing-options router-id 192.168.1.2
Appareil CE2
set chassis network-services enhanced-ip set interfaces ge-0/0/2 unit 0 description CE2->PE2 set interfaces ge-0/0/2 unit 0 family inet address 172.16.2.2/30 set interfaces ge-0/0/2 unit 0 family inet6 address 2001:db8::15/32 set interfaces ge-0/0/2 unit 0 family mpls set interfaces lo0 unit 0 family inet address 192.168.1.3/32 set protocols mpls interface all set protocols bgp group ebgp type external set protocols bgp group ebgp peer-as 64496 set protocols bgp group ebgp family inet labeled-unicast set protocols bgp group ebgp family inet6 labeled-unicast set protocols bgp group ebgp export send-direct set protocols bgp group ebgp neighbor 172.16.2.1 description PE2 set policy-options policy statement send-direct from protocol direct then accept set routing-options autonomous-system 64497 set routing-options router-id 192.168.1.3
Configuration de l’équipement PE0
Procédure étape par étape
L’exemple suivant nécessite que vous naviguiez à différents niveaux dans la hiérarchie de configuration. Pour plus d’informations sur la navigation dans la CLI, reportez-vous à la section Utilisation de l’éditeur CLI en mode configuration dans le Guide de l’utilisateur de la CLI de Junos OS.
Pour configurer l’équipement PE0 :
-
Sur les routeurs équipés de concentrateurs de ports modulaires (MPC), améliorez les services de réseau IP.
[edit chassis] usr@PE0# set network-services enhanced-ip -
Configurez les interfaces des appareils.
[edit interfaces] user@PE0# set ge-0/0/0 unit 0 description PE0->P0 user@PE0# set ge-0/0/0 unit 0 family inet address 10.0.0.5/24 user@PE0# set ge-0/0/0 unit 0 family iso user@PE0# set ge-0/0/0 unit 0 family inet6 address 2001:db8::1/32 user@PE0# set ge-0/0/0 unit 0 family mpls user@PE0# set ge-0/0/1 unit 0 description PE0->P1 user@PE0# set ge-0/0/1 unit 0 family inet address 10.0.0.1/24 user@PE0# set ge-0/0/1 unit 0 family iso user@PE0# set ge-0/0/1 unit 0 family inet6 address 2001:db8::2/32 user@PE0# set ge-0/0/1 unit 0 family mpls user@PE0# set ge-0/0/2 unit 0 description PE0->CE0 user@PE0# set ge-0/0/2 unit 0 family inet address 172.16.0.1/30 user@PE0# set ge-0/0/2 unit 0 family inet6 address 2001:db8::10/32 user@PE0# set ge-0/0/2 unit 0 family mpls
-
Configurez l’interface de bouclage.
[edit interfaces] user@PE0# set lo0 unit 0 family inet address 192.168.0.1/32
-
Configurez MPLS et LDP sur toutes les interfaces, à l’exception de l’interface de gestion.
[edit protocols] user@PE0# set mpls ipv6-tunneling user@PE0# set mpls interface all user@PE0# set mpls interface fxp0.0 disable user@PE0# set ldp track-igp-metric user@PE0# set ldp interface all user@PE0# set ldp interface fxp0.0 disable
-
Configurez un IGP sur les interfaces centrales.
[edit protocols] user@PE0# set ospf area 0.0.0.0 interface all user@PE0# set ospf area 0.0.0.0 interface fxp0.0 disable user@PE0# set ospf area 0.0.0.0 interface lo0.0 passive user@PE0# set ospf area 0.0.0.0 interface ge-0/0/1.0 metric 1000 user@PE0# set ospf3 area 0.0.0.0 interface all user@PE0# set ospf3 area 0.0.0.0 interface fxp0.0 disable user@PE0# set ospf3 area 0.0.0.0 interface lo0.0 passive user@PE0# set ospf3 area 0.0.0.0 interface ge-0/0/1.0 metric 1000
-
Configurez les connexions IBGP avec les autres équipements PE.
[edit protocols] user@PE0# set bgp group ibgp type internal user@PE0# set bgp group ibgp local-address 192.168.0.1 user@PE0# set bgp group ibgp family inet labeled-unicast per-prefix-label user@PE0# set bgp group ibgp family inet6 labeled-unicast explicit-null user@PE0# set bgp group ibgp export nhself user@PE0# set bgp group ibgp neighbor 192.168.0.4 description PE1 user@PE0# set bgp group ibgp neighbor 192.168.0.5 description PE2
-
Configurez les connexions EBGP avec les appareils du client.
[edit protocols] user@PE0# set bgp group ebgp type external user@PE0# set bgp group ebgp local address 192.168.0.1 user@PE0# set bgp group ebgp family inet labeled-unicast user@PE0# set bgp group ebgp family inet6 labeled-unicast user@PE0# set bgp group ebgp peer-as 64497 user@PE0# set bgp group ebgp neighbor 172.16.0.2 description CE0
-
Configurez la stratégie d’équilibrage de charge.
[edit policy-options] user@PE0# set policy-statement lb then load-balance per-packet
-
Configurez une auto-stratégie de saut suivant.
[edit policy-options] user@PE0# set policy-statement nhself then next-hop self
-
Activez la fonctionnalité de périphérie du PIC BGP.
[edit routing-options] user@PE0# set protect core
-
Appliquez la politique d’équilibrage de charge.
[edit routing-options] user@PE0# set forwarding-table export lb
-
Attribuez l’ID du routeur et le numéro du système autonome (AS).
[edit routing-options] user@PE0# set router-id 192.168.0.2 user@PE0# set autonomous-system 64496
Résultats
En mode configuration, confirmez votre configuration en entrant les show chassiscommandes , , show policy-optionsshow interfacesshow protocols, , et .show routing-options Si la sortie n’affiche pas la configuration prévue, répétez les instructions de cet exemple pour corriger la configuration.
[edit] user@PE0# show chassis network-services enhanced-ip;
[edit]
user@PE0# show interfaces
ge-0/0/0 {
unit 0 {
description PE0->P0;
family inet {
address 10.0.0.5/24;
}
family iso;
family inet6 {
address 2001:db8::1/32;
}
family mpls;
}
}
ge-0/0/1 {
unit 0 {
description PE0->P1;
family inet {
address 10.0.0.1/24;
}
family iso;
family inet6 {
address 2001:db8::2/32;
}
family mpls;
}
}
ge-0/0/2 {
unit 0 {
description PE0->CE0;
family inet {
address 172.16.0.1/30;
}
family inet6 {
address 2001:db8::10/32;
}
family mpls;
}
}
lo0 {
unit 0 {
family inet {
address 192.168.0.1/32;
}
}
}
[edit]
user@PE0# show protocols
mpls {
ipv6-tunneling;
interface all;
interface fxp0.0 {
disable;
}
}
bgp {
group ibgp {
type internal;
local-address 192.168.0.1;
family inet {
labeled-unicast {
per-prefix-label;
}
}
family inet6 {
labeled-unicast {
explicit-null;
}
}
export nhself;
neighbor 192.168.0.4 {
description PE1;
}
neighbor 192.168.0.5 {
description PE2;
}
}
group ebgp {
type external;
local-address 192.168.0.1;
family inet {
labeled-unicast;
}
family inet6 {
labeled-unicast;
}
peer-as 64497;
neighbor 172.16.0.2 {
description CE0;
}
}
}
ospf {
area 0.0.0.0 {
interface all;
interface lo0.0 {
passive;
}
interface ge-0/0/1.0 {
metric 1000;
}
interface fxp0.0 {
disable;
}
}
}
ospf3 {
area 0.0.0.0 {
interface all;
interface lo0.0 {
passive;
}
interface ge-0/0/1.0 {
metric 1000;
}
interface fxp0.0 {
disable;
}
}
}
ldp {
track-igp-metric;
interface all;
interface fxp0.0 {
disable;
}
}
[edit]
user@PE1# show policy-options
policy-statement lb {
then {
load-balance per-packet;
}
}
policy-statement nhself {
then {
next-hop self;
}
}
[edit]
user@PE0# show routing-options
protect core;
router-id 192.168.0.1;
autonomous system 64496
forwarding-table {
export lb;
}
Vérification
Vérifiez que la configuration fonctionne correctement.
Affichage d’informations détaillées sur l’itinéraire
Objet
Vérifiez que le périphérique PIC BGP fonctionne.
Mesures à prendre
À partir de l’appareil PE0, exécutez la show route extensive commande.
user@PE0>
show route 192.168.1.5 extensive
inet.0: 236941 destinations, 630411 routes (236940 active, 0 holddown, 1 hidden)
20.1.1.1/32 (3 entries, 2 announced)
State: <CalcForwarding>
TSI:
KRT in-kernel 192.168.1.5/24 -> {indirect(1048574), indirect(1048575)}
@BGP Preference: 170/-101
Next hop type: Indirect, Next hop index: 0
Address: 0xafd09d0
Next-hop reference count: 236886
Source: 192.168.0.4
Next hop type: Router, Next hop index: 623
Next hop: 10.0.0.2 via ge-0/0/1.0, selected
Session Id: 0x140
Protocol next hop: 192.168.0.4
Indirect next hop: 0xab3b980 1048574 INH Session ID: 0x144
State: <Active Int Ext ProtectionPath ProtectionCand>
Local AS: 64496 Peer AS: 64496
Age: 1:11 Metric2: 2
Validation State: unverified
Task: BGP_100.192.168.0.5
Announcement bits (1): 6-Resolve tree 2
AS path: 64497 I
Accepted MultipathUnequal
Localpref: 100
Router ID: 192.168.0.5
Indirect next hops: 1
Protocol next hop: 192.168.0.5 Metric: 2
Indirect next hop: 0xab3b980 1048574 INH Session ID: 0x144
Indirect path forwarding next hops: 1
Next hop type: Router
Next hop: 10.0.0.2 via ge-0/0/1.0
Session Id: 0x140
192.168.0.5/32 Originating RIB: inet.0
Metric: 2 Node path count: 1
Forwarding nexthops: 1
Nexthop: 10.0.0.2 via ge-0/0/1.0
BGP Preference: 170/-101
Next hop type: Indirect, Next hop index: 0
Address: 0xafd0970
Next-hop reference count: 196735
Source: 192.168.0.4
Next hop type: Router, Next hop index: 624
Next hop: 10.0.0.6 via ge-0/0/0.0, selected
Session Id: 0x141
Protocol next hop: 192.168.0.4
Indirect next hop: 0xab3c240 1048575 INH Session ID: 0x145
State: <NotBest Int Ext ProtectionCand>
Inactive reason: Not Best in its group - IGP metric
Local AS: 100 Peer AS: 100
Age: 1:05 Metric2: 1001
Validation State: unverified
Task: BGP_100.192.168.0.4
AS path: 200 400 I
Accepted
Localpref: 100
Router ID: 192.168.0.4
Indirect next hops: 1
Protocol next hop: 192.168.0.4 Metric: 1001
Indirect next hop: 0xab3c240 1048575 INH Session ID: 0x145
Indirect path forwarding next hops: 1
Next hop type: Router
Next hop: 10.0.0.6 via ge-0/0/0.0
Session Id: 0x141
192.168.0.4/32 Originating RIB: inet.0
Metric: 1001 Node path count: 1
Forwarding nexthops: 1
Nexthop: 10.0.0.6 via ge-0/0/0.0
#Multipath Preference: 255
Next hop type: Indirect, Next hop index: 0
Address: 0xd330f90
Next-hop reference count: 304062
Next hop type: Router, Next hop index: 623
Next hop: 10.0.0.6 via ge-0/0/0.0, selected
Session Id: 0x140
Next hop type: Router, Next hop index: 624
Next hop: 10.0.0.2 via ge-0/0/1.0
Session Id: 0x141
Protocol next hop: 192.168.0.4
Indirect next hop: 0xab3b980 1048574 INH Session ID: 0x144 Weight 0x1
Protocol next hop: 192.168.0.5
Indirect next hop: 0xab3c240 1048575 INH Session ID: 0x145 Weight 0x4000
State: <ForwardinOnly Int Ext>
Inactive reason: Forwarding use only
Local AS: 64496
Age: 1:05 Metric2: 2
Validation State: unverified
Task: RT
Announcement bits (1): 0-KRT
AS path: 64497 I
Signification
Junos OS utilise les sauts suivants et les weight valeurs pour sélectionner un chemin de secours en cas de défaillance d’une liaison. La pondération du saut suivant a l’une des valeurs suivantes :
-
0x1 indique le chemin principal avec les sauts suivants actifs.
-
0x4000 indique le chemin de secours avec les sauts suivants passifs.
Affichage de la table de transfert
Objet
Vérifiez l’état de la table de transfert et de routage du noyau à l’aide de la show route forwarding-table commande.
Mesures à prendre
À partir de l’appareil PE0, exécutez la show route forwarding-table destination 192.168.1.5 extensive commande.
user@PE0>
show route forwarding-table destination 192.168.1.5 extensive
Routing table: default.inet [Index 0]
Internet:
Destination: 192.168.1.5/24
Route type: user
Route reference: 0 Route interface-index: 0
Multicast RPF nh index: 0
Flags: sent to PFE
Next-hop type: unilist Index: 1048576 Reference: 7401
Next-hop type: indirect Index: 1048574 Reference: 2 Weight: 0x1
Nexthop: 10.0.0.6
Next-hop type: unicast Index: 623 Reference: 8
Next-hop interface: ge-0/0/0.0 Weight: 0x1
Next-hop type: indirect Index: 1048575 Reference: 2 Weight: 0x4000
Nexthop: 10.0.0.2
Next-hop type: unicast Index: 624 Reference: 8
Next-hop interface: ge-0/0/1.0 Weight: 0x4000
Signification
Junos OS utilise les sauts suivants et les weight valeurs pour sélectionner un chemin de secours en cas de défaillance d’une liaison. La pondération du saut suivant a l’une des valeurs suivantes :
-
0x1 indique le chemin principal avec les sauts suivants actifs.
-
0x4000 indique le chemin de secours avec les sauts suivants passifs.
Présentation de la hiérarchie Conserver le saut suivant
Dans la hiérarchie compressée traditionnelle, les étiquettes de service sont fusionnées en un seul transport nexthops (FNH), ce qui peut entraîner une explosion du nexthop dans le PFE. La hiérarchie compressée traditionnelle peut également causer des problèmes tels que la troncature ECMP et la perte de poids hiérarchiques.
Conserver la hiérarchie du saut suivant (également appelée hiérarchie étendue) conserve chaque étiquette de service dans son propre composite de chaîne, préservant la hiérarchie d’origine au lieu de tout fusionner dans une seule structure de saut suivant.
- Avantages de la préservation de la hiérarchie du saut suivant
- Configurer Conserver la hiérarchie du saut suivant
Avantages de la préservation de la hiérarchie du saut suivant
Cette fonctionnalité offre les avantages suivants :
- Réduction des ressources Nexthop de transfert : Fournit une réduction significative du nombre de ressources/nombre de transferts Nexthop.
- PIC BGP à tous les niveaux : prend en charge le PIC BGP à tous les niveaux hiérarchiques (transport, service, chaînes composites), garantissant un basculement rapide et une convergence locale pour les chemins BGP.
- Conservation des pondérations hiérarchiques : maintient la distribution des pondérations et de la bande passante pour les scénarios ECMP et de routage hiérarchique.
- Éviter la troncature ECMP : garantit que tous les pieds ECMP sont installés en PFE, améliorant ainsi l’équilibrage de charge et la résilience.
Services tels que les services de couche 2 (circuit de couche 2, VPN de couche 2), VPN de couche 3 (IPv4 et IPv6), VPLS, tunnels IPIP, services Internet (IPv4, IPv6, 6PE), prise en charge d’EVPN et de PRPD Préserver la hiérarchie du saut suivant.
Prise en charge de protocoles de transport tels que l’unicast étiqueté BGP, le transport avec classe BGP (BGP-CT), RSVP-TE, SR-MPLS, SR-FlexAlgo, SR-TE, SRv6 TE, MPLS-over-UDP Préservez la hiérarchie du saut suivant avec l’infrastructure de classe transport.
Voir l’outil Explorateur d’entités pour obtenir la liste des plates-formes qui prennent en charge la conservation de la hiérarchie du saut suivant.
Configurer Conserver la hiérarchie du saut suivant
Pour configurer la fonctionnalité Conserver la hiérarchie du saut suivant, incluez l’instruction preserve-nexthop-hierarchy au niveau de la hiérarchie [edit routing-options resolution]. Cela garantit que tous les processus de routage associés respectent la hiérarchie de saut suivant établie. Cela facilite la résolution efficace des routes et accélère leur adaptation en cas de défaillance des chemins, ce qui contribue à améliorer les performances du réseau.
La fonctionnalité Préserver la hiérarchie du prochain saut profite aux réseaux qui nécessitent une haute disponibilité et une intégration transparente avec des technologies avancées telles que le Segment Routing avec MPLS et le Segment Routing avec IPv6. Ils offrent une meilleure distribution du trafic, une meilleure redondance et un comportement de routage cohérent sur les architectures réseau complexes.
preserve-nexthop-hierarchy au niveau global ou au niveau du protocole, le saut suivant pointé par les routes affectées est recalculé et téléchargé dans PFE et le noyau. Il en résulte des pics de processeur plus élevés dans l’équipement dans un environnement à plus grande échelle, entraînant une perte de paquets jusqu’à ce que les routes soient reprogrammées dans le PFE.
Présentation de la périphérie PIC BGP utilisant l’unicast étiqueté BGP
Cette section présente les avantages et la présentation de BGP PIC Edge qui utilise l’unicast étiqueté BGP comme protocole de transport.
- Avantages de la périphérie PIC BGP utilisant l’unicast étiqueté BGP
- Comment fonctionne la convergence indépendante du préfixe BGP ?
- Périphérie PIC BGP utilisant l’unicast étiqueté BGP comme protocole de transport
Avantages de la périphérie PIC BGP utilisant l’unicast étiqueté BGP
Cette fonctionnalité offre les avantages suivants :
Fournit une protection du trafic en cas de défaillance des nœuds de bordure (ABR et ASBR) dans les réseaux multi-domaines.
Permet de rétablir plus rapidement la connectivité réseau et réduit les pertes de trafic si le chemin principal devient indisponible.
Comment fonctionne la convergence indépendante du préfixe BGP ?
La convergence indépendante du préfixe BGP (PIC) améliore la convergence BGP en cas de défaillance des nœuds réseau. Le PIC BGP crée et stocke les chemins principaux et secondaires pour le saut suivant indirect sur le moteur de routage et fournit également les informations sur l’itinéraire de saut suivant indirect au moteur de transfert de paquets. Lorsqu’un nœud réseau tombe en panne, le moteur de routage signale au moteur de transfert de paquets qu’un saut suivant indirect a échoué et que le trafic est réacheminé vers un chemin précalculé à coût égal ou secondaire sans modifier les préfixes BGP. Le routage du trafic vers le préfixe de destination se poursuit à l’aide du chemin de secours pour réduire la perte de trafic jusqu’à ce que la convergence globale via BGP soit résolue.
La convergence BGP s’applique aux défaillances de nœuds du réseau central et de périphérie. Dans le cas du cœur du PIC BGP, les chaînes de transfert sont ajustées en raison de la défaillance des liaisons du nœud ou du cœur. Dans le cas de BGP PIC Edge, les chaînes de transfert sont ajustées en raison de défaillances de nœud périphérique ou de liaison périphérique.
Périphérie PIC BGP utilisant l’unicast étiqueté BGP comme protocole de transport
Le dispositif PIC Edge BGP utilisant le protocole de transport unicast étiqueté BGP permet de protéger et de réacheminer le trafic lorsque des nœuds de bordure (ABR et ASBR) défaillants se produisent dans les réseaux multidomaines. Les réseaux multidomaines sont généralement utilisés dans l’agrégation Metro Ethernet et les conceptions de réseaux de backhaul mobile.
Sur les équipements MX Series, EX Series et PTX Series de Juniper Networks, BGP PIC Edge prend en charge les services de couche 3 avec l’étiquetage BGP unicast comme protocole de transport. De plus, sur les équipements MX Series, EX9204, EX9208, EX9214, EX9251 et EX9253 de Juniper Networks, le BGP PIC Edge prend en charge les services de circuit de couche 2, VPN de couche 2 et VPLS (VPLS BGP, VPLS LDP et FEC 129) avec un unicast étiqueté BGP comme protocole de transport. Ces services BGP sont multichemins (appris à partir de plusieurs PE) et résolus via des routes unicast étiquetées BGP, qui pourraient à nouveau être un chemin multichemin appris à partir d’autres ABR. Les protocoles de transport pris en charge sur BGP PIC Edge sont RSVP, LDP, OSPF et ISIS. À partir de Junos OS version 20.2R1, les équipements MX Series, EX9204, EX9208, EX9214, EX9251 et EX9253 prennent en charge la protection BGP PIC Edge pour les services de circuit de couche 2, VPN de couche 2 et VPLS (VPLS BGP, VPLS LDP et FEC 129 VPLS) avec l’étiquetage unicast BGP comme protocole de transport.
Sur les équipements Juniper Networks MX Series, EX Series et PTX Series, la protection BGP PIC Edge avec unicast étiqueté BGP comme transport est prise en charge pour les services suivants :
Services IPv4 sur IPv4 unicast étiqueté BGP
IPv6 BGP étiqueté service unicast sur IPv4 BGP étiqueté unicast
Services VPN de couche 3 IPv4 sur IPv4 unicast étiqueté BGP
Services VPN IPv6 de couche 3 sur IPv4 unicast étiqueté BGP
Sur les équipements MX Series et EX Series de Juniper Networks, la protection BGP PIC Edge avec unicast étiqueté BGP comme transport est prise en charge pour les services suivants :
Services de circuit de couche 2 sur IPv4 unicast étiqueté BGP
Services VPN de couche 2 sur IPv4 unicast étiqueté BGP
Services VPLS (VPLS BGP, VPLS LDP et FEC 129 VPLS) sur IPv4 unicast étiqueté BGP
Configuration de BGP PIC Edge à l’aide d’une unicast étiquetée BGP pour les services de couche 2
MX Series, EX9204, EX9208, EX9214, EX9251 et EX9253 prennent en charge la protection PIC Edge BGP pour les services VPN de couche circuit 2, VPN de couche 2 et VPLS (VPLS BGP, VPLS LDP et VPLS FEC 129) avec BGP étiquetés unicast comme protocole de transport. BGP PIC Edge utilisant le protocole de transport unicast étiqueté BGP permet de protéger contre les défaillances de trafic sur les nœuds de frontière (ABR et ASBR) dans les réseaux multidomaines. Les réseaux multidomaines sont généralement utilisés dans les conceptions de réseaux d’agrégation métropolitaine et de backhaul mobile.
Une condition préalable à la protection de BGP PIC Edge est de programmer le moteur de transfert de paquets (PFE) avec une hiérarchie de saut suivant étendue.
Pour activer l’extension de la hiérarchie de saut suivant pour BGP famille de unicast étiquetée, vous devez configurer l’instruction de configuration CLI suivante au niveau de la hiérarchie [edit protocols] :
[edit protocols] user@host#set bgp group group-name family inet labeled-unicast nexthop-resolution preserve-nexthop-hierarchy;
Pour activer le PIC BGP pour les prochains sauts d’équilibrage de charge MPLS, vous devez configurer l’instruction de configuration CLI suivante au niveau de la hiérarchie [edit routing-options] :
[edit routing-options] user@host#set rib routing-table-name protect core;
Pour activer une convergence rapide pour les services de couche 2, vous devez configurer les instructions de configuration CLI suivantes au niveau de la hiérarchie [edit protocols] :
Pour les circuits de couche 2 et les VPLS LDP :
[edit protocols] user@host#set l2circuit resolution preserve-nexthop-heirarchy;
Pour les VPN de couche 2, BGP VPLS et FEC129 :
[edit protocols] user@host#set l2vpn resolution preserve-nexthop-heirarchy;
Exemple : Protection du trafic IPv4 sur un VPN de couche 3 exécutant un unicast étiqueté BGP
Cet exemple montre comment configurer BGP périphérie convergence indépendante des préfixes (PIC) étiquetée unicast et protéger le trafic IPv4 sur un VPN de couche 3. Lorsqu’un trafic IPv4 provenant d’un routeur CE est envoyé à un routeur PE, le trafic IPv4 est acheminé sur un VPN de couche 3, où l’unicast étiqueté BGP est configuré comme protocole de transport.
Exigences
Cet exemple utilise les composants matériels et logiciels suivants :
-
routeurs MX Series.
-
Junos OS version 19.4R1 ou ultérieure s’exécutant sur tous les équipements.
Vue d’ensemble
La topologie suivante fournit une protection ABR et ASBR en basculant le trafic vers des chemins de secours chaque fois que le chemin principal devient indisponible.
Topologie
La figure 14 illustre un VPN de couche 3 exécutant BGP étiqueté unicast comme protocole de transport inter-domaines.
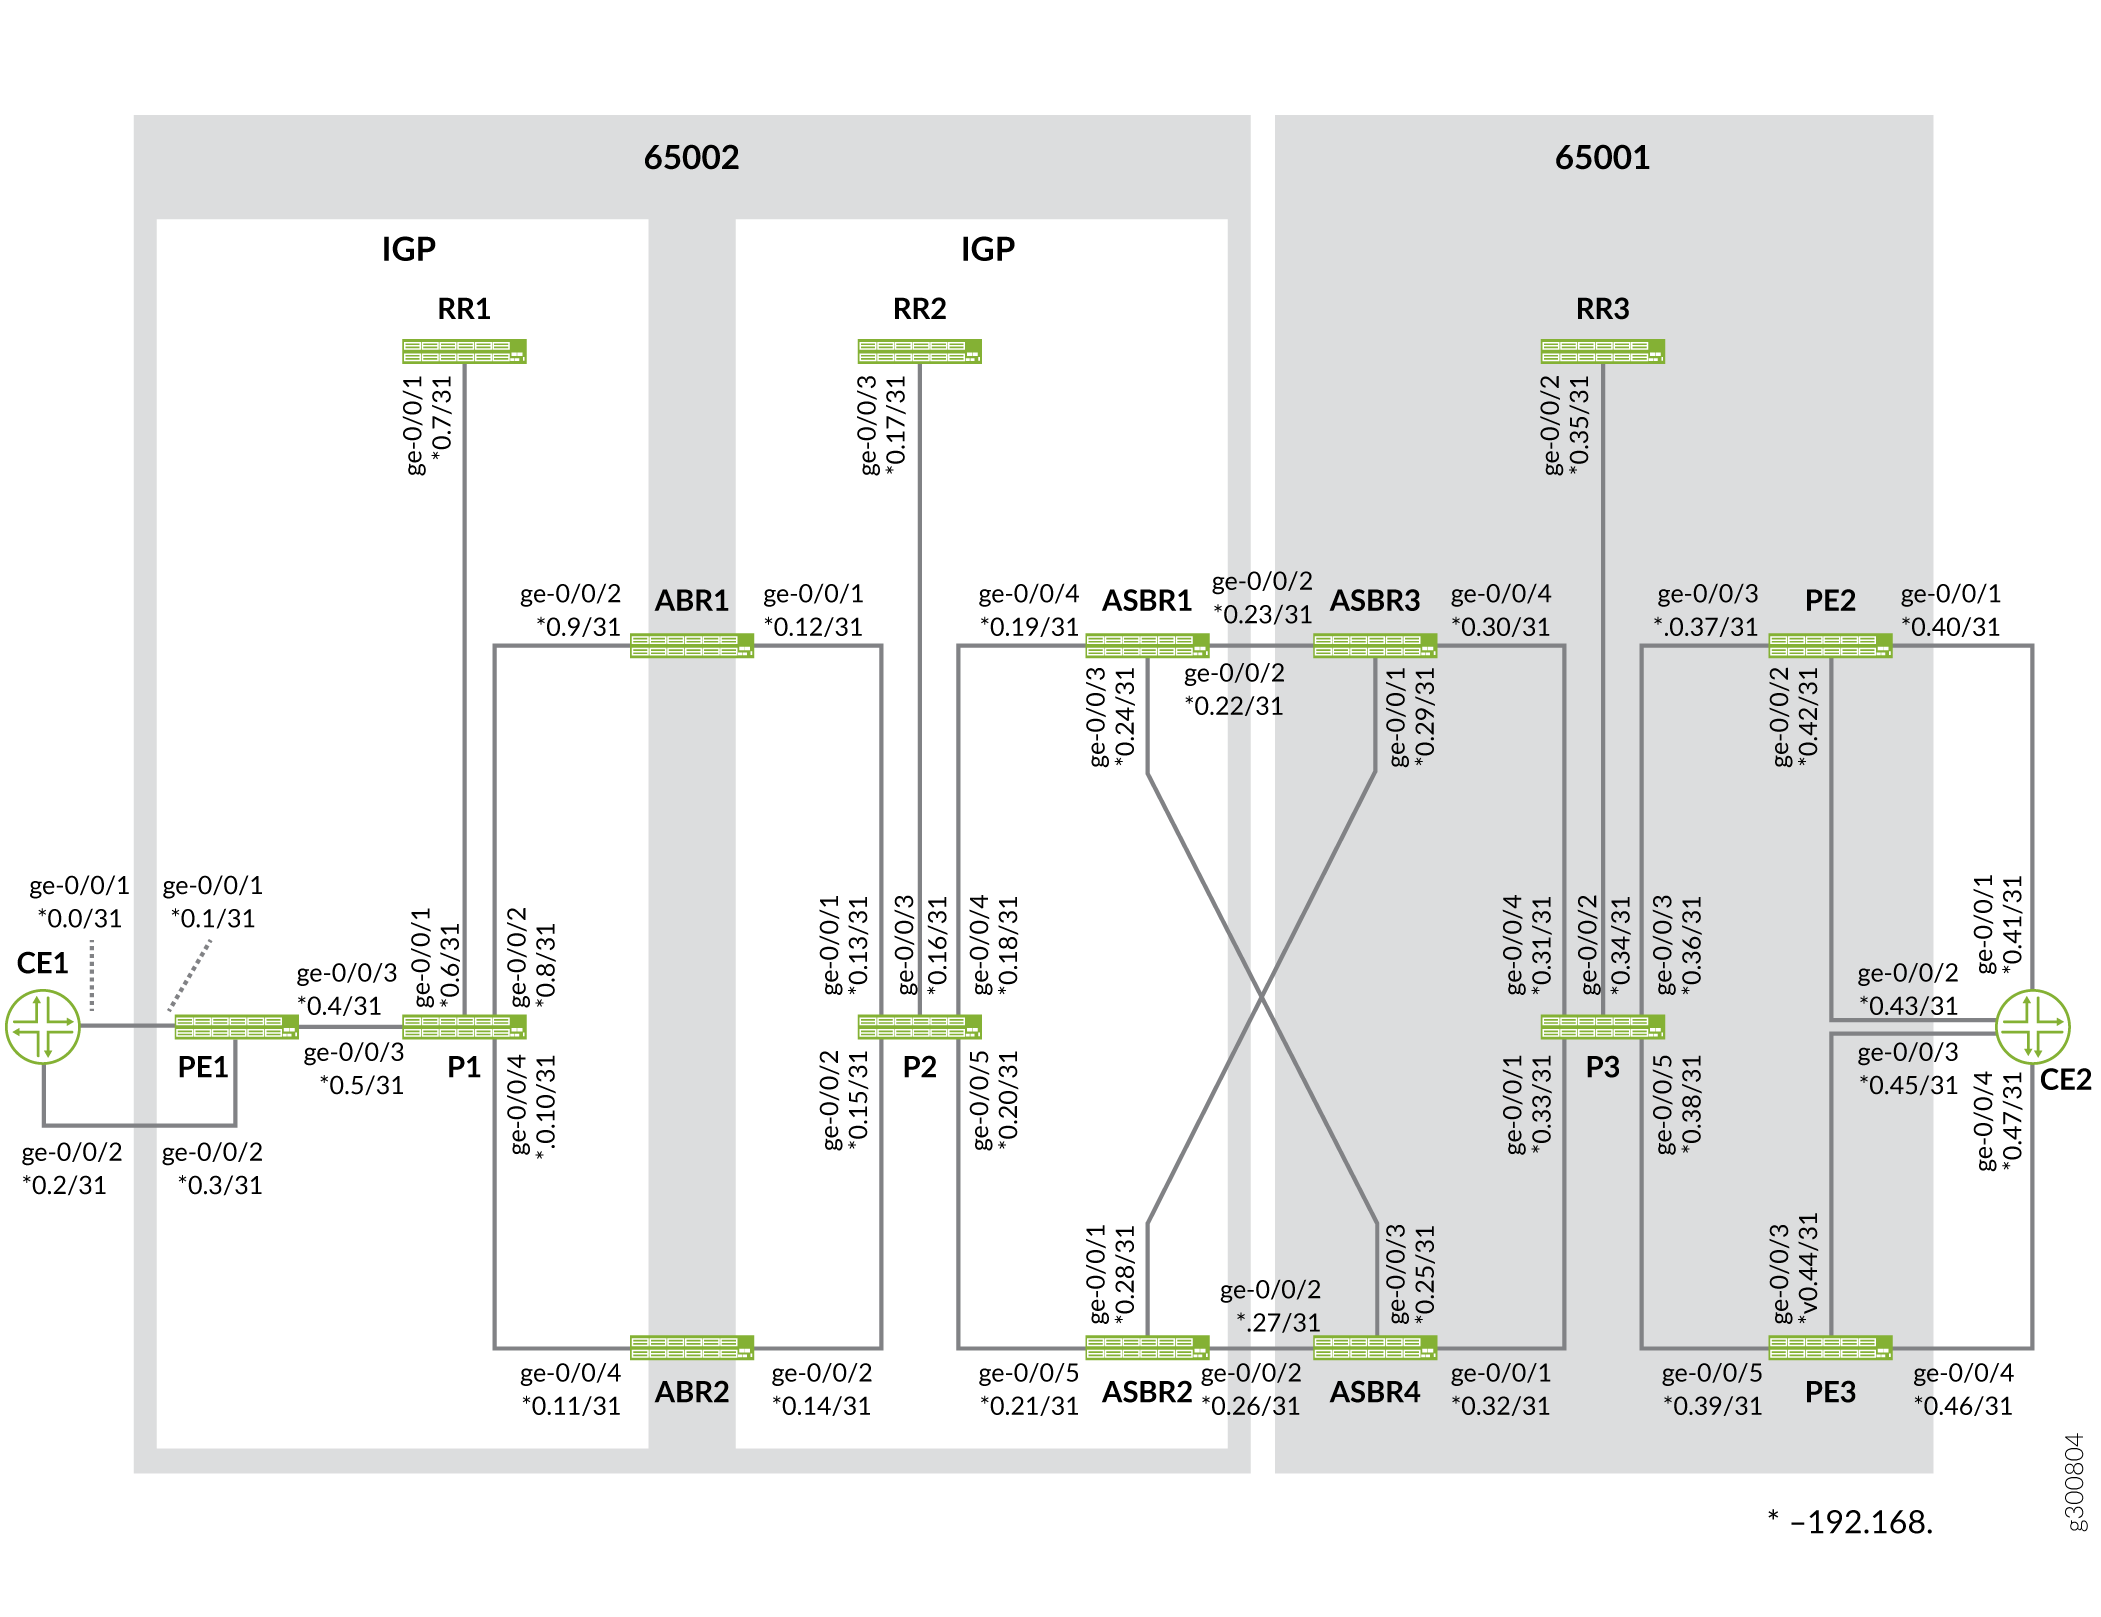
Le tableau suivant décrit les composants utilisés dans la topologie :
| Composants principaux |
Type d’équipement |
Poste |
|---|---|---|
| CE1 |
MX Series |
Connecté au réseau du client. |
| PE1 |
MX Series |
Configuré avec des chemins de routage principal et secondaire pour protéger et rediriger le trafic de CE1 vers CE2. |
| P1 à P3 |
MX Series |
Routeurs centraux pour le transport du trafic. |
| ABR1-ABR2 |
MX Series |
Routeurs de bordure de zone |
| ABSR1-ABSR4 |
MX Series |
Routeur de limite de système autonome |
| RR1-RR3 |
MX Series |
Réflecteur de route |
| PE2-PE3 |
MX Series |
Routeurs PE connectés au routeur de périphérie client (CE2). |
| CE2 |
MX Series |
Connecté au réseau du client. |
Les adresses des équipements PE2 et PE3 sont apprises à partir des routes ABR1 et ABR2 sous forme de routes unicast étiquetées. Ces routes sont résolues via des protocoles IGP/LDP. PE1 apprend les routes CE2 à partir des appareils PE2 et PE3.
La configuration
Pour configurer BGP PIC Edge à l’aide de BGP Label Unicast avec LDP comme protocole de transport, effectuez les tâches suivantes :
- Configuration rapide de la CLI
- Configuration de CE1
- Configuration de PE1
- Configuration de l’équipement P1
- Configuration du périphérique RR1
- Configuration de l’équipement ABR1
- Configuration de l’équipement ABR2
- Configuration de l’équipement P2
- Configuration du périphérique RR2
Configuration rapide de la CLI
Pour configurer rapidement cet exemple, copiez les commandes suivantes, collez-les dans un fichier texte, supprimez les sauts de ligne, modifiez tous les détails nécessaires pour qu’ils correspondent à votre configuration réseau, copiez et collez les commandes dans la CLI au niveau de la [edit] hiérarchie, puis entrez commit en mode configuration.
Appareil CE1
set interfaces ge-0/0/1 description CE1-to-PE1-Link1 set interfaces ge-0/0/1 vlan-tagging set interfaces ge-0/0/1 unit 0 vlan-id 100 set interfaces ge-0/0/1 unit 0 family inet address 192.168.0.0/31 set interfaces ge-0/0/2 description CE1-to-PE1-Link2 set interfaces ge-0/0/2 vlan-tagging set interfaces ge-0/0/2 unit 0 vlan-id 100 set interfaces ge-0/0/2 unit 0 family inet address 192.168.0.2/31 set interfaces lo0 unit 0 family inet address 10.4.4.4/32 set policy-options policy-statement nhs term 1 from interface lo0.0 set policy-options policy-statement nhs term 1 then next-hop self set policy-options policy-statement nhs term 1 then accept set routing-options router-id 10.4.4.4 set routing-options autonomous-system 65004 set protocols bgp path-selection external-router-id set protocols bgp group toAs2 export nhs set protocols bgp group toAs2 peer-as 65002 set protocols bgp group toAs2 neighbor 192.168.0.1 set protocols bgp group toAs2 neighbor 192.168.0.3
Dispositif PE1
set interfaces ge-0/0/1 description PE1-to-CE1-Link1 set interfaces ge-0/0/1 vlan-tagging set interfaces ge-0/0/1 unit 0 vlan-id 100 set interfaces ge-0/0/1 unit 0 family inet address 192.168.0.1/31 set interfaces ge-0/0/2 description PE1-to-CE1-Link2 set interfaces ge-0/0/2 vlan-tagging set interfaces ge-0/0/2 unit 0 vlan-id 100 set interfaces ge-0/0/2 unit 0 family inet address 192.168.0.3/31 set interfaces ge-0/0/3 description PE1-to-P1 set interfaces ge-0/0/3 vlan-tagging set interfaces ge-0/0/3 unit 0 vlan-id 100 set interfaces ge-0/0/3 unit 0 family inet address 192.168.0.4/31 set interfaces ge-0/0/3 unit 0 family iso set interfaces ge-0/0/3 unit 0 family mpls set interfaces lo0 unit 1 family inet address 10.2.2.5/32 set interfaces lo0 unit 1 family iso address 49.0000.0000.aaaa.0005.00 set policy-options policy-statement add-noexport term 1 then community add noexport set policy-options policy-statement allow-lo0 term 1 from interface lo0.1 set policy-options policy-statement allow-lo0 term 1 then accept set policy-options policy-statement allow-lo0 term 2 then reject set policy-options policy-statement export-inet3 term 1 from rib inet.3 set policy-options policy-statement export-inet3 term 1 then accept set policy-options policy-statement export-inet3 term 2 then reject set policy-options policy-statement mp-resolv term 1 from route-filter 10.1.1.0/24 orlonger set policy-options policy-statement mp-resolv term 1 then accept set policy-options policy-statement mp-resolv term 1 then multipath-resolve set policy-options policy-statement mp-resolv term 2 from route-filter 10.2.2.0/24 orlonger set policy-options policy-statement mp-resolv term 2 then accept set policy-options policy-statement mp-resolv term 2 then multipath-resolve set policy-options policy-statement mp-resolv term def then reject set policy-options policy-statement nhs term 1 from protocol bgp set policy-options policy-statement nhs term 1 then local-preference 65200 set policy-options policy-statement nhs term 1 then next-hop self set policy-options policy-statement nhs term 1 then accept set policy-options policy-statement pplb then load-balance per-packet set policy-options policy-statement vrf-export-red term 1 then community add leak2red set policy-options policy-statement vrf-export-red term 1 then accept set policy-options policy-statement vrf-import-red term 1 from community leak2red set policy-options policy-statement vrf-import-red term 1 then accept set policy-options community leak2red members target:100:100 set policy-options community noexport members no-export set policy-options community noexport members no-advertise set routing-instances red routing-options multipath preserve-nexthop-hierarchy set routing-instances red routing-options protect core set routing-instances red protocols bgp group toCE1 peer-as 4 set routing-instances red protocols bgp group toCE1 neighbor 192.168.0.2 set routing-instances red instance-type vrf set routing-instances red interface ge-0/0/2.0 set routing-instances red vrf-import vrf-import-red set routing-instances red vrf-export vrf-export-red set routing-options rib inet.3 protect core set routing-options route-distinguisher-id 10.2.2.5 set routing-options forwarding-table export pplb set routing-options resolution preserve-nexthop-hierarchy set routing-options resolution rib inet.0 import mp-resolv set routing-options interface-routes rib-group inet inet0to3 set routing-options router-id 10.2.2.5 set routing-options autonomous-system 2 set routing-options protect core set routing-options rib-groups inet0to3 import-rib inet.0 set routing-options rib-groups inet0to3 import-rib inet.3 set routing-options rib-groups inet0to3 import-policy allow-lo0 set routing-options rib-groups inet3to0 import-rib inet.3 set routing-options rib-groups inet3to0 import-rib inet.0 set routing-options rib-groups inet3to0 import-policy add-noexport set protocols isis level 1 disable set protocols isis interface ge-0/0/3.0 set protocols isis export allow-lo0 set protocols isis topologies ipv6-unicast set protocols rsvp interface ge-0/0/3.0 set protocols ldp interface ge-0/0/3.0 set protocols mpls label-switched-path toABR1-gold to 10.2.2.3 set protocols mpls label-switched-path toABR1-bronze to 10.2.2.3 set protocols mpls label-switched-path toABR2-gold to 10.2.2.4 set protocols bgp path-selection external-router-id set protocols bgp group toAs2RR type internal set protocols bgp group toAs2RR local-address 10.2.2.5 set protocols bgp group toAs2RR family inet labeled-unicast rib-group inet3to0 set protocols bgp group toAs2RR family inet labeled-unicast add-path receive set protocols bgp group toAs2RR family inet labeled-unicast add-path send path-count 4 set protocols bgp group toAs2RR family inet labeled-unicast nexthop-resolution preserve-nexthop-hierarchy set protocols bgp group toAs2RR family inet labeled-unicast rib inet.3 set protocols bgp group toAs2RR export nhs set protocols bgp group toAs2RR export export-inet3 set protocols bgp group toAs2RR neighbor 10.2.2.6 set protocols bgp group toAs4 peer-as 65004 set protocols bgp group toAs4 neighbor 192.168.0.0 set protocols bgp group toAs1PEs multihop no-nexthop-change set protocols bgp group toAs1PEs local-address 10.2.2.5 set protocols bgp group toAs1PEs family inet unicast set protocols bgp group toAs1PEs family inet-vpn unicast set protocols bgp group toAs1PEs family inet6 unicast set protocols bgp group toAs1PEs family inet6-vpn unicast set protocols bgp group toAs1PEs export nhs set protocols bgp group toAs1PEs peer-as 65001 set protocols bgp group toAs1PEs neighbor 10.1.1.1 set protocols bgp group toAs1PEs neighbor 10.1.1.2 set protocols bgp traceoptions file bgp.log set protocols bgp traceoptions file size 100m set protocols bgp traceoptions flag state detail set protocols bgp traceoptions flag policy set protocols bgp multipath
Appareil P1
set interfaces ge-0/0/1 description P1-to-RR1 set interfaces ge-0/0/1 vlan-tagging set interfaces ge-0/0/1 unit 0 vlan-id 100 set interfaces ge-0/0/1 unit 0 family inet address 192.168.0.6/31 set interfaces ge-0/0/1 unit 0 family iso set interfaces ge-0/0/1 unit 0 family mpls set interfaces ge-0/0/2 description P1-to-ABR1 set interfaces ge-0/0/2 vlan-tagging set interfaces ge-0/0/2 unit 0 vlan-id 100 set interfaces ge-0/0/2 unit 0 family inet address 192.168.0.8/31 set interfaces ge-0/0/2 unit 0 family iso set interfaces ge-0/0/2 unit 0 family mpls set interfaces ge-0/0/3 description P1-to-PE1 set interfaces ge-0/0/3 vlan-tagging set interfaces ge-0/0/3 unit 0 vlan-id 100 set interfaces ge-0/0/3 unit 0 family inet address 192.168.0.5/31 set interfaces ge-0/0/3 unit 0 family iso set interfaces ge-0/0/3 unit 0 family mpls set interfaces ge-0/0/4 description P1-to-ABR2 set interfaces ge-0/0/4 vlan-tagging set interfaces ge-0/0/4 unit 0 vlan-id 100 set interfaces ge-0/0/4 unit 0 family inet address 192.168.0.10/31 set interfaces ge-0/0/4 unit 0 family iso set interfaces ge-0/0/4 unit 0 family mpls set interfaces lo0 unit 0 family inet address 10.2.2.8/32 set interfaces lo0 unit 0 family iso address 49.0000.0000.aaaa.0008.00 set policy-options policy-statement allow-lo0 term 1 from interface lo0.0 set policy-options policy-statement allow-lo0 term 1 then accept set policy-options policy-statement allow-lo0 term 2 then reject set routing-options router-id 10.2.2.8 set protocols isis level 1 disable set protocols isis interface all set protocols isis export allow-lo0 set protocols isis topologies ipv6-unicast set protocols rsvp interface all set protocols ldp interface all set protocols mpls interface all
RR1 de l’appareil
set interfaces ge-0/0/1 description RR1-to-P1 set interfaces ge-0/0/1 vlan-tagging set interfaces ge-0/0/1 unit 0 vlan-id 100 set interfaces ge-0/0/1 unit 0 family inet address 192.168.0.7/31 set interfaces ge-0/0/1 unit 0 family iso set interfaces ge-0/0/1 unit 0 family mpls set interfaces lo0 unit 1 family inet address 10.2.2.6/32 set interfaces lo0 unit 1 family iso address 49.0000.0000.aaaa.0006.00 set policy-options policy-statement add-noexport term 1 then community add noexport set policy-options policy-statement allow-lo0 term 1 from interface lo0.1 set policy-options policy-statement allow-lo0 term 1 then accept set policy-options policy-statement allow-lo0 term 2 then reject set policy-options policy-statement export-inet3 term 1 from rib inet.3 set policy-options policy-statement export-inet3 term 1 then accept set policy-options policy-statement export-inet3 term 2 then reject set policy-options policy-statement pplb then load-balance per-packet set policy-options community noexport members no-export set policy-options community noexport members no-advertise set routing-options forwarding-table export pplb set routing-options interface-routes rib-group inet inet0to3 set routing-options router-id 10.2.2.6 set routing-options autonomous-system 2 set routing-options rib-groups inet0to3 import-rib inet.0 set routing-options rib-groups inet0to3 import-rib inet.3 set routing-options rib-groups inet0to3 import-policy allow-lo0 set routing-options rib-groups inet3to0 import-rib inet.3 set routing-options rib-groups inet3to0 import-rib inet.0 set routing-options rib-groups inet3to0 import-rib inet6.3 set routing-options rib-groups inet3to0 import-policy add-noexport set protocols isis level 1 disable set protocols isis interface all set protocols isis export allow-lo0 set protocols isis topologies ipv6-unicast set protocols rsvp interface all set protocols ldp interface all set protocols mpls interface all set protocols bgp path-selection external-router-id set protocols bgp group toAs2Reg2BNs type internal set protocols bgp group toAs2Reg2BNs family inet labeled-unicast rib-group inet3to0 set protocols bgp group toAs2Reg2BNs family inet labeled-unicast add-path receive set protocols bgp group toAs2Reg2BNs family inet labeled-unicast add-path send path-count 4 set protocols bgp group toAs2Reg2BNs family inet labeled-unicast rib inet.3 set protocols bgp group toAs2Reg2BNs export export-inet3 set protocols bgp group toAs2Reg2BNs neighbor 10.2.2.3 set protocols bgp group toAs2Reg2BNs neighbor 10.2.2.4 set protocols bgp group toAs2Reg2BNs neighbor 10.2.2.5 set protocols bgp traceoptions file bgp.log set protocols bgp traceoptions file size 100m set protocols bgp traceoptions flag state detail set protocols bgp traceoptions flag policy set protocols bgp local-address 10.2.2.6 set protocols bgp cluster 10.2.2.6
Équipement ABR1
set interfaces ge-0/0/1 description ABR1-to-P2 set interfaces ge-0/0/1 vlan-tagging set interfaces ge-0/0/1 unit 0 vlan-id 100 set interfaces ge-0/0/1 unit 0 family inet address 192.168.0.12/31 set interfaces ge-0/0/1 unit 0 family iso set interfaces ge-0/0/1 unit 0 family mpls set interfaces ge-0/0/2 description ABR1-to-P1 set interfaces ge-0/0/2 vlan-tagging set interfaces ge-0/0/2 unit 0 vlan-id 100 set interfaces ge-0/0/2 unit 0 family inet address 192.168.0.9/31 set interfaces ge-0/0/2 unit 0 family iso set interfaces ge-0/0/2 unit 0 family mpls set interfaces lo0 unit 0 family inet address 10.2.2.3/32 set interfaces lo0 unit 0 family iso address 49.0000.0000.aaaa.0003.00 set policy-options policy-statement allow-lo0 term 1 from interface lo0.0 set policy-options policy-statement allow-lo0 term 1 then accept set policy-options policy-statement allow-lo0 term 2 then reject set policy-options policy-statement nhs term 1 from protocol bgp set policy-options policy-statement nhs term 1 then next-hop self set policy-options policy-statement nhs term 1 then accept set policy-options policy-statement pplb then load-balance per-packet set routing-options forwarding-table export pplb set routing-options router-id 10.2.2.3 set routing-options autonomous-system 65002 set protocols isis level 1 disable set protocols isis interface all set protocols isis export allow-lo0 set protocols isis topologies ipv6-unicast set protocols rsvp interface all set protocols ldp interface all set protocols mpls label-switched-path toASBR2-gold to 10.2.2.2 set protocols mpls label-switched-path toASBR1-bronze to 10.2.2.1 set protocols mpls label-switched-path toASBR2-bronze to 10.2.2.2 set protocols mpls interface all set protocols bgp group toAs2RR type internal set protocols bgp group toAs2RR local-address 10.2.2.3 set protocols bgp group toAs2RR advertise-inactive set protocols bgp group toAs2RR family inet labeled-unicast add-path receive set protocols bgp group toAs2RR family inet labeled-unicast add-path send path-count 4 set protocols bgp group toAs2RR family inet labeled-unicast rib inet.3 set protocols bgp group toAs2RR export nhs set protocols bgp group toAs2RR cluster 10.2.2.3 set protocols bgp group toAs2RR neighbor 10.2.2.6 set protocols bgp group toAs2RR neighbor 10.2.2.7 set protocols bgp traceoptions file bgp.log set protocols bgp traceoptions file size 100m set protocols bgp traceoptions flag state detail set protocols bgp traceoptions flag policy
Équipement ABR2
set interfaces ge-0/0/2 description ABR2-to-P2 set interfaces ge-0/0/2 vlan-tagging set interfaces ge-0/0/2 unit 0 vlan-id 100 set interfaces ge-0/0/2 unit 0 family inet address 192.168.0.14/31 set interfaces ge-0/0/2 unit 0 family iso set interfaces ge-0/0/2 unit 0 family mpls set interfaces ge-0/0/4 description ABR2-to-P1 set interfaces ge-0/0/4 vlan-tagging set interfaces ge-0/0/4 unit 0 vlan-id 100 set interfaces ge-0/0/4 unit 0 family inet address 192.168.0.11/31 set interfaces ge-0/0/4 unit 0 family iso set interfaces ge-0/0/4 unit 0 family mpls set interfaces lo0 unit 0 family inet address 10.2.2.4/32 set interfaces lo0 unit 0 family iso address 49.0000.0000.aaaa.0004.00 set policy-options policy-statement allow-lo0 term 1 from interface lo0.0 set policy-options policy-statement allow-lo0 term 1 then accept set policy-options policy-statement allow-lo0 term 2 then reject set policy-options policy-statement nhs term 1 from protocol bgp set policy-options policy-statement nhs term 1 then next-hop self set policy-options policy-statement nhs term 1 then accept set policy-options policy-statement pplb then load-balance per-packet set routing-options forwarding-table export pplb set routing-options router-id 10.2.2.4 set routing-options autonomous-system 65002 set protocols isis level 1 disable set protocols isis interface all set protocols isis export allow-lo0 set protocols isis topologies ipv6-unicast set protocols rsvp interface all set protocols ldp interface all set protocols mpls label-switched-path toASBR1-bronze to 10.2.2.1 set protocols mpls interface all set protocols bgp group toAs2RR type internal set protocols bgp group toAs2RR local-address 10.2.2.4 set protocols bgp group toAs2RR advertise-inactive set protocols bgp group toAs2RR family inet labeled-unicast add-path receive set protocols bgp group toAs2RR family inet labeled-unicast add-path send path-count 4 set protocols bgp group toAs2RR family inet labeled-unicast rib inet.3 set protocols bgp group toAs2RR export nhs set protocols bgp group toAs2RR cluster 10.2.2.4 set protocols bgp group toAs2RR neighbor 10.2.2.6 set protocols bgp group toAs2RR neighbor 10.2.2.7 set protocols bgp traceoptions file bgp.log set protocols bgp traceoptions file size 100m set protocols bgp traceoptions flag state detail set protocols bgp traceoptions flag policy
Équipement P2
set interfaces ge-0/0/1 description P2-to-ABR1 set interfaces ge-0/0/1 vlan-tagging set interfaces ge-0/0/1 unit 0 vlan-id 100 set interfaces ge-0/0/1 unit 0 family inet address 192.168.0.13/31 set interfaces ge-0/0/1 unit 0 family iso set interfaces ge-0/0/1 unit 0 family mpls set interfaces ge-0/0/2 description P2-to-ABR2 set interfaces ge-0/0/2 vlan-tagging set interfaces ge-0/0/2 unit 0 vlan-id 100 set interfaces ge-0/0/2 unit 0 family inet address 192.168.0.15/31 set interfaces ge-0/0/2 unit 0 family iso set interfaces ge-0/0/2 unit 0 family mpls set interfaces ge-0/0/3 description P2-to-RR2 set interfaces ge-0/0/3 vlan-tagging set interfaces ge-0/0/3 unit 0 vlan-id 100 set interfaces ge-0/0/3 unit 0 family inet address 192.168.0.16/31 set interfaces ge-0/0/3 unit 0 family iso set interfaces ge-0/0/3 unit 0 family mpls set interfaces ge-0/0/4 description P2-to-ASBR1 set interfaces ge-0/0/4 vlan-tagging set interfaces ge-0/0/4 unit 0 vlan-id 100 set interfaces ge-0/0/4 unit 0 family inet address 192.168.0.18/31 set interfaces ge-0/0/4 unit 0 family iso set interfaces ge-0/0/4 unit 0 family mpls set interfaces ge-0/0/5 description P2-to-ASBR2 set interfaces ge-0/0/5 vlan-tagging set interfaces ge-0/0/5 unit 0 vlan-id 100 set interfaces ge-0/0/5 unit 0 family inet address 192.168.0.20/31 set interfaces ge-0/0/5 unit 0 family iso set interfaces ge-0/0/5 unit 0 family mpls set interfaces lo0 unit 0 family inet address 10.2.2.9/32 set interfaces lo0 unit 0 family iso address 49.0000.0000.aaaa.0009.00 set policy-options policy-statement allow-lo0 term 1 from interface lo0.0 set policy-options policy-statement allow-lo0 term 1 then accept set policy-options policy-statement allow-lo0 term 2 then reject set routing-options router-id 10.2.2.9 set protocols isis level 1 disable set protocols isis interface all set protocols isis export allow-lo0 set protocols isis topologies ipv6-unicast set protocols rsvp interface all set protocols ldp interface all set protocols mpls interface all
Appareil RR2
set interfaces ge-0/0/3 description RR2-to-P2 set interfaces ge-0/0/3 vlan-tagging set interfaces ge-0/0/3 unit 0 vlan-id 100 set interfaces ge-0/0/3 unit 0 family inet address 192.168.0.17/31 set interfaces ge-0/0/3 unit 0 family iso set interfaces ge-0/0/3 unit 0 family mpls set interfaces lo0 unit 1 family inet address 10.2.2.7/32 set interfaces lo0 unit 1 family iso address 49.0000.0000.aaaa.0007.00 set policy-options policy-statement allow-lo0 term 1 from interface lo0.1 set policy-options policy-statement allow-lo0 term 1 then accept set policy-options policy-statement allow-lo0 term 2 then reject set policy-options policy-statement export-inet3 term 1 from rib inet.3 set policy-options policy-statement export-inet3 term 1 then accept set policy-options policy-statement export-inet3 term 2 then reject set policy-options policy-statement pplb then load-balance per-packet set routing-options forwarding-table export pplb set routing-options interface-routes rib-group inet inet0to3 set routing-options router-id 10.2.2.7 set routing-options autonomous-system 65002 set routing-options rib-groups inet0to3 import-rib inet.0 set routing-options rib-groups inet0to3 import-rib inet.3 set routing-options rib-groups inet0to3 import-policy allow-lo0 set protocols isis level 1 disable set protocols isis interface all set protocols isis export allow-lo0 set protocols isis topologies ipv6-unicast set protocols rsvp interface all set protocols ldp interface all set protocols mpls interface all set protocols bgp path-selection external-router-id set protocols bgp group toAs2Reg1BNs type internal set protocols bgp group toAs2Reg1BNs family inet labeled-unicast add-path receive set protocols bgp group toAs2Reg1BNs family inet labeled-unicast add-path send path-count 4 set protocols bgp group toAs2Reg1BNs family inet labeled-unicast rib inet.3 set protocols bgp group toAs2Reg1BNs neighbor 10.2.2.1 set protocols bgp group toAs2Reg1BNs neighbor 10.2.2.2 set protocols bgp group toAs2Reg1BNs neighbor 10.2.2.3 set protocols bgp group toAs2Reg1BNs neighbor 10.2.2.4 set protocols bgp traceoptions file bgp.log set protocols bgp traceoptions file size 100m set protocols bgp traceoptions flag state detail set protocols bgp traceoptions flag policy set protocols bgp local-address 10.2.2.7 set protocols bgp cluster 10.2.2.7
ASBR1 de l’appareil
set interfaces ge-0/0/2 description ASBR1-to-ASBR3 set interfaces ge-0/0/2 vlan-tagging set interfaces ge-0/0/2 unit 0 vlan-id 100 set interfaces ge-0/0/2 unit 0 family inet address 192.168.0.22/31 set interfaces ge-0/0/2 unit 0 family mpls set interfaces ge-0/0/3 description ASBR1-to-ASBR4 set interfaces ge-0/0/3 vlan-tagging set interfaces ge-0/0/3 unit 0 vlan-id 100 set interfaces ge-0/0/3 unit 0 family inet address 192.168.0.24/31 set interfaces ge-0/0/3 unit 0 family mpls set interfaces ge-0/0/4 description ASBR1-to-P2 set interfaces ge-0/0/4 vlan-tagging set interfaces ge-0/0/4 unit 0 vlan-id 100 set interfaces ge-0/0/4 unit 0 family inet address 192.168.0.19/31 set interfaces ge-0/0/4 unit 0 family iso set interfaces ge-0/0/4 unit 0 family mpls set interfaces lo0 unit 0 family inet address 10.2.2.1/32 set interfaces lo0 unit 0 family iso address 49.0000.0000.aaaa.0001.00 set policy-options policy-statement allow-lo0 term 1 from interface lo0.0 set policy-options policy-statement allow-lo0 term 1 then accept set policy-options policy-statement allow-lo0 term 2 then reject set policy-options policy-statement nhs term 1 from protocol bgp set policy-options policy-statement nhs term 1 then next-hop self set policy-options policy-statement nhs term 1 then accept set policy-options policy-statement pplb then load-balance per-packet set routing-options forwarding-table export pplb set routing-options router-id 10.2.2.1 set routing-options autonomous-system 65002 set protocols isis level 1 disable set protocols isis interface ge-0/0/4.0 set protocols isis export allow-lo0 set protocols isis topologies ipv6-unicast set protocols rsvp interface ge-0/0/4.0 set protocols ldp interface ge-0/0/4.0 set protocols mpls interface ge-0/0/4.0 set protocols bgp path-selection external-router-id set protocols bgp group toAs1-T family inet labeled-unicast rib inet.3 set protocols bgp group toAs1-T peer-as 1 set protocols bgp group toAs1-T neighbor 192.168.0.23 set protocols bgp group toAs1-T neighbor 192.168.0.27 set protocols bgp group toAs2RR type internal set protocols bgp group toAs2RR local-address 10.2.2.1 set protocols bgp group toAs2RR advertise-external set protocols bgp group toAs2RR family inet labeled-unicast rib inet.3 set protocols bgp group toAs2RR export nhs set protocols bgp group toAs2RR neighbor 10.2.2.7 set protocols bgp traceoptions file bgp.log set protocols bgp traceoptions file size 100m set protocols bgp traceoptions flag state detail set protocols bgp traceoptions flag policy
ASBR2 de l’appareil
set interfaces ge-0/0/1 description ASBR2-to-ASBR3 set interfaces ge-0/0/1 vlan-tagging set interfaces ge-0/0/1 unit 0 vlan-id 100 set interfaces ge-0/0/1 unit 0 family inet address 192.168.0.28/31 set interfaces ge-0/0/1 unit 0 family mpls set interfaces ge-0/0/2 description ASBR2-to-ASBR4 set interfaces ge-0/0/2 vlan-tagging set interfaces ge-0/0/2 unit 0 vlan-id 100 set interfaces ge-0/0/2 unit 0 family inet address 192.168.0.26/31 set interfaces ge-0/0/2 unit 0 family mpls set interfaces ge-0/0/5 description ASBR2-to-P2 set interfaces ge-0/0/5 vlan-tagging set interfaces ge-0/0/5 unit 0 vlan-id 100 set interfaces ge-0/0/5 unit 0 family inet address 192.168.0.21/31 set interfaces ge-0/0/5 unit 0 family iso set interfaces ge-0/0/5 unit 0 family mpls set interfaces lo0 unit 0 family inet address 10.2.2.2/32 set interfaces lo0 unit 0 family iso address 49.0000.0000.aaaa.0002.00 set policy-options policy-statement allow-lo0 term 1 from interface lo0.0 set policy-options policy-statement allow-lo0 term 1 then accept set policy-options policy-statement allow-lo0 term 2 then reject set policy-options policy-statement nhs term 1 from protocol bgp set policy-options policy-statement nhs term 1 then next-hop self set policy-options policy-statement nhs term 1 then accept set policy-options policy-statement pplb then load-balance per-packet set routing-options forwarding-table export pplb set routing-options router-id 10.2.2.2 set routing-options autonomous-system 65002 set protocols isis level 1 disable set protocols isis interface ge-0/0/5.0 set protocols isis export allow-lo0 set protocols isis topologies ipv6-unicast set protocols rsvp interface ge-0/0/5.0 set protocols ldp interface ge-0/0/5.0 set protocols mpls interface ge-0/0/5.0 set protocols bgp path-selection external-router-id set protocols bgp group toAs1-T family inet labeled-unicast rib inet.3 set protocols bgp group toAs1-T peer-as 1 set protocols bgp group toAs1-T neighbor 192.168.0.29 set protocols bgp group toAs1-T neighbor 192.168.0.25 set protocols bgp group toAs2RR type internal set protocols bgp group toAs2RR local-address 10.2.2.2 set protocols bgp group toAs2RR advertise-external set protocols bgp group toAs2RR family inet labeled-unicast rib inet.3 set protocols bgp group toAs2RR export nhs set protocols bgp group toAs2RR neighbor 10.2.2.7 set protocols bgp traceoptions file bgp.log set protocols bgp traceoptions file size 100m set protocols bgp traceoptions flag state detail set protocols bgp traceoptions flag policy
Appareil ASBR3
set interfaces ge-0/0/1 description ASBR3-to-ASBR2 set interfaces ge-0/0/1 vlan-tagging set interfaces ge-0/0/1 unit 0 vlan-id 100 set interfaces ge-0/0/1 unit 0 family inet address 192.168.0.29/31 set interfaces ge-0/0/1 unit 0 family mpls set interfaces ge-0/0/2 description ASBR3-to-ASBR1 set interfaces ge-0/0/2 vlan-tagging set interfaces ge-0/0/2 unit 0 vlan-id 100 set interfaces ge-0/0/2 unit 0 family inet address 192.168.0.23/31 set interfaces ge-0/0/2 unit 0 family mpls set interfaces ge-0/0/4 description ASBR3-to-P3 set interfaces ge-0/0/4 vlan-tagging set interfaces ge-0/0/4 unit 0 vlan-id 100 set interfaces ge-0/0/4 unit 0 family inet address 192.168.0.30/31 set interfaces ge-0/0/4 unit 0 family iso set interfaces ge-0/0/4 unit 0 family mpls set interfaces lo0 unit 0 family inet address 10.1.1.3/32 set interfaces lo0 unit 0 family iso address 49.0000.0000.aaaa.0003.00 set policy-options policy-statement allow-lo0 term 1 from interface lo0.0 set policy-options policy-statement allow-lo0 term 1 then accept set policy-options policy-statement allow-lo0 term 2 then reject set policy-options policy-statement nhs term 1 from protocol bgp set policy-options policy-statement nhs term 1 then next-hop self set policy-options policy-statement nhs term 1 then accept set policy-options policy-statement pplb then load-balance per-packet set routing-options forwarding-table export pplb set routing-options router-id 10.1.1.3 set routing-options autonomous-system 65001 set protocols isis level 1 disable set protocols isis interface ge-0/0/4.0 set protocols isis export allow-lo0 set protocols isis topologies ipv6-unicast set protocols rsvp interface ge-0/0/4.0 set protocols ldp interface ge-0/0/4.0 set protocols mpls label-switched-path toPE2-gold to 10.1.1.1 set protocols mpls interface ge-0/0/4.0 set protocols bgp path-selection external-router-id set protocols bgp group toAs2-T family inet labeled-unicast rib inet.3 set protocols bgp group toAs2-T peer-as 65002 set protocols bgp group toAs2-T neighbor 192.168.0.22 set protocols bgp group toAs2-T neighbor 192.168.0.28 set protocols bgp group toAs1RR type internal set protocols bgp group toAs1RR local-address 10.1.1.3 set protocols bgp group toAs1RR advertise-external set protocols bgp group toAs1RR family inet labeled-unicast rib inet.3 set protocols bgp group toAs1RR export nhs set protocols bgp group toAs1RR neighbor 10.1.1.6 set protocols bgp traceoptions file bgp.log set protocols bgp traceoptions file size 100m set protocols bgp traceoptions flag state detail set protocols bgp traceoptions flag policy
Appareil ASBR4
set interfaces ge-0/0/1 description ASBR4-to-P3 set interfaces ge-0/0/1 vlan-tagging set interfaces ge-0/0/1 unit 0 vlan-id 100 set interfaces ge-0/0/1 unit 0 family inet address 192.168.0.32/31 set interfaces ge-0/0/1 unit 0 family iso set interfaces ge-0/0/1 unit 0 family mpls set interfaces ge-0/0/2 description ASBR4-to-ASBR2 set interfaces ge-0/0/2 vlan-tagging set interfaces ge-0/0/2 unit 0 vlan-id 100 set interfaces ge-0/0/2 unit 0 family inet address 192.168.0.27/31 set interfaces ge-0/0/2 unit 0 family mpls set interfaces ge-0/0/3 description ASBR4-to-ASBR1 set interfaces ge-0/0/3 vlan-tagging set interfaces ge-0/0/3 unit 0 vlan-id 100 set interfaces ge-0/0/3 unit 0 family inet address 192.168.0.25/31 set interfaces ge-0/0/3 unit 0 family mpls set interfaces lo0 unit 0 family inet address 10.1.1.4/32 set interfaces lo0 unit 0 family iso address 49.0000.0000.aaaa.0004.00 set policy-options policy-statement allow-lo0 term 1 from interface lo0.0 set policy-options policy-statement allow-lo0 term 1 then accept set policy-options policy-statement allow-lo0 term 2 then reject set policy-options policy-statement nhs term 1 from protocol bgp set policy-options policy-statement nhs term 1 then next-hop self set policy-options policy-statement nhs term 1 then accept set policy-options policy-statement pplb then load-balance per-packet set routing-options forwarding-table export pplb set routing-options router-id 10.1.1.4 set routing-options autonomous-system 65001 set protocols isis level 1 disable set protocols isis interface ge-0/0/1.0 set protocols isis export allow-lo0 set protocols isis topologies ipv6-unicast set protocols rsvp interface ge-0/0/1.0 set protocols ldp interface ge-0/0/1.0 set protocols mpls label-switched-path toPE2-bronze to 10.1.1.1 set protocols mpls label-switched-path toPE3-bronze to 10.1.1.2 set protocols mpls interface ge-0/0/1.0 set protocols bgp path-selection external-router-id set protocols bgp group toAs2-T family inet labeled-unicast rib inet.3 set protocols bgp group toAs2-T peer-as 2 set protocols bgp group toAs2-T neighbor 192.168.0.26 set protocols bgp group toAs2-T neighbor 192.168.0.24 set protocols bgp group toAs1RR type internal set protocols bgp group toAs1RR local-address 10.1.1.4 set protocols bgp group toAs1RR advertise-external set protocols bgp group toAs1RR family inet labeled-unicast rib inet.3 set protocols bgp group toAs1RR export nhs set protocols bgp group toAs1RR neighbor 10.1.1.6 set protocols bgp traceoptions file bgp.log set protocols bgp traceoptions file size 100m set protocols bgp traceoptions flag state detail set protocols bgp traceoptions flag policy
Appareil RR3
set interfaces ge-0/0/2 description RR3-to-P3 set interfaces ge-0/0/2 vlan-tagging set interfaces ge-0/0/2 unit 0 vlan-id 100 set interfaces ge-0/0/2 unit 0 family inet address 192.168.0.35/31 set interfaces ge-0/0/2 unit 0 family iso set interfaces ge-0/0/2 unit 0 family mpls set interfaces lo0 unit 1 family inet address 10.1.1.6/32 set interfaces lo0 unit 1 family iso address 49.0000.0000.aaaa.0006.00 set policy-options policy-statement add-noexport term 1 then community add noexport set policy-options policy-statement allow-lo0 term 1 from interface lo0.1 set policy-options policy-statement allow-lo0 term 1 then accept set policy-options policy-statement allow-lo0 term 2 then reject set policy-options policy-statement export-inet3 term 1 from rib inet.3 set policy-options policy-statement export-inet3 term 1 then accept set policy-options policy-statement export-inet3 term 2 then reject set policy-options policy-statement pplb then load-balance per-packet set policy-options community noexport members no-export set policy-options community noexport members no-advertise set routing-options forwarding-table export pplb set routing-options interface-routes rib-group inet inet0to3 set routing-options router-id 10.1.1.6 set routing-options autonomous-system 1 set routing-options rib-groups inet0to3 import-rib inet.0 set routing-options rib-groups inet0to3 import-rib inet.3 set routing-options rib-groups inet0to3 import-policy allow-lo0 set routing-options rib-groups inet3to0 import-rib inet.3 set routing-options rib-groups inet3to0 import-rib inet.0 set routing-options rib-groups inet3to0 import-policy add-noexport set protocols isis level 1 disable set protocols isis interface all set protocols isis export allow-lo0 set protocols isis topologies ipv6-unicast set protocols rsvp interface all set protocols ldp interface all set protocols mpls interface all set protocols bgp path-selection external-router-id set protocols bgp group toAs1BNs type internal set protocols bgp group toAs1BNs family inet labeled-unicast rib-group inet3to0 set protocols bgp group toAs1BNs family inet labeled-unicast add-path receive set protocols bgp group toAs1BNs family inet labeled-unicast add-path send path-count 4 set protocols bgp group toAs1BNs family inet labeled-unicast rib inet.3 set protocols bgp group toAs1BNs export export-inet3 set protocols bgp group toAs1BNs neighbor 10.1.1.3 set protocols bgp group toAs1BNs neighbor 10.1.1.4 set protocols bgp group toAs1BNs neighbor 10.1.1.2 set protocols bgp group toAs1BNs neighbor 10.1.1.1 set protocols bgp traceoptions file bgp.log set protocols bgp traceoptions file size 100m set protocols bgp traceoptions flag state detail set protocols bgp traceoptions flag policy set protocols bgp local-address 10.1.1.6 set protocols bgp cluster 10.1.1.6
Appareil P3
set interfaces ge-0/0/1 description P3-to-ASBR4 set interfaces ge-0/0/1 vlan-tagging set interfaces ge-0/0/1 unit 0 vlan-id 100 set interfaces ge-0/0/1 unit 0 family inet address 192.168.0.33/31 set interfaces ge-0/0/1 unit 0 family iso set interfaces ge-0/0/1 unit 0 family mpls set interfaces ge-0/0/2 description P3-to-RR3 set interfaces ge-0/0/2 vlan-tagging set interfaces ge-0/0/2 unit 0 vlan-id 100 set interfaces ge-0/0/2 unit 0 family inet address 192.168.0.34/31 set interfaces ge-0/0/2 unit 0 family iso set interfaces ge-0/0/2 unit 0 family mpls set interfaces ge-0/0/3 description P3-to-PE2 set interfaces ge-0/0/3 vlan-tagging set interfaces ge-0/0/3 unit 0 vlan-id 100 set interfaces ge-0/0/3 unit 0 family inet address 192.168.0.36/31 set interfaces ge-0/0/3 unit 0 family iso set interfaces ge-0/0/3 unit 0 family mpls set interfaces ge-0/0/4 description P3-to-ASBR3 set interfaces ge-0/0/4 vlan-tagging set interfaces ge-0/0/4 unit 0 vlan-id 100 set interfaces ge-0/0/4 unit 0 family inet address 192.168.0.31/31 set interfaces ge-0/0/4 unit 0 family iso set interfaces ge-0/0/4 unit 0 family mpls set interfaces ge-0/0/5 description P3-to-PE3 set interfaces ge-0/0/5 vlan-tagging set interfaces ge-0/0/5 unit 0 vlan-id 100 set interfaces ge-0/0/5 unit 0 family inet address 192.168.0.38/31 set interfaces ge-0/0/5 unit 0 family iso set interfaces ge-0/0/5 unit 0 family mpls set interfaces lo0 unit 0 family inet address 10.1.1.5/32 set interfaces lo0 unit 0 family iso address 49.0000.0000.aaaa.0005.00 set policy-options policy-statement allow-lo0 term 1 from interface lo0.0 set policy-options policy-statement allow-lo0 term 1 then accept set policy-options policy-statement allow-lo0 term 2 then reject set routing-options router-id 10.1.1.5 set protocols isis level 1 disable set protocols isis interface all set protocols isis export allow-lo0 set protocols isis topologies ipv6-unicast set protocols rsvp interface all set protocols ldp interface all set protocols mpls interface all
Équipement PE2
set interfaces ge-0/0/1 description PE2-to-CE2-Link1 set interfaces ge-0/0/1 vlan-tagging set interfaces ge-0/0/1 unit 0 vlan-id 100 set interfaces ge-0/0/1 unit 0 family inet address 192.168.0.40/31 set interfaces ge-0/0/2 description PE2-to-CE2-Link2 set interfaces ge-0/0/2 vlan-tagging set interfaces ge-0/0/2 unit 0 vlan-id 100 set interfaces ge-0/0/2 unit 0 family inet address 192.168.0.42/31 set interfaces ge-0/0/3 description PE2-to-P3 set interfaces ge-0/0/3 vlan-tagging set interfaces ge-0/0/3 unit 0 vlan-id 100 set interfaces ge-0/0/3 unit 0 family inet address 192.168.0.37/31 set interfaces ge-0/0/3 unit 0 family iso set interfaces ge-0/0/3 unit 0 family mpls set interfaces lo0 unit 1 family inet address 10.1.1.1/32 set interfaces lo0 unit 1 family iso address 49.0000.0000.aaaa.0001.00 set policy-options policy-statement add-noexport term 1 then community add noexport set policy-options policy-statement allow-lo0 term 1 from interface lo0.1 set policy-options policy-statement allow-lo0 term 1 then accept set policy-options policy-statement allow-lo0 term 2 then reject set policy-options policy-statement export-inet3 term 1 from rib inet.3 set policy-options policy-statement export-inet3 term 1 then accept set policy-options policy-statement export-inet3 term 2 then reject set policy-options policy-statement nhs term 1 from protocol bgp set policy-options policy-statement nhs term 1 then metric add 0 set policy-options policy-statement nhs term 1 then local-preference 200 set policy-options policy-statement nhs term 1 then next-hop self set policy-options policy-statement nhs term 1 then accept set policy-options policy-statement pplb then load-balance per-packet set policy-options policy-statement vrf-export-red term 1 then community add leak2red set policy-options policy-statement vrf-export-red term 1 then accept set policy-options policy-statement vrf-import-red term 1 from community leak2red set policy-options policy-statement vrf-import-red term 1 then accept set policy-options community leak2red members target:100:100 set policy-options community noexport members no-export set policy-options community noexport members no-advertise set routing-instances red protocols bgp group toCE2 peer-as 65003 set routing-instances red protocols bgp group toCE2 neighbor 192.168.0.43 set routing-instances red instance-type vrf set routing-instances red interface ge-0/0/2.0 set routing-instances red vrf-import vrf-import-red set routing-instances red vrf-export vrf-export-red set routing-options route-distinguisher-id 10.1.1.1 set routing-options forwarding-table export pplb set routing-options interface-routes rib-group inet inet0to3 set routing-options router-id 10.1.1.1 set routing-options autonomous-system 1 set routing-options rib-groups inet0to3 import-rib inet.0 set routing-options rib-groups inet0to3 import-rib inet.3 set routing-options rib-groups inet0to3 import-policy allow-lo0 set routing-options rib-groups inet3to0 import-rib inet.3 set routing-options rib-groups inet3to0 import-rib inet.0 set routing-options rib-groups inet3to0 import-policy add-noexport set protocols isis level 1 disable set protocols isis interface ge-0/0/3.0 set protocols isis export allow-lo0 set protocols isis topologies ipv6-unicast set protocols rsvp interface ge-0/0/3.0 set protocols ldp interface ge-0/0/3.0 set protocols mpls interface ge-0/0/3.0 set protocols bgp path-selection external-router-id set protocols bgp group toAs3-1 peer-as 65003 set protocols bgp group toAs3-1 neighbor 192.168.0.41 set protocols bgp group toAs1RR type internal set protocols bgp group toAs1RR local-address 10.1.1.1 set protocols bgp group toAs1RR advertise-external set protocols bgp group toAs1RR family inet labeled-unicast rib-group inet3to0 set protocols bgp group toAs1RR family inet labeled-unicast add-path receive set protocols bgp group toAs1RR family inet labeled-unicast add-path send path-count 4 set protocols bgp group toAs1RR family inet labeled-unicast rib inet.3 set protocols bgp group toAs1RR family inet6-vpn unicast set protocols bgp group toAs1RR export nhs set protocols bgp group toAs1RR export export-inet3 set protocols bgp group toAs1RR neighbor 10.1.1.6 set protocols bgp group toAs2PEs multihop no-nexthop-change set protocols bgp group toAs2PEs local-address 10.1.1.1 set protocols bgp group toAs2PEs family inet unicast set protocols bgp group toAs2PEs family inet-vpn unicast set protocols bgp group toAs2PEs family inet6 unicast set protocols bgp group toAs2PEs family inet6-vpn unicast set protocols bgp group toAs2PEs export nhs set protocols bgp group toAs2PEs peer-as 65002 set protocols bgp group toAs2PEs neighbor 10.2.2.5 set protocols bgp group toAs2PEs vpn-apply-export set protocols bgp traceoptions file bgp.log set protocols bgp traceoptions file size 100m set protocols bgp traceoptions flag state detail set protocols bgp traceoptions flag policy
Équipement PE3
set interfaces ge-0/0/3 description PE3-to-CE2-Link1 set interfaces ge-0/0/3 vlan-tagging set interfaces ge-0/0/3 unit 0 vlan-id 100 set interfaces ge-0/0/3 unit 0 family inet address 192.168.0.44/31 set interfaces ge-0/0/4 description PE3-to-CE2-Link2 set interfaces ge-0/0/4 vlan-tagging set interfaces ge-0/0/4 unit 0 vlan-id 100 set interfaces ge-0/0/4 unit 0 family inet address 192.168.0.46/31 set interfaces ge-0/0/5 description PE3-to-P3 set interfaces ge-0/0/5 vlan-tagging set interfaces ge-0/0/5 unit 0 vlan-id 100 set interfaces ge-0/0/5 unit 0 family inet address 192.168.0.39/31 set interfaces ge-0/0/5 unit 0 family iso set interfaces ge-0/0/5 unit 0 family mpls set interfaces lo0 unit 1 family inet address 10.1.1.2/32 set interfaces lo0 unit 1 family iso address 49.0000.0000.aaaa.0002.00 set policy-options policy-statement add-noexport term 1 then community add noexport set policy-options policy-statement allow-lo0 term 1 from interface lo0.1 set policy-options policy-statement allow-lo0 term 1 then accept set policy-options policy-statement allow-lo0 term 2 then reject set policy-options policy-statement export-inet3 term 1 from rib inet.3 set policy-options policy-statement export-inet3 term 1 then accept set policy-options policy-statement export-inet3 term 2 then reject set policy-options policy-statement nhs term 1 from protocol bgp set policy-options policy-statement nhs term 1 then metric add 0 set policy-options policy-statement nhs term 1 then local-preference 200 set policy-options policy-statement nhs term 1 then next-hop self set policy-options policy-statement nhs term 1 then accept set policy-options policy-statement pplb then load-balance per-packet set policy-options policy-statement vrf-export-red term 1 then community add leak2red set policy-options policy-statement vrf-export-red term 1 then accept set policy-options policy-statement vrf-import-red term 1 from community leak2red set policy-options policy-statement vrf-import-red term 1 then accept set policy-options community leak2red members target:100:100 set policy-options community noexport members no-export set policy-options community noexport members no-advertise set routing-instances red protocols bgp group toCE2 peer-as 65003 set routing-instances red protocols bgp group toCE2 neighbor 192.168.0.47 set routing-instances red instance-type vrf set routing-instances red interface ge-0/0/4.0 set routing-instances red vrf-import vrf-import-red set routing-instances red vrf-export vrf-export-red set routing-options route-distinguisher-id 10.1.1.2 set routing-options forwarding-table export pplb set routing-options interface-routes rib-group inet inet0to3 set routing-options router-id 10.1.1.2 set routing-options autonomous-system 1 set routing-options rib-groups inet0to3 import-rib inet.0 set routing-options rib-groups inet0to3 import-rib inet.3 set routing-options rib-groups inet0to3 import-policy allow-lo0 set routing-options rib-groups inet3to0 import-rib inet.3 set routing-options rib-groups inet3to0 import-rib inet.0 set routing-options rib-groups inet3to0 import-policy add-noexport set protocols isis level 1 disable set protocols isis interface ge-0/0/5.0 set protocols isis export allow-lo0 set protocols isis topologies ipv6-unicast set protocols rsvp interface ge-0/0/5.0 set protocols ldp interface ge-0/0/5.0 set protocols mpls interface ge-0/0/5.0 set protocols bgp path-selection external-router-id set protocols bgp group toAs3 peer-as 65003 set protocols bgp group toAs3 neighbor 192.168.0.45 set protocols bgp group toAs1RR type internal set protocols bgp group toAs1RR local-address 10.1.1.2 set protocols bgp group toAs1RR advertise-external set protocols bgp group toAs1RR family inet labeled-unicast rib-group inet3to0 set protocols bgp group toAs1RR family inet labeled-unicast rib inet.3 set protocols bgp group toAs1RR export nhs set protocols bgp group toAs1RR export export-inet3 set protocols bgp group toAs1RR neighbor 10.1.1.6 set protocols bgp group toAs2PEs multihop no-nexthop-change set protocols bgp group toAs2PEs local-address 10.1.1.2 set protocols bgp group toAs2PEs family inet unicast set protocols bgp group toAs2PEs family inet-vpn unicast set protocols bgp group toAs2PEs family inet6 unicast set protocols bgp group toAs2PEs family inet6-vpn unicast set protocols bgp group toAs2PEs export nhs set protocols bgp group toAs2PEs peer-as 65002 set protocols bgp group toAs2PEs neighbor 10.2.2.5 set protocols bgp group toAs2PEs vpn-apply-export set protocols bgp traceoptions file bgp.log set protocols bgp traceoptions file size 100m set protocols bgp traceoptions flag state detail set protocols bgp traceoptions flag policy
Appareil CE2
set interfaces ge-0/0/1 description CE2-to-PE2-Link1 set interfaces ge-0/0/1 vlan-tagging set interfaces ge-0/0/1 unit 0 vlan-id 100 set interfaces ge-0/0/1 unit 0 family inet address 192.168.0.41/31 set interfaces ge-0/0/2 description CE2-to-PE2-Link2 set interfaces ge-0/0/2 vlan-tagging set interfaces ge-0/0/2 unit 0 vlan-id 100 set interfaces ge-0/0/2 unit 0 family inet address 192.168.0.43/31 set interfaces ge-0/0/3 description CE2-to-PE3-Link1 set interfaces ge-0/0/3 vlan-tagging set interfaces ge-0/0/3 unit 0 vlan-id 100 set interfaces ge-0/0/3 unit 0 family inet address 192.168.0.45/31 set interfaces ge-0/0/4 description CE2-to-PE3-Link2 set interfaces ge-0/0/4 vlan-tagging set interfaces ge-0/0/4 unit 0 vlan-id 100 set interfaces ge-0/0/4 unit 0 family inet address 192.168.0.47/31 set interfaces lo0 unit 0 family inet address 10.3.3.3/32 set policy-options policy-statement nhs term 1 from interface lo0.0 set policy-options policy-statement nhs term 1 then metric 50 set policy-options policy-statement nhs term 1 then next-hop self set policy-options policy-statement nhs term 1 then accept set policy-options policy-statement nhsMED100 term 1 from interface lo0.0 set policy-options policy-statement nhsMED100 term 1 then metric 100 set policy-options policy-statement nhsMED100 term 1 then next-hop self set policy-options policy-statement nhsMED100 term 1 then accept set policy-options community map2bronze members 100:200 set policy-options community map2gold members 100:100 set policy-options community map2gold_bronze_plain members 300:400 set routing-options router-id 10.3.3.3 set routing-options autonomous-system 65003 set protocols bgp path-selection external-router-id set protocols bgp group toAs1Internet export nhs set protocols bgp group toAs1Internet peer-as 65001 set protocols bgp group toAs1Internet neighbor 192.168.0.40 set protocols bgp group toAs1Internet neighbor 192.168.0.44 export nhsMED100 set protocols bgp group toAs1L3VPN export nhs set protocols bgp group toAs1L3VPN peer-as 65001 set protocols bgp group toAs1L3VPN neighbor 192.168.0.46 set protocols bgp group toAs1L3VPN neighbor 192.168.0.42 export nhsMED100
Configuration de CE1
Procédure étape par étape
L’exemple suivant vous oblige à naviguer à différents niveaux dans la hiérarchie de configuration. Pour plus d’informations sur la navigation dans la CLI, consultez Utilisation de l’éditeur CLI en mode configuration dans le Guide de l’utilisateur de la CLI.
Pour configurer l’équipement CE1 :
-
Configurez les interfaces pour activer le transport IP et MPLS.
[edit interfaces] user@CE1#set ge-0/0/1 description CE1-to-PE1-Link1 user@CE1#set ge-0/0/1 vlan-tagging user@CE1#set ge-0/0/1 unit 0 vlan-id 100 user@CE1#set ge-0/0/1 unit 0 family inet address 192.168.0.0/31 user@CE1#set ge-0/0/2 description CE1-to-PE1-Link2 user@CE1#set ge-0/0/2 vlan-tagging user@CE1#set ge-0/0/2 unit 0 vlan-id 100 user@CE1#set ge-0/0/2 unit 0 family inet address 192.168.0.2/31
-
Configurez l’interface de bouclage à utiliser comme ID de routeur et interface de terminaison pour les sessions LDP et BGP.
[edit interfaces] user@CE1#set lo0 unit 0 family inet address 10.4.4.4/32
-
Configurez les stratégies de résolution de chemins multiples pour installer des chemins multiples hiérarchiques dans PFE.
[edit policy-options] user@CE1#set policy-statement nhs term 1 from interface lo0.0 user@CE1#set policy-statement nhs term 1 then next-hop self user@CE1#set policy-statement nhs term 1 then accept
-
Configurez les options de routage.
[edit routing-options] user@CE1#set router-id 10.4.4.4 user@CE1#set autonomous-system 65004
-
Configurez l’unicast étiqueté BGP en ABR pour échanger des adresses IP de bouclage en tant que préfixes de unicast étiquetés BGP.
[edit protocols bgp] user@CE1#set path-selection external-router-id user@CE1#set group toAs2 export nhs user@CE1#set group toAs2 peer-as 65002 user@CE1#set group toAs2 neighbor 192.168.0.1 user@CE1#set group toAs2 neighbor 192.168.0.3
Résultats
En mode configuration, confirmez votre configuration en entrant les show interfacescommandes , show policy-optionsshow routing-options, , et show protocols . Si la sortie n’affiche pas la configuration prévue, répétez les instructions de cet exemple pour corriger la configuration.
interfaces {
ge-0/0/1 {
description CE1-to-PE1-Link1;
vlan-tagging;
unit 0 {
vlan-id 100;
family inet {
address 192.168.0.0/31;
}
}
}
ge-0/0/2 {
description CE1-to-PE1-Link2;
vlan-tagging;
unit 0 {
vlan-id 100;
family inet {
address 192.168.0.2/31;
}
}
}
lo0 {
unit 0 {
family inet {
address 10.4.4.4/32;
}
}
}
}
policy-options {
policy-statement nhs {
term 1 {
from interface lo0.0;
then {
next-hop self;
accept;
}
}
}
}
routing-options {
router-id 10.4.4.4;
autonomous-system 65004;
}
protocols {
bgp {
path-selection external-router-id;
group toAs2 {
export nhs;
peer-as 65002;
neighbor 192.168.0.1;
neighbor 192.168.0.3;
}
}
}
Configuration de PE1
Procédure étape par étape
L’exemple suivant vous oblige à naviguer à différents niveaux dans la hiérarchie de configuration. Pour plus d’informations sur la navigation dans la CLI, consultez Utilisation de l’éditeur CLI en mode configuration dans le Guide de l’utilisateur de la CLI.
Pour configurer l’appareil PE1 :
-
Configurez les interfaces pour activer le transport IP et MPLS.
[edit interfaces] user@PE1#set ge-0/0/1 description PE1-to-CE1-Link1 user@PE1#set ge-0/0/1 vlan-tagging user@PE1#set ge-0/0/1 unit 0 vlan-id 100 user@PE1#set ge-0/0/1 unit 0 family inet address 192.168.0.1/31 user@PE1#set ge-0/0/2 description PE1-to-CE1-Link2 user@PE1#set ge-0/0/2 vlan-tagging user@PE1#set ge-0/0/2 unit 0 vlan-id 100 user@PE1#set ge-0/0/2 unit 0 family inet address 192.168.0.3/31 user@PE1#set ge-0/0/3 description PE1-to-P1 user@PE1#set ge-0/0/3 vlan-tagging user@PE1#set ge-0/0/3 unit 0 vlan-id 100 user@PE1#set ge-0/0/3 unit 0 family inet address 192.168.0.4/31 user@PE1#set ge-0/0/3 unit 0 family iso user@PE1#set ge-0/0/3 unit 0 family mpls
-
Configurez l’interface de bouclage à utiliser comme ID de routeur et interface de terminaison pour les sessions LDP et BGP.
[edit interfaces] user@PE1#set lo0 unit 1 family inet address 10.2.2.5/32 user@PE1#set lo0 unit 1 family iso address 49.0000.0000.aaaa.0005.00
-
Configurez les stratégies de résolution de chemins multiples pour installer des chemins multiples hiérarchiques dans PFE.
[edit policy-options] user@PE1#set policy-statement add-noexport term 1 then community add noexport user@PE1#set policy-statement allow-lo0 term 1 from interface lo0.1 user@PE1#set policy-statement allow-lo0 term 1 then accept user@PE1#set policy-statement allow-lo0 term 2 then reject user@PE1#set policy-statement export-inet3 term 1 from rib inet.3 user@PE1#set policy-statement export-inet3 term 1 then accept user@PE1#set policy-statement export-inet3 term 2 then reject user@PE1#set policy-statement mp-resolv term 1 from route-filter 10.1.1.0/24 orlonger user@PE1#set policy-statement mp-resolv term 1 then accept user@PE1#set policy-statement mp-resolv term 1 then multipath-resolve user@PE1#set policy-statement mp-resolv term 2 from route-filter 10.2.2.0/24 orlonger user@PE1#set policy-statement mp-resolv term 2 then accept user@PE1#set policy-statement mp-resolv term 2 then multipath-resolve user@PE1#set policy-statement mp-resolv term def then reject user@PE1#set policy-statement nhs term 1 from protocol bgp user@PE1#set policy-statement nhs term 1 then local-preference 200 user@PE1#set policy-statement nhs term 1 then next-hop self user@PE1#set policy-statement nhs term 1 then accept user@PE1#set policy-statement pplb then load-balance per-packet user@PE1#set policy-statement vrf-export-red term 1 then community add leak2red user@PE1#set policy-statement vrf-export-red term 1 then accept user@PE1#set policy-statement vrf-import-red term 1 from community leak2red user@PE1#set policy-statement vrf-import-red term 1 then accept user@PE1#set community leak2red members target:100:100 user@PE1#set community noexport members no-export user@PE1#set community noexport members no-advertise
-
Configurez l’instance de routage VPN de couche 3 pour fournir des services client.
[edit routing-instances] user@PE1#set red routing-options multipath preserve-nexthop-hierarchy user@PE1#set red routing-options protect core user@PE1#set red protocols bgp group toCE1 peer-as 65004 user@PE1#set red protocols bgp group toCE1 neighbor 192.168.0.2 user@PE1#set red instance-type vrf user@PE1#set red interface ge-0/0/2.0 user@PE1#set red vrf-import vrf-import-red user@PE1#set red vrf-export vrf-export-red
-
Configurez les stratégies d’importation RIB du résolveur et les RIB de résolution pour permettre une structure nexthop hiérarchique étendue pour les préfixes VPN de couche 3 sélectionnés spécifiés dans la stratégie.
[edit routing-options] user@PE1#set rib inet.3 protect core user@PE1#set route-distinguisher-id 10.2.2.5 user@PE1#set forwarding-table export pplb user@PE1#set resolution preserve-nexthop-hierarchy user@PE1#set resolution rib inet.0 import mp-resolv user@PE1#set interface-routes rib-group inet inet0to3 user@PE1#set router-id 10.2.2.5 user@PE1#set autonomous-system 65002 user@PE1#set protect core user@PE1#set rib-groups inet0to3 import-rib inet.0 user@PE1#set rib-groups inet0to3 import-rib inet.3 user@PE1#set rib-groups inet0to3 import-policy allow-lo0 user@PE1#set rib-groups inet3to0 import-rib inet.3 user@PE1#set rib-groups inet3to0 import-rib inet.0 user@PE1#set rib-groups inet3to0 import-policy add-noexport
-
Configurez le protocole OSPF.
[edit protocols ospf] user@PE1#set protocols ospf area 0.0.0.0 interface all link-protection; user@PE1#set protocols ospf area 0.0.0.0 interface fxp0.0 disable; user@PE1#set protocols ospf area 0.0.0.0 interface lo0.0 passive;
-
Configurez les protocoles de routage pour établir une connectivité IP et MPLS sur l’ensemble du domaine.
[edit protocols] user@PE1#set isis level 1 disable user@PE1#set isis interface ge-0/0/3.0 user@PE1#set isis export allow-lo0 user@PE1#set isis topologies ipv6-unicast user@PE1#set rsvp interface ge-0/0/3.0 user@PE1#set ldp interface ge-0/0/3.0 user@PE1#set mpls label-switched-path toABR1-gold to 10.2.2.3 user@PE1#set mpls label-switched-path toABR1-bronze to 10.2.2.3 user@PE1#set mpls label-switched-path toABR2-gold to 10.2.2.4
-
Configurez l’unicast étiqueté BGP en ABR pour échanger des adresses IP de bouclage en tant que préfixes de unicast étiquetés BGP.
[edit protocols bgp] user@PE1#set path-selection external-router-id user@PE1#set group toAs2RR type internal user@PE1#set group toAs2RR local-address 10.2.2.5 user@PE1#set group toAs2RR family inet labeled-unicast rib-group inet3to0 user@PE1#set group toAs2RR family inet labeled-unicast add-path receive user@PE1#set group toAs2RR family inet labeled-unicast add-path send path-count 4 user@PE1#set group toAs2RR family inet labeled-unicast nexthop-resolution preserve-nexthop-hierarchy user@PE1#set group toAs2RR family inet labeled-unicast rib inet.3 user@PE1#set group toAs2RR export nhs user@PE1#set group toAs2RR export export-inet3 user@PE1#set group toAs2RR neighbor 10.2.2.6 user@PE1#set group toAs4 peer-as 65004 user@PE1#set group toAs4 neighbor 192.168.0.0 user@PE1#set group toAs1PEs multihop no-nexthop-change user@PE1#set group toAs1PEs local-address 10.2.2.5 user@PE1#set group toAs1PEs family inet unicast user@PE1#set group toAs1PEs family inet-vpn unicast user@PE1#set group toAs1PEs family inet6 unicast user@PE1#set group toAs1PEs family inet6-vpn unicast user@PE1#set group toAs1PEs export nhs user@PE1#set group toAs1PEs peer-as 65001 user@PE1#set group toAs1PEs neighbor 10.1.1.1 user@PE1#set group toAs1PEs neighbor 10 .1.1.2 user@PE1#set traceoptions file bgp.log user@PE1#set traceoptions file size 100m user@PE1#set traceoptions flag state detail user@PE1#set traceoptions flag policy user@PE1#set multipath
Résultats
En mode configuration, confirmez votre configuration en entrant les show chassiscommandes , , show interfacesshow policy-options, show routing-instancesshow routing-options, et show protocols . Si la sortie n’affiche pas la configuration prévue, répétez les instructions de cet exemple pour corriger la configuration.
interfaces {
ge-0/0/1 {
description PE1-to-CE1-Link1;
vlan-tagging;
unit 0 {
vlan-id 100;
family inet {
address 192.168.0.1/31;
}
}
}
ge-0/0/2 {
description PE1-to-CE1-Link2;
vlan-tagging;
unit 0 {
vlan-id 100;
family inet {
address 192.168.0.3/31;
}
}
}
ge-0/0/3 {
description PE1-to-P1;
vlan-tagging;
unit 0 {
vlan-id 100;
family inet {
address 192.168.0.4/31;
}
family iso;
family mpls;
}
}
lo0 {
unit 1 {
family inet {
address 10.2.2.5/32;
}
family iso {
address 49.0000.0000.aaaa.0005.00;
}
}
}
}
policy-options {
policy-statement add-noexport {
term 1 {
then {
community add noexport;
}
}
}
policy-statement allow-lo0 {
term 1 {
from interface lo0.1;
then accept;
}
term 2 {
then reject;
}
}
policy-statement export-inet3 {
term 1 {
from rib inet.3;
then accept;
}
term 2 {
then reject;
}
}
policy-statement mp-resolv {
term 1 {
from {
route-filter 10.1.1.0/24 orlonger;
}
then {
accept;
multipath-resolve;
}
}
term 2 {
from {
route-filter 10.2.2.0/24 orlonger;
}
then {
accept;
multipath-resolve;
}
}
term def {
then reject;
}
}
policy-statement nhs {
term 1 {
from protocol bgp;
then {
local-preference 200;
next-hop self;
accept;
}
}
}
policy-statement pplb {
then {
load-balance per-packet;
}
}
policy-statement vrf-export-red {
term 1 {
then {
community add leak2red;
accept;
}
}
}
policy-statement vrf-import-red {
term 1 {
from community leak2red;
then accept;
}
}
community leak2red members target:100:100;
community noexport members [ no-export no-advertise ];
}
routing-instances {
red {
routing-options {
multipath preserve-nexthop-hierarchy;
protect core;
}
protocols {
bgp {
group toCE1 {
peer-as 65004;
neighbor 192.168.0.2;
}
}
}
instance-type vrf;
interface ge-0/0/2.0;
vrf-import vrf-import-red;
vrf-export vrf-export-red;
}
}
routing-options {
rib inet.3 {
protect core;
}
route-distinguisher-id 10.2.2.5;
forwarding-table {
export pplb;
}
resolution {
preserve-nexthop-hierarchy;
rib inet.0 {
import mp-resolv;
}
}
interface-routes {
rib-group inet inet0to3;
}
router-id 10.2.2.5;
autonomous-system 65002;
protect core;
rib-groups {
inet0to3 {
import-rib [ inet.0 inet.3 ];
import-policy allow-lo0;
}
inet3to0 {
import-rib [ inet.3 inet.0 ];
import-policy add-noexport;
}
}
}
protocols {
isis {
level 1 disable;
interface ge-0/0/3.0;
export allow-lo0;
topologies ipv6-unicast;
}
rsvp {
interface ge-0/0/3.0;
}
bgp {
path-selection external-router-id;
group toAs2RR {
type internal;
local-address 10.2.2.5;
family inet {
labeled-unicast {
rib-group inet3to0;
add-path {
receive;
send {
path-count 4;
}
}
nexthop-resolution {
preserve-nexthop-hierarchy;
}
rib {
inet.3;
}
}
}
export [ nhs export-inet3 ];
neighbor 10.2.2.6;
}
group toAs4 {
peer-as 65004;
neighbor 192.168.0.0;
}
group toAs1PEs {
multihop {
no-nexthop-change;
}
local-address 10.2.2.5;
family inet {
unicast;
}
family inet-vpn {
unicast;
}
family inet6 {
unicast;
}
family inet6-vpn {
unicast;
}
export nhs;
peer-as 65001;
neighbor 10.1.1.1;
neighbor 10.1.1.2;
}
traceoptions {
file bgp.log size 100m;
flag state detail;
flag policy;
}
multipath;
}
ldp {
interface ge-0/0/3.0;
}
mpls {
label-switched-path toABR1-gold {
to 10.2.2.3;
}
label-switched-path toABR1-bronze {
to 10.2.2.3;
}
label-switched-path toABR2-gold {
to 10.2.2.4;
}
}
}
Configuration de l’équipement P1
Procédure étape par étape
L’exemple suivant vous oblige à naviguer à différents niveaux dans la hiérarchie de configuration. Pour plus d’informations sur la navigation dans la CLI, consultez Utilisation de l’éditeur CLI en mode configuration dans le Guide de l’utilisateur de la CLI.
Pour configurer l’appareil P1 :
-
Configurez les interfaces.
[edit interfaces] user@P1#set ge-0/0/1 description P1-to-RR1 user@P1#set ge-0/0/1 vlan-tagging user@P1#set ge-0/0/1 unit 0 vlan-id 100 user@P1#set ge-0/0/1 unit 0 family inet address 192.168.0.6/31 user@P1#set ge-0/0/1 unit 0 family iso user@P1#set ge-0/0/1 unit 0 family mpls user@P1#set ge-0/0/2 description P1-to-ABR1 user@P1#set ge-0/0/2 vlan-tagging user@P1#set ge-0/0/2 unit 0 vlan-id 100 user@P1#set ge-0/0/2 unit 0 family inet address 192.168.0.8/31 user@P1#set ge-0/0/2 unit 0 family iso user@P1#set ge-0/0/2 unit 0 family mpls user@P1#set ge-0/0/3 description P1-to-PE1 user@P1#set ge-0/0/3 vlan-tagging user@P1#set ge-0/0/3 unit 0 vlan-id 100 user@P1#set ge-0/0/3 unit 0 family inet address 192.168.0.5/31 user@P1#set ge-0/0/3 unit 0 family iso user@P1#set ge-0/0/3 unit 0 family mpls user@P1#set ge-0/0/4 description P1-to-ABR2 user@P1#set ge-0/0/4 vlan-tagging user@P1#set ge-0/0/4 unit 0 vlan-id 100 user@P1#set ge-0/0/4 unit 0 family inet address 192.168.0.10/31 user@P1#set ge-0/0/4 unit 0 family iso user@P1#set ge-0/0/4 unit 0 family mpls
-
Configurez l’interface de bouclage.
[edit interfaces] user@P1#set lo0 unit 0 family inet address 10.2.2.8/32 user@P1#set lo0 unit 0 family iso address 49.0000.0000.aaaa.0008.00
-
Configurez les stratégies de résolution de chemins multiples pour installer des chemins multiples hiérarchiques dans PFE.
[edit policy-options] user@P1#set policy-statement allow-lo0 term 1 from interface lo0.0 user@P1#set policy-statement allow-lo0 term 1 then accept user@P1#set policy-statement allow-lo0 term 2 then reject
-
Configurez les options de routage.
[edit routing-options] user@P1#set router-id 10.2.2.8
-
Configurez les protocoles ISIS, RSVP, LDP et MPLS sur l’interface.
[edit protocols] user@P1#set isis level 1 disable user@P1#set isis interface all user@P1#set isis export allow-lo0 user@P1#set isis topologies ipv6-unicast user@P1#set rsvp interface all user@P1#set ldp interface all user@P1#set mpls interface all
Résultats
En mode configuration, confirmez votre configuration en entrant les show interfacescommandes , show policy-optionset . show protocols Si la sortie n’affiche pas la configuration prévue, répétez les instructions de cet exemple pour corriger la configuration.
interfaces {
ge-0/0/1 {
description P1-to-RR1;
vlan-tagging;
unit 0 {
vlan-id 100;
family inet {
address 192.168.0.6/31;
}
family iso;
family mpls;
}
}
ge-0/0/2 {
description P1-to-ABR1;
vlan-tagging;
unit 0 {
vlan-id 100;
family inet {
address 192.168.0.8/31;
}
family iso;
family mpls;
}
}
ge-0/0/3 {
description P1-to-PE1;
vlan-tagging;
unit 0 {
vlan-id 100;
family inet {
address 192.168.0.5/31;
}
family iso;
family mpls;
}
}
ge-0/0/4 {
description P1-to-ABR2;
vlan-tagging;
unit 0 {
vlan-id 100;
family inet {
address 192.168.0.10/31;
}
family iso;
family mpls;
}
}
lo0 {
unit 0 {
family inet {
address 10.2.2.8/32;
}
family iso {
address 49.0000.0000.aaaa.0008.00;
}
}
}
}
policy-options {
policy-statement allow-lo0 {
term 1 {
from interface lo0.0;
then accept;
}
term 2 {
then reject;
}
}
}
routing-options {
router-id 10.2.2.8;
}
protocols {
isis {
level 1 disable;
interface all;
export allow-lo0;
topologies ipv6-unicast;
}
rsvp {
interface all;
}
ldp {
interface all;
}
mpls {
interface all;
}
}
Configuration du périphérique RR1
Procédure étape par étape
L’exemple suivant vous oblige à naviguer à différents niveaux dans la hiérarchie de configuration. Pour plus d’informations sur la navigation dans la CLI, consultez Utilisation de l’éditeur CLI en mode configuration dans le Guide de l’utilisateur de la CLI.
Pour configurer l’appareil RR1 :
-
Configurez les interfaces.
[edit interfaces] user@RR1#set ge-0/0/1 description RR1-to-P1 user@RR1#set ge-0/0/1 vlan-tagging user@RR1#set ge-0/0/1 unit 0 vlan-id 100 user@RR1#set ge-0/0/1 unit 0 family inet address 192.168.0.7/31 user@RR1#set ge-0/0/1 unit 0 family iso user@RR1#set ge-0/0/1 unit 0 family mpls
-
Configurez l’interface de bouclage.
[edit interfaces] user@RR1#set lo0 unit 1 family inet address 10.2.2.6/32 user@RR1#set lo0 unit 1 family iso address 49.0000.0000.aaaa.0006.00
-
Configurez les stratégies de résolution de chemins multiples pour installer des chemins multiples hiérarchiques dans PFE.
[edit policy-options] user@RR1#set policy-statement add-noexport term 1 then community add noexport user@RR1#set policy-statement allow-lo0 term 1 from interface lo0.1 user@RR1#set policy-statement allow-lo0 term 1 then accept user@RR1#set policy-statement allow-lo0 term 2 then reject user@RR1#set policy-statement export-inet3 term 1 from rib inet.3 user@RR1#set policy-statement export-inet3 term 1 then accept user@RR1#set policy-statement export-inet3 term 2 then reject user@RR1#set policy-statement pplb then load-balance per-packet user@RR1#set community noexport members no-export user@RR1#set community noexport members no-advertise
-
Configurez les options de routage.
[edit routing-options] user@RR1#set forwarding-table export pplb user@RR1#set interface-routes rib-group inet inet0to3 user@RR1#set router-id 10.2.2.6 user@RR1#set autonomous-system 2 user@RR1#set rib-groups inet0to3 import-rib inet.0 user@RR1#set rib-groups inet0to3 import-rib inet.3 user@RR1#set rib-groups inet0to3 import-policy allow-lo0 user@RR1#set rib-groups inet3to0 import-rib inet.3 user@RR1#set rib-groups inet3to0 import-rib inet.0 user@RR1#set rib-groups inet3to0 import-rib inet6.3 user@RR1#set rib-groups inet3to0 import-policy add-noexport
-
Configurez les protocoles ISIS, RSVP, LDP et MPLS sur l’interface.
[edit protocols] user@RR1#set isis level 1 disable user@RR1#set isis interface all user@RR1#set isis export allow-lo0 user@RR1#set isis topologies ipv6-unicast user@RR1#set rsvp interface all user@RR1#set ldp interface all user@RR1#set mpls interface all
-
Configurez BGP unicast étiquetée pour échanger les adresses IP de bouclage comme BGP étiquetées unicast préfixes.
[edit protocols bgp] user@RR1#set path-selection external-router-id user@RR1#set group toAs2Reg2BNs type internal user@RR1#set group toAs2Reg2BNs family inet labeled-unicast rib-group inet3to0 user@RR1#set group toAs2Reg2BNs family inet labeled-unicast add-path receive user@RR1#set group toAs2Reg2BNs family inet labeled-unicast add-path send path-count 4 user@RR1#set group toAs2Reg2BNs family inet labeled-unicast rib inet.3 user@RR1#set group toAs2Reg2BNs export export-inet3 user@RR1#set group toAs2Reg2BNs neighbor 10.2.2.3 user@RR1#set group toAs2Reg2BNs neighbor 10.2.2.4 user@RR1#set group toAs2Reg2BNs neighbor 10.2.2.5 user@RR1#set traceoptions file bgp.log user@RR1#set traceoptions file size 100m user@RR1#set traceoptions flag state detail user@RR1#set traceoptions flag policy user@RR1#set local-address 10.2.2.6 user@RR1#set cluster 10.2.2.6
Résultats
En mode configuration, confirmez votre configuration en entrant les show interfacescommandes , show policy-optionsshow routing-optionset .show protocols Si la sortie n’affiche pas la configuration prévue, répétez les instructions de cet exemple pour corriger la configuration.
interfaces {
ge-0/0/1 {
description RR1-to-P1;
vlan-tagging;
unit 0 {
vlan-id 100;
family inet {
address 192.168.0.7/31;
}
family iso;
family mpls;
}
}
lo0 {
unit 1 {
family inet {
address 10.2.2.6/32;
}
family iso {
address 49.0000.0000.aaaa.0006.00;
}
}
}
}
policy-options {
policy-statement add-noexport {
term 1 {
then {
community add noexport;
}
}
}
policy-statement allow-lo0 {
term 1 {
from interface lo0.1;
then accept;
}
term 2 {
then reject;
}
}
policy-statement export-inet3 {
term 1 {
from rib inet.3;
then accept;
}
term 2 {
then reject;
}
}
policy-statement pplb {
then {
load-balance per-packet;
}
}
community noexport members [ no-export no-advertise ];
}
routing-options {
forwarding-table {
export pplb;
}
interface-routes {
rib-group inet inet0to3;
}
router-id 10.2.2.6;
autonomous-system 2;
rib-groups {
inet0to3 {
import-rib [ inet.0 inet.3 ];
import-policy allow-lo0;
}
inet3to0 {
import-rib [ inet.3 inet.0 inet6.3 ];
import-policy add-noexport;
}
}
}
protocols {
isis {
level 1 disable;
interface all;
export allow-lo0;
topologies ipv6-unicast;
}
rsvp {
interface all;
}
bgp {
path-selection external-router-id;
group toAs2Reg2BNs {
type internal;
family inet {
labeled-unicast {
rib-group inet3to0;
add-path {
receive;
send {
path-count 4;
}
}
rib {
inet.3;
}
}
}
export export-inet3;
neighbor 10.2.2.3;
neighbor 10.2.2.4;
neighbor 10.2.2.5;
}
traceoptions {
file bgp.log size 100m;
flag state detail;
flag policy;
}
local-address 10.2.2.6;
cluster 10.2.2.6;
}
ldp {
interface all;
}
mpls {
interface all;
}
}
Configuration de l’équipement ABR1
Procédure étape par étape
L’exemple suivant vous oblige à naviguer à différents niveaux dans la hiérarchie de configuration. Pour plus d’informations sur la navigation dans la CLI, consultez Utilisation de l’éditeur CLI en mode configuration dans le Guide de l’utilisateur de la CLI.
Pour configurer l’appareil ABR1 :
-
Configurez les interfaces pour activer le transport IP et MPLS.
[edit interfaces] user@ABR1#set ge-0/0/1 description ABR1-to-P2 user@ABR1#set ge-0/0/1 vlan-tagging user@ABR1#set ge-0/0/1 unit 0 vlan-id 100 user@ABR1#set ge-0/0/1 unit 0 family inet address 192.168.0.12/31 user@ABR1#set ge-0/0/1 unit 0 family iso user@ABR1#set ge-0/0/1 unit 0 family mpls user@ABR1#set ge-0/0/2 description ABR1-to-P1 user@ABR1#set ge-0/0/2 vlan-tagging user@ABR1#set ge-0/0/2 unit 0 vlan-id 100 user@ABR1#set ge-0/0/2 unit 0 family inet address 192.168.0.9/31 user@ABR1#set ge-0/0/2 unit 0 family iso user@ABR1#set ge-0/0/2 unit 0 family mpls
-
Configurez l’interface de bouclage à utiliser comme ID de routeur et interface de terminaison pour les sessions LDP et BGP.
[edit interfaces] user@ABR1#set lo0 unit 0 family inet address 10.2.2.3/32 user@ABR1#set lo0 unit 0 family iso address 49.0000.0000.aaaa.0003.00
-
Configurez les stratégies de résolution de chemins multiples pour installer des chemins multiples hiérarchiques dans PFE.
[edit policy-options] user@ABR1#set policy-statement allow-lo0 term 1 from interface lo0.0 user@ABR1#set policy-statement allow-lo0 term 1 then accept user@ABR1#set policy-statement allow-lo0 term 2 then reject user@ABR1#set policy-statement nhs term 1 from protocol bgp user@ABR1#set policy-statement nhs term 1 then next-hop self user@ABR1#set policy-statement nhs term 1 then accept user@ABR1#set policy-statement pplb then load-balance per-packet
-
Appliquez une stratégie d’équilibrage de charge par flux pour assurer la protection du trafic.
[edit routing-options] user@ABR1#set forwarding-table export pplb user@ABR1#set router-id 10.2.2.3 user@ABR1#set autonomous-system 65002
-
Configurez les protocoles ISIS, RSVP, MPLS et LDP sur l’interface.
[edit protocols] user@ABR1#set isis level 1 disable user@ABR1#set isis interface all user@ABR1#set isis export allow-lo0 user@ABR1#set isis topologies ipv6-unicast user@ABR1#set rsvp interface all user@ABR1#set ldp interface all user@ABR1#set mpls label-switched-path toASBR2-gold to 10.2.2.2 user@ABR1#set mpls label-switched-path toASBR1-bronze to 10.2.2.1 user@ABR1#set mpls label-switched-path toASBR2-bronze to 10.2.2.2 user@ABR1#set mpls interface all
-
Configurez BGP unicast étiquetée pour échanger les adresses IP de bouclage comme BGP étiquetées unicast préfixes.
[edit protocols] user@ABR1#set bgp group toAs2RR type internal user@ABR1#set bgp group toAs2RR local-address 10.2.2.3 user@ABR1#set bgp group toAs2RR advertise-inactive user@ABR1#set bgp group toAs2RR family inet labeled-unicast add-path receive user@ABR1#set bgp group toAs2RR family inet labeled-unicast add-path send path-count 4 user@ABR1#set bgp group toAs2RR family inet labeled-unicast rib inet.3 user@ABR1#set bgp group toAs2RR export nhs user@ABR1#set bgp group toAs2RR cluster 10.2.2.3 user@ABR1#set bgp group toAs2RR neighbor 10.2.2.6 user@ABR1#set bgp group toAs2RR neighbor 10.2.2.7 user@ABR1#set bgp traceoptions file bgp.log user@ABR1#set bgp traceoptions file size 100m user@ABR1#set bgp traceoptions flag state detail user@ABR1#set bgp traceoptions flag policy
Résultats
En mode configuration, confirmez votre configuration en entrant les show interfacescommandes , show policy-optionsshow routing-optionset .show protocols Si la sortie n’affiche pas la configuration prévue, répétez les instructions de cet exemple pour corriger la configuration.
interfaces {
ge-0/0/1 {
description ABR1-to-P2;
vlan-tagging;
unit 0 {
vlan-id 100;
family inet {
address 192.168.0.12/31;
}
family iso;
family mpls;
}
}
ge-0/0/2 {
description ABR1-to-P1;
vlan-tagging;
unit 0 {
vlan-id 100;
family inet {
address 192.168.0.9/31;
}
family iso;
family mpls;
}
}
lo0 {
unit 0 {
family inet {
address 10.2.2.3/32;
}
family iso {
address 49.0000.0000.aaaa.0003.00;
}
}
}
}
policy-options {
policy-statement allow-lo0 {
term 1 {
from interface lo0.0;
then accept;
}
term 2 {
then reject;
}
}
policy-statement nhs {
term 1 {
from protocol bgp;
then {
next-hop self;
accept;
}
}
}
policy-statement pplb {
then {
load-balance per-packet;
}
}
}
routing-options {
forwarding-table {
export pplb;
}
router-id 10.2.2.3;
autonomous-system 65002;
}
protocols {
isis {
level 1 disable;
interface all;
export allow-lo0;
topologies ipv6-unicast;
}
rsvp {
interface all;
}
bgp {
group toAs2RR {
type internal;
local-address 10.2.2.3;
advertise-inactive;
family inet {
labeled-unicast {
add-path {
receive;
send {
path-count 4;
}
}
rib {
inet.3;
}
}
}
export nhs;
cluster 10.2.2.3;
neighbor 10.2.2.6;
neighbor 10.2.2.7;
}
traceoptions {
file bgp.log size 100m;
flag state detail;
flag policy;
}
}
ldp {
interface all;
}
mpls {
label-switched-path toASBR2-gold {
to 10.2.2.2;
}
label-switched-path toASBR1-bronze {
to 10.2.2.1;
}
label-switched-path toASBR2-bronze {
to 10.2.2.2;
}
interface all;
}
}
Configuration de l’équipement ABR2
Procédure étape par étape
L’exemple suivant vous oblige à naviguer à différents niveaux dans la hiérarchie de configuration. Pour plus d’informations sur la navigation dans la CLI, consultez Utilisation de l’éditeur CLI en mode configuration dans le Guide de l’utilisateur de la CLI.
Pour configurer l’appareil ABR2 :
-
Configurez les interfaces pour activer le transport IP et MPLS.
[edit interfaces] user@ABR2#set ge-0/0/2 description ABR2-to-P2 user@ABR2#set ge-0/0/2 vlan-tagging user@ABR2#set ge-0/0/2 unit 0 vlan-id 100 user@ABR2#set ge-0/0/2 unit 0 family inet address 192.168.0.14/31 user@ABR2#set ge-0/0/2 unit 0 family iso user@ABR2#set ge-0/0/2 unit 0 family mpls user@ABR2#set ge-0/0/4 description ABR2-to-P1 user@ABR2#set ge-0/0/4 vlan-tagging user@ABR2#set ge-0/0/4 unit 0 vlan-id 100 user@ABR2#set ge-0/0/4 unit 0 family inet address 192.168.0.11/31 user@ABR2#set ge-0/0/4 unit 0 family iso user@ABR2#set ge-0/0/4 unit 0 family mpls
-
Configurez l’interface de bouclage à utiliser comme ID de routeur et interface de terminaison pour les sessions LDP et BGP.
[edit interfaces] user@ABR2#set lo0 unit 0 family inet address 2.2.2.4/32 user@ABR2#set lo0 unit 0 family iso address 49.0000.0000.aaaa.0004.00
-
Configurez les stratégies de résolution de chemins multiples pour installer des chemins multiples hiérarchiques dans PFE.
[edit policy-options] user@ABR2#set policy-statement allow-lo0 term 1 from interface lo0.0 user@ABR2#set policy-statement allow-lo0 term 1 then accept user@ABR2#set policy-statement allow-lo0 term 2 then reject user@ABR2#set policy-statement nhs term 1 from protocol bgp user@ABR2#set policy-statement nhs term 1 then next-hop self user@ABR2#set policy-statement nhs term 1 then accept user@ABR2#set policy-statement pplb then load-balance per-packet
-
Appliquez une stratégie d’équilibrage de charge par flux pour assurer la protection du trafic.
[edit routing-options] user@ABR2#set forwarding-table export pplb user@ABR2#set router-id 2.2.2.4 user@ABR2#set autonomous-system 2
-
Configurez les protocoles ISIS, RSVP, MPLS et LDP sur l’interface.
[edit protocols] user@ABR2#set isis level 1 disable user@ABR2#set isis interface all user@ABR2#set isis export allow-lo0 user@ABR2#set isis topologies ipv6-unicast user@ABR2#set rsvp interface all user@ABR2#set ldp interface all user@ABR2#set mpls label-switched-path toASBR1-bronze to 2.2.2.1 user@ABR2#set mpls interface all
-
Configurez BGP unicast étiquetée pour échanger les adresses IP de bouclage comme BGP étiquetées unicast préfixes.
[edit protocols] user@ABR2#set bgp group toAs2RR type internal user@ABR2#set bgp group toAs2RR local-address 2.2.2.4 user@ABR2#set bgp group toAs2RR advertise-inactive user@ABR2#set bgp group toAs2RR family inet labeled-unicast add-path receive user@ABR2#set bgp group toAs2RR family inet labeled-unicast add-path send path-count 4 user@ABR2#set bgp group toAs2RR family inet labeled-unicast rib inet.3 user@ABR2#set bgp group toAs2RR export nhs user@ABR2#set bgp group toAs2RR cluster 2.2.2.4 user@ABR2#set bgp group toAs2RR neighbor 2.2.2.6 user@ABR2#set bgp group toAs2RR neighbor 2.2.2.7 user@ABR2#set bgp traceoptions file bgp.log user@ABR2#set bgp traceoptions file size 100m user@ABR2#set bgp traceoptions flag state detail user@ABR2#set bgp traceoptions flag policy
Résultats
En mode configuration, confirmez votre configuration en entrant les show interfacescommandes , show policy-optionsshow routing-optionset .show protocols Si la sortie n’affiche pas la configuration prévue, répétez les instructions de cet exemple pour corriger la configuration.
interfaces {
ge-0/0/2 {
description ABR2-to-P2;
vlan-tagging;
unit 0 {
vlan-id 100;
family inet {
address 192.168.0.14/31;
}
family iso;
family mpls;
}
}
ge-0/0/4 {
description ABR2-to-P1;
vlan-tagging;
unit 0 {
vlan-id 100;
family inet {
address 192.168.0.11/31;
}
family iso;
family mpls;
}
}
lo0 {
unit 0 {
family inet {
address 2.2.2.4/32;
}
family iso {
address 49.0000.0000.aaaa.0004.00;
}
}
}
}
policy-options {
policy-statement allow-lo0 {
term 1 {
from interface lo0.0;
then accept;
}
term 2 {
then reject;
}
}
policy-statement nhs {
term 1 {
from protocol bgp;
then {
next-hop self;
accept;
}
}
}
policy-statement pplb {
then {
load-balance per-packet;
}
}
}
routing-options {
forwarding-table {
export pplb;
}
router-id 2.2.2.4;
autonomous-system 2;
}
protocols {
isis {
level 1 disable;
interface all;
export allow-lo0;
topologies ipv6-unicast;
}
rsvp {
interface all;
}
bgp {
group toAs2RR {
type internal;
local-address 2.2.2.4;
advertise-inactive;
family inet {
labeled-unicast {
add-path {
receive;
send {
path-count 4;
}
}
rib {
inet.3;
}
}
}
export nhs;
cluster 2.2.2.4;
neighbor 2.2.2.6;
neighbor 2.2.2.7;
}
traceoptions {
file bgp.log size 100m;
flag state detail;
flag policy;
}
}
ldp {
interface all;
}
mpls {
label-switched-path toASBR1-bronze {
to 2.2.2.1;
}
interface all;
}
}
Configuration de l’équipement P2
Procédure étape par étape
L’exemple suivant vous oblige à naviguer à différents niveaux dans la hiérarchie de configuration. Pour plus d’informations sur la navigation dans la CLI, consultez Utilisation de l’éditeur CLI en mode configuration dans le Guide de l’utilisateur de la CLI.
Pour configurer l’appareil P2 :
-
Configurez les interfaces pour activer le transport IP et MPLS.
[edit interfaces] user@P2#set ge-0/0/1 description P2-to-ABR1 user@P2#set ge-0/0/1 vlan-tagging user@P2#set ge-0/0/1 unit 0 vlan-id 100 user@P2#set ge-0/0/1 unit 0 family inet address 192.168.0.13/31 user@P2#set ge-0/0/1 unit 0 family iso user@P2#set ge-0/0/1 unit 0 family mpls user@P2#set ge-0/0/2 description P2-to-ABR2 user@P2#set ge-0/0/2 vlan-tagging user@P2#set ge-0/0/2 unit 0 vlan-id 100 user@P2#set ge-0/0/2 unit 0 family inet address 192.168.0.15/31 user@P2#set ge-0/0/2 unit 0 family iso user@P2#set ge-0/0/2 unit 0 family mpls user@P2#set ge-0/0/3 description P2-to-RR2 user@P2#set ge-0/0/3 vlan-tagging user@P2#set ge-0/0/3 unit 0 vlan-id 100 user@P2#set ge-0/0/3 unit 0 family inet address 192.168.0.16/31 user@P2#set ge-0/0/3 unit 0 family iso user@P2#set ge-0/0/3 unit 0 family mpls user@P2#set ge-0/0/4 description P2-to-ASBR1 user@P2#set ge-0/0/4 vlan-tagging user@P2#set ge-0/0/4 unit 0 vlan-id 100 user@P2#set ge-0/0/4 unit 0 family inet address 192.168.0.18/31 user@P2#set ge-0/0/4 unit 0 family iso user@P2#set ge-0/0/4 unit 0 family mpls user@P2#set ge-0/0/5 description P2-to-ASBR2 user@P2#set ge-0/0/5 vlan-tagging user@P2#set ge-0/0/5 unit 0 vlan-id 100 user@P2#set ge-0/0/5 unit 0 family inet address 192.168.0.20/31 user@P2#set ge-0/0/5 unit 0 family iso user@P2#set ge-0/0/5 unit 0 family mpls
-
Configurez l’interface de bouclage à utiliser comme ID de routeur et interface de terminaison pour les sessions LDP et BGP.
[edit interfaces] user@P2#set lo0 unit 0 family inet address 2.2.2.9/32 user@P2#set lo0 unit 0 family iso address 49.0000.0000.aaaa.0009.00
-
Configurez les stratégies de résolution de chemins multiples pour installer des chemins multiples hiérarchiques dans PFE.
[edit policy-options] user@P2#set policy-statement allow-lo0 term 1 from interface lo0.0 user@P2#set policy-statement allow-lo0 term 1 then accept user@P2#set policy-statement allow-lo0 term 2 then reject
-
Configurez les options de routage.
[edit routing-options] user@P2#set router-id 2.2.2.9
-
Configurez les protocoles ISIS, RSVP, MPLS et LDP sur l’interface.
[edit protocols] user@P2#set isis level 1 disable user@P2#set isis interface all user@P2#set isis export allow-lo0 user@P2#set isis topologies ipv6-unicast user@P2#set rsvp interface all user@P2#set ldp interface all user@P2#set mpls interface all
Résultats
En mode configuration, confirmez votre configuration en entrant les show interfacescommandes , show policy-optionsshow routing-optionset .show protocols Si la sortie n’affiche pas la configuration prévue, répétez les instructions de cet exemple pour corriger la configuration.
interfaces {
ge-0/0/1 {
description P2-to-ABR1;
vlan-tagging;
unit 0 {
vlan-id 100;
family inet {
address 192.168.0.13/31;
}
family iso;
family mpls;
}
}
ge-0/0/2 {
description P2-to-ABR2;
vlan-tagging;
unit 0 {
vlan-id 100;
family inet {
address 192.168.0.15/31;
}
family iso;
family mpls;
}
}
ge-0/0/3 {
description P2-to-RR2;
vlan-tagging;
unit 0 {
vlan-id 100;
family inet {
address 192.168.0.16/31;
}
family iso;
family mpls;
}
}
ge-0/0/4 {
description P2-to-ASBR1;
vlan-tagging;
unit 0 {
vlan-id 100;
family inet {
address 192.168.0.18/31;
}
family iso;
family mpls;
}
}
ge-0/0/5 {
description P2-to-ASBR2;
vlan-tagging;
unit 0 {
vlan-id 100;
family inet {
address 192.168.0.20/31;
}
family iso;
family mpls;
}
}
lo0 {
unit 0 {
family inet {
address 2.2.2.9/32;
}
family iso {
address 49.0000.0000.aaaa.0009.00;
}
}
}
}
policy-options {
policy-statement allow-lo0 {
term 1 {
from interface lo0.0;
then accept;
}
term 2 {
then reject;
}
}
}
routing-options {
router-id 2.2.2.9;
}
protocols {
isis {
level 1 disable;
interface all;
export allow-lo0;
topologies ipv6-unicast;
}
rsvp {
interface all;
}
ldp {
interface all;
}
mpls {
interface all;
}
}
Configuration du périphérique RR2
Procédure étape par étape
L’exemple suivant vous oblige à naviguer à différents niveaux dans la hiérarchie de configuration. Pour plus d’informations sur la navigation dans la CLI, consultez Utilisation de l’éditeur CLI en mode configuration dans le Guide de l’utilisateur de la CLI.
Pour configurer l’appareil RR2 :
-
Configurez les interfaces pour activer le transport IP et MPLS.
[edit interfaces] user@RR2#set ge-0/0/3 description RR2-to-P2 user@RR2#set ge-0/0/3 vlan-tagging user@RR2#set ge-0/0/3 unit 0 vlan-id 100 user@RR2#set ge-0/0/3 unit 0 family inet address 192.168.0.17/31 user@RR2#set ge-0/0/3 unit 0 family iso user@RR2#set ge-0/0/3 unit 0 family mpls
-
Configurez l’interface de bouclage à utiliser comme ID de routeur et interface de terminaison pour les sessions LDP et BGP.
[edit interfaces] user@RR2#set lo0 unit 1 family inet address 2.2.2.7/32 user@RR2#set lo0 unit 1 family iso address 49.0000.0000.aaaa.0007.00
-
Configurez les stratégies de résolution de chemins multiples pour installer des chemins multiples hiérarchiques dans PFE.
[edit policy-options] user@RR2#set policy-statement allow-lo0 term 1 from interface lo0.1 user@RR2#set policy-statement allow-lo0 term 1 then accept user@RR2#set policy-statement allow-lo0 term 2 then reject user@RR2#set policy-statement export-inet3 term 1 from rib inet.3 user@RR2#set policy-statement export-inet3 term 1 then accept user@RR2#set policy-statement export-inet3 term 2 then reject user@RR2#set policy-statement pplb then load-balance per-packet
-
Appliquez une stratégie d’équilibrage de charge par flux pour assurer la protection du trafic.
[edit routing-options] user@RR2#set forwarding-table export pplb user@RR2#set interface-routes rib-group inet inet0to3 user@RR2#set router-id 2.2.2.7 user@RR2#set autonomous-system 2 user@RR2#set rib-groups inet0to3 import-rib inet.0 user@RR2#set rib-groups inet0to3 import-rib inet.3 user@RR2#set rib-groups inet0to3 import-policy allow-lo0
-
Configurez les protocoles ISIS, RSVP, MPLS et LDP sur l’interface.
[edit protocols] user@RR2#set isis level 1 disable user@RR2#set isis interface all user@RR2#set isis export allow-lo0 user@RR2#set isis topologies ipv6-unicast user@RR2#set rsvp interface all user@RR2#set ldp interface all user@RR2#set mpls interface all
-
Configurez BGP unicast étiquetée pour échanger les adresses IP de bouclage comme BGP étiquetées unicast préfixes.
[edit protocols] user@RR2#set bgp path-selection external-router-id user@RR2#set bgp group toAs2Reg1BNs type internal user@RR2#set bgp group toAs2Reg1BNs family inet labeled-unicast add-path receive user@RR2#set bgp group toAs2Reg1BNs family inet labeled-unicast add-path send path-count 4 user@RR2#set bgp group toAs2Reg1BNs family inet labeled-unicast rib inet.3 user@RR2#set bgp group toAs2Reg1BNs neighbor 2.2.2.1 user@RR2#set bgp group toAs2Reg1BNs neighbor 2.2.2.2 user@RR2#set bgp group toAs2Reg1BNs neighbor 2.2.2.3 user@RR2#set bgp group toAs2Reg1BNs neighbor 2.2.2.4 user@RR2#set bgp traceoptions file bgp.log user@RR2#set bgp traceoptions file size 100m user@RR2#set bgp traceoptions flag state detail user@RR2#set bgp traceoptions flag policy user@RR2#set bgp local-address 2.2.2.7 user@RR2#set bgp cluster 2.2.2.7
Résultats
En mode configuration, confirmez votre configuration en entrant les show interfacescommandes , show policy-optionsshow routing-optionset .show protocols Si la sortie n’affiche pas la configuration prévue, répétez les instructions de cet exemple pour corriger la configuration.
interfaces {
ge-0/0/3 {
description RR2-to-P2;
vlan-tagging;
unit 0 {
vlan-id 100;
family inet {
address 192.168.0.17/31;
}
family iso;
family mpls;
}
}
lo0 {
unit 1 {
family inet {
address 2.2.2.7/32;
}
family iso {
address 49.0000.0000.aaaa.0007.00;
}
}
}
}
policy-options {
policy-statement allow-lo0 {
term 1 {
from interface lo0.1;
then accept;
}
term 2 {
then reject;
}
}
policy-statement export-inet3 {
term 1 {
from rib inet.3;
then accept;
}
term 2 {
then reject;
}
}
policy-statement pplb {
then {
load-balance per-packet;
}
}
}
routing-options {
forwarding-table {
export pplb;
}
interface-routes {
rib-group inet inet0to3;
}
router-id 2.2.2.7;
autonomous-system 2;
rib-groups {
inet0to3 {
import-rib [ inet.0 inet.3 ];
import-policy allow-lo0;
}
}
}
protocols {
isis {
level 1 disable;
interface all;
export allow-lo0;
topologies ipv6-unicast;
}
rsvp {
interface all;
}
bgp {
path-selection external-router-id;
group toAs2Reg1BNs {
type internal;
family inet {
labeled-unicast {
add-path {
receive;
send {
path-count 4;
}
}
rib {
inet.3;
}
}
}
neighbor 2.2.2.1;
neighbor 2.2.2.2;
neighbor 2.2.2.3;
neighbor 2.2.2.4;
}
traceoptions {
file bgp.log size 100m;
flag state detail;
flag policy;
}
local-address 2.2.2.7;
cluster 2.2.2.7;
}
ldp {
interface all;
}
mpls {
interface all;
}
}
Vérification
Vérifiez que la configuration fonctionne correctement.
- Vérification de la résolution des sauts suivants
- Vérification des entrées de saut suivant dans la table de routage
Vérification de la résolution des sauts suivants
Objet
Vérifiez que les prochains sauts PE2 et PE3 sont résolus au niveau PE1.
Mesures à prendre
À partir du mode opérationnel, exécutez la show route forwarding-table destination commande.
user@PE1> show route forwarding-table destination 10.3.3.3 extensive table default | match Weight
Weight: 0x1
Weight: 0x1
Next-hop interface: ge-0/0/3.0 Weight: 0x1
Weight: 0x1
Next-hop interface: ge-0/0/3.0 Weight: 0x1
Weight: 0x1
Next-hop interface: ge-0/0/3.0 Weight: 0x1
Weight: 0x1
Next-hop interface: ge-0/0/3.0 Weight: 0x1
Weight: 0x4000
Weight: 0x1
Next-hop interface: ge-0/0/3.0 Weight: 0x1
Weight: 0x1
Next-hop interface: ge-0/0/3.0 Weight: 0x1
Weight: 0x1
Next-hop interface: ge-0/0/3.0 Weight: 0x1
Weight: 0x1
Next-hop interface: ge-0/0/3.0 Weight: 0x1
user@PE1> show route forwarding-table destination 10.3.3.3 extensive table red | match Weight
Weight: 0x1
Weight: 0x1
Next-hop interface: ge-0/0/3.0 Weight: 0x1
Weight: 0x4000
Weight: 0x4000
Next-hop interface: ge-0/0/3.0 Weight: 0x4000
Signification
Vous pouvez voir les poids et 0x4000 pour les 0x1 sauts suivants principaux et secondaires.
Vérification des entrées de saut suivant dans la table de routage
Objet
Vérifiez les entrées de routage nexthop actives au niveau PE1.
Mesures à prendre
À partir du mode opérationnel, exécutez la show route extensive expanded-nh commande.
user@PE1> show route 10.3.3.3 extensive expanded-nh
inet.0: 36 destinations, 65 routes (36 active, 0 holddown, 0 hidden)
10.3.3.3/32 (2 entries, 1 announced)
Installed-nexthop:
List (0xd6ba4b8) Index:1048626
Indr (0xc593cac) 10.1.1.1
Krt_inh (0xcc14684) Index:1048614
List (0xc4cf7b4) Index:1048613
Frr_inh (0xc592730) Index:1048608
Chain (0xc59334c) Index:651 Push 300368
Router (0xc58ea40) Index:628 192.168.0.5 Push 299808
Frr_inh (0xc592604) Index:1048609
Chain (0xc5924d8) Index:649 Push 300384
Router (0xc58ea40) Index:628 192.168.0.5 Push 299808
Frr_inh (0xc592154) Index:1048611
Chain (0xc591bdc) Index:654 Push 300368
Router (0xc58ebd0) Index:629 192.168.0.5 Push 299824
Frr_inh (0xc5921b8) Index:1048612
Chain (0xc591a4c) Index:655 Push 300384
Router (0xc58ebd0) Index:629 192.168.0.5 Push 299824
Indr (0xc593ab8) 10.1.1.2
Krt_inh (0xcc14f84) Index:1048624
List (0xc4d0074) Index:1048623
Frr_inh (0xc5939f0) Index:1048619
Chain (0xc592ab4) Index:638 Push 300144
Router (0xc58ea40) Index:628 192.168.0.5 Push 299808
Frr_inh (0xc593a54) Index:1048620
Chain (0xc591efc) Index:637 Push 300160
Router (0xc58ea40) Index:628 192.168.0.5 Push 299808
Frr_inh (0xc59172c) Index:1048589
Chain (0xc5903a4) Index:640 Push 300144
Router (0xc58ebd0) Index:629 192.168.0.5 Push 299824
Frr_inh (0xc59159c) Index:1048590
Chain (0xc58fa44) Index:639 Push 300160
Router (0xc58ebd0) Index:629 192.168.0.5 Push 299824
TSI:
<SNIP>
Protocol next hop: 10.1.1.1
Indirect next hop: 0xcc14684 1048614 INH Session ID: 0x146 Weight 0x1
Protocol next hop: 10.1.1.2
Indirect next hop: 0xcc14f84 1048624 INH Session ID: 0x145 Weight 0x4000
State: >Active Ext>
Local AS: 65002 Peer AS: 65001
<SNIP>
Indirect next hops: 2
Protocol next hop: 10.1.1.1 Metric: 1
Indirect next hop: 0xcc14684 1048614 INH Session ID: 0x146 Weight 0x1
Indirect path forwarding next hops (Merged): 4
<SNIP>
Protocol next hop: 10.1.1.2 Metric: 1
Indirect next hop: 0xcc14f84 1048624 INH Session ID: 0x145 Weight 0x4000
Indirect path forwarding next hops (Merged): 4
Signification
Vous pouvez voir les poids 0x1 et 0x4000 pour les sauts suivants principaux et de secours.
Prise en charge de FAT Pseudowire pour BGP, L2VPN et VPLS Présentation
Un pseudowire est un circuit ou un service de couche 2 qui émule les attributs essentiels d’un service de télécommunications, tel qu’une ligne T1, sur un réseau à commutation de paquets (PSN) MPLS. Le pseudowire a pour but de fournir uniquement les fonctionnalités minimales nécessaires pour émuler le wire avec les exigences de résilience requises pour la définition de service donnée.
Dans un réseau MPLS, l’étiquette de flux de transport en fonction des flux (FAT) des pseudo-câbles, telle que décrite dans draft-keyupdate-l2vpn-fat-pw-bgp, est utilisée pour équilibrer la charge du trafic sur les pseudo-câbles signalés par BGP pour le réseau privé virtuel de couche 2 (L2VPN) et le service de LAN privé virtuel (VPLS).
L’étiquette de flux FAT est configurée uniquement sur les routeurs de périphérie d’étiquettes (LER). Ainsi, les routeurs de transit ou les routeurs de commutation d’étiquettes (LSR) effectuent des équilibrage de charge de paquets MPLS sur des chemins ECMP (Equal-Cost multichemin) ou des LAG (Link Aggregation Groups) sans avoir besoin de inspection approfondie des paquets de la charge utile.
L’étiquette de flux FAT peut être utilisée pour les pseudowires de classe d’équivalence de transfert à signalisation LDP (FEC 128 et FEC 129) pour les pseudowires VPWS et VPLS. Le paramètre d’interface (Sub-TLV) est utilisé à la fois pour les pseudowires FEC 128 et FEC 129. Le sous-TLV défini pour LDP contient les bits d’émission (T) et de réception (R). Le bit T annonce la possibilité d’envoyer l’étiquette de flux. Le bit R annonce la possibilité d’ouvrir l’étiquette de flux. Par défaut, le comportement de signalisation du routeur PE (Provider Edge) pour l’un de ces pseudowires est d’annoncer les bits T et R dans l’étiquette définie sur 0.
Les flow-label-transmit instructions de configuration and flow-label-receive permettent de définir l’annonce du bit T et du bit R sur 1 dans le champ Sub-TLV, qui fait partie des paramètres d’interface de la FEC pour le message de mappage d’étiquette LDP. Vous pouvez utiliser ces instructions pour contrôler l’envoi de l’étiquette d’équilibrage de charge et la publication de l’étiquette aux homologues de routage dans le plan de contrôle pour les pseudowires signalés par BGP tels que L2VPN et VPLS.
Voir aussi
Configuration de la prise en charge de FAT Pseudowire pour BGP L2VPN pour équilibrer la charge du trafic MPLS
L’étiquette de transport en fonction des flux (FAT) ou de flux est prise en charge pour les pseudowires signalés par BGP tels que L2VPN, qui doivent être configurés uniquement sur les routeurs de périphérie d’étiquettes (LER). Cela permet aux routeurs de transit ou aux routeurs de commutation d’étiquettes (LSR) d’effectuer un équilibrage de charge des paquets MPLS sur des chemins multichemins à coût égal (ECMP) ou des groupes d’agrégation de liens (LAG) sans qu’il soit nécessaire d’effectuer une inspection approfondie des paquets de la charge utile. Les pseudo-fils FAT ou l’étiquette de flux peuvent être utilisés avec les L2VPN à signalisation LDP avec classe d’équivalence de transfert (FEC128 et FEC129), et la prise en charge de l’étiquette de flux est étendue aux pseudo-fils à signalisation BGP pour les services de couche 2 point à point ou point à multipoint.
Avant de configurer la prise en charge de pseudowire FAT pour BGP L2VPN afin d’équilibrer la charge du trafic MPLS :
Configurez les interfaces des appareils et activez le protocole MPLS sur toutes les interfaces.
Configurez RSVP.
Configurez un MPLS et un LSP sur le routeur PE distant.
Configurez BGP et OSPF.
Pour configurer la prise en charge du pseudowire FAT pour BGP L2VPN afin d’équilibrer la charge du trafic MPLS, vous devez procéder comme suit :
Voir aussi
Exemple : configuration de la prise en charge de FAT Pseudowire pour BGP L2VPN pour équilibrer la charge du trafic MPLS
Cet exemple montre comment implémenter la prise en charge du pseudowire FAT pour BGP L2VPN afin d’équilibrer la charge du trafic MPLS.
Exigences
Cet exemple utilise les composants matériels et logiciels suivants :
-
Cinq routeurs MX Series
-
Junos OS version 16.1 ou ultérieure s’exécutant sur tous les équipements
Avant de configurer la prise en charge du pseudowire FAT pour BGP L2VPN, assurez-vous de configurer les protocoles de routage et de signalisation.
Vue d’ensemble
Junos OS permet de configurer l’étiquette de flux FAT (Flow-aware transport) prise en charge pour les pseudowires signalés par BGP tels que L2VPN uniquement sur les routeurs de périphérie d’étiquettes (LER). Ainsi, les routeurs de transit ou les routeurs de commutation d’étiquettes (LSR) effectuent des équilibrage de charge de paquets MPLS sur des chemins ECMP (Equal-Cost multichemin) ou des LAG (Link Aggregation Groups) sans avoir besoin de inspection approfondie des paquets de la charge utile. L’étiquette de flux FAT peut être utilisée pour les pseudofils de classe d’équivalence de transfert à signalisation LDP (FEC 128 et FEC 129) pour les pseudo-fils VPWS et VPLS.
Topologie
La figure 15 montre la prise en charge du pseudowire FAT pour BGP L2VPN configuré sur les appareils PE1 et PE2.
La configuration
Configuration rapide de la CLI
Pour configurer rapidement cet exemple, copiez les commandes suivantes, collez-les dans un fichier texte, supprimez les sauts de ligne, modifiez tous les détails nécessaires pour qu’ils correspondent à votre configuration réseau, copiez et collez les commandes dans la CLI au niveau de la [edit] hiérarchie, puis entrez commit en mode configuration.
CE1
set interfaces ge-0/0/0 vlan-tagging set interfaces ge-0/0/0 unit 600 vlan-id 600 set interfaces ge-0/0/0 unit 600 family inet address 10.1.1.1/24 set interfaces lo0 unit 0 family inet address 10.255.255.8/32
PE1
set interfaces ge-0/0/0 vlan-tagging set interfaces ge-0/0/0 mtu 1600 set interfaces ge-0/0/0 encapsulation vlan-ccc set interfaces ge-0/0/0 unit 300 encapsulation vlan-ccc set interfaces ge-0/0/0 unit 300 vlan-id 600 set interfaces ge-0/0/0 unit 600 encapsulation vlan-vpls set interfaces ge-0/0/0 unit 600 vlan-id 600 set interfaces ge-0/0/0 unit 600 family vpls set interfaces ge-0/0/1 unit 0 family inet address 1.0.0.1/24 set interfaces ge-0/0/1 unit 0 family mpls set interfaces lo0 unit 0 family inet address 10.255.255.1/32 set routing-options nonstop-routing set routing-options router-id 10.255.255.1 set routing-options autonomous-system 100 set routing-options forwarding-table export exp-to-frwd set protocols rsvp interface all set protocols rsvp interface ge-0/0/1.0 set protocols rsvp interface lo0.0 set protocols mpls label-switched-path to-pe2 to 10.255.255.4 set protocols mpls interface ge-0/0/1.0 set protocols bgp group vpls-pe type internal set protocols bgp group vpls-pe local-address 10.255.255.1 set protocols bgp group vpls-pe family l2vpn auto-discovery-only set protocols bgp group vpls-pe family l2vpn signaling set protocols bgp group vpls-pe neighbor 10.255.255.4 set protocols bgp group vpls-pe neighbor 10.255.255.2 set protocols ospf traffic-engineering set protocols ospf area 0.0.0.0 interface lo0.0 passive set protocols ospf area 0.0.0.0 interface ge-0/0/1.0 set policy-options policy-statement exp-to-frwd term 0 from community vpls-com set policy-options policy-statement exp-to-frwd term 0 then install-nexthop lsp to-pe2 set policy-options policy-statement exp-to-frwd term 0 then accept set policy-options community vpls-com members target:100:100 set routing-instances l2vpn-inst instance-type l2vpn set routing-instances l2vpn-inst interface ge-0/0/0.300 set routing-instances l2vpn-inst route-distinguisher 10.255.255.1:200 set routing-instances l2vpn-inst vrf-target target:100:100 set routing-instances l2vpn-inst protocols l2vpn encapsulation-type ethernet-vlan set routing-instances l2vpn-inst protocols l2vpn site pe1 site-identifier 1 set routing-instances l2vpn-inst protocols l2vpn site pe1 interface ge-0/0/0.300 remote-site-id 2 set routing-instances l2vpn-inst protocols l2vpn flow-label-transmit set routing-instances l2vpn-inst protocols l2vpn flow-label-receive set routing-instances vpl1 instance-type vpls set routing-instances vpl1 interface ge-0/0/0.600 set routing-instances vpl1 route-distinguisher 10.255.255.1:100 set routing-instances vpl1 vrf-target target:100:100 set routing-instances vpl1 protocols vpls site-range 10 set routing-instances vpl1 protocols vpls no-tunnel-services set routing-instances vpl1 protocols vpls site vpl1PE1 site-identifier 1 set routing-instances vpl1 protocols vpls flow-label-transmit set routing-instances vpl1 protocols vpls flow-label-receive
L
set interfaces ge-0/0/0 unit 0 family inet address 1.0.0.2/24 set interfaces ge-0/0/0 unit 0 family mpls set interfaces ge-0/0/1 unit 0 family inet address 2.0.0.1/24 set interfaces ge-0/0/1 unit 0 family mpls set interfaces lo0 unit 0 family inet address 10.255.255.2/32 set routing-options router-id 10.255.255.2 set routing-options autonomous-system 100 set protocols rsvp interface ge-0/0/1.0 set protocols rsvp interface ge-0/0/0.0 set protocols rsvp interface lo0.0 set protocols mpls interface ge-0/0/0.0 set protocols mpls interface ge-0/0/1.0 set protocols bgp group vpls-pe type internal set protocols bgp group vpls-pe local-address 10.255.255.2 set protocols bgp group vpls-pe family l2vpn signaling set protocols bgp group vpls-pe neighbor 10.255.255.1 set protocols bgp group vpls-pe neighbor 10.255.255.4 deactivate protocols bgp set protocols ospf traffic-engineering set protocols ospf area 0.0.0.0 interface lo0.0 passive set protocols ospf area 0.0.0.0 interface ge-0/0/0.0 set protocols ospf area 0.0.0.0 interface ge-0/0/1.0
PE2
set interfaces ge-0/0/0 unit 0 family inet address 2.0.0.2/24 set interfaces ge-0/0/0 unit 0 family mpls set interfaces ge-0/0/1 vlan-tagging set interfaces ge-0/0/1 mtu 1600 set interfaces ge-0/0/1 encapsulation vlan-ccc set interfaces ge-0/0/1 unit 300 encapsulation vlan-ccc set interfaces ge-0/0/1 unit 300 vlan-id 600 set interfaces ge-0/0/1 unit 600 encapsulation vlan-vpls set interfaces ge-0/0/1 unit 600 vlan-id 600 set interfaces ge-0/0/1 unit 600 family vpls set interfaces lo0 unit 0 family inet address 10.255.255.4/32 set routing-options router-id 10.255.255.4 set routing-options autonomous-system 100 set routing-options forwarding-table export exp-to-frwd set protocols rsvp interface all set protocols rsvp interface ge-0/0/1.0 set protocols rsvp interface lo0.0 set protocols mpls label-switched-path to-pe1 to 10.255.255.1 set protocols mpls interface ge-0/0/0.0 set protocols bgp group vpls-pe type internal set protocols bgp group vpls-pe local-address 10.255.255.4 set protocols bgp group vpls-pe family l2vpn auto-discovery-only set protocols bgp group vpls-pe family l2vpn signaling set protocols bgp group vpls-pe neighbor 10.255.255.1 set protocols bgp group vpls-pe neighbor 10.255.255.2 set protocols ospf traffic-engineering set protocols ospf area 0.0.0.0 interface lo0.0 passive set protocols ospf area 0.0.0.0 interface ge-0/0/0.0 set policy-options policy-statement exp-to-frwd term 0 from community vpls-com set policy-options policy-statement exp-to-frwd term 0 then install-nexthop lsp to-pe1 set policy-options policy-statement exp-to-frwd term 0 then accept set policy-options community vpls-com members target:100:100 set routing-instances l2vpn-inst instance-type l2vpn set routing-instances l2vpn-inst interface ge-0/0/1.300 set routing-instances l2vpn-inst route-distinguisher 10.255.255.4:200 set routing-instances l2vpn-inst vrf-target target:100:100 set routing-instances l2vpn-inst protocols l2vpn encapsulation-type ethernet-vlan set routing-instances l2vpn-inst protocols l2vpn site pe2 site-identifier 2 set routing-instances l2vpn-inst protocols l2vpn site pe2 interface ge-0/0/1.300 remote-site-id 1 set routing-instances l2vpn-inst protocols l2vpn flow-label-transmit set routing-instances l2vpn-inst protocols l2vpn flow-label-receive set routing-instances vpl1 instance-type vpls set routing-instances vpl1 interface ge-0/0/1.600 set routing-instances vpl1 route-distinguisher 10.255.255.4:100 set routing-instances vpl1 vrf-target target:100:100 set routing-instances vpl1 protocols vpls site-range 10 set routing-instances vpl1 protocols vpls no-tunnel-services set routing-instances vpl1 protocols vpls site vpl1PE2 site-identifier 2 set routing-instances vpl1 protocols vpls flow-label-transmit set routing-instances vpl1 protocols vpls flow-label-receive deactivate routing-instances vpl1
CE2
set interfaces ge-0/0/0 vlan-tagging set interfaces ge-0/0/0 unit 600 vlan-id 600 set interfaces ge-0/0/0 unit 600 family inet address 10.1.1.2/24 set interfaces lo0 unit 0 family inet address 10.255.255.9/32
Configuration de PE1
Procédure étape par étape
L’exemple suivant nécessite que vous naviguiez à différents niveaux dans la hiérarchie de configuration. Pour plus d’informations sur la navigation dans la CLI, reportez-vous à la section Utilisation de l’éditeur CLI en mode configuration dans le Guide de l’utilisateur de la CLI de Junos OS.
Pour configurer l’équipement PE1 :
-
Configurez les interfaces.
[edit interfaces] user@PE1# set ge-0/0/0 vlan-tagging user@PE1# set ge-0/0/0 mtu 1600 user@PE1# set ge-0/0/0 encapsulation vlan-ccc user@PE1# set ge-0/0/0 unit 300 encapsulation vlan-ccc user@PE1# set ge-0/0/0 unit 300 vlan-id 600 user@PE1# set ge-0/0/0 unit 600 encapsulation vlan-vpls user@PE1# set ge-0/0/0 unit 600 vlan-id 600 user@PE1# set ge-0/0/0 unit 600 family vpls deactivate interfaces ge-0/0/0 unit 600 user@PE1# set ge-0/0/1 unit 0 family inet address 1.0.0.1/24 user@PE1# set ge-0/0/1 unit 0 family mpls user@PE1# set lo0 unit 0 family inet address 10.255.255.1/32
-
Configurez le routage non-stop et configurez l’ID du routeur.
[edit routing-options] user@PE1# set nonstop-routing user@PE1# set router-id 10.255.255.1
-
Configurez le numéro du système autonome (AS) et appliquez la stratégie à la table de transfert du routeur local avec l’instruction export.
[edit routing-options] user@PE1# set autonomous-system 100 user@PE1# set forwarding-table export exp-to-frwd
-
Configurez le protocole RSVP sur les interfaces.
[edit protocols rsvp] user@PE1# set interface all user@PE1# set interface ge-0/0/1.0 user@PE1# set interface lo0.0
-
Appliquez les attributs de chemin à commutation d’étiquette au protocole MPLS et configurez l’interface.
[edit protocols mpls] user@PE1# set label-switched-path to-pe2 to 10.255.255.4 user@PE1# set interface ge-0/0/1.0
-
Définissez un groupe d’homologues et configurez l’adresse de fin locale de la session BGP pour le groupe
vpls-ped’homologues.[edit protocols bgp group vpls-pe] user@PE1# set type internal user@PE1# set local-address 10.255.255.1
-
Configurez les attributs de la famille de protocoles pour les NLRI dans les mises à jour.
[edit protocols bgp group vpls-pe] user@PE1# set family l2vpn auto-discovery-only user@PE1# set family l2vpn signaling
-
Configurez les voisins pour le groupe
vpls-pede pairs .[edit protocols bgp group vpls-pe] user@PE1# set neighbor 10.255.255.4 user@PE1# set neighbor 10.255.255.2
-
Configurez l’ingénierie de trafic et configurez les interfaces de la zone 0.0.0.0 d’OSPF.
[edit protocols ospf] user@PE1# set traffic-engineering user@PE1# set area 0.0.0.0 interface lo0.0 passive user@PE1# set area 0.0.0.0 interface ge-0/0/1.0
-
Configurez la politique de routage et les informations de la communauté BGP.
[edit policy-options] user@PE1# set policy-statement exp-to-fwd term 0 from community vpls-com user@PE1# set policy-statement exp-to-fwd term 0 then install-nexthop lsp to-pe2 user@PE1# set policy-statement exp-to-fwd term 0 then accept user@PE1# set community vpls-com members target:100:100
-
Configurez le type d’instance de routage et configurez l’interface.
[edit routing-instances l2vpn-inst] user@PE1# set instance-type l2vpn user@PE1# set interface ge-0/0/0.300
-
Configurez le distinguisher de route par exemple
l2vpn-inst, et configurez la communauté cible VRF.[edit routing-instances l2vpn-inst] user@PE1# set route-distinguisher 10.255.255.1:200 user@PE1# set vrf-target target:100:100
-
Configurez le type d’encapsulation requis pour le protocole L2VPN.
[edit routing-instances l2vpn-inst protocols l2vpn] user@PE1# set encapsulation-type ethernet-vlan
-
Configurez les sites connectés à l’équipement du fournisseur.
[edit routing-instances l2vpn-inst protocols l2vpn] user@PE1# set site pe1 site-identifier 1 user@PE1# set site pe1 interface ge-0/0/0.300 remote-site-id 2
-
Configurez le protocole L2VPN pour l’instance de routage afin de fournir une capacité de publicité permettant d’afficher l’étiquette de flux dans le sens de réception vers le PE distant et de fournir une capacité de publicité pour envoyer l’étiquette de flux dans le sens de transmission vers le PE distant.
[edit routing-instances l2vpn-inst protocols l2vpn] user@PE1# set flow-label-transmit user@PE1# set flow-label-receive
-
Configurez le type d’instance de routage et configurez l’interface.
[edit routing-instances vpl1] user@PE1# set instance-type vpls user@PE1# set interface ge-0/0/0.600
-
Configurez le distinguisher de route par exemple
vp1, et configurez la communauté cible VRF.[edit routing-instances vpl1] user@PE1# set route-distinguisher 10.255.255.1:100 user@PE1# set vrf-target target:100:100
-
Attribuez l’identifiant de site maximal au domaine VPLS.
[edit routing-instances vpl1 protocols vpls] user@PE1# set site-range 10
-
Configurez pour ne pas utiliser les services de tunnel pour l’instance VPLS et attribuez un identifiant de site au site connecté à l’équipement du fournisseur.
[edit routing-instances vpl1 protocols vpls] user@PE1# set no-tunnel-services user@PE1# set site vpl1PE1 site-identifier 1
-
Configurez le protocole VPLS pour l’instance de routage afin de fournir une capacité de publicité permettant d’insérer l’étiquette de flux dans le sens de réception vers le PE distant et de fournir une capacité de publicité pour envoyer l’étiquette de flux dans le sens de transmission vers le PE distant.
[edit routing-instances vpl1 protocols vpls] user@PE1# set flow-label-transmit user@PE1# set flow-label-receive
Résultats
En mode configuration, confirmez votre configuration en entrant les show interfacescommandes , , show routing-instancesshow protocolsshow policy-options, , et .show routing-options Si la sortie n’affiche pas la configuration prévue, répétez les instructions de cet exemple pour corriger la configuration.
user@PE1# show interfaces
ge-0/0/0 {
vlan-tagging;
mtu 1600;
encapsulation vlan-ccc;
unit 300 {
encapsulation vlan-ccc;
vlan-id 600;
}
unit 600 {
encapsulation vlan-vpls;
vlan-id 600;
family vpls;
}
}
ge-0/0/1 {
unit 0 {
family inet {
address 1.0.0.1/24;
}
family mpls;
}
}
lo0 {
unit 0 {
family inet {
address 10.255.255.1/32;
}
}
}
user@PE1# show protocols
rsvp {
interface all;
interface ge-0/0/1.0;
interface lo0.0;
}
mpls {
label-switched-path to-pe2 {
to 10.255.255.4;
}
interface ge-0/0/1.0;
}
bgp {
group vpls-pe {
type internal;
local-address 10.255.255.1;
family l2vpn {
auto-discovery-only;
signaling;
}
neighbor 10.255.255.4;
neighbor 10.255.255.2;
}
}
ospf {
traffic-engineering;
area 0.0.0.0 {
interface lo0.0 {
passive;
}
interface ge-0/0/1.0;
}
}
user@PE1# show policy-options
policy-statement exp-to-frwd {
term 0 {
from community vpls-com;
then {
install-nexthop lsp to-pe2;
accept;
}
}
}
community vpls-com members target:100:100;
user@PE1# show routing-instances
l2vpn-inst {
instance-type l2vpn;
interface ge-0/0/0.300;
route-distinguisher 10.255.255.1:200;
vrf-target target:100:100;
protocols {
l2vpn {
encapsulation-type ethernet-vlan;
site pe1 {
site-identifier 1;
interface ge-0/0/0.300 {
remote-site-id 2;
}
}
flow-label-transmit;
flow-label-receive;
}
}
}
vpl1 {
instance-type vpls;
interface ge-0/0/0.600;
route-distinguisher 10.255.255.1:100;
vrf-target target:100:100;
protocols {
vpls {
site-range 10;
no-tunnel-services;
site vpl1PE1 {
site-identifier 1;
}
flow-label-transmit;
flow-label-receive;
}
}
}
user@PE1# show routing-options
nonstop-routing;
router-id 10.255.255.1;
autonomous-system 100;
forwarding-table {
export exp-to-frwd;
}
Vérification
Vérifiez que la configuration fonctionne correctement.
- Vérification des informations récapitulatives du BGP
- Vérification des informations de connexion L2VPN
- Vérification des routes
Vérification des informations récapitulatives du BGP
Objet
Vérifiez les informations récapitulatives du BGP.
Mesures à prendre
À partir du mode opérationnel, entrez la show bgp summary commande.
user@PE1> show bgp summary
Groups: 1 Peers: 2 Down peers: 1
Table Tot Paths Act Paths Suppressed History Damp State Pending
bgp.l2vpn.0
1 1 0 0 0 0
Peer AS InPkt OutPkt OutQ Flaps Last Up/Dwn State|#Active/Received/Accepted/Damped...
10.255.255.2 100 0 0 0 0 2d 12:54:28 Active
10.255.255.4 100 8121 8093 0 0 2d 12:53:56 Establ
bgp.l2vpn.0: 1/1/1/0
l2vpn-inst.l2vpn.0: 1/1/1/0
Signification
La sortie affiche les informations récapitulatives de BGP.
Vérification des informations de connexion L2VPN
Objet
Vérifiez les informations de connexion VPN de couche 2.
Mesures à prendre
À partir du mode opérationnel, exécutez la show l2vpn connections commande pour afficher les informations sur les connexions VPN de couche 2.
user@PE1> show l2vpn connections
Layer-2 VPN connections:
Legend for connection status (St)
EI -- encapsulation invalid NC -- interface encapsulation not CCC/TCC/VPLS
EM -- encapsulation mismatch WE -- interface and instance encaps not same
VC-Dn -- Virtual circuit down NP -- interface hardware not present
CM -- control-word mismatch -> -- only outbound connection is up
CN -- circuit not provisioned <- -- only inbound connection is up
OR -- out of range Up -- operational
OL -- no outgoing label Dn -- down
LD -- local site signaled down CF -- call admission control failure
RD -- remote site signaled down SC -- local and remote site ID collision
LN -- local site not designated LM -- local site ID not minimum designated
RN -- remote site not designated RM -- remote site ID not minimum designated
XX -- unknown connection status IL -- no incoming label
MM -- MTU mismatch MI -- Mesh-Group ID not available
BK -- Backup connection ST -- Standby connection
PF -- Profile parse failure PB -- Profile busy
RS -- remote site standby SN -- Static Neighbor
LB -- Local site not best-site RB -- Remote site not best-site
VM -- VLAN ID mismatch
Legend for interface status
Up -- operational
Dn -- down
Instance: l2vpn-inst
Edge protection: Not-Primary
Local site: pe1 (1)
connection-site Type St Time last up # Up trans
2 rmt Up Jun 22 14:46:50 2015 1
Remote PE: 10.255.255.4, Negotiated control-word: Yes (Null)
Incoming label: 800003, Outgoing label: 800002
Local interface: ge-0/0/0.300, Status: Up, Encapsulation: VLAN
Flow Label Transmit: Yes, Flow Label Receive: Yes
Signification
La sortie affiche les informations de connexion VPN de couche 2 ainsi que les informations de transmission et de réception de l’étiquette de flux.
Vérification des routes
Objet
Vérifiez que les routes attendues sont apprises.
Mesures à prendre
Depuis le mode opérationnel, exécutez la show route commande pour afficher les routes dans la table de routage.
user@PE1> show route
inet.0: 51 destinations, 51 routes (51 active, 0 holddown, 0 hidden)
+ = Active Route, - = Last Active, * = Both
1.0.0.0/24 *[Direct/0] 2d 12:48:34
> via ge-0/0/1.0
1.0.0.1/32 *[Local/0] 2d 12:48:34
Local via ge-0/0/1.0
2.0.0.0/24 *[OSPF/10] 2d 12:48:24, metric 2
> to 1.0.0.2 via ge-0/0/1.0
10.4.0.0/16 *[Static/5] 2d 12:48:34
> to 10.102.191.254 via fxp0.0
10.5.0.0/16 *[Static/5] 2d 12:48:34
> to 10.102.191.254 via fxp0.0
10.6.128.0/17 *[Static/5] 2d 12:48:34
> to 10.102.191.254 via fxp0.0
10.9.0.0/16 *[Static/5] 2d 12:48:34
> to 10.102.191.254 via fxp0.0
10.10.0.0/16 *[Static/5] 2d 12:48:34
> to 10.102.191.254 via fxp0.0
10.13.4.0/23 *[Static/5] 2d 12:48:34
> to 10.102.191.254 via fxp0.0
10.13.10.0/23 *[Static/5] 2d 12:48:34
> to 10.102.191.254 via fxp0.0
10.82.0.0/15 *[Static/5] 2d 12:48:34
> to 10.102.191.254 via fxp0.0
10.84.0.0/16 *[Static/5] 2d 12:48:34
> to 10.102.191.254 via fxp0.0
10.85.12.0/22 *[Static/5] 2d 12:48:34
> to 10.102.191.254 via fxp0.0
10.92.0.0/16 *[Static/5] 2d 12:48:34
> to 10.102.191.254 via fxp0.0
10.94.0.0/16 *[Static/5] 2d 12:48:34
> to 10.102.191.254 via fxp0.0
10.99.0.0/16 *[Static/5] 2d 12:48:34
> to 10.102.191.254 via fxp0.0
10.102.0.0/16 *[Static/5] 2d 12:48:34
> to 10.102.191.254 via fxp0.0
10.102.160.0/19 *[Direct/0] 2d 12:48:34
> via fxp0.0
10.102.169.99/32 *[Local/0] 2d 12:48:34
Local via fxp0.0
10.150.0.0/16 *[Static/5] 2d 12:48:34
> to 10.102.191.254 via fxp0.0
10.155.0.0/16 *[Static/5] 2d 12:48:34
> to 10.102.191.254 via fxp0.0
10.157.64.0/19 *[Static/5] 2d 12:48:34
> to 10.102.191.254 via fxp0.0
10.160.0.0/16 *[Static/5] 2d 12:48:34
> to 10.102.191.254 via fxp0.0
10.204.0.0/16 *[Static/5] 2d 12:48:34
> to 10.102.191.254 via fxp0.0
10.205.0.0/16 *[Static/5] 2d 12:48:34
> to 10.102.191.254 via fxp0.0
10.206.0.0/16 *[Static/5] 2d 12:48:34
> to 10.102.191.254 via fxp0.0
10.207.0.0/16 *[Static/5] 2d 12:48:34
> to 10.102.191.254 via fxp0.0
10.209.0.0/16 *[Static/5] 2d 12:48:34
> to 10.102.191.254 via fxp0.0
10.212.0.0/16 *[Static/5] 2d 12:48:34
> to 10.102.191.254 via fxp0.0
10.213.0.0/16 *[Static/5] 2d 12:48:34
> to 10.102.191.254 via fxp0.0
10.214.0.0/16 *[Static/5] 2d 12:48:34
> to 10.102.191.254 via fxp0.0
10.215.0.0/16 *[Static/5] 2d 12:48:34
> to 10.102.191.254 via fxp0.0
10.216.0.0/16 *[Static/5] 2d 12:48:34
> to 10.102.191.254 via fxp0.0
10.218.13.0/24 *[Static/5] 2d 12:48:34
> to 10.102.191.254 via fxp0.0
10.218.14.0/24 *[Static/5] 2d 12:48:34
> to 10.102.191.254 via fxp0.0
10.218.16.0/20 *[Static/5] 2d 12:48:34
> to 10.102.191.254 via fxp0.0
10.218.32.0/20 *[Static/5] 2d 12:48:34
> to 10.102.191.254 via fxp0.0
10.227.0.0/16 *[Static/5] 2d 12:48:34
> to 10.102.191.254 via fxp0.0
10.255.255.1/32 *[Direct/0] 2d 12:48:34
> via lo0.0
10.255.255.2/32 *[OSPF/10] 2d 12:48:24, metric 1
> to 1.0.0.2 via ge-0/0/1.0
10.255.255.4/32 *[OSPF/10] 2d 12:48:24, metric 2
> to 1.0.0.2 via ge-0/0/1.0
128.102.161.191/32 *[OSPF/10] 2d 12:48:24, metric 1
> to 1.0.0.2 via ge-0/0/1.0
128.102.169.99/32 *[Direct/0] 2d 12:48:34
> via lo0.0
128.102.171.41/32 *[OSPF/10] 2d 12:48:24, metric 2
> to 1.0.0.2 via ge-0/0/1.0
172.16.0.0/12 *[Static/5] 2d 12:48:34
> to 10.102.191.254 via fxp0.0
192.168.0.0/16 *[Static/5] 2d 12:48:34
> to 10.102.191.254 via fxp0.0
192.168.102.0/23 *[Static/5] 2d 12:48:34
> to 10.102.191.254 via fxp0.0
207.17.136.0/24 *[Static/5] 2d 12:48:34
> to 10.102.191.254 via fxp0.0
207.17.136.192/32 *[Static/5] 2d 12:48:34
> to 10.102.191.254 via fxp0.0
207.17.137.0/24 *[Static/5] 2d 12:48:34
> to 10.102.191.254 via fxp0.0
224.0.0.5/32 *[OSPF/10] 2d 12:48:34, metric 1
MultiRecv
inet.3: 1 destinations, 1 routes (1 active, 0 holddown, 0 hidden)
+ = Active Route, - = Last Active, * = Both
10.255.255.4/32 *[RSVP/7/1] 2d 12:48:04, metric 2
> to 1.0.0.2 via ge-0/0/1.0, label-switched-path to-pe2
iso.0: 1 destinations, 1 routes (1 active, 0 holddown, 0 hidden)
+ = Active Route, - = Last Active, * = Both
47.0005.80ff.f800.0000.0108.0001.1281.0216.9099/152
*[Direct/0] 2d 12:48:34
> via lo0.0
mpls.0: 6 destinations, 6 routes (6 active, 0 holddown, 0 hidden)
+ = Active Route, - = Last Active, * = Both
0 *[MPLS/0] 2d 12:48:34, metric 1
Receive
1 *[MPLS/0] 2d 12:48:34, metric 1
Receive
2 *[MPLS/0] 2d 12:48:34, metric 1
Receive
13 *[MPLS/0] 2d 12:48:34, metric 1
Receive
800003 *[L2VPN/7] 2d 12:41:29
> via ge-0/0/0.300, Pop Offset: 4
ge-0/0/0.300 *[L2VPN/7] 2d 12:41:29, metric2 2
> to 1.0.0.2 via ge-0/0/1.0, label-switched-path to-pe2
inet6.0: 2 destinations, 2 routes (2 active, 0 holddown, 0 hidden)
+ = Active Route, - = Last Active, * = Both
abcd::128:102:169:99/128
*[Direct/0] 2d 12:48:34
> via lo0.0
fe80::5668:a60f:fc6b:eb97/128
*[Direct/0] 2d 12:48:34
> via lo0.0
bgp.l2vpn.0: 1 destinations, 1 routes (1 active, 0 holddown, 0 hidden)
+ = Active Route, - = Last Active, * = Both
10.255.255.4:200:2:1/96
*[BGP/170] 2d 12:41:35, localpref 100, from 10.255.255.4
AS path: I, validation-state: unverified
> to 1.0.0.2 via ge-0/0/1.0, label-switched-path to-pe2
l2vpn-inst.l2vpn.0: 2 destinations, 2 routes (2 active, 0 holddown, 0 hidden)
+ = Active Route, - = Last Active, * = Both
10.255.255.1:200:1:1/96
*[L2VPN/170/-101] 2d 12:41:29, metric2 1
Indirect
10.255.255.4:200:2:1/96
*[BGP/170] 2d 12:41:35, localpref 100, from 10.255.255.4
AS path: I, validation-state: unverified
> to 1.0.0.2 via ge-0/0/1.0, label-switched-path to-pe2
l2vpn-inst.l2id.0: 2 destinations, 3 routes (2 active, 0 holddown, 0 hidden)
+ = Active Route, - = Last Active, * = Both
1 *[L2VPN/170/-101] 2d 12:41:29, metric2 1
Indirect
[L2VPN/175] 2d 12:41:29
> via ge-0/0/0.300, Pop Offset: 4
2 *[BGP/170] 2d 12:41:35, localpref 100, from 10.255.255.4
AS path: I, validation-state: unverified
> to 1.0.0.2 via ge-0/0/1.0, label-switched-path to-pe2
Signification
La sortie affiche toutes les routes dans la table de routage.
Configuration de PE2
Procédure
Procédure étape par étape
L’exemple suivant nécessite que vous naviguiez à différents niveaux dans la hiérarchie de configuration. Pour plus d’informations sur la navigation dans la CLI, reportez-vous à la section Utilisation de l’éditeur CLI en mode configuration dans le Guide de l’utilisateur de la CLI de Junos OS.
Pour configurer l’équipement PE2 :
-
Configurez les interfaces.
[edit interfaces] user@PE2# set ge-0/0/0 unit 0 family inet address 2.0.0.2/24 user@PE2# set ge-0/0/0 unit 0 family mpls user@PE2# set ge-0/0/1 vlan-tagging user@PE2# set ge-0/0/1 mtu 1600 user@PE2# set ge-0/0/1 encapsulation vlan-ccc user@PE2# set ge-0/0/1 unit 300 encapsulation vlan-ccc user@PE2# set ge-0/0/1 unit 300 vlan-id 600 user@PE2# set ge-0/0/1 unit 600 encapsulation vlan-vpls user@PE2# set ge-0/0/1 unit 600 vlan-id 600 user@PE2# set ge-0/0/1 unit 600 family vpls deactivate interfaces ge-0/0/1 unit 600 user@PE2# set lo0 unit 0 family inet address 10.255.255.4/32
-
Configurez l’ID du routeur.
[edit routing-options] user@PE2# set router-id 10.255.255.4
-
Configurez le numéro du système autonome (AS) et appliquez la stratégie à la table de transfert du routeur local avec l’instruction export.
[edit routing-options] user@PE2# set autonomous-system 100 user@PE2# set forwarding-table export exp-to-frwd
-
Configurez le protocole RSVP sur les interfaces.
[edit protocols rsvp] user@PE2# set interface all user@PE2# set interface ge-0/0/1.0 user@PE2# set interface lo0.0
-
Appliquez les attributs de chemin à commutation d’étiquette au protocole MPLS et configurez l’interface.
[edit protocols mpls] user@PE2# set label-switched-path to-pe1 to 10.255.255.1 user@PE2# set interface ge-0/0/0.0
-
Définissez un groupe d’homologues et configurez l’adresse de fin locale de la session BGP pour le groupe
vpls-ped’homologues.[edit protocols bgp group vpls-pe] user@PE2# set type internal user@PE2# set local-address 10.255.255.4
-
Configurez les attributs de la famille de protocoles pour les NLRI dans les mises à jour.
[edit protocols bgp group vpls-pe] user@PE2# set family l2vpn auto-discovery-only user@PE2# set family l2vpn signaling
-
Configurez les voisins pour le groupe
vpls-pehomologue .[edit protocols bgp group vpls-pe] user@PE2# set neighbor 10.255.255.1 user@PE2# set neighbor 10.255.255.2
-
Configurez l’ingénierie de trafic et configurez les interfaces de la zone 0.0.0.0 d’OSPF.
[edit protocols ospf] user@PE2# set traffic-engineering user@PE2# set area 0.0.0.0 interface lo0.0 passive user@PE2# set area 0.0.0.0 interface ge-0/0/0.0
-
Configurez la politique de routage et les informations de la communauté BGP.
[edit policy-options] user@PE2# set policy-statement exp-to-frwd term 0 from community vpls-com user@PE2# set policy-statement exp-to-frwd term 0 then install-nexthop lsp to-pe1 user@PE2# set policy-statement exp-to-frwd term 0 then accept user@PE2# set community vpls-com members target:100:100
-
Configurez le type d’instance de routage et configurez l’interface.
[edit routing-instances l2vpn-inst] user@PE2# set instance-type l2vpn user@PE2# set interface ge-0/0/1.300
-
Configurez le distinguisher de route par exemple
l2vpn-inst, et configurez la communauté cible VRF.[edit routing-instances l2vpn-inst] user@PE2# set route-distinguisher 10.255.255.4:200 user@PE2# set vrf-target target:100:100
-
Configurez le type d’encapsulation requis pour le protocole L2VPN.
[edit routing-instances l2vpn-inst protocols l2vpn] user@PE2# set encapsulation-type ethernet-vlan
-
Configurez les sites connectés à l’équipement du fournisseur.
[edit routing-instances l2vpn-inst protocols l2vpn] user@PE2# set site pe2 site-identifier 2 user@PE2# set site pe2 interface ge-0/0/1.300 remote-site-id 1
-
Configurez le protocole L2VPN pour l’instance de routage afin de fournir une capacité de publicité permettant d’afficher l’étiquette de flux dans le sens de réception vers le PE distant et de fournir une capacité de publicité pour envoyer l’étiquette de flux dans le sens de transmission vers le PE distant.
[edit routing-instances l2vpn-inst protocols l2vpn] user@PE2# set flow-label-transmit user@PE2# set flow-label-receive
-
Configurez le type d’instance de routage et configurez l’interface.
[edit routing-instances vpl1] user@PE2# set instance-type vpls user@PE2# set interface ge-0/0/1.600
-
Configurez le distinguisher de route par exemple
vpl1, et configurez la communauté cible VRF.[edit routing-instances vpl1] user@PE2# set route-distinguisher 10.255.255.4:100 user@PE2# set vrf-target target:100:100
-
Attribuez l’identifiant de site maximal au domaine VPLS.
[edit routing-instances vpl1 protocols vpls] user@PE2# set site-range 10
-
Configurez pour ne pas utiliser les services de tunnel pour l’instance VPLS et attribuez un identifiant de site au site connecté à l’équipement du fournisseur.
[edit routing-instances vpl1 protocols vpls] user@PE2# set no-tunnel-services user@PE2# set site vpl1PE2 site-identifier 2
-
Configurez le protocole VPLS pour l’instance de routage afin de fournir une capacité de publicité permettant d’insérer l’étiquette de flux dans le sens de réception vers le PE distant et de fournir une capacité de publicité à l’étiquette de flux push dans le sens de transmission vers le PE distant.
[edit routing-instances vpl1 protocols vpls] user@PE2# set flow-label-transmit user@PE2# set flow-label-receive
Résultats
En mode configuration, confirmez votre configuration en entrant les show interfacescommandes , , show routing-instancesshow protocolsshow policy-options, , et .show routing-options Si la sortie n’affiche pas la configuration prévue, répétez les instructions de cet exemple pour corriger la configuration.
user@PE2# show interfaces
ge-0/0/0 {
unit 0 {
family inet {
address 2.0.0.2/24;
}
family mpls;
}
}
ge-0/0/1 {
vlan-tagging;
mtu 1600;
encapsulation vlan-ccc;
unit 300 {
encapsulation vlan-ccc;
vlan-id 600;
}
unit 600 {
encapsulation vlan-vpls;
vlan-id 600;
family vpls;
}
}
lo0 {
unit 0 {
family inet {
address 10.255.255.4/32;
}
}
}
user@PE2# show protocols
rsvp {
interface all;
interface ge-0/0/1.0;
interface lo0.0;
}
mpls {
label-switched-path to-pe1 {
to 10.255.255.1;
}
interface ge-0/0/0.0;
}
bgp {
group vpls-pe {
type internal;
local-address 10.255.255.4;
family l2vpn {
auto-discovery-only;
signaling;
}
neighbor 10.255.255.1;
neighbor 10.255.255.2;
}
}
ospf {
traffic-engineering;
area 0.0.0.0 {
interface lo0.0 {
passive;
}
interface ge-0/0/0.0;
}
}
user@PE2# show policy-options
policy-statement exp-to-frwd {
term 0 {
from community vpls-com;
then {
install-nexthop lsp to-pe1;
accept;
}
}
}
community vpls-com members target:100:100;
user@PE2# show routing-instances
l2vpn-inst {
instance-type l2vpn;
interface ge-0/0/1.300;
route-distinguisher 10.255.255.4:200;
vrf-target target:100:100;
protocols {
l2vpn {
encapsulation-type ethernet-vlan;
site pe2 {
site-identifier 2;
interface ge-0/0/1.300 {
remote-site-id 1;
}
}
flow-label-transmit;
flow-label-receive;
}
}
}
vpl1 {
instance-type vpls;
interface ge-0/0/1.600;
route-distinguisher 10.255.255.4:100;
vrf-target target:100:100;
protocols {
vpls {
site-range 10;
no-tunnel-services;
site vpl1PE2 {
site-identifier 2;
}
flow-label-transmit;
flow-label-receive;
}
}
}
user@PE2# show routing-options
router-id 10.255.255.4;
autonomous-system 100;
forwarding-table {
export exp-to-frwd;
}
Vérification
Vérifiez que la configuration fonctionne correctement.
- Vérification des informations récapitulatives du BGP
- Vérification des informations de connexion L2VPN
- Vérification des routes
Vérification des informations récapitulatives du BGP
Objet
Vérifiez les informations récapitulatives du BGP.
Mesures à prendre
À partir du mode opérationnel, entrez la show bgp summary commande.
user@PE2> show bgp summary
Groups: 1 Peers: 2 Down peers: 1
Table Tot Paths Act Paths Suppressed History Damp State Pending
bgp.l2vpn.0
1 1 0 0 0 0
Peer AS InPkt OutPkt OutQ Flaps Last Up/Dwn State|#Active/Received/Accepted/Damped...
10.255.255.1 100 8090 8119 0 1 2d 12:53:15 Establ
bgp.l2vpn.0: 1/1/1/0
l2vpn-inst.l2vpn.0: 1/1/1/0
10.255.255.2 100 0 0 0 0 2d 14:14:49 Active
Signification
La sortie affiche les informations récapitulatives de BGP.
Vérification des informations de connexion L2VPN
Objet
Vérifiez les informations de connexion VPN de couche 2.
Mesures à prendre
À partir du mode opérationnel, exécutez la show l2vpn connections commande pour afficher les informations sur les connexions VPN de couche 2.
user@PE2> show l2vpn connections
Layer-2 VPN connections:
Legend for connection status (St)
EI -- encapsulation invalid NC -- interface encapsulation not CCC/TCC/VPLS
EM -- encapsulation mismatch WE -- interface and instance encaps not same
VC-Dn -- Virtual circuit down NP -- interface hardware not present
CM -- control-word mismatch -> -- only outbound connection is up
CN -- circuit not provisioned <- -- only inbound connection is up
OR -- out of range Up -- operational
OL -- no outgoing label Dn -- down
LD -- local site signaled down CF -- call admission control failure
RD -- remote site signaled down SC -- local and remote site ID collision
LN -- local site not designated LM -- local site ID not minimum designated
RN -- remote site not designated RM -- remote site ID not minimum designated
XX -- unknown connection status IL -- no incoming label
MM -- MTU mismatch MI -- Mesh-Group ID not available
BK -- Backup connection ST -- Standby connection
PF -- Profile parse failure PB -- Profile busy
RS -- remote site standby SN -- Static Neighbor
LB -- Local site not best-site RB -- Remote site not best-site
VM -- VLAN ID mismatch
Legend for interface status
Up -- operational
Dn -- down
Instance: l2vpn-inst
Edge protection: Not-Primary
Local site: pe2 (2)
connection-site Type St Time last up # Up trans
1 rmt Up Jun 22 14:46:50 2015 1
Remote PE: 10.255.255.1, Negotiated control-word: Yes (Null)
Incoming label: 800002, Outgoing label: 800003
Local interface: ge-0/0/1.300, Status: Up, Encapsulation: VLAN
Flow Label Transmit: Yes, Flow Label Receive: Yes
Signification
La sortie affiche les informations de connexion VPN de couche 2 ainsi que les informations de transmission et de réception de l’étiquette de flux.
Vérification des routes
Objet
Vérifiez que les routes attendues sont apprises.
Mesures à prendre
Depuis le mode opérationnel, exécutez la show route commande pour afficher les routes dans la table de routage.
user@PE2> show route
inet.0: 51 destinations, 51 routes (51 active, 0 holddown, 0 hidden)
+ = Active Route, - = Last Active, * = Both
1.0.0.0/24 *[OSPF/10] 2d 14:09:33, metric 2
> to 2.0.0.1 via ge-0/0/0.0
2.0.0.0/24 *[Direct/0] 2d 14:10:18
> via ge-0/0/0.0
2.0.0.2/32 *[Local/0] 2d 14:10:20
Local via ge-0/0/0.0
10.4.0.0/16 *[Static/5] 2d 14:12:18
> to 10.102.191.254 via fxp0.0
10.5.0.0/16 *[Static/5] 2d 14:12:18
> to 10.102.191.254 via fxp0.0
10.6.128.0/17 *[Static/5] 2d 14:12:18
> to 10.102.191.254 via fxp0.0
10.9.0.0/16 *[Static/5] 2d 14:12:18
> to 10.102.191.254 via fxp0.0
10.10.0.0/16 *[Static/5] 2d 14:12:18
> to 10.102.191.254 via fxp0.0
10.13.4.0/23 *[Static/5] 2d 14:12:18
> to 10.102.191.254 via fxp0.0
10.13.10.0/23 *[Static/5] 2d 14:12:18
> to 10.102.191.254 via fxp0.0
10.82.0.0/15 *[Static/5] 2d 14:12:18
> to 10.102.191.254 via fxp0.0
10.84.0.0/16 *[Static/5] 2d 14:12:18
> to 10.102.191.254 via fxp0.0
10.85.12.0/22 *[Static/5] 2d 14:12:18
> to 10.102.191.254 via fxp0.0
10.92.0.0/16 *[Static/5] 2d 14:12:18
> to 10.102.191.254 via fxp0.0
10.94.0.0/16 *[Static/5] 2d 14:12:18
> to 10.102.191.254 via fxp0.0
10.99.0.0/16 *[Static/5] 2d 14:12:18
> to 10.102.191.254 via fxp0.0
10.102.0.0/16 *[Static/5] 2d 14:12:18
> to 10.102.191.254 via fxp0.0
10.102.160.0/19 *[Direct/0] 2d 14:12:18
> via fxp0.0
10.102.171.41/32 *[Local/0] 2d 14:12:18
Local via fxp0.0
10.150.0.0/16 *[Static/5] 2d 14:12:18
> to 10.102.191.254 via fxp0.0
10.155.0.0/16 *[Static/5] 2d 14:12:18
> to 10.102.191.254 via fxp0.0
10.157.64.0/19 *[Static/5] 2d 14:12:18
> to 10.102.191.254 via fxp0.0
10.160.0.0/16 *[Static/5] 2d 14:12:18
> to 10.102.191.254 via fxp0.0
10.204.0.0/16 *[Static/5] 2d 14:12:18
> to 10.102.191.254 via fxp0.0
10.205.0.0/16 *[Static/5] 2d 14:12:18
> to 10.102.191.254 via fxp0.0
10.206.0.0/16 *[Static/5] 2d 14:12:18
> to 10.102.191.254 via fxp0.0
10.207.0.0/16 *[Static/5] 2d 14:12:18
> to 10.102.191.254 via fxp0.0
10.209.0.0/16 *[Static/5] 2d 14:12:18
> to 10.102.191.254 via fxp0.0
10.212.0.0/16 *[Static/5] 2d 14:12:18
> to 10.102.191.254 via fxp0.0
10.213.0.0/16 *[Static/5] 2d 14:12:18
> to 10.102.191.254 via fxp0.0
10.214.0.0/16 *[Static/5] 2d 14:12:18
> to 10.102.191.254 via fxp0.0
10.215.0.0/16 *[Static/5] 2d 14:12:18
> to 10.102.191.254 via fxp0.0
10.216.0.0/16 *[Static/5] 2d 14:12:18
> to 10.102.191.254 via fxp0.0
10.218.13.0/24 *[Static/5] 2d 14:12:18
> to 10.102.191.254 via fxp0.0
10.218.14.0/24 *[Static/5] 2d 14:12:18
> to 10.102.191.254 via fxp0.0
10.218.16.0/20 *[Static/5] 2d 14:12:18
> to 10.102.191.254 via fxp0.0
10.218.32.0/20 *[Static/5] 2d 14:12:18
> to 10.102.191.254 via fxp0.0
10.227.0.0/16 *[Static/5] 2d 14:12:18
> to 10.102.191.254 via fxp0.0
10.255.255.1/32 *[OSPF/10] 2d 12:50:36, metric 2
> to 2.0.0.1 via ge-0/0/0.0
10.255.255.2/32 *[OSPF/10] 2d 14:09:33, metric 1
> to 2.0.0.1 via ge-0/0/0.0
10.255.255.4/32 *[Direct/0] 2d 14:11:51
> via lo0.0
128.102.161.191/32 *[OSPF/10] 2d 14:09:33, metric 1
> to 2.0.0.1 via ge-0/0/0.0
128.102.169.99/32 *[OSPF/10] 2d 12:50:36, metric 2
> to 2.0.0.1 via ge-0/0/0.0
128.102.171.41/32 *[Direct/0] 2d 14:12:18
> via lo0.0
172.16.0.0/12 *[Static/5] 2d 14:12:18
> to 10.102.191.254 via fxp0.0
192.168.0.0/16 *[Static/5] 2d 14:12:18
> to 10.102.191.254 via fxp0.0
192.168.102.0/23 *[Static/5] 2d 14:12:18
> to 10.102.191.254 via fxp0.0
207.17.136.0/24 *[Static/5] 2d 14:12:18
> to 10.102.191.254 via fxp0.0
207.17.136.192/32 *[Static/5] 2d 14:12:18
> to 10.102.191.254 via fxp0.0
207.17.137.0/24 *[Static/5] 2d 14:12:18
> to 10.102.191.254 via fxp0.0
224.0.0.5/32 *[OSPF/10] 2d 14:11:51, metric 1
MultiRecv
inet.3: 1 destinations, 1 routes (1 active, 0 holddown, 0 hidden)
+ = Active Route, - = Last Active, * = Both
10.255.255.1/32 *[RSVP/7/1] 2d 12:50:24, metric 2
> to 2.0.0.1 via ge-0/0/0.0, label-switched-path to-pe1
iso.0: 1 destinations, 1 routes (1 active, 0 holddown, 0 hidden)
+ = Active Route, - = Last Active, * = Both
47.0005.80ff.f800.0000.0108.0001.1281.0217.1041/152
*[Direct/0] 2d 14:12:18
> via lo0.0
mpls.0: 6 destinations, 6 routes (6 active, 0 holddown, 0 hidden)
+ = Active Route, - = Last Active, * = Both
0 *[MPLS/0] 2d 14:11:51, metric 1
Receive
1 *[MPLS/0] 2d 14:11:51, metric 1
Receive
2 *[MPLS/0] 2d 14:11:51, metric 1
Receive
13 *[MPLS/0] 2d 14:11:51, metric 1
Receive
800002 *[L2VPN/7] 2d 12:43:43
> via ge-0/0/1.300, Pop Offset: 4
ge-0/0/1.300 *[L2VPN/7] 2d 12:43:43, metric2 2
> to 2.0.0.1 via ge-0/0/0.0, label-switched-path to-pe1
inet6.0: 2 destinations, 2 routes (2 active, 0 holddown, 0 hidden)
+ = Active Route, - = Last Active, * = Both
abcd::128:102:171:41/128
*[Direct/0] 2d 14:12:18
> via lo0.0
fe80::5668:a60f:fc6b:ee28/128
*[Direct/0] 2d 14:12:18
> via lo0.0
bgp.l2vpn.0: 1 destinations, 1 routes (1 active, 0 holddown, 0 hidden)
+ = Active Route, - = Last Active, * = Both
10.255.255.1:200:1:1/96
*[BGP/170] 2d 12:43:43, localpref 100, from 10.255.255.1
AS path: I, validation-state: unverified
> to 2.0.0.1 via ge-0/0/0.0, label-switched-path to-pe1
l2vpn-inst.l2vpn.0: 2 destinations, 2 routes (2 active, 0 holddown, 0 hidden)
+ = Active Route, - = Last Active, * = Both
10.255.255.1:200:1:1/96
*[BGP/170] 2d 12:43:43, localpref 100, from 10.255.255.1
AS path: I, validation-state: unverified
> to 2.0.0.1 via ge-0/0/0.0, label-switched-path to-pe1
10.255.255.4:200:2:1/96
*[L2VPN/170/-101] 2d 12:43:50, metric2 1
Indirect
l2vpn-inst.l2id.0: 2 destinations, 3 routes (2 active, 0 holddown, 0 hidden)
+ = Active Route, - = Last Active, * = Both
1 *[BGP/170] 2d 12:43:43, localpref 100, from 10.255.255.1
AS path: I, validation-state: unverified
> to 2.0.0.1 via ge-0/0/0.0, label-switched-path to-pe1
2 *[L2VPN/170/-101] 2d 12:43:50, metric2 1
Indirect
[L2VPN/175] 2d 12:43:43
> via ge-0/0/1.300, Pop Offset: 4
Signification
La sortie affiche toutes les routes dans la table de routage.
Configuration de la prise en charge de FAT Pseudowire pour BGP VPLS afin d’équilibrer la charge du trafic MPLS
L’étiquette de transport sensible aux flux (FAT) ou de flux est prise en charge pour les pseudowires signalés par BGP tels que VPLS et doit être configurée uniquement sur les routeurs de périphérie d’étiquettes (LER). Cela permet aux routeurs de transit ou aux routeurs de commutation d’étiquettes (LSR) d’effectuer un équilibrage de charge des paquets MPLS sur des chemins multichemins à coût égal (ECMP) ou des groupes d’agrégation de liens (LAG) sans avoir besoin d’une inspection approfondie des paquets de la charge utile. Les pseudofils FAT ou l’étiquette de flux peuvent être utilisés avec les VPLS à signalisation LDP avec classe d’équivalence de transfert (FEC128 et FEC129), et la prise en charge de l’étiquette de flux est étendue aux pseudo-fils signalés par BGP pour les services de couche 2 point à point ou point à multipoint.
Avant de configurer la prise en charge du pseudowire FAT pour le VPLS BGP afin d’équilibrer la charge du trafic MPLS :
Configurez les interfaces des appareils et activez le protocole MPLS sur toutes les interfaces.
Configurez RSVP.
Configurez un MPLS et un LSP sur le routeur PE distant.
Configurez BGP et OSPF.
Pour configurer la prise en charge du pseudowire FAT pour le VPLS BGP afin d’équilibrer la charge du trafic MPLS, vous devez procéder comme suit :
Voir aussi
Exemple : Configuration de la prise en charge de FAT Pseudowire pour BGP VPLS pour équilibrer la charge du trafic MPLS
Cet exemple montre comment implémenter la prise en charge du pseudowire FAT pour les VPLS BGP afin d’équilibrer la charge du trafic MPLS.
Exigences
Cet exemple utilise les composants matériels et logiciels suivants :
-
Cinq routeurs MX Series
-
Junos OS version 16.1 ou ultérieure s’exécutant sur tous les équipements
Avant de configurer la prise en charge du pseudowire FAT pour les VPLS BGP, assurez-vous de configurer les protocoles de routage et de signalisation.
Vue d’ensemble
Junos OS permet de configurer l’étiquette de flux FAT (Flow-aware transport) prise en charge pour les pseudowires signalés par BGP tels que VPLS uniquement sur les routeurs de périphérie d’étiquettes (LER). Ainsi, les routeurs de transit ou les routeurs de commutation d’étiquettes (LSR) effectuent équilibrage de charge de paquets MPLS sur des chemins ECMP (Equal-Cost multichemin) ou des LAG (Link Aggregation Groups) sans qu’il soit nécessaire de inspection approfondie des paquets la charge utile. L’étiquette de flux FAT peut être utilisée pour les pseudofils de classe d’équivalence de transfert à signalisation LDP (FEC 128 et FEC 129) pour les pseudo-fils VPWS et VPLS.
Topologie
La figure 16 montre la prise en charge du pseudowire FAT pour les VPLS BGP configurés sur les appareils PE1 et PE2.
 BGP
La configuration
Configuration rapide de la CLI
Pour configurer rapidement cet exemple, copiez les commandes suivantes, collez-les dans un fichier texte, supprimez les sauts de ligne, modifiez tous les détails nécessaires pour qu’ils correspondent à votre configuration réseau, copiez et collez les commandes dans la CLI au niveau de la [edit] hiérarchie, puis entrez commit en mode configuration.
CE1
set interfaces ge-0/0/0 vlan-tagging set interfaces ge-0/0/0 unit 600 vlan-id 600 set interfaces ge-0/0/0 unit 600 family inet address 10.1.1.1/24 set interfaces lo0 unit 0 family inet address 10.255.255.8/32
PE1
set interfaces ge-0/0/0 vlan-tagging set interfaces ge-0/0/0 mtu 1600 set interfaces ge-0/0/0 encapsulation vlan-vpls set interfaces ge-0/0/0 unit 600 encapsulation vlan-vpls set interfaces ge-0/0/0 unit 600 vlan-id 600 set interfaces ge-0/0/0 unit 600 family vpls set interfaces ge-0/0/1 unit 0 family inet address 1.0.0.1/24 set interfaces ge-0/0/1 unit 0 family mpls set interfaces lo0 unit 0 family inet address 10.255.255.1/32 set routing-options nonstop-routing set routing-options router-id 10.255.255.1 set routing-options autonomous-system 100 set routing-options forwarding-table export exp-to-frwd set protocols rsvp interface all set protocols rsvp interface ge-0/0/1.0 set protocols rsvp interface lo0.0 set protocols mpls label-switched-path to-pe2 to 10.255.255.4 set protocols mpls interface ge-0/0/1.0 set protocols bgp group vpls-pe type internal set protocols bgp group vpls-pe local-address 10.255.255.1 set protocols bgp group vpls-pe family l2vpn auto-discovery-only set protocols bgp group vpls-pe family l2vpn signaling set protocols bgp group vpls-pe neighbor 10.255.255.4 set protocols bgp group vpls-pe neighbor 10.255.255.2 set protocols ospf traffic-engineering set protocols ospf area 0.0.0.0 interface lo0.0 passive set protocols ospf area 0.0.0.0 interface ge-0/0/1.0 set policy-options policy-statement exp-to-frwd term 0 from community vpls-com set policy-options policy-statement exp-to-frwd term 0 then install-nexthop lsp to-pe2 set policy-options policy-statement exp-to-frwd term 0 then accept set policy-options community vpls-com members target:100:100 set routing-instances vpl1 instance-type vpls set routing-instances vpl1 interface ge-0/0/0.600 set routing-instances vpl1 route-distinguisher 10.255.255.1:100 set routing-instances vpl1 vrf-target target:100:100 set routing-instances vpl1 protocols vpls site-range 10 set routing-instances vpl1 protocols vpls no-tunnel-services set routing-instances vpl1 protocols vpls site vpl1PE1 site-identifier 1 set routing-instances vpl1 protocols vpls flow-label-transmit set routing-instances vpl1 protocols vpls flow-label-receive
L
set interfaces ge-0/0/0 unit 0 family inet address 1.0.0.2/24 set interfaces ge-0/0/0 unit 0 family mpls set interfaces ge-0/0/1 unit 0 family inet address 2.0.0.1/24 set interfaces ge-0/0/1 unit 0 family mpls set interfaces lo0 unit 0 family inet address 10.255.255.2/32 set routing-options router-id 10.255.255.2 set routing-options autonomous-system 100 set protocols rsvp interface ge-0/0/1.0 set protocols rsvp interface ge-0/0/0.0 set protocols rsvp interface lo0.0 set protocols mpls interface ge-0/0/0.0 set protocols mpls interface ge-0/0/1.0 set protocols bgp group vpls-pe type internal set protocols bgp group vpls-pe local-address 10.255.255.2 set protocols bgp group vpls-pe family l2vpn signaling set protocols bgp group vpls-pe neighbor 10.255.255.1 set protocols bgp group vpls-pe neighbor 10.255.255.4 deactivate protocols bgp set protocols ospf traffic-engineering set protocols ospf area 0.0.0.0 interface lo0.0 passive set protocols ospf area 0.0.0.0 interface ge-0/0/0.0 set protocols ospf area 0.0.0.0 interface ge-0/0/1.0
PE2
set interfaces ge-0/0/0 unit 0 family inet address 2.0.0.2/24 set interfaces ge-0/0/0 unit 0 family mpls set interfaces ge-0/0/1 vlan-tagging set interfaces ge-0/0/1 mtu 1600 set interfaces ge-0/0/1 encapsulation vlan-vpls set interfaces ge-0/0/1 unit 600 encapsulation vlan-vpls set interfaces ge-0/0/1 unit 600 vlan-id 600 set interfaces ge-0/0/1 unit 600 family vpls set interfaces lo0 unit 0 family inet address 10.255.255.4/32 set routing-options router-id 10.255.255.4 set routing-options autonomous-system 100 set routing-options forwarding-table export exp-to-frwd set protocols rsvp interface all set protocols rsvp interface ge-0/0/1.0 set protocols rsvp interface lo0.0 set protocols mpls label-switched-path to-pe1 to 10.255.255.1 set protocols mpls interface ge-0/0/0.0 set protocols bgp group vpls-pe type internal set protocols bgp group vpls-pe local-address 10.255.255.4 set protocols bgp group vpls-pe family l2vpn auto-discovery-only set protocols bgp group vpls-pe family l2vpn signaling set protocols bgp group vpls-pe neighbor 10.255.255.1 set protocols bgp group vpls-pe neighbor 10.255.255.2 set protocols ospf traffic-engineering set protocols ospf area 0.0.0.0 interface lo0.0 passive set protocols ospf area 0.0.0.0 interface ge-0/0/0.0 set policy-options policy-statement exp-to-frwd term 0 from community vpls-com set policy-options policy-statement exp-to-frwd term 0 then install-nexthop lsp to-pe1 set policy-options policy-statement exp-to-frwd term 0 then accept set policy-options community vpls-com members target:100:100 set routing-instances vpl1 instance-type vpls set routing-instances vpl1 interface ge-0/0/1.600 set routing-instances vpl1 route-distinguisher 10.255.255.4:100 set routing-instances vpl1 vrf-target target:100:100 set routing-instances vpl1 protocols vpls site-range 10 set routing-instances vpl1 protocols vpls no-tunnel-services set routing-instances vpl1 protocols vpls site vpl1PE2 site-identifier 2 set routing-instances vpl1 protocols vpls flow-label-transmit set routing-instances vpl1 protocols vpls flow-label-receive
CE2
set interfaces ge-0/0/0 vlan-tagging set interfaces ge-0/0/0 unit 600 vlan-id 600 set interfaces ge-0/0/0 unit 600 family inet address 10.1.1.2/24 set interfaces lo0 unit 0 family inet address 10.255.255.9/32
Configuration de PE1
Procédure étape par étape
L’exemple suivant nécessite que vous naviguiez à différents niveaux dans la hiérarchie de configuration. Pour plus d’informations sur la navigation dans la CLI, reportez-vous à la section Utilisation de l’éditeur CLI en mode configuration dans le Guide de l’utilisateur de la CLI de Junos OS.
Pour configurer l’équipement PE1 :
-
Configurez les interfaces.
[edit interfaces] user@PE1# set ge-0/0/0 vlan-tagging user@PE1# set ge-0/0/0 mtu 1600 user@PE1# set ge-0/0/0 encapsulation vlan-vpls user@PE1# set ge-0/0/0 unit 600 encapsulation vlan-vpls user@PE1# set ge-0/0/0 unit 600 vlan-id 600 user@PE1# set ge-0/0/0 unit 600 family vpls user@PE1# set ge-0/0/1 unit 0 family inet address 1.0.0.1/24 user@PE1# set ge-0/0/1 unit 0 family mpls user@PE1# set lo0 unit 0 family inet address 10.255.255.1/32
-
Configurez le routage non-stop et configurez l’ID du routeur.
[edit routing-options] user@PE1# set nonstop-routing user@PE1# set router-id 10.255.255.1
-
Configurez le numéro du système autonome (AS) et appliquez la stratégie à la table de transfert du routeur local avec l’instruction export.
[edit routing-options] user@PE1# set autonomous-system 100 user@PE1# set forwarding-table export exp-to-frwd
-
Configurez le protocole RSVP sur les interfaces.
[edit protocols rsvp] user@PE1# set interface all user@PE1# set interface ge-0/0/1.0 user@PE1# set interface lo0.0
-
Appliquez les attributs de chemin à commutation d’étiquette au protocole MPLS et configurez l’interface.
[edit protocols mpls] user@PE1# set label-switched-path to-pe2 to 10.255.255.4 user@PE1# set interface ge-0/0/1.0
-
Définissez un groupe d’homologues et configurez l’adresse de l’extrémité locale de la session BGP pour le groupe
vpls-ped’homologues .[edit protocols bgp group vpls-pe] user@PE1# set type internal user@PE1# set local-address 10.255.255.1
-
Configurez les attributs de la famille de protocoles pour les NLRI dans les mises à jour.
[edit protocols bgp group vpls-pe family l2vpn] user@PE1# set auto-discovery-only user@PE1# set signaling
-
Configurez les voisins pour le groupe
vpls-pede pairs .[edit protocols bgp group vpls-pe] user@PE1# set neighbor 10.255.255.4 user@PE1# set neighbor 10.255.255.2
-
Configurez l’ingénierie de trafic et configurez les interfaces de la zone 0.0.0.0 d’OSPF.
[edit protocols ospf] user@PE1# set traffic-engineering user@PE1# set area 0.0.0.0 interface lo0.0 passive user@PE1# set area 0.0.0.0 interface ge-0/0/1.0
-
Configurez la politique de routage et les informations de la communauté BGP.
[edit policy-options ] user@PE1# set policy-statement exp-to-frwd term 0 from community vpls-com user@PE1# set policy-statement exp-to-frwd term 0 then install-nexthop lsp to-pe2 user@PE1# set policy-statement exp-to-frwd term 0 then accept user@PE1# set community vpls-com members target:100:100
-
Configurez le type d’instance de routage et configurez l’interface.
[edit routing-instances vp1] user@PE1# set instance-type vpls user@PE1# set interface ge-0/0/0.600
-
Configurez le distinguisher de route par exemple
vpl1, et configurez la communauté cible VRF.[edit routing-instances vpl1] user@PE1# set route-distinguisher 10.255.255.1:100 user@PE1# set vrf-target target:100:100
-
Attribuez l’identifiant de site maximal au domaine VPLS.
[edit routing-instances vp1 protocols vpls] user@PE1# set site-range 10
-
Configurez le protocole VPLS afin qu’il n’utilise pas les services de tunnel pour l’instance VPLS et attribuez l’identifiant de site au site connecté à l’équipement du fournisseur.
[edit routing-instances vp1 protocols vpls] user@PE1# set no-tunnel-services user@PE1# set site vpl1PE1 site-identifier 1
-
Configurez le protocole VPLS pour l’instance de routage afin de fournir une capacité de publicité permettant d’insérer l’étiquette de flux dans le sens de réception vers le PE distant et de fournir une capacité de publicité pour envoyer l’étiquette de flux dans le sens de transmission vers le PE distant.
[edit routing-instances vp1 protocols vpls] user@PE1# set flow-label-receive user@PE1# set flow-label-transmit
Résultats
En mode configuration, confirmez votre configuration en entrant les show interfacescommandes , , show routing-instancesshow protocolsshow policy-options, , et .show routing-options Si la sortie n’affiche pas la configuration prévue, répétez les instructions de cet exemple pour corriger la configuration.
user@PE1# show interfaces
ge-0/0/0 {
vlan-tagging;
mtu 1600;
encapsulation vlan-vpls;
unit 600 {
encapsulation vlan-vpls;
vlan-id 600;
family vpls;
}
}
ge-0/0/1 {
unit 0 {
family inet {
address 1.0.0.1/24;
}
family mpls;
}
}
lo0 {
unit 0 {
family inet {
address 10.255.255.1/32;
}
}
}
user@PE1# show protocols
rsvp {
interface all;
interface ge-0/0/1.0;
interface lo0.0;
}
mpls {
label-switched-path to-pe2 {
to 10.255.255.4;
}
interface ge-0/0/1.0;
}
bgp {
group vpls-pe {
type internal;
local-address 10.255.255.1;
family l2vpn {
auto-discovery-only;
signaling;
}
neighbor 10.255.255.4;
neighbor 10.255.255.2;
}
}
ospf {
traffic-engineering;
area 0.0.0.0 {
interface lo0.0 {
passive;
}
interface ge-0/0/1.0;
}
}
user@PE1# show policy-options
policy-statement exp-to-frwd {
term 0 {
from community vpls-com;
then {
install-nexthop lsp to-pe2;
accept;
}
}
}
community vpls-com members target:100:100;
user@PE1# show routing-instances
vpl1 {
instance-type vpls;
interface ge-0/0/0.600;
route-distinguisher 10.255.255.1:100;
vrf-target target:100:100;
protocols {
vpls {
site-range 10;
no-tunnel-services;
site vpl1PE1 {
site-identifier 1;
}
flow-label-transmit;
flow-label-receive;
}
}
}
user@PE1# show routing-options
nonstop-routing;
router-id 10.255.255.1;
autonomous-system 100;
forwarding-table {
export exp-to-frwd;
}
Configuration de PE2
Procédure étape par étape
L’exemple suivant nécessite que vous naviguiez à différents niveaux dans la hiérarchie de configuration. Pour plus d’informations sur la navigation dans la CLI, reportez-vous à la section Utilisation de l’éditeur CLI en mode configuration dans le Guide de l’utilisateur de la CLI de Junos OS.
Pour configurer l’équipement PE2 :
-
Configurez les interfaces.
[edit interfaces] user@PE2# set ge-0/0/0 unit 0 family inet address 2.0.0.2/24 user@PE2# set ge-0/0/0 unit 0 family mpls user@PE2# set ge-0/0/1 vlan-tagging user@PE2# set ge-0/0/1 mtu 1600 user@PE2# set ge-0/0/1 encapsulation vlan-vpls user@PE2# set ge-0/0/1 unit 600 encapsulation vlan-vpls user@PE2# set ge-0/0/1 unit 600 vlan-id 600 user@PE2# set ge-0/0/1 unit 600 family vpls user@PE2# set lo0 unit 0 family inet address 10.255.255.4/32
-
Configurez l’ID du routeur.
[edit routing-options] user@PE2# set router-id 10.255.255.4
-
Configurez le numéro du système autonome (AS) et appliquez la stratégie à la table de transfert du routeur local avec l’instruction export.
[edit routing-options] user@PE2# set autonomous-system 100 user@PE2# set forwarding-table export exp-to-frwd
-
Configurez le protocole RSVP sur les interfaces.
[edit protocols rsvp] user@PE2# set interface all user@PE2# set interface ge-0/0/1.0 user@PE2# set interface lo0.0
-
Appliquez les attributs de chemin à commutation d’étiquette au protocole MPLS et configurez l’interface.
[edit protocols mpls] user@PE2# set label-switched-path to-pe1 to 10.255.255.1 user@PE2# set interface ge-0/0/0.0
-
Définissez un groupe d’homologues et configurez l’adresse d’extrémité locale de la session BGP pour le groupe
vpls-ped’homologues.[edit protocols bgp group vpls-pe] user@PE2# set type internal user@PE2# set local-address 10.255.255.4
-
Configurez les attributs de la famille de protocoles pour les NLRI dans les mises à jour.
[edit protocols bgp group vpls-pe] user@PE2# set family l2vpn auto-discovery-only user@PE2# set family l2vpn signaling
-
Configurez les voisins pour le groupe
vpls-pede pairs .[edit protocols bgp group vpls-pe] user@PE2# set neighbor 10.255.255.1 user@PE2# set neighbor 10.255.255.2
-
Configurez l’ingénierie de trafic et configurez les interfaces de la zone 0.0.0.0 d’OSPF.
[edit protocols ospf] user@PE2# set traffic-engineering user@PE2# set area 0.0.0.0 interface lo0.0 passive user@PE2# set area 0.0.0.0 interface ge-0/0/0.0
-
Configurez la politique de routage et les informations de la communauté BGP.
[edit policy-options ] user@PE2# set policy-statement exp-to-frwd term 0 from community vpls-com user@PE2# set policy-statement exp-to-frwd term 0 then install-nexthop lsp to-pe1 user@PE2# set policy-statement exp-to-frwd term 0 then accept user@PE2# set community vpls-com members target:100:100
-
Configurez le type d’instance de routage et configurez l’interface.
[edit routing-instances vpl1] user@PE2# set instance-type vpls user@PE2# set interface ge-0/0/1.600
-
Configurez le distinguisher de route par exemple
vp11, et configurez la communauté cible VRF.[edit routing-instances vpl1] user@PE2# set route-distinguisher 10.255.255.4:100 user@PE2# set vrf-target target:100:100
-
Attribuez l’identifiant de site maximal au domaine VPLS.
[edit routing-instances vpl1 protocols vpls] user@PE2# set site-range 10
-
Configurez le protocole VPLS afin qu’il n’utilise pas les services de tunnel pour l’instance VPLS et attribuez l’identifiant de site au site connecté à l’équipement du fournisseur.
[edit routing-instances vpl1 protocols vpls] user@PE2# set no-tunnel-services user@PE2# set site vpl1PE2 site-identifier 2
-
Configurez le protocole VPLS pour l’instance de routage afin de fournir une capacité de publicité permettant d’insérer l’étiquette de flux dans le sens de réception vers le PE distant et de fournir une capacité de publicité pour envoyer l’étiquette de flux dans le sens de transmission vers le PE distant.
[edit routing-instances vpl1 protocols vpls] user@PE2# set flow-label-transmit user@PE2# set flow-label-receive
Résultats
En mode configuration, confirmez votre configuration en entrant les show interfacescommandes , , show routing-instancesshow protocolsshow policy-options, , et .show routing-options Si la sortie n’affiche pas la configuration prévue, répétez les instructions de cet exemple pour corriger la configuration.
user@PE2# show interfaces
ge-0/0/0 {
unit 0 {
family inet {
address 2.0.0.2/24;
}
family mpls;
}
}
ge-0/0/1 {
vlan-tagging;
mtu 1600;
encapsulation vlan-vpls;
unit 600 {
encapsulation vlan-vpls;
vlan-id 600;
family vpls;
}
}
lo0 {
unit 0 {
family inet {
address 10.255.255.4/32;
}
}
}
user@PE2# show protocols
rsvp {
interface all;
interface ge-0/0/1.0;
interface lo0.0;
}
mpls {
label-switched-path to-pe1 {
to 10.255.255.1;
}
interface ge-0/0/0.0;
}
bgp {
group vpls-pe {
type internal;
local-address 10.255.255.4;
family l2vpn {
auto-discovery-only;
signaling;
}
neighbor 10.255.255.1;
neighbor 10.255.255.2;
}
}
ospf {
traffic-engineering;
area 0.0.0.0 {
interface lo0.0 {
passive;
}
interface ge-0/0/0.0;
}
}
user@PE2# show policy-options
policy-statement exp-to-frwd {
term 0 {
from community vpls-com;
then {
install-nexthop lsp to-pe1;
accept;
}
}
}
community vpls-com members target:100:100;
user@PE2# show routing-instances
vpl1 {
instance-type vpls;
interface ge-0/0/1.600;
route-distinguisher 10.255.255.4:100;
vrf-target target:100:100;
protocols {
vpls {
site-range 10;
no-tunnel-services;
site vpl1PE2 {
site-identifier 2;
}
flow-label-transmit;
flow-label-receive;
}
}
}
user@PE2# show routing-options
router-id 10.255.255.4;
autonomous-system 100;
forwarding-table {
export exp-to-frwd;
}
Vérification
Vérifiez que la configuration fonctionne correctement.
Vérification des informations de connexion VPLS
Objet
Vérifiez les informations de connexion VPLS.
Mesures à prendre
Depuis le mode opérationnel, exécutez la show vpls connections commande pour afficher les informations sur les connexions VPLS.
user@PE1> show vpls connections
Layer-2 VPN connections:
Legend for connection status (St)
EI -- encapsulation invalid NC -- interface encapsulation not CCC/TCC/VPLS
EM -- encapsulation mismatch WE -- interface and instance encaps not same
VC-Dn -- Virtual circuit down NP -- interface hardware not present
CM -- control-word mismatch -> -- only outbound connection is up
CN -- circuit not provisioned <- -- only inbound connection is up
OR -- out of range Up -- operational
OL -- no outgoing label Dn -- down
LD -- local site signaled down CF -- call admission control failure
RD -- remote site signaled down SC -- local and remote site ID collision
LN -- local site not designated LM -- local site ID not minimum designated
RN -- remote site not designated RM -- remote site ID not minimum designated
XX -- unknown connection status IL -- no incoming label
MM -- MTU mismatch MI -- Mesh-Group ID not available
BK -- Backup connection ST -- Standby connection
PF -- Profile parse failure PB -- Profile busy
RS -- remote site standby SN -- Static Neighbor
LB -- Local site not best-site RB -- Remote site not best-site
VM -- VLAN ID mismatch
Legend for interface status
Up -- operational
Dn -- down
Instance: vpl1
Edge protection: Not-Primary
Local site: vpl1PE1 (1)
connection-site Type St Time last up # Up trans
2 rmt Up Jun 17 11:38:14 2015 1
Remote PE: 10.255.255.4, Negotiated control-word: No
Incoming label: 262146, Outgoing label: 262145
Local interface: lsi.1048576, Status: Up, Encapsulation: VPLS
Description: Intf - vpls vpl1 local site 1 remote site 2
Flow Label Transmit: Yes, Flow Label Receive: Yes
Signification
La sortie affiche les informations de connexion VPLS ainsi que les informations de réception et de transmission des étiquettes de flux.
Vérification
Vérifiez que la configuration fonctionne correctement.
Vérification des informations de connexion VPLS
Objet
Vérifiez les informations de connexion VPLS.
Mesures à prendre
Depuis le mode opérationnel, exécutez la show vpls connections commande pour afficher les informations sur les connexions VPLS.
user@PE2> show vpls connections
Layer-2 VPN connections:
Legend for connection status (St)
EI -- encapsulation invalid NC -- interface encapsulation not CCC/TCC/VPLS
EM -- encapsulation mismatch WE -- interface and instance encaps not same
VC-Dn -- Virtual circuit down NP -- interface hardware not present
CM -- control-word mismatch -> -- only outbound connection is up
CN -- circuit not provisioned <- -- only inbound connection is up
OR -- out of range Up -- operational
OL -- no outgoing label Dn -- down
LD -- local site signaled down CF -- call admission control failure
RD -- remote site signaled down SC -- local and remote site ID collision
LN -- local site not designated LM -- local site ID not minimum designated
RN -- remote site not designated RM -- remote site ID not minimum designated
XX -- unknown connection status IL -- no incoming label
MM -- MTU mismatch MI -- Mesh-Group ID not available
BK -- Backup connection ST -- Standby connection
PF -- Profile parse failure PB -- Profile busy
RS -- remote site standby SN -- Static Neighbor
LB -- Local site not best-site RB -- Remote site not best-site
VM -- VLAN ID mismatch
Legend for interface status
Up -- operational
Dn -- down
Instance: vpl1
Edge protection: Not-Primary
Local site: vpl1PE2 (2)
connection-site Type St Time last up # Up trans
1 rmt Up Jun 17 11:38:14 2015 1
Remote PE: 10.255.255.1, Negotiated control-word: No
Incoming label: 262145, Outgoing label: 262146
Local interface: lsi.1048576, Status: Up, Encapsulation: VPLS
Description: Intf - vpls vpl1 local site 2 remote site 1
Flow Label Transmit: Yes, Flow Label Receive: Yes
Signification
La sortie affiche les informations de connexion VPLS ainsi que les informations de réception et de transmission des étiquettes de flux.
Tableau de l’historique des modifications
La prise en charge des fonctionnalités est déterminée par la plateforme et la version que vous utilisez. Utilisez l’explorateur de fonctionnalités pour déterminer si une fonctionnalité est prise en charge sur votre plateforme.
[edit protocols bgp] niveau de la hiérarchie. Vous pouvez désactiver sélectivement le multichemin sur certains groupes BGP et voisins. Inclure
disable au
[edit protocols bgp group group-name multipath] niveau de la hiérarchie pour désactiver l’option multichemin pour un groupe ou un voisin BGP spécifique.
defer-initial-multipath-build au
[edit protocols bgp] niveau de la hiérarchie. Vous pouvez également réduire la priorité de la tâche de construction BGP multichemin à l’aide d’une
multipath-build-priority instruction de configuration au
[edit protocols bgp] niveau de la hiérarchie pour accélérer l’apprentissage RIB.