
AUF DIESER SEITE
Architektur der Lösung
Die drei im vorherigen Abschnitt beschriebenen Fabrics (Frontend, GPU-Backend und Speicher-Backend) sind in der in Abbildung 2 dargestellten Gesamtarchitektur der KI-JVD-Lösung miteinander verbunden.
Abbildung 2: Architektur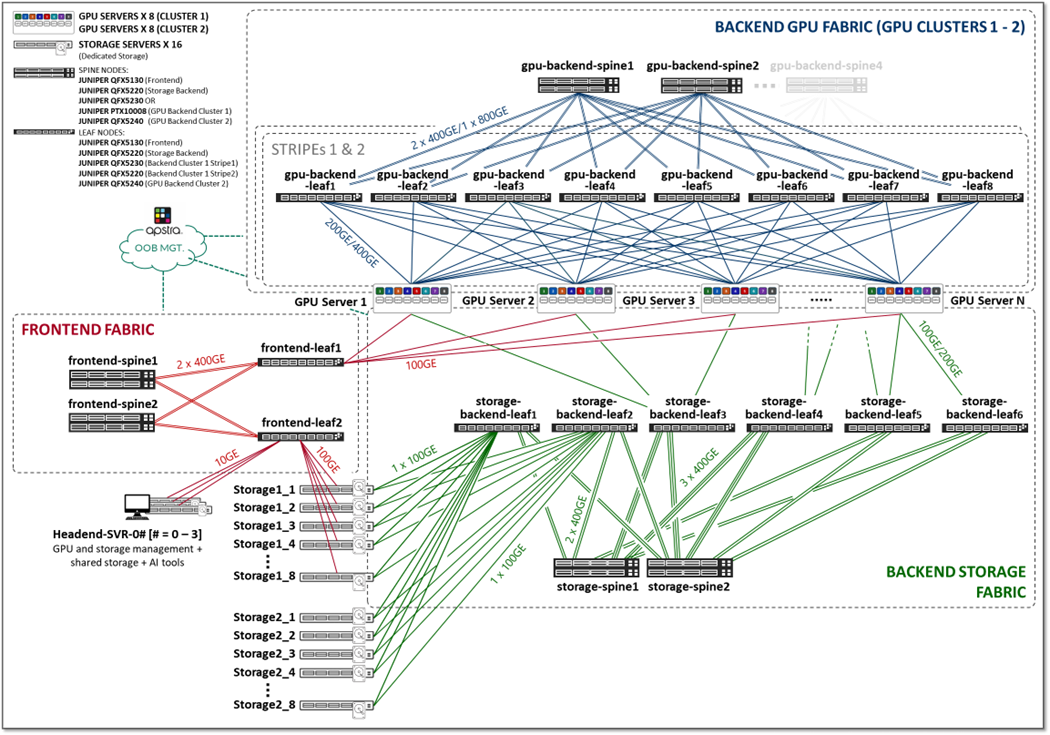 der KI-JVD-Lösung
Frontend Fabric
Die Frontend-Fabric bietet Benutzern die Infrastruktur, um mit den KI-Systemen zu interagieren, um Trainings- und Inferenzaufgaben-Workflows mithilfe von Tools wie SLURM, Kubernetes und anderen KI-Workflow-Managern zu orchestrieren, die sich um die Jobplanung, die Ressourcenzuweisung und das Lebenszyklusmanagement kümmern.
Diese Interaktionen erzeugen keine großen Datenströme und stellen keine strengen Anforderungen an Latenz oder Paketverlust. Infolgedessen stellt der Datenverkehr auf der Steuerungsebene keine strengen Leistungsanforderungen an die Fabric.
Das Frontend-Fabric-Design besteht aus einer 3-stufigen L3-IP-Fabric ohne hohe Verfügbarkeit (Hohe Verfügbarkeit), wie in Abbildung 3 dargestellt. Diese Architektur bietet eine einfache und effektive Lösung für die im Frontend erforderliche Konnektivität. Es kann jedoch jede beliebige Fabric-Architektur einschließlich EVPN/VXLAN verwendet werden. Wenn eine Frontend-Fabric mit hoher Verfügbarkeit erforderlich ist, empfehlen wir, die 3-stufige Lösung mit Juniper Apstra JVD durchzuführen.
Abbildung 3: Frontend-Fabric-Architektur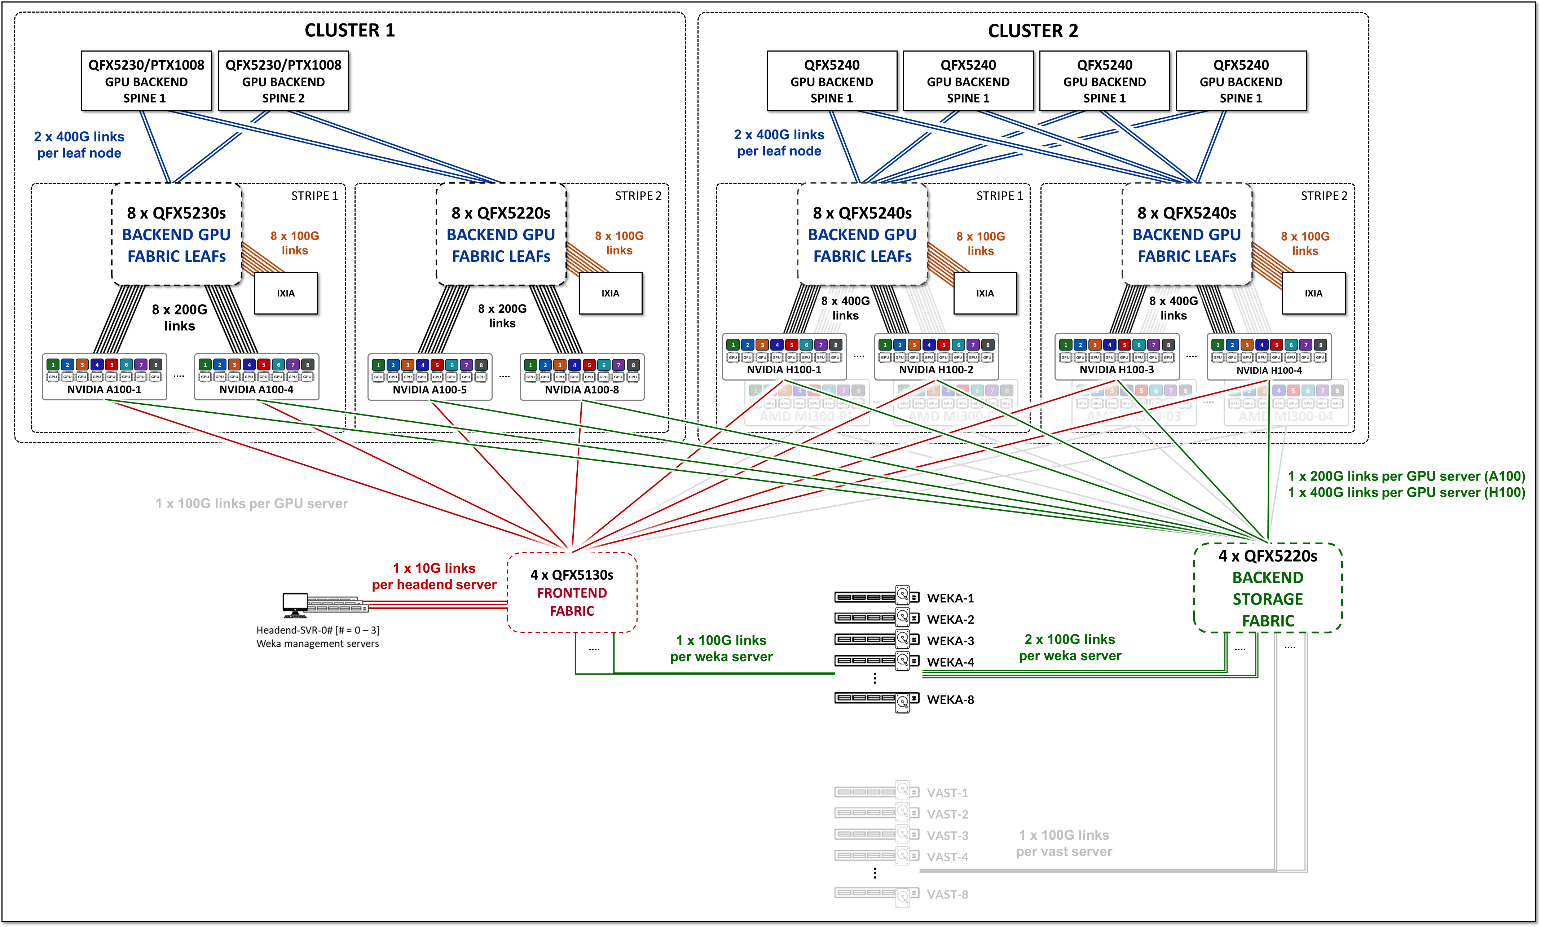
Die Anzahl der Leaf-Knoten hängt von der Anzahl der Server und Speichergeräte im KI Cluster sowie von allen anderen Geräten ab, die für die KI Jobplanung, Ressourcenzuweisung und Lebenszyklusverwaltung verwendet werden.
Die Anzahl der Spine-Knoten hängt vom gewünschten Subskriptionsfaktor für den Versuchsplan ab. Ein 1:1-Abo-Faktor ist nicht erforderlich. Eine moderate Überbelegung ist für den Datenverkehr auf der Steuerungsebene akzeptabel, vorausgesetzt, das Design behält die Ausfallsicherheit bei und vermeidet Überlastungen, die die Stabilität der Steuerungsebene beeinträchtigen würden.
Bei der Fabric handelt es sich um eine L3-IP-Fabric, die EBGP für die Routenankündigung mit IP-Adressierung und EBGP-Konfigurationsdetails verwendet, die im Abschnitt "Netzwerke" dieses Dokuments beschrieben werden. Es ist kein spezieller Load Balancing-Mechanismus erforderlich. ECMP über redundante L3-Pfade ist in der Regel ausreichend.
Da der Datenverkehr auf der Steuerungsebene im Vergleich zu Speicher- oder GPU-Fabrics in der Regel nicht bandbreitenintensiv ist, sind strenge QoS-Mechanismen optional und werden nur empfohlen, wenn Links mit Burst-Datenverkehr ohne Kontrolle geteilt werden.
Die Geräte und Verbindungen in der Frontend-Fabric, die in diesem JVD validiert wurden, sind in den folgenden Tabellen zusammengefasst:
Tabelle 1: Validierte Verwaltungsgeräte und GPU-Server, die mit der Frontend-Fabric verbunden sind
| GPU-Server, | Speichergeräte | , Headend-Server |
|---|---|---|
|
Weka CSE-LB16TS-R860AWP-A |
Supermicro SYS-6019U-TR4 |
Tabelle 2: Validierte Frontend-Fabric-Leaf- und -Spine-Knoten
| Frontend Fabric Leaf Nodes Switch-Modell | Frontend Fabric Spine Nodes Switch-Modell |
|---|---|
| QFX5130-32CD | QFX5130-32CD |
| QFX5220-32CD | QFX5220-32CD |
Tabelle 3: Validierte Verbindungen zwischen Headend-Servern und Leaf-Knoten in der Frontend-Fabric
| Links pro GPU-Server zur Leaf-Verbindung | Servertyp |
|---|---|
| 1 x 10 GE | Supermicro SYS-6019U-TR4 |
Tabelle 4: Validierte Verbindungen zwischen GPU-Servern und Leaf-Knoten im Frontend
| Links pro GPU-Server zur Leaf-Verbindung | Servertyp |
|---|---|
| 1 x 100 GE | NVIDIA A100 |
| 1 x 100 GE | NVIDIA H100 |
Tabelle 5: Validierte Verbindungen zwischen Leaf- und Spine-Knoten im Frontend
| Links pro Leaf- und Spine-Verbindung | Leaf-Knoten-Modell | , Spine-Knoten-Modell |
|---|---|---|
| 2 x 400 GE | QFX5130-32CD | QFX5130-32CD |
Die Tests für dieses JVD wurden mit 8 NVIDIA A100 GPU-Servern und 4 NVIDIA H100 GPU-Servern durchgeführt, die mit zwei Leaf-Knoten verbunden waren, die wiederum mit zwei Spine-Knoten verbunden waren, wie gezeigt:
Abbildung 4: Frontend-Fabric-JVD-Testtopologie
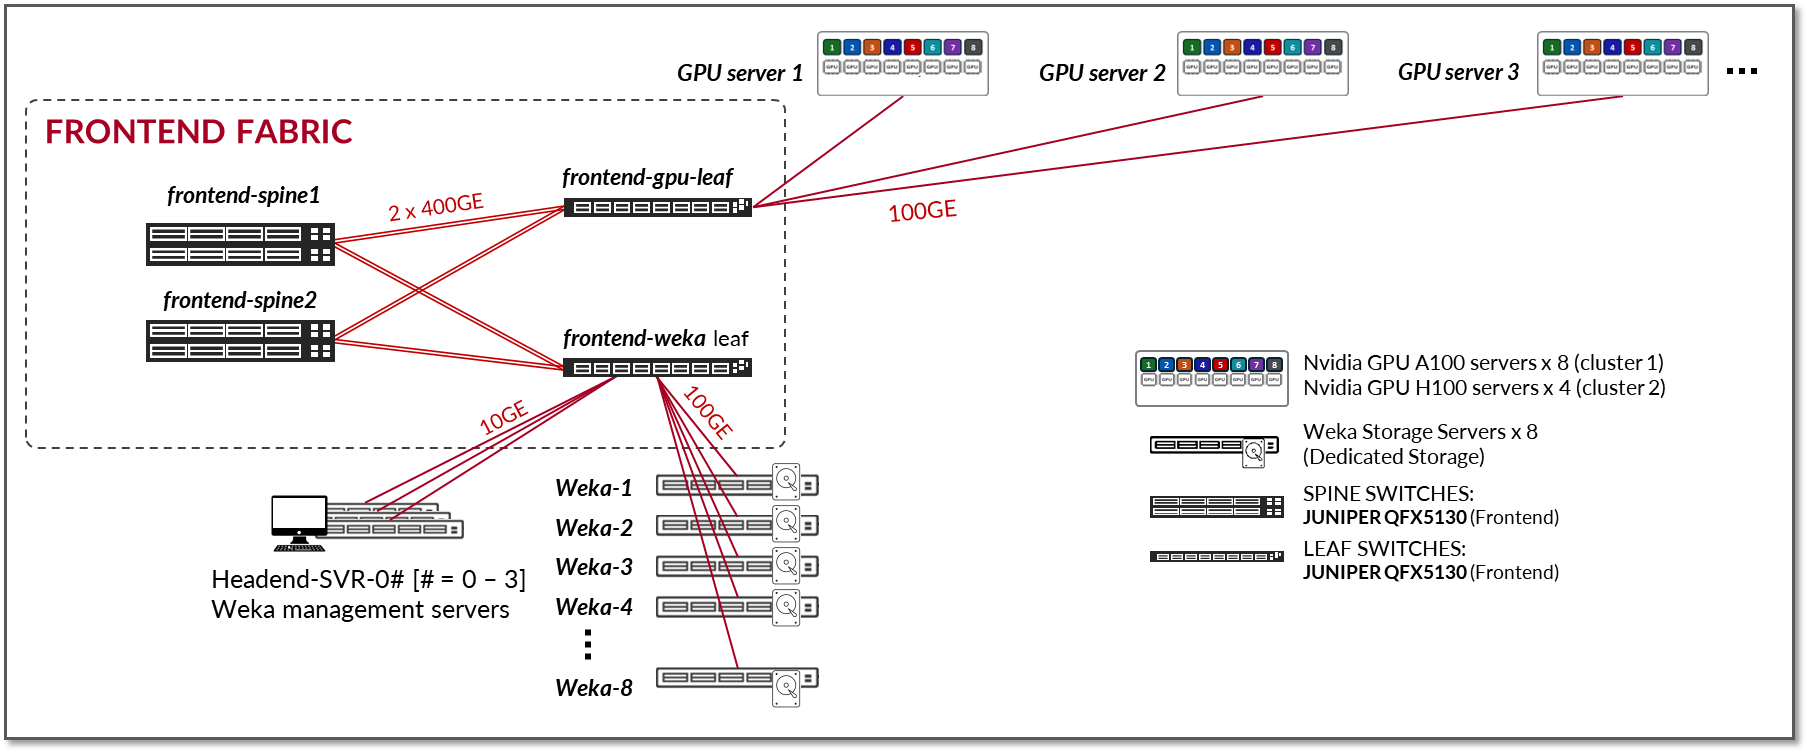
- GPU-Server sind über 100G-Schnittstellen (ConnectX-6/ConnectX-7-NICs) mit den Leaf-Knoten verbunden.
- Weka-Geräte sind über 100G-Schnittstellen mit den Leaf-Knoten verbunden
Tabelle 6: Aggregierte Frontend-GPU-Server <=> Frontend-Leaf-Knoten Anzahl und getestete Bandbreite
| GPU-Server <=> Bandbreite der Frontend-Leaf-Knoten | |
|---|---|
| Anzahl der 100GE-Links GPU-Server ó Frontend-Leaf-Knoten = 12 (1 pro Server) |
12 x 100 GE = 1,2 Tbit/s |
| Anzahl der 100GE-Verbindungen zwischen Speichergerät ó Frontend-Leaf-Knoten = 8 (1 pro Speichergerät) |
8 x 100 GE = 0,8 Tbit/s |
| Gesamtbandbreite = | 2,0 Tbit/s |
Tabelle 7: Aggregierte Frontend-Leaf-Knoten <=> Frontend-Spine-Knoten Anzahl und getestete Bandbreite
| Frontend-Leaf-Knoten <=> Bandbreite der Frontend-Spine-Knoten | ||
|---|---|---|
| Anzahl der 400GE-Verbindungen zwischen Frontend-Leaf-Knoten und Spine-Knoten = 8 (2 Leaf-Knoten x 2 Spines-Knoten x 2 Links pro Leaf-to-Spine-Verbindung) |
8 x 400 GE = 3,2 Tbit/s | |
| Gesamtbandbreite = | 3,2 Tbit/s | |
| Kein Überabonnement. | ||
GPU-Backend-Fabric
Die GPU-Backend-Fabric stellt die Infrastruktur für GPUs bereit, um innerhalb eines Clusters über RDMA over Converged Ethernet (RoCEv2) miteinander zu kommunizieren. ROCEv2 steigert die Effizienz von Datencentern, reduziert die Gesamtkomplexität und erhöht die Datenbereitstellungsleistung, indem es den GPUs ermöglicht, wie mit dem InfiniBand-Protokoll zu kommunizieren.
Im Gegensatz zur Frontend-Fabric überträgt die GPU-Backend-Fabric Datenverkehr auf der Datenebene, der sowohl bandbreitenintensiv als auch latenzempfindlich ist. Paketverlust, übermäßige Latenz oder Jitter können die Bearbeitungsdauer von Jobs erheblich beeinträchtigen und müssen daher vermieden werden. Daher besteht eines der primären Designziele der GPU-Backend-Fabric darin, eine nahezu verlustfreie Ethernet-Fabric bereitzustellen und gleichzeitig maximalen Durchsatz, minimale Latenz und minimale Netzwerkinterferenzen für den GPU-zu-GPU-Datenverkehr zu liefern. RoCEv2 arbeitet am effizientesten in Umgebungen, in denen Paketverluste minimiert werden, und trägt so direkt zu optimalen Job-Abschlusszeiten bei.
Die GPU-Backend-Fabric in diesem JVD wurde entwickelt, um diese Anforderungen zu erfüllen. Das Design folgt einer 3-stufigen IP Clos, Rail Optimized Stripe-Architektur, wie in Abbildung 5 dargestellt. Details zur Rail-optimierten Stripe-Architektur werden in einem späteren Abschnitt beschrieben.
Abbildung 5: GPU-Backend-Fabric-Architektur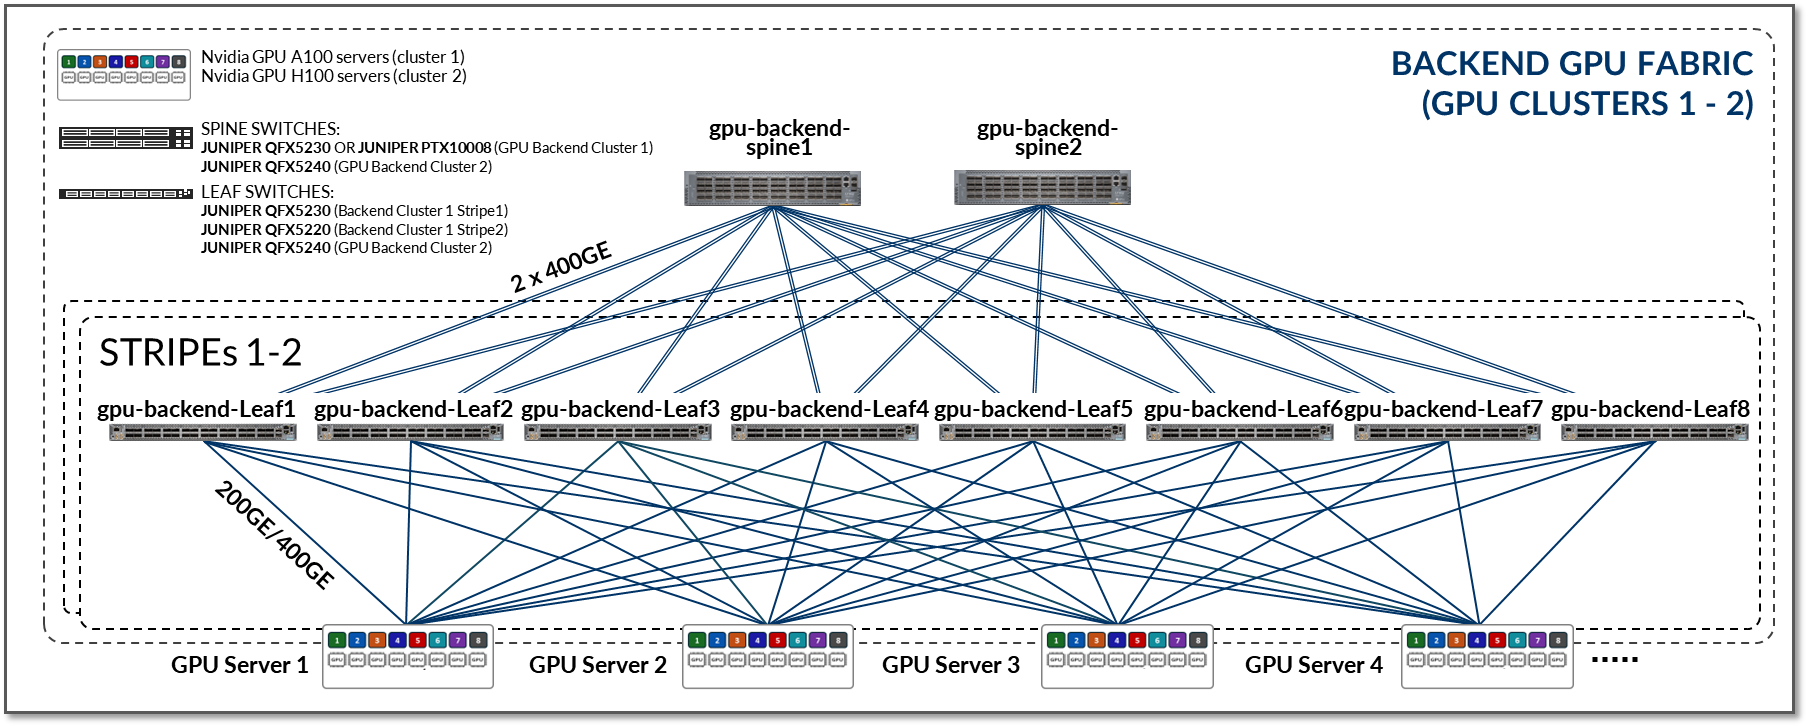
Die Fabric arbeitet als L3-IP-Fabric, die EBGP für die Routenankündigung mit IP-Adressierung und EBGP-Konfigurationsdetails verwendet, die im Abschnitt "Netzwerke" dieses Dokuments beschrieben werden.
In einer Rail-optimierten Architektur wird die Anzahl der Leaf-Knoten durch die Anzahl der GPUs pro Server bestimmt, die für die in diesem JVD enthaltenen Nvidia-Server 8 beträgt. Die Anzahl der Spine-Knoten sowie die Geschwindigkeit und Anzahl der Verbindungen zwischen GPU-Servern und Leaf-Knoten sowie zwischen Leaf- und Spine-Knoten bestimmen die effektive Bandbreite und die Überbelegungseigenschaften der GPU-Backend-Fabric.
Im Gegensatz zur Frontend-Fabric erfordert die GPU-Backend-Fabric ein nicht überzeichnetes Design (1:1-Abonnementfaktor), um eine ausreichende Bandbreite für den hohen RoCEv2-Datenverkehr zu gewährleisten und Überlastung, Paketverluste und übermäßige Latenzzeiten zu vermeiden.
Die Verteilung des Datenverkehrs innerhalb des GPU-Backend-Fabric basiert auf ECMP über mehrere L3-Pfade zu gleichen Kosten in Kombination mit fortschrittlichen Load Balancing-Techniken wie dynamischem Load Balancing (DLB), globalem Load Balancing und adaptivem Load Balancing (ALB). Diese werden im Abschnitt Load Balancing dieses Dokuments beschrieben.
Da die GPU-Backend-Fabric RoCEv2-Datenverkehr überträgt, der empfindlich auf Verluste und Latenzzeiten reagiert, umfasst das Design DCQCN (Data Center Quantized Congestion Notification), das ECN (Explicit Congestion Notification) nutzt und optional PFC (Priority Flow Control) verwenden kann, um ein verlustfreies oder nahezu verlustfreies Verhalten für RDMA-Datenverkehr zu erreichen. Diese Mechanismen werden im Abschnitt "Class of Service" dieses Dokuments ausführlich beschrieben.
Die in diesem JVD validierten Geräte und Verbindungen in der GPU-Backend-Fabric sind in den folgenden Tabellen zusammengefasst:
Tabelle 8: Validierte Verwaltungsgeräte und GPU-Server, die mit der GPU-Backend-Fabric verbunden sind.
| GPU-Server, | Speichergeräte | , Headend-Server |
|---|---|---|
|
Weka CSE-LB16TS-R860AWP-A |
Supermicro SYS-6019U-TR4 |
Tabelle 9: Validierte GPU-Backend-Fabric-Leaf-Knoten
| GPU-Backend-Fabric-Leaf-Nodes-Switch-Modell |
|---|
| QFX5220-32CD |
| QFX5230-64CD |
| QFX5240-64OD |
| QFX5241-64OD |
Tabelle 10: Validierte GPU-Backend-Fabric-Spine-Knoten
| GPU-Backend-Fabric-Spine-Knoten Switch-Modell |
|---|
| QFX5230-64CD |
| QFX5240-64OD |
| QFX5241-64OD |
| PTX10008 LC1201 |
| PTX10008 LC1301 |
Tabelle 11: Validierte Verbindungen zwischen GPU-Servern und Leaf-Knoten in der GPU-Backend-Fabric
| Links pro GPU-Server zur Leaf-Verbindung | Servertyp |
|---|---|
| 1 x 200 GE | NVIDIA A100 |
| 1 x 400GE-Verbindungen pro GPU-Server zur Leaf-Verbindung | NVIDIA H100 |
Tabelle 12: Validierte Verbindungen zwischen Leaf- und Spine-Knoten in der GPU-Backend-Fabric
| Links pro Leaf- und Spine-Verbindung | Leaf-Knoten-Modell | , Spine-Knoten-Modell |
|---|---|---|
| 1 x 400 GE | QFX5220-32CD | QFX5230-32CD |
| 1 x 400 GE | QFX5230-32CD | QFX5230-32CD |
| 2 x 400 GE | QFX5240-64OD | QFX5240-64OD |
| 1 x 800 GE | QFX5240-64OD | QFX5240-64OD |
| 1 x 400 GE | QFX5220-32CD | PTX10008 LC1201 |
| 1 x 400 GE | QFX5230-32CD | PTX10008 LC1201 |
| 1 x 800 GE | QFX5240-64OD | PTX10008 LC1301 |
| 2 x 800 GE | QFX5240-64OD | PTX10008 LC1301 |
Die Tests für dieses JVD wurden mit 8 NVIDIA A100 GPU-Servern und 4 NVIDIA H100 GPU-Servern durchgeführt, die mit zwei Stripes verbunden waren, wie gezeigt:
Abbildung 6: GPU-Backend-Fabric-JVD-Testtopologie
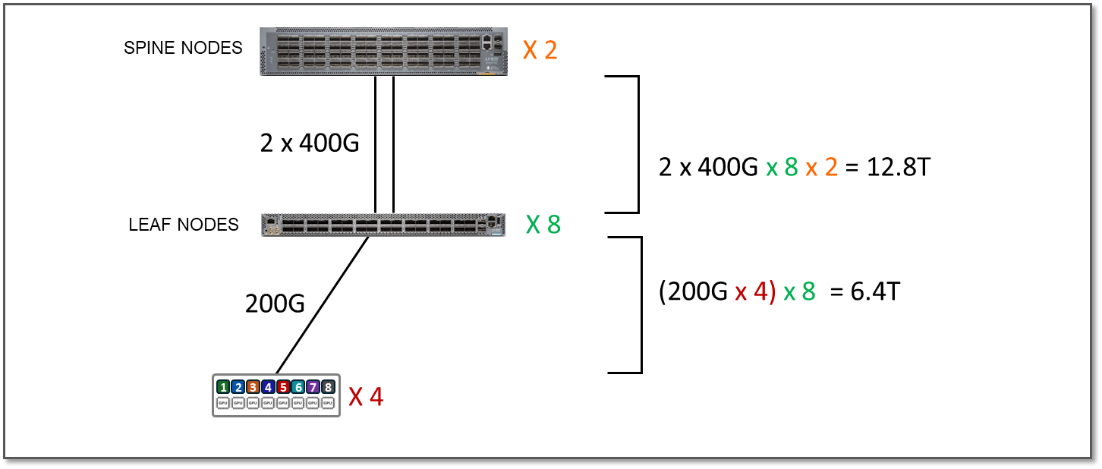
- Jeder Nvidia A100-Server ist über 200G-Schnittstellen (ConnectX-7-NICs) mit den Leaf-Knoten verbunden.
- Jeder Nvidia H100-Server ist über 400G-Schnittstellen (ConnectX-7-NICs) mit den Leaf-Knoten verbunden.
Tabelle 13: Server-zu-Leaf-Bandbreite pro Stripe
| Streifen | Anzahl der Server pro Stripe |
Anzahl der Server <=> Leaf-Links pro Server (entspricht der Anzahl der Leaf-Knoten und der GPUs pro Server) |
Server-<=> Leaf-Link-Bandbreite [Gbit/s] |
Server insgesamt <=> Leaf-Links Bandbreite pro Stripe [Tbit/s] |
|---|---|---|---|---|
| 1 | 2 H100 | 8 | 400 Gbit/s | 2 x 8 x 400 Gbit/s = 6,4 Tbit/s |
| 4 DIN A100 | 8 | 200 Gbit/s | 4 x 8 x 200 Gbit/s = 6,4 Tbit/s | |
| 2 | 2 H100 | 8 | 400 Gbit/s | 2 x 8 x 400 Gbit/s = 6,4 Tbit/s |
| 4 DIN A100 | 8 | 200 Gbit/s | 4 x 8 x 200 Gbit/s = 6,4 Tbit/s | |
| Server-< insgesamt = > Leaf-Bandbreite | 25,6 Tbit/s | |||
Tabelle 14: Bandbreite pro Stripe Leaf to Spine mit QFX5240 als Leaf und Spines
| Streifen | Anzahl der Leaf-Knoten |
Anzahl der Spine-Knoten | Anzahl der 400 Gbit/s Leaf-<=> Spine Links pro Leaf-Knoten |
Server <=> Leaf Bandbreite der Verbindung [Gbit/s] |
Bandbreite Leaf-<=> Spine pro Stripe [Tbit/s] |
|---|---|---|---|---|---|
| 1 | 8 | 4 | 2 | 400 | 8 x 2 x 2 x 400 Gbit/s = 12,8 Tbit/s |
| 2 | 8 | 4 | 2 | 400 | 8 x 2 x 2 x 400 Gbit/s = 12,8 Tbit/s |
| Server-< insgesamt = > Leaf-Bandbreite | 25,6 Tbit/s | ||||
GPU-Backend-Fabric-Abonnementfaktor
Der Abonnementfaktor wird einfach berechnet, indem die Zahlen aus den beiden obigen Tabellen verglichen werden:
In der JVD-Testumgebung beträgt die Bandbreite zwischen den Servern und den Leaf-Knoten 25,6 Tbit/s pro Stripe, während die verfügbare Bandbreite zwischen den Leaf- und Spine-Knoten 25,6 Tbit/s pro Stripe beträgt. Das bedeutet, dass die Fabric über genügend Kapazität verfügt, um den gesamten Datenverkehr zwischen den GPUs zu verarbeiten, selbst wenn dieser Datenverkehr zu 100 % Inter-Stripe war. Jetzt gibt es jedoch keine zusätzliche Kapazität für zusätzliche Server. Der Abo-Faktor beträgt in diesem Fall 1:1 (kein Abo).
Abbildung 7: 1:1 Abonnementfaktor
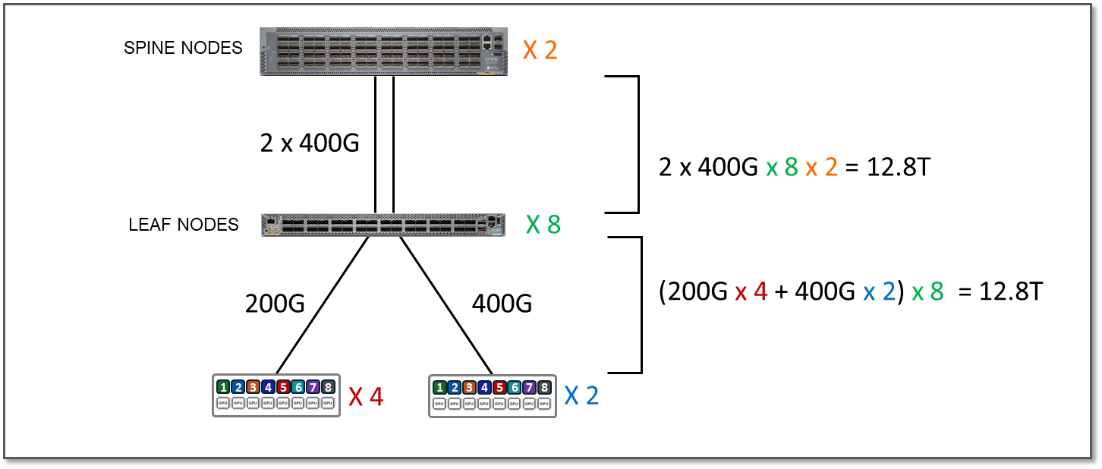
Um Überbelegungstests durchzuführen, wurden einige der Schnittstellen zwischen dem Leaf und den Spines deaktiviert, wodurch die verfügbare Bandbreite reduziert wurde, wie im Beispiel in Abbildung 8 gezeigt:
Abbildung 8: 2:1 Zeichnungsfaktor (Überbelegung)
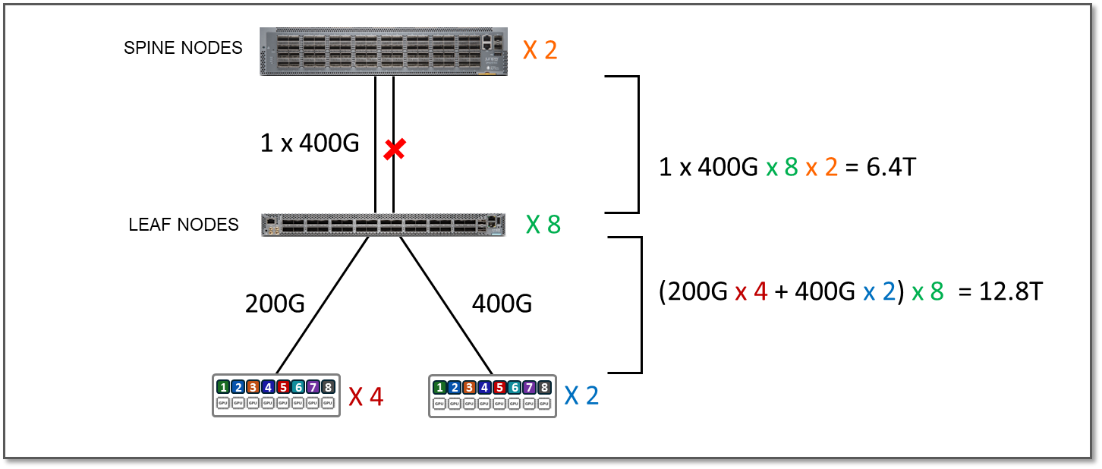
Die Gesamtbandbreite von Servern zu Leaf-Links pro Stripe hat sich nicht geändert. Es sind immer noch 12,8 Tbit/s, wie in Tabelle 15 im vorherigen Szenario dargestellt.
Allerdings beträgt die verfügbare Bandbreite zwischen den Leaf- und Spine-Knoten jetzt nur noch 6,4 Tbit/s pro Stripe.
Tabelle 15: Bandbreite pro Stripe Leaf to Spine
| Leaf-to-Spine-Bandbreite pro Stripe | |||
| Leaf <=> Spine-Links pro Spine-Knoten und pro Stripe | Geschwindigkeit von Leaf-<=> Spine-Links [Gbit/s] |
Anzahl der Spine-Knoten | Gesamtbandbreite Leaf-<=> Spine pro Stripe [Tbit/s] |
| 8 | 1 x 400 cm | 2 | 6.4 |
Das bedeutet, dass die Fabric nicht mehr über genügend Kapazität verfügt, um den gesamten Datenverkehr zwischen den GPUs zu verarbeiten, selbst wenn dieser Datenverkehr zu 100 % Inter-Stripe ist, was zu Überlastung und Datenverkehrsverlust führen kann. Der Überzeichnungsfaktor beträgt in diesem Fall 2:1.
Die Ergebnisse der Überlastungs- und Fehlertests sind im JVD-Testbericht enthalten.
Optimierung der GPU-zu-GPU-Kommunikation
Die Optimierung in Rail-optimierten Topologien bezieht sich darauf, wie die GPU-Kommunikation verwaltet wird, um Überlastung und Latenz zu minimieren und gleichzeitig den Durchsatz zu maximieren. Ein wichtiger Teil dieser Optimierungsstrategie besteht darin, den Verkehr nach Möglichkeit lokal zu halten. Indem sichergestellt wird, dass die GPU-Kommunikation innerhalb derselben Schiene oder desselben Stripes oder sogar innerhalb des Servers bleibt, wird die Notwendigkeit des Durchlaufens von Spines oder externen Verbindungen reduziert, was die Latenz senkt, Überlastungen minimiert und die Gesamteffizienz steigert.
Während die Lokalisierung des Datenverkehrs Priorität hat, wird in größeren GPU-Clustern die Kommunikation zwischen den Stripes erforderlich sein. Die Kommunikation zwischen den Stripes wird durch geeignete Routing- und Balancing-Techniken über die verfügbaren Verbindungen optimiert, um Engpässe und Paketverluste zu vermeiden.
Das Wesentliche der Optimierung besteht darin, die Topologie zu nutzen, um den Datenverkehr über die kürzesten und am wenigsten überlasteten Pfade zu leiten und so eine gleichbleibende Leistung auch bei wachsendem Netzwerk zu gewährleisten. Der Datenverkehr zwischen GPUs auf denselben Servern kann lokal über die interne Server-Fabric weitergeleitet werden (herstellerabhängig), während der Datenverkehr zwischen GPUs auf verschiedenen Servern über die externe GPU-Backend-Infrastruktur erfolgt. Die Kommunikation zwischen GPUs auf verschiedenen Servern kann Intra-Rail oder Inter-Rail/Inter-Stripe erfolgen.
Der Intra-Rail-Datenverkehr wird auf dem lokalen Leaf-Knoten geschaltet (verarbeitet auf Layer 2). Diesem Design folgend, werden Daten zwischen GPUs auf verschiedenen Servern (aber im selben Stripe) immer auf derselben Schiene und über einen einzigen Switch verschoben. Dies garantiert, dass die GPUs 1 Hop voneinander entfernt sind und separate, unabhängige Kanäle mit hoher Bandbreite erstellen, die Konflikte minimieren und die Leistung maximieren. Andererseits wird der Inter-Rail-/Inter-Stripe-Datenverkehr über die IRB-Schnittstellen auf den Leaf-Knoten und den Spine-Knoten, die die Leaf-Knoten verbinden (verarbeitet auf Layer 3), geleitet.
Betrachten Sie das in Abbildung 8 dargestellte Beispiel
- Die Kommunikation zwischen GPU 1 und GPU 2 in Server 1 erfolgt über die interne Fabric des Servers (1)
- Die Kommunikation zwischen den GPUs 1 in den Servern 1 bis 4 und zwischen den GPUs 8 in den Servern 1 bis 4 erfolgt über Leaf 1 bzw. Leaf 8 (2) und
- Die Kommunikation zwischen GPU 1 und GPU 8 (in den Servern 1 bis 4) erfolgt über leaf1, die Spine-Knoten und leaf8 (3)
Abbildung 8: Inter-Rail- vs. Intra-Rail-GPU-GPU-Kommunikation
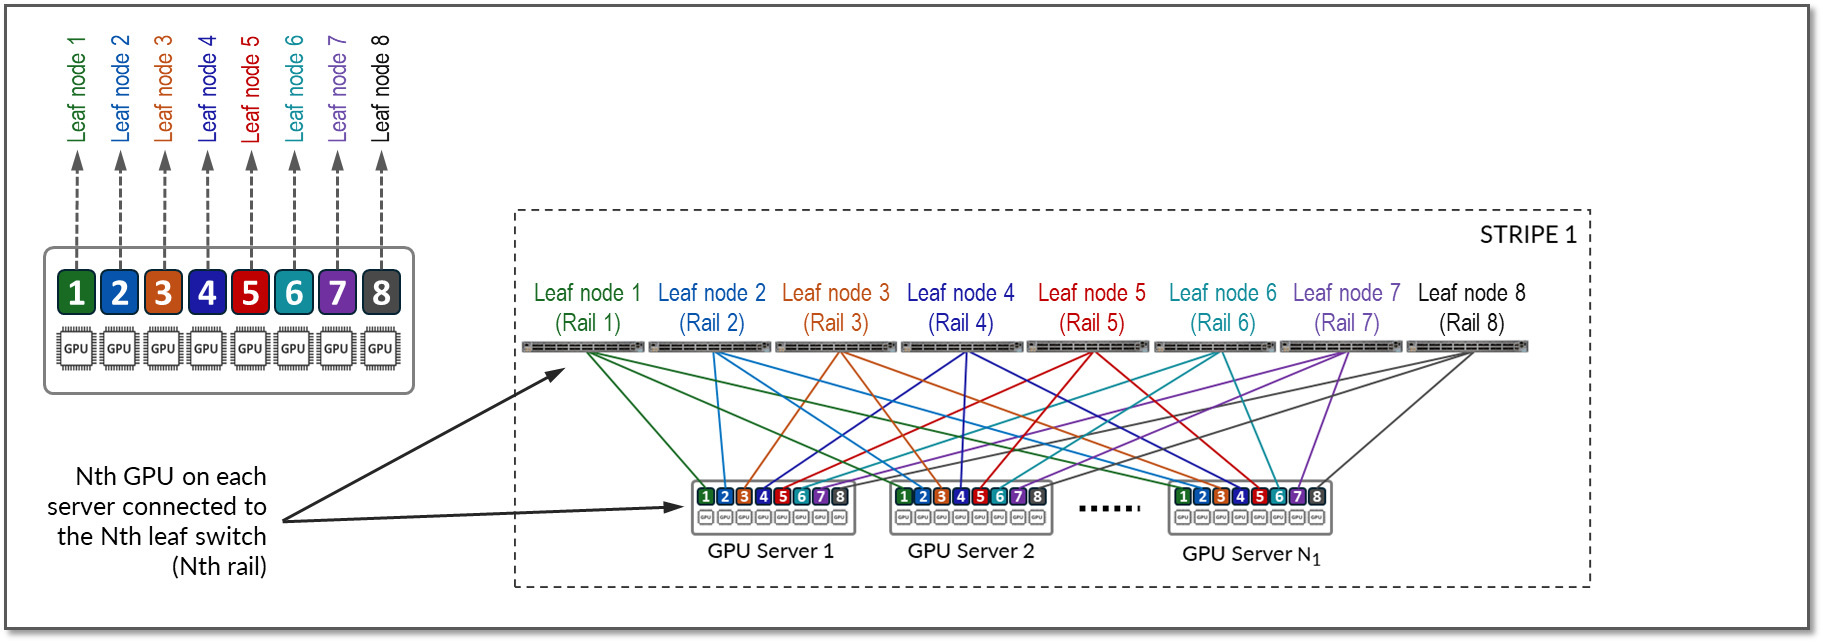
Abbildung 10 stellt eine Topologie mit einem Streifen und 8 Schienen dar, die die GPUs 1 bis 8 mit den Leaf-Switches 1 bis 8 verbinden.
Die Kommunikation zwischen GPU 7 und GPU 8 in Server 1 erfolgt über die interne Fabric, während die Kommunikation zwischen GPU 1 in Server 1 und GPU 1 in Server N1 über Leaf-Switch 1 (innerhalb derselben Schiene) erfolgt.
Beachten Sie, dass, wenn eine Kommunikation zwischen GPUs in verschiedenen Stripes und verschiedenen Servern erforderlich ist (z. B. GPU 4 in Server 1 kommuniziert mit GPU 5 in Server N1), die Daten zuerst zu einer GPU-Schnittstelle in derselben Rail wie die Ziel-GPU verschoben werden, sodass Daten an die Ziel-GPU gesendet werden, ohne die Schienen zu überschreiten.
Diesem Design folgend, werden Daten zwischen GPUs auf verschiedenen Servern (aber im selben Stripe) immer auf derselben Schiene und über einen einzigen Switch verschoben, wodurch garantiert wird, dass die GPUs 1 Hop voneinander entfernt sind und separate, unabhängige Kanäle mit hoher Bandbreite entstehen, die Konflikte minimieren und die Leistung maximieren.
Auf NVIDIA H100s-GPU-Servern sind die GPUs über NVLink und NVswitches miteinander verbunden, die eine bidirektionale GPU-zu-GPU-Kommunikation mit hoher Bandbreite und niedriger Latenz mit 400 Gbit/s innerhalb eines einzelnen Servers ermöglichen (siehe Abbildung 9).
Abbildung 9: NVIDIA HGX/DGX GPU-Interconnect-Architektur
Weitere Informationen finden Sie unter Einführung in NVIDIA DGX H100/H200-Systeme — NVIDIA DGX H100/H200-Benutzerhandbuch
NVIDIA-GPUs nutzen NVLink und NVSwitch , um eine Kommunikation mit hoher Bandbreite und niedriger Latenz zwischen GPUs, CPUs und anderen Systemkomponenten bereitzustellen. Diese Interconnect-Fabric verwaltet dynamisch den Datenverkehr über mehrere Links, bietet optimierte Pfade für die GPU-Kommunikation innerhalb des Knotens und ermöglicht effiziente kollektive Operationen.
Standardmäßig implementieren NVIDIA-GPU-Plattformen topologieorientiertes Routing und lokale Optimierung mithilfe von PXN (Parallel Execution Networks), um die Latenz für den Datenverkehr von GPU zu GPU zu minimieren. Die Kommunikation zwischen GPUs auf denselben Servern wird über die Infinity Fabric weitergeleitet und bleibt innerhalb des Knotens und durchläuft nicht die externe Ethernet-Fabric. Der Datenverkehr zwischen GPUs desselben Ranges über mehrere Server bleibt innerhalb des Stripes.
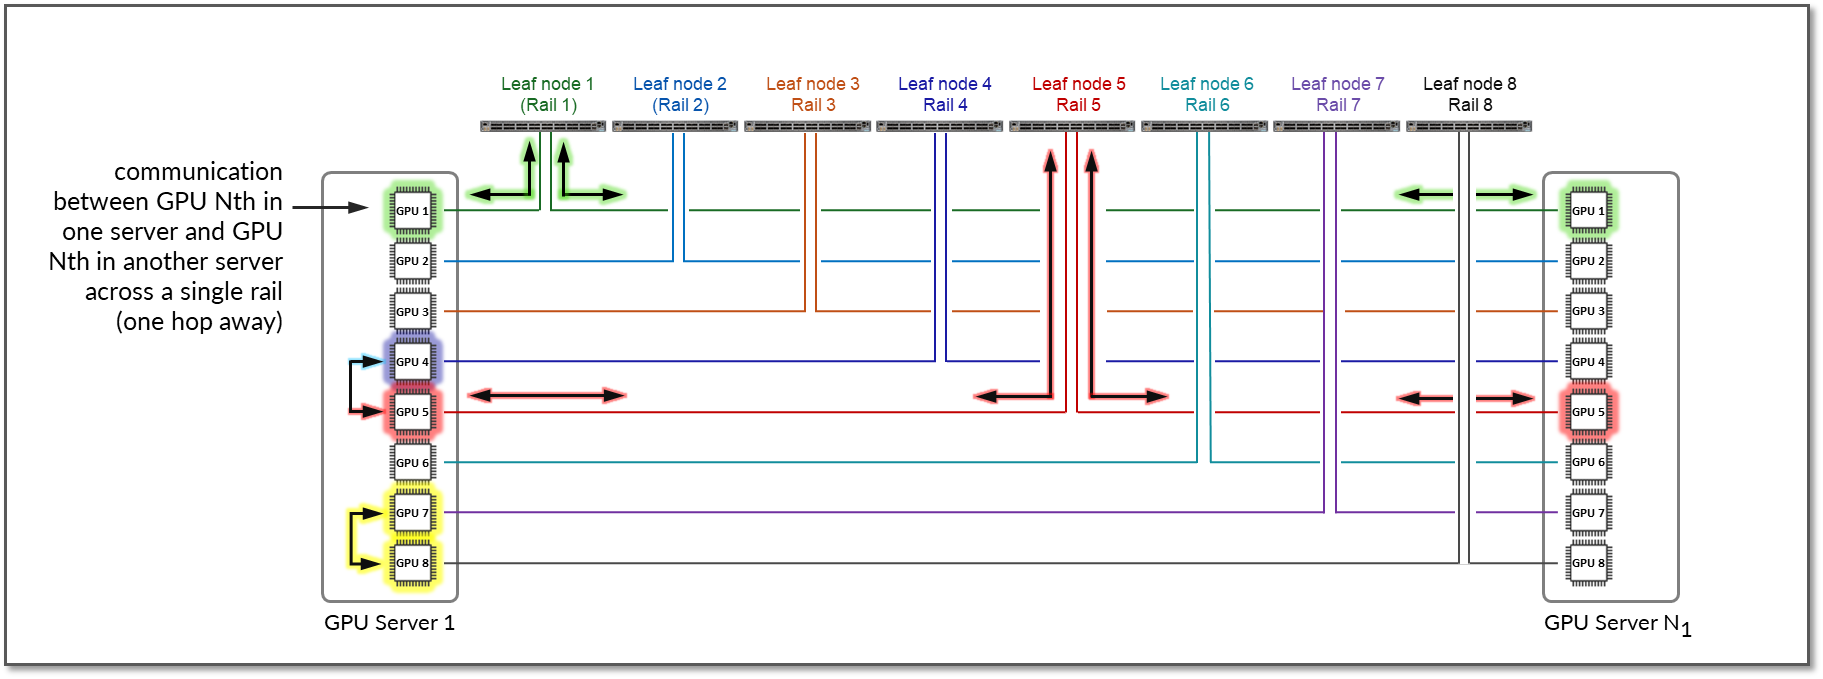
Abbildung 12 zeigt ein Beispiel, in dem GPU1 in Server 1 mit GPU1 in Server 2 kommuniziert. Der Datenverkehr wird von Leaf Node 1 weitergeleitet und verbleibt innerhalb von Rail 1.
Wenn GPU4 in Server 1 mit GPU5 in Server 2 kommunizieren möchte und GPU5 in Server 1 als lokaler Hop in AMDs Infinity Fabric verfügbar ist, bevorzugt der Datenverkehr natürlich diesen Pfad, um die Leistung zu optimieren und die Kommunikation zwischen GPUs innerhalb der Schiene aufrechtzuerhalten.
Abbildung 10: GPU-zu-GPU-Interrail-Kommunikation zwischen zwei Servern mit lokaler Optimierung.
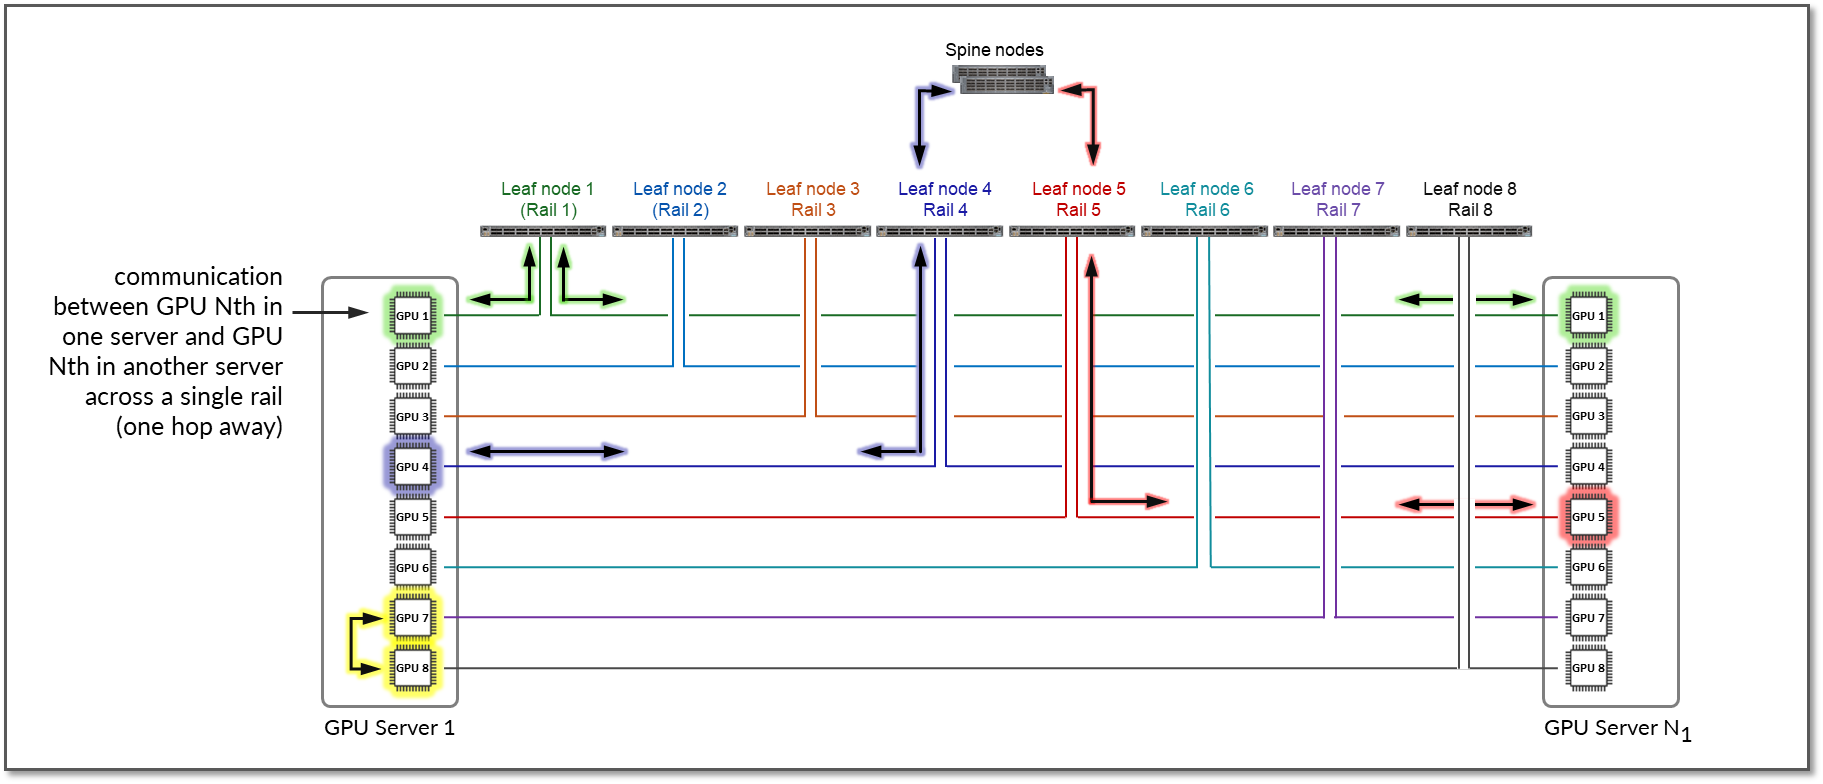
Wenn eine lokale Optimierung beispielsweise aufgrund von Einschränkungen bei der Arbeitsauslastung nicht möglich ist, muss der Datenverkehr lokale Hops (interne Fabric) umgehen und RDMA (Off-Node NIC-basierte Kommunikation) verwenden. In einem solchen Fall kommuniziert GPU4 in Server 1 mit GPU5 in Server 2, indem Daten mithilfe von RDMA direkt über die NIC gesendet werden, die dann über die Fabric weitergeleitet werden, wie in Abbildung 11 dargestellt.
Abbildung 11: GPU-zu-GPU-Inter-Rail-Kommunikation zwischen zwei Servern ohne lokale Optimierung.
Das Beispiel zeigt, dass die Kommunikation zwischen GPU 4 in Server 1 und GPU 5 in Server N1 über Leaf-Switch 1, die Spine-Knoten und Leaf-Switch 5 (zwischen zwei verschiedenen Rails) erfolgt.
Backend-GPU Rail-optimierte Stripe-Architektur
Wie bereits beschrieben, bietet eine Rail-optimierte Stripe-Architektur einen effizienten Datentransfer zwischen GPUs, insbesondere bei rechenintensiven Aufgaben wie Trainingsworkloads für KI-Large-Language-Modelle (LLM), bei denen eine nahtlose Datenübertragung erforderlich ist, um die Aufgaben innerhalb eines angemessenen Zeitrahmens zu erledigen. Eine Rail-optimierte Topologie zielt darauf ab, die Leistung zu maximieren, indem sie minimale Bandbreitenkonflikte, minimale Latenzzeiten und minimale Netzwerkinterferenzen bietet und sicherstellt, dass Daten effizient und zuverlässig über das Netzwerk übertragen werden können.
In einer Rail-optimierten Stripe-Architektur gibt es zwei wichtige Konzepte: Rail und Stripe.
Die GPUs auf einem Server sind von 1 bis 8 nummeriert, wobei die Zahl die Position der GPU auf dem Server darstellt, wie in Abbildung 6 dargestellt. Diese Zahl wird manchmal als Rang oder genauer gesagt als "lokaler Rang" in Bezug auf die GPUs auf dem Server, auf dem sich die GPU befindet, oder als "globaler Rang" in Bezug auf alle GPUs (auf mehreren Servern) bezeichnet, die einem einzigen Job zugewiesen sind.
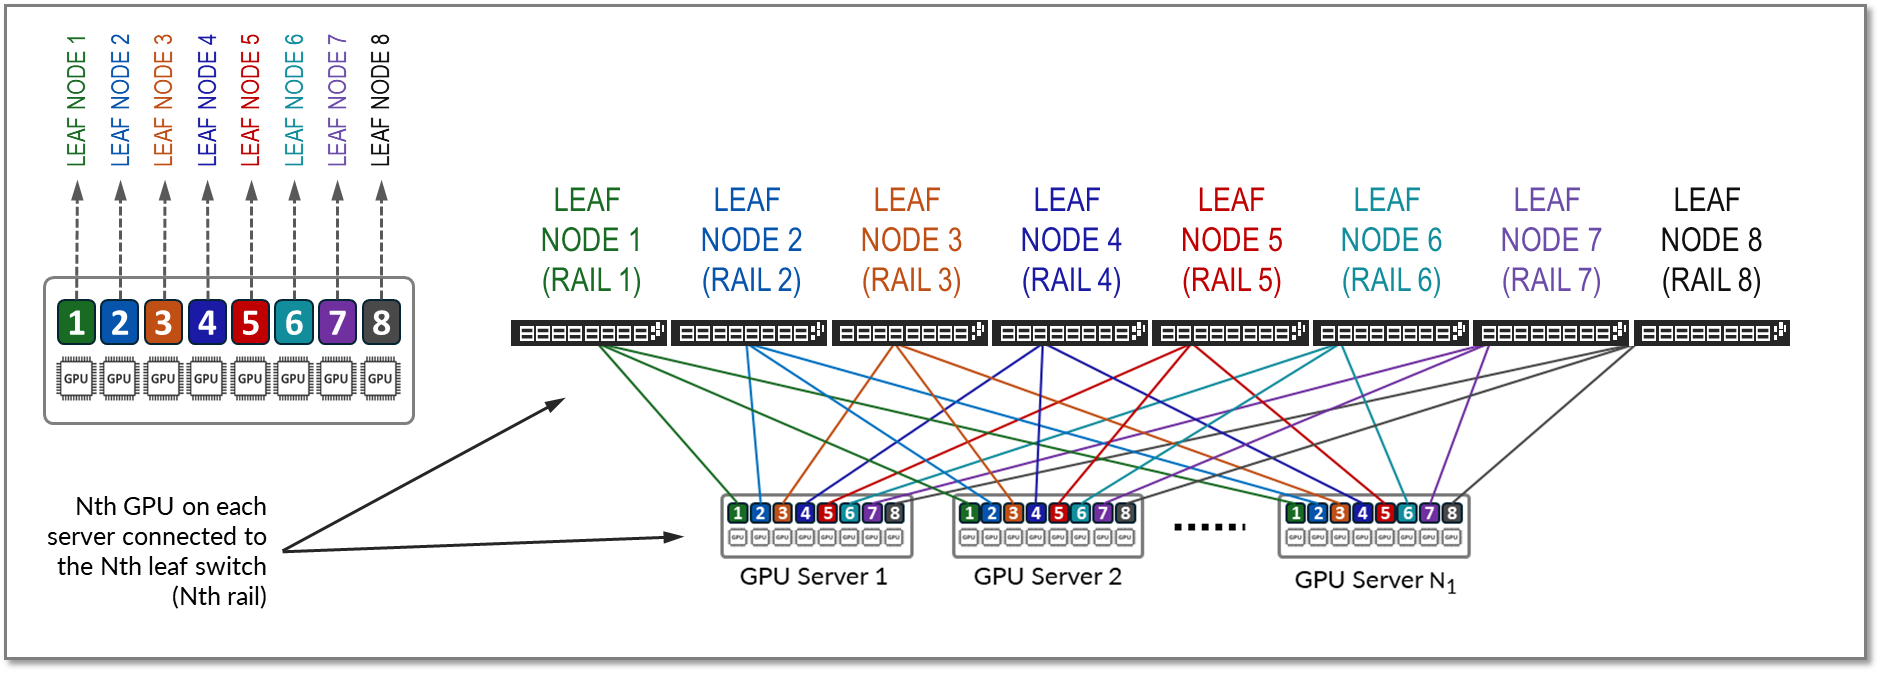
Eine Schiene verbindet GPUs derselben Ordnung über einen der Leaf-Knoten in der Fabric. Das heißt, Rail Nth verbindet alle GPUs in Position Nth auf allen Servern mit dem Leaf-Knoten Nth, wie in Abbildung 10 dargestellt.
Abbildung 10: Rails in einer Rail-optimierten Architektur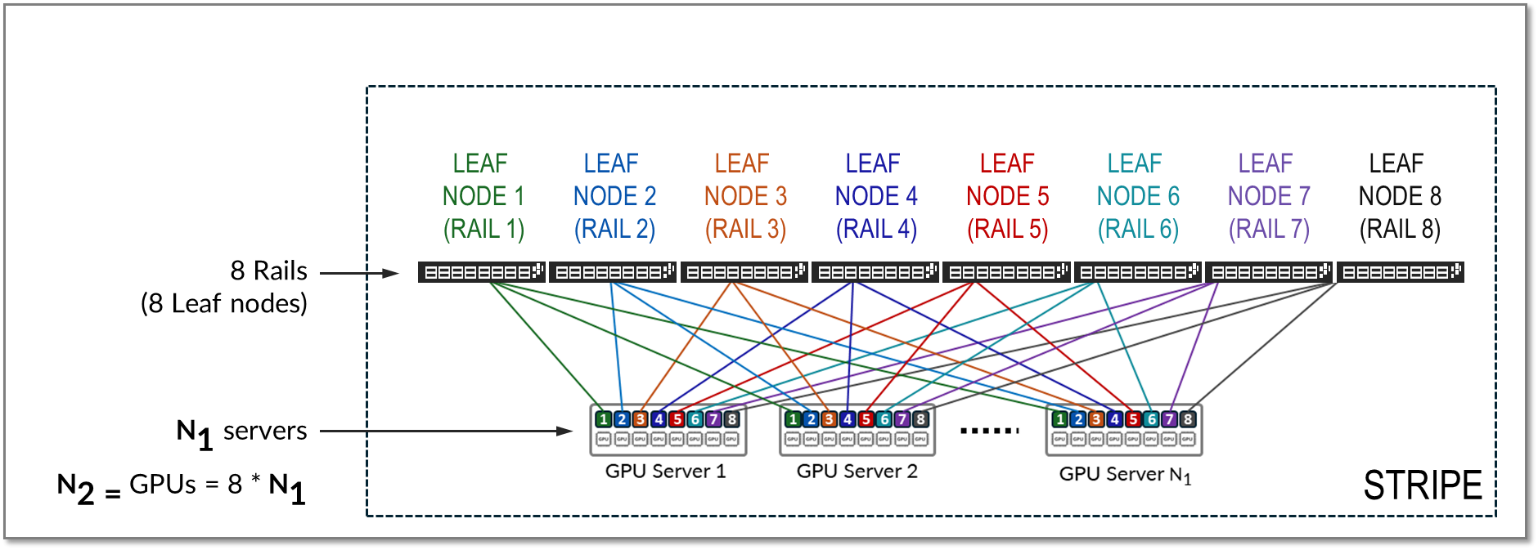
Ein Stripe bezieht sich auf ein Design-Modul oder einen Baustein, der aus mehreren Rails besteht und eine Reihe von Leaf-Knoten und GPU-Servern umfasst, wie in Abbildung 11 dargestellt. Dieser Baustein kann repliziert werden, um den KI-Cluster zu skalieren.
Abbildung 11: Stripes in einer Rail-optimierten Architektur
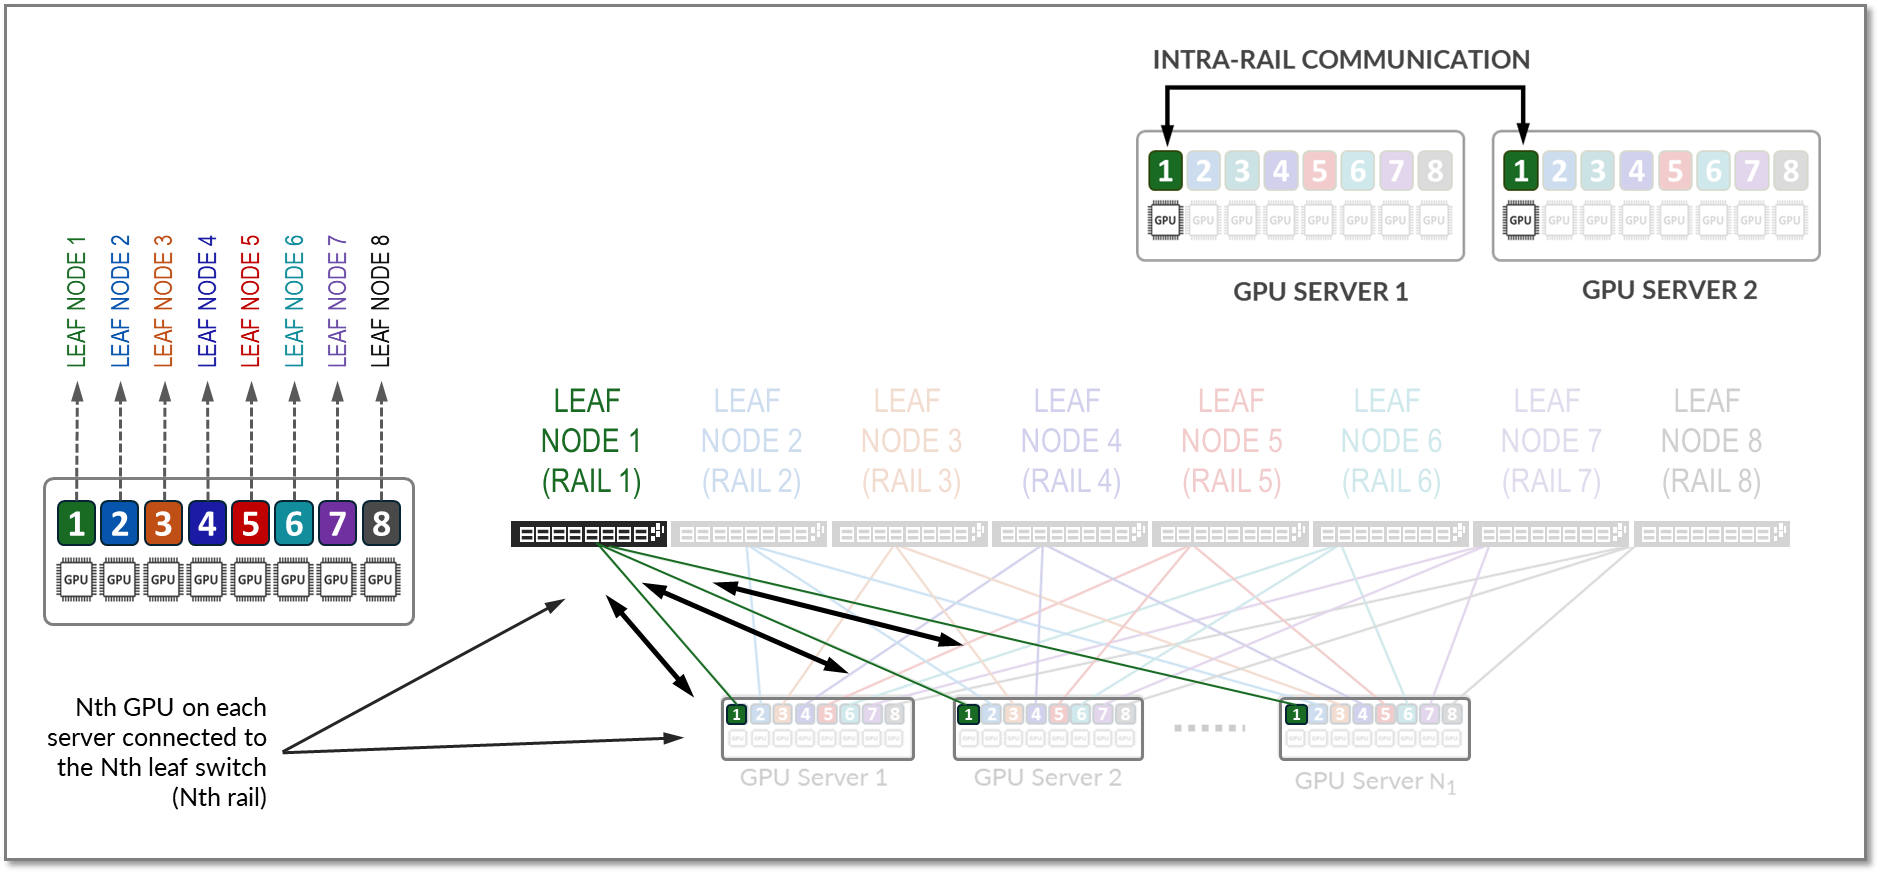
Der gesamte Datenverkehr zwischen GPUs desselben Ranges (Intra-Rail-Datenverkehr) wird auf Leaf-Knoten-Ebene weitergeleitet, wie in Abbildung 12 dargestellt.
Abbildung 12: Beispiel für Intra-Rail-GPU-zu-GPU-Datenverkehr.
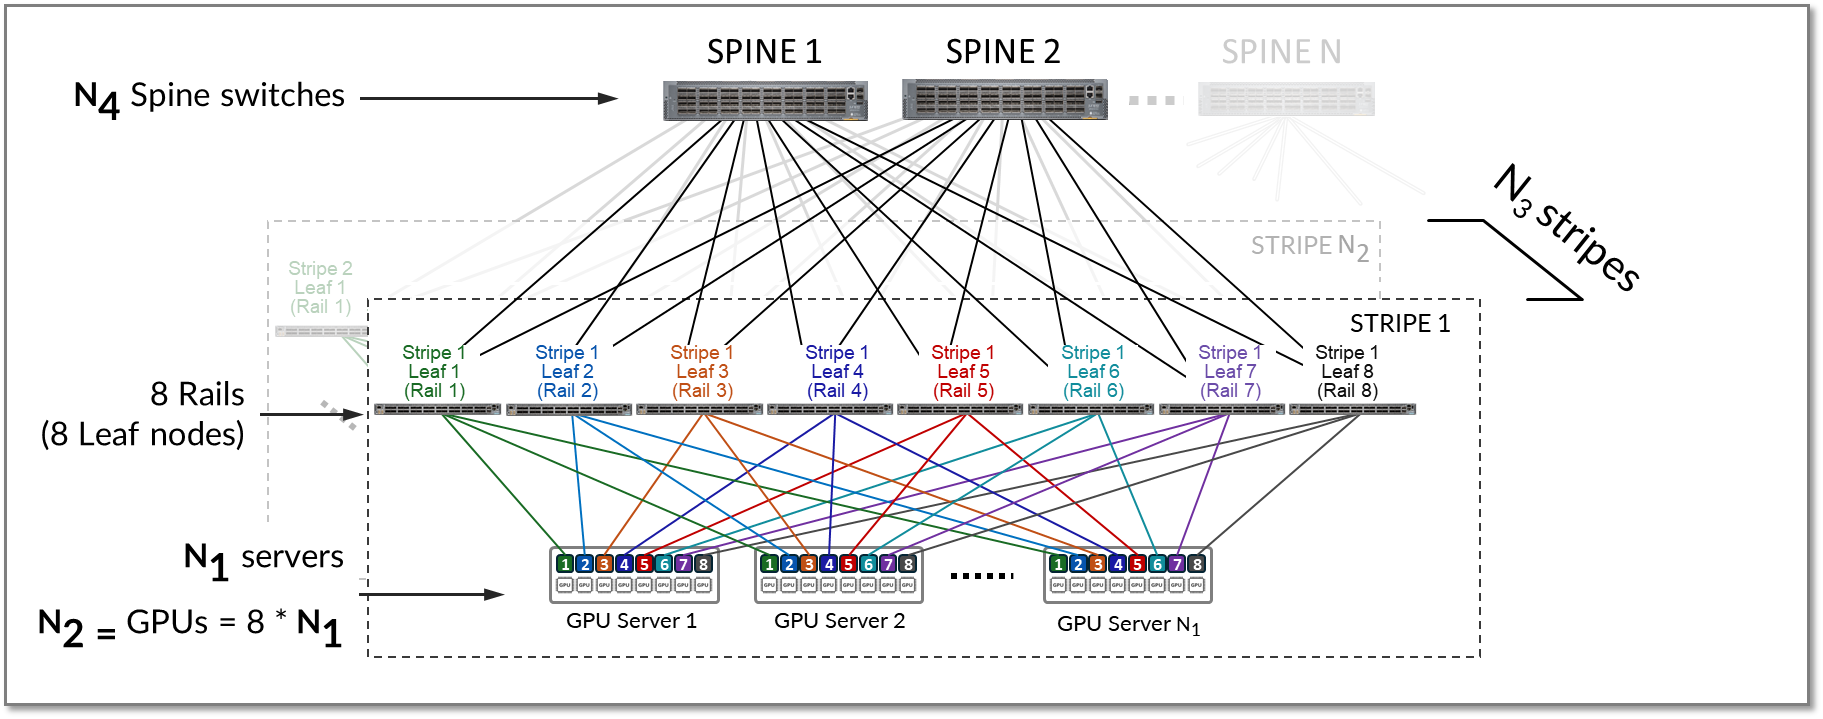
Ein Stripe kann repliziert werden, um die Anzahl der Server (N1) und GPUs (N2) in einem KI-Cluster zu erhöhen. Mehrere Stripes (N3) werden dann über Spine-Switches verbunden, wie in Abbildung 13 dargestellt.
Abbildung 13: Mehrere Stripes, die über Spine-Knoten verbunden sind
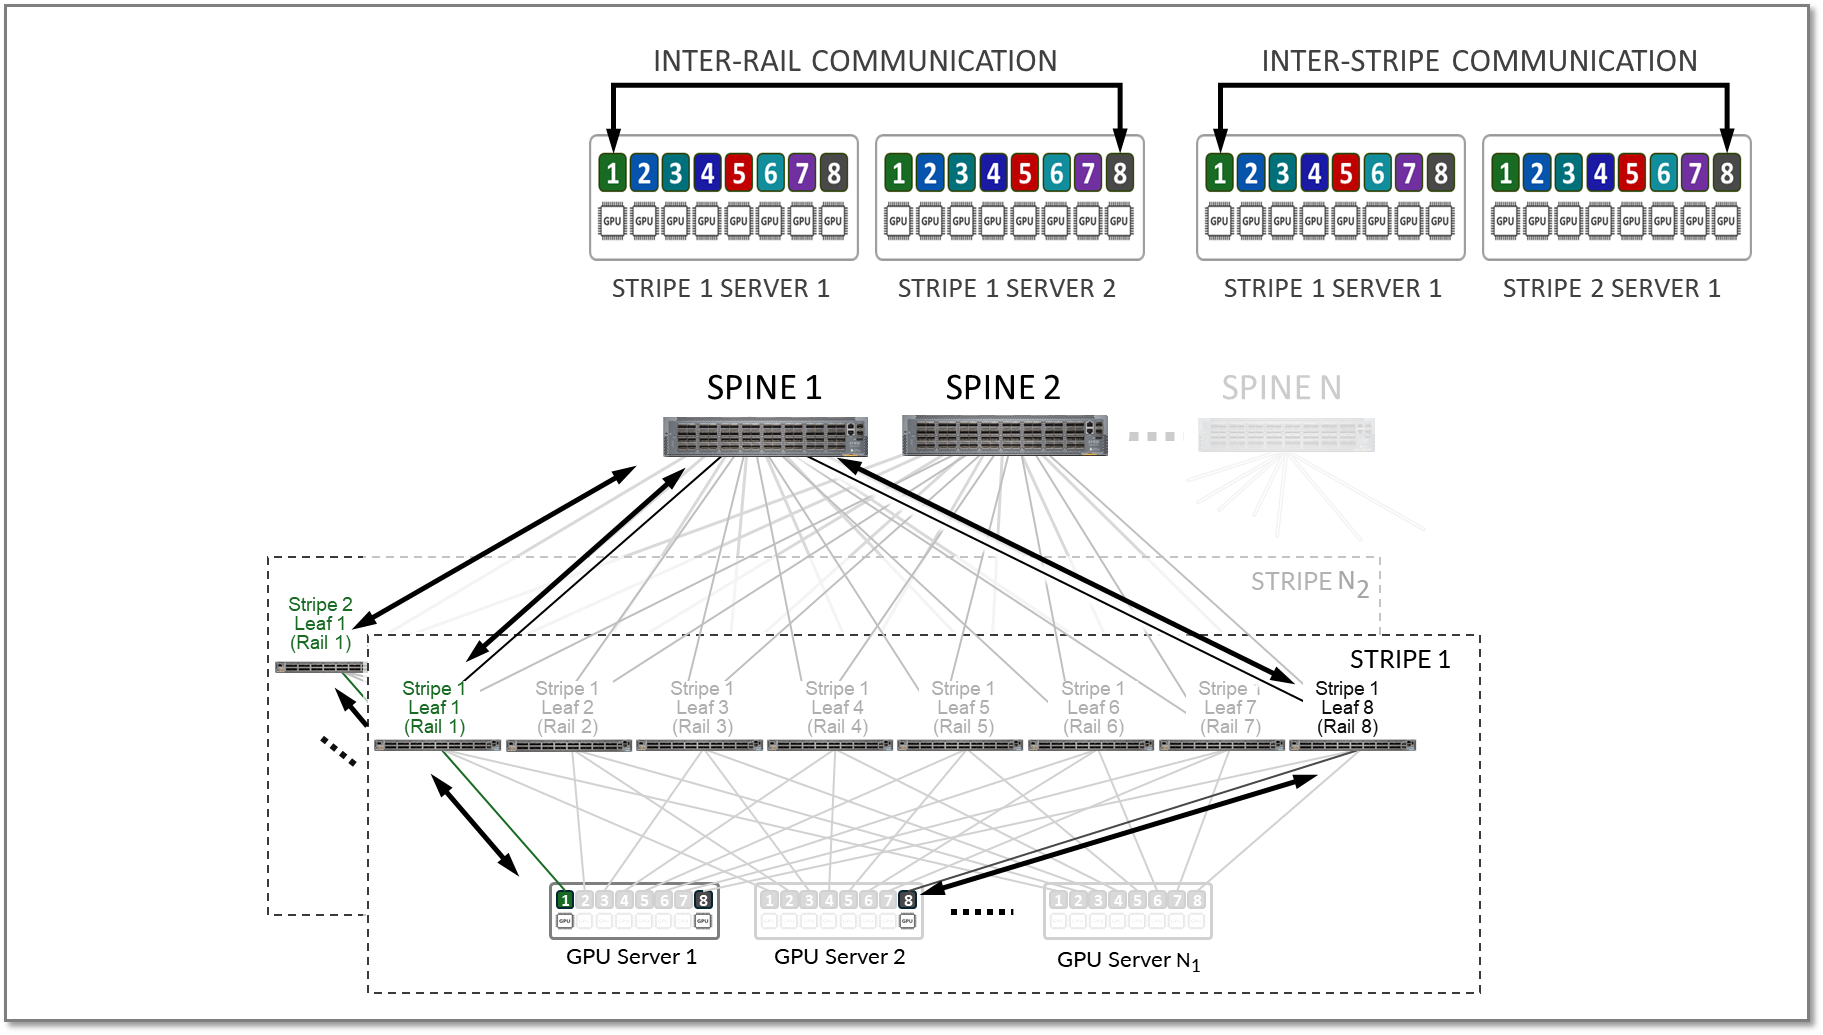
Sowohl Inter-Rail- als auch Inter-Stripe-Datenverkehr werden über die Spines-Knoten weitergeleitet, wie in Abbildung 14 dargestellt.
Abbildung 14. Beispiel für Inter-Rail- und Inter-Stripe-GPU-zu-GPU-Datenverkehr.
Berechnung der Anzahl der Leaf- und Spine-Knoten, Server und GPUs in einer Rail-optimierten Architektur
Die Anzahl der Leaf-Knoten in einem einzelnen Stripe in einer Rail-optimierten Architektur wird durch die Anzahl der GPUs pro Server (Anzahl der Rails) definiert. Jeder NVIDIA DGX H100 GPU-Server enthält 8 NVIDIA H100 Tensor-Core-GPUs. Daher umfasst ein einzelner Stripe 8 Leaf-Knoten (8 Rails).
Anzahl der Leaf-Knoten = Anzahl der GPUs pro Server = 8
Die maximale Anzahl von Servern, die in einem einzelnen Stripe unterstützt werden (N1), wird durch die Anzahl der verfügbaren Ports auf dem Leaf-Knoten definiert, die vom Switch-Modell abhängt.
Die Gesamtbandbreite zwischen den GPU-Servern und den Leaf-Knoten muss mit der Gesamtbandbreite zwischen den Leaf- und Spine-Knoten übereinstimmen, um ein Abonnementverhältnis von 1:1 zu gewährleisten.
Unter der Annahme, dass alle Schnittstellen auf dem Leaf-Knoten mit derselben Geschwindigkeit arbeiten, wird die Hälfte der Schnittstellen für die Verbindung zu den GPU-Servern und die andere Hälfte für die Verbindung zu den Spines verwendet. Daher wird die maximale Anzahl von Servern in einem Stripe als die Hälfte der Anzahl der verfügbaren Ports auf jedem Leaf-Knoten berechnet.
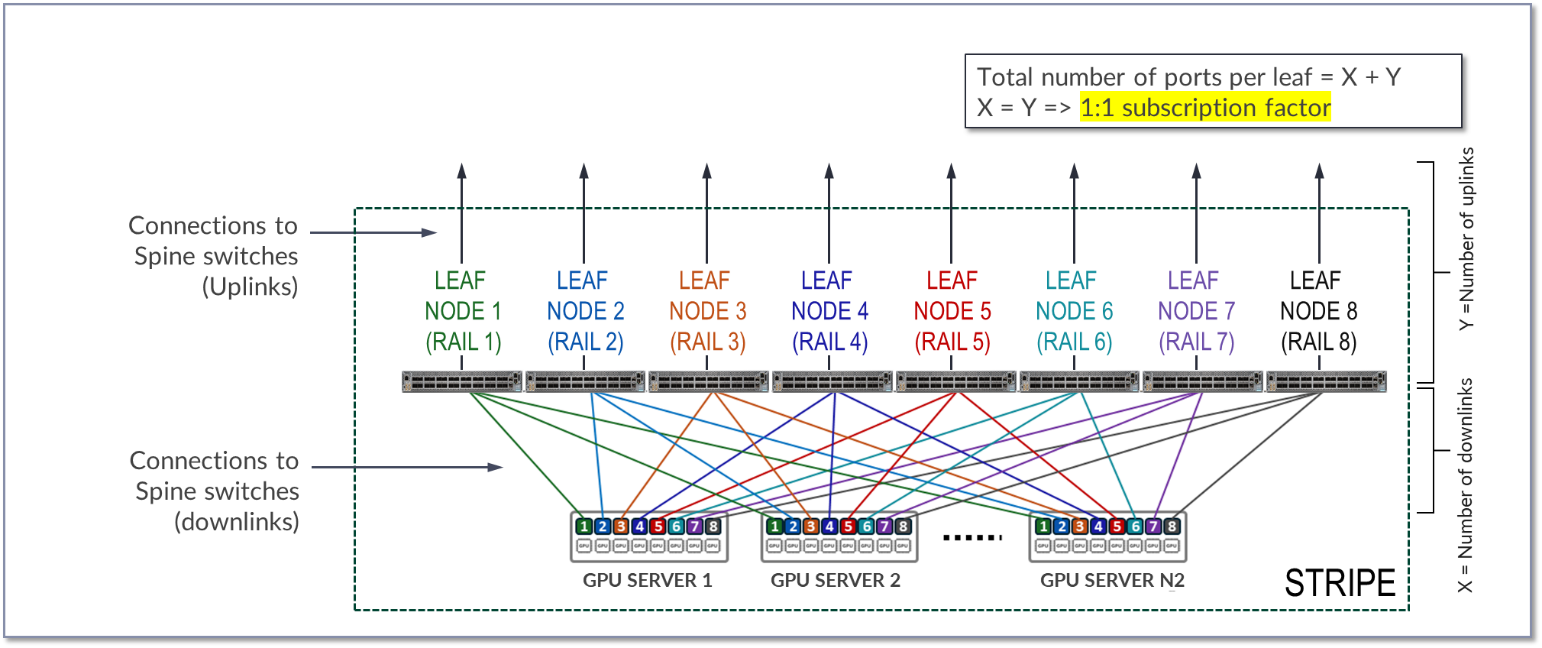
Abbildung 15. Anzahl der Uplinks und Downlinks für 1:1 Abo-Faktor
Im Diagramm steht X für die Anzahl der Downlinks (Verbindungen zwischen Leaf-Knoten und den GPU-Servern), während Y für die Anzahl der Uplinks (Verbindungen zwischen den Leaf-Knoten und den Spine-Knoten) steht. Um einen 1:1-Abonnementfaktor zu ermöglichen, muss X gleich Y sein.
Die Anzahl der verfügbaren Ports auf jedem Leaf-Knoten ist gleich X + Y oder 2 * X.
Da alle Server in einem Stripe über einen Port verfügen, der mit jedem Leaf im Stripe verbunden ist, beträgt die maximale Anzahl von Servern im Stripe (N1) gleich X.
N1 (maximale Anzahl von Servern pro Stripe) = Anzahl der verfügbaren Ports ÷ 2
Die maximale Anzahl von GPUs im Stripe wird berechnet, indem einfach die Anzahl der GPUs pro Server multipliziert wird.
N2 (maximale Anzahl der GPUs) = N1 (maximale Anzahl der Server pro Stripe) * 8
Die Gesamtzahl der verfügbaren Ports hängt vom Switch-Modell ab, das für den Leaf-Knoten verwendet wird. Tabelle 16 zeigt einige Beispiele.
Tabelle 16: Maximale Anzahl der pro Stripe unterstützten GPUs
| Leaf-Knoten QFX-Switch-Modell |
Gesamtzahl der verfügbaren 400GE-Ports pro Switch | Maximale Anzahl der unterstützten Server pro Stripe für ein 1:1-Abonnement (N1) |
GPUs pro Server | Maximale Anzahl der pro Stripe unterstützten GPUs (N2) |
|---|---|---|---|---|
| QFX5220-32CD | 32 | 32 ÷ 2 = 16 | 8 | 16 Server x 8 GPUs/Server = 128 GPUs |
| QFX5230-64CD | 64 | 64 ÷ 2 = 32 | 8 | 32 Server x 8 GPUs/Server = 256 GPUs |
| QFX5240-64OD QFX5241-64OD |
128 | 128 ÷ 2 = 64 | 8 | 64 Server x 8 GPUs/Server = 512 GPUs |
- Die QFX5220-32CD-Switches bieten 32 x 400-GE-Ports (16 werden für die Verbindung zu den Servern und 16 für die Verbindung zu den Spine-Knoten verwendet)
- QFX5230-64CD-Switches bieten bis zu 64 x 400-GE-Ports (32 werden für die Verbindung zu den Servern und 32 für die Verbindung zum Spine-Knoten verwendet).
- QFX5240-64OD-Switches bieten bis zu 128 x 400-GE-Ports (64 werden für die Verbindung zu den Servern und 64 für die Verbindung zum Spine-Knoten verwendet).
Um größere Maßstäbe zu erreichen, können mehrere Stripes (N3) mit einem Satz Spine-Knoten (N4) verbunden werden, wie in Abbildung 10 dargestellt.
Abbildung 16: Mehrere Stripes, die über Spine-Knoten hinweg verbunden sind.
Die Anzahl der erforderlichen Stripes (N3 ) wird basierend auf der erforderlichen Anzahl von GPUs und der maximalen Anzahl von GPUs pro Stripe (N2) berechnet.
Nehmen wir zum Beispiel an, dass die erforderliche Anzahl von GPUs (GPUs) 16.000 beträgt und die Fabric QFX5240-64OD als Leaf-Knoten verwendet.
Die Anzahl der verfügbaren 400G-Ports beträgt 128, was bedeutet, dass:
- die maximale Anzahl von Servern pro Stripe (N1) = 64
- die maximale Anzahl von GPUs pro Stripe (N2) = 512
Die Anzahl der erforderlichen Stripes (N3) wird berechnet, indem die Anzahl der erforderlichen GPUs und die Anzahl der GPUs pro Stripe wie folgt geteilt werden:
N 3 (Anzahl der Stripes) = GPUs ÷ N 2 (maximale Anzahl der GPUs pro Stripe) = 16000 ÷ 512 = 32 Stripes (aufgerundet)
Mit 32 Stripes und 64 Servern pro Stripe kann der Cluster 16.384 GPUs bereitstellen.
Wenn Sie die Anzahl der erforderlichen Stripes (N 3) und die Anzahl der Uplink-Ports pro Leaf-Knoten (Y) kennen, können Sie berechnen, wie viele Spine-Knoten erforderlich sind.
Zur Erinnerung: X = Y = N1
Zunächst kann die Gesamtzahl der Leaf-Knoten berechnet werden, indem die Anzahl der benötigten Stripes mit 8 multipliziert wird (Anzahl der Leaf-Knoten pro Stripe).
Gesamtzahl der Leaf-Knoten = N3 x 8 = 32 x 8 = 256
Dann kann die Gesamtzahl der Uplinks ermittelt werden, indem die Anzahl der Uplinks pro Leaf-Knoten (N1) mit der Gesamtzahl der Leaf-Knoten multipliziert wird.
Gesamtzahl der Uplinks = N1 x 256 = 64 x 256 = 16384
Die Anzahl der erforderlichen Spines (N4 ) kann dann bestimmt werden, indem die Gesamtzahl der Uplinks durch die Anzahl der verfügbaren Ports auf jedem Spine-Knoten geteilt wird, was wie bei den Leaf-Knoten von dem für die Spine-Rolle verwendeten Switch-Modell abhängt.
Anzahl der erforderlichen Spines (N4 ) = 16384 / Anzahl der verfügbaren Ports auf jedem Spine-Knoten
Wenn die Spine-Knoten beispielsweise QFX5240/41 sind, beträgt die Anzahl der verfügbaren Ports auf jedem Spine Knoten 128.
Tabelle 17: Anzahl der Spines-Knoten für zwei Stripes.
| Spine-Knoten QFX-Switch-Modell |
Maximale Anzahl von 400 GE-Schnittstellen pro Switch | Anzahl der erforderlichen Spines (N4) mit 64 Stripes |
|---|---|---|
| QFX5240-64OD | 128 | 32768 ÷ 128 = 128 |
| PTX10008 LC1201 | 288 | 32768 ÷ 288 ~ 57 |
| PTX10008 LC1301 |
576 | 32768 ÷ 576 ~ 29 |
Speicher-Backend-Fabric
Die Speicher-Backend-Fabric stellt die Konnektivitätsinfrastruktur für Speichergeräte bereit, auf die von den GPU-Servern aus zugegriffen werden kann.
Die Performance der Speicherinfrastruktur hat erhebliche Auswirkungen auf die Effizienz von KI-Workflows. Ein Speichersystem, das einen schnellen Zugriff auf Daten ermöglicht, kann die Zeit für das Training von KI-Modellen erheblich reduzieren. Ebenso kann ein Speichersystem, das eine effiziente Datenabfrage und -indizierung unterstützt, die Abschlusszeit für die Vorverarbeitung und Merkmalsextraktion in einem KI-Workflow minimieren.
In kleinen Clustern kann es ausreichen, den lokalen Speicher auf jedem GPU-Server zu verwenden oder diesen Speicher mit Open-Source- oder kommerzieller Software zusammenzufassen. In größeren Clustern mit höheren Workloads ist ein externes dediziertes Speichersystem erforderlich, um das Dataset-Staging für die Aufnahme und für Cluster-Checkpoints während des Trainings bereitzustellen.
Zwei führende Plattformen, WEKA und Vast Storage, bieten hochmoderne Lösungen für die gemeinsame Speicherung in GPU-Umgebungen. Während wir beide Lösungen in unserem Labor getestet haben, konzentriert sich dieses JVD auf die Weka-Speicherlösung. Daher werden der Rest dieses Dokuments sowie andere Abschnitte in diesem Dokument Details zu Weka Storage-Geräten und der Konnektivität zur Storage Backend Fabric behandeln.
Details zum Vast-Speicher sind im KI-Datencenter-Netzwerk mit Juniper Apstra, AMD-GPUs, Broadcom NIC, AMD Pollara NIC und Vast-Speicher enthalten – Juniper Validated Design (JVD).
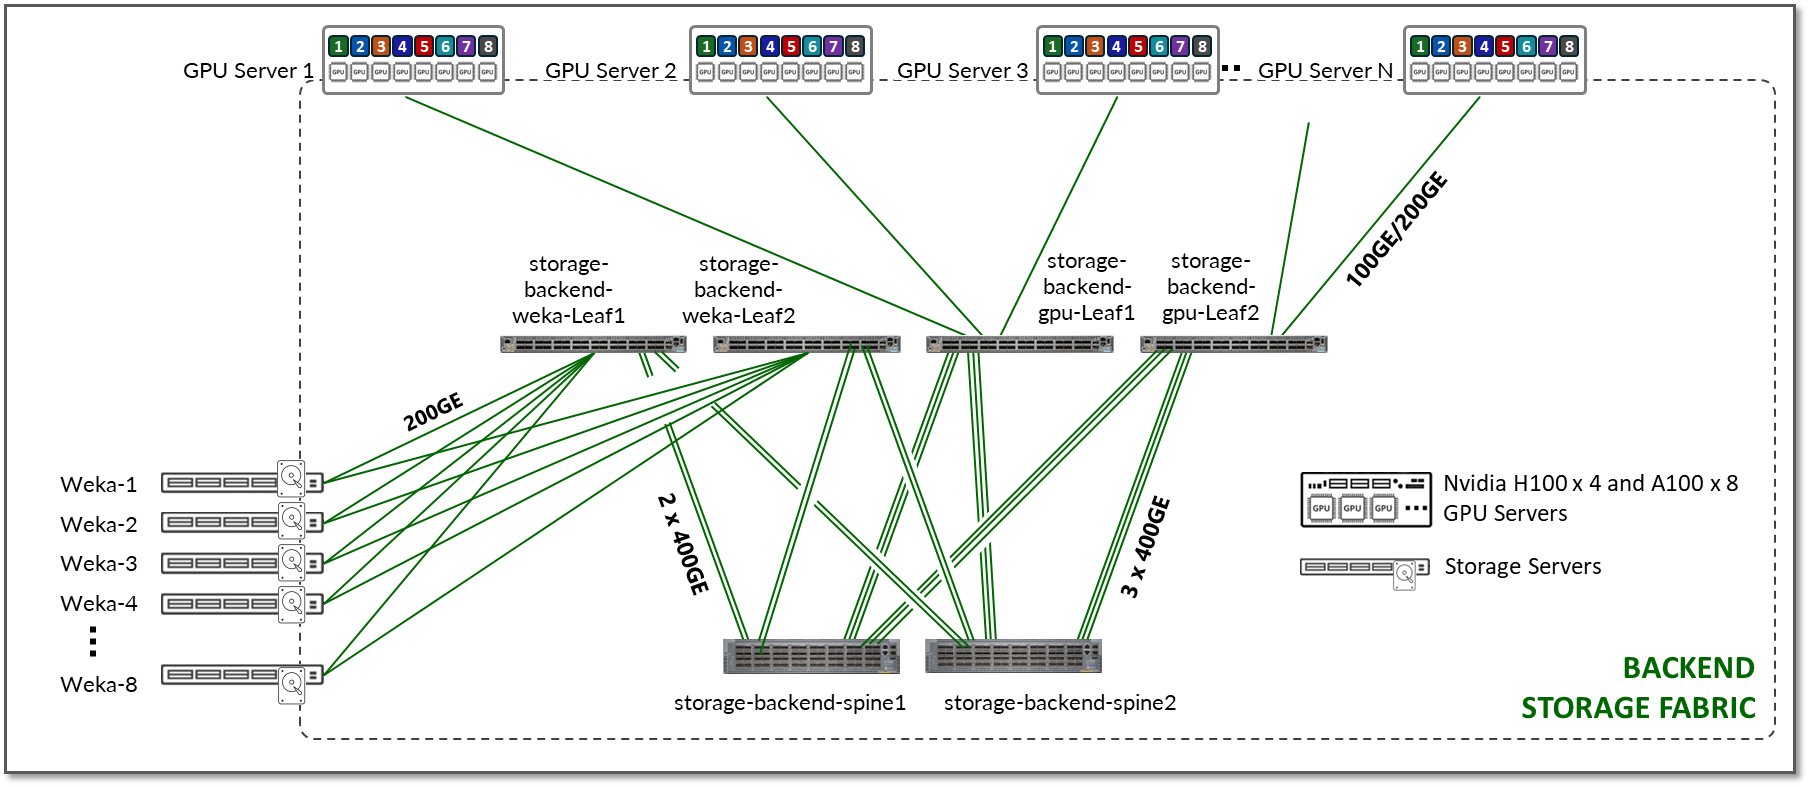
Das Design der Speicher-Backend-Fabric im JVD folgt ebenfalls einer 3-stufigen IP-Clos-Architektur, wie in Abbildung 17 dargestellt. In einem Storage-Cluster gibt es kein Konzept der Rail-Optimierung. Jeder GPU-Server hat eine einzige Verbindung zu den Leaf-Knoten anstatt einer pro GPU.
Abbildung 17: Speicher-Backend-Fabric-Architektur
Die Anzahl der Leaf-Knoten hängt von der GPU, der Anzahl der Server und Speichergeräte im KI-Cluster ab.
Die Anzahl der Spine-Knoten hängt vom gewünschten Subskriptionsfaktor für den Versuchsplan ab. Wie die GPU-Backend-Fabric erfordert auch die Storage Fabric ein nicht überbelegtes Design (1:1-Abonnementfaktor), um ausreichende Bandbreite für den hohen Datenverkehr zu gewährleisten und Überlastung, Paketverluste und übermäßige Latenzzeiten zu vermeiden.
Der Speicherdatenverkehr kann verschiedene Transportmechanismen nutzen, darunter NFS, POSIX und RoCEv2. Für RoCEv2 müssen die gleichen Load Balancing- und Class-of-Service-Mechanismen implementiert werden, die für die GPU-Backend-Fabric beschrieben sind. Diese werden in den Abschnitten Load Balancing und Class-of-Service dieses Dokuments beschrieben.
Die Geräte und Verbindungen in der Speicher-Fabric, die in diesem JVD validiert wurden, sind in den folgenden Tabellen zusammengefasst:
Tabelle 18: Validierte Storage Fabric-Leaf- und Spine-Knoten
| Storage Fabric Leaf Nodes Switch-Modell | Storage Fabric Spine Nodes Switch-Modell |
|---|---|
| QFX5130-32CD | QFX5130-32CD |
| QFX5220-32CD | QFX5220-32CD |
| QFX5230-32CD | QFX5230-32CD |
| QFX5230-64CD | QFX5230-64CD |
| QFX5240-64OD | QFX5240-64OD |
Tabelle 19: Validierte Verbindungen zwischen GPU-Servern, Speichergeräten und Leaf-Knoten in der Storage Fabric
| Links pro GPU-Server zur Leaf-Verbindung | Servertyp |
|---|---|
| 1 x 100 GE | NVIDIA A100 |
| 1 x 100 GE | NVIDIA H100 |
| 1 x 200 GE | WEKA |
Tabelle 20: Validierte Verbindungen zwischen Leaf- und Spine-Knoten in der Speicher-Fabric
| Links pro Leaf- und Spine-Verbindung | Leaf-Knoten-Modell | , Spine-Knoten-Modell |
|---|---|---|
| 2 x 400 GE, 3 x 400 GE | QFX5130-32CD | QFX5130-32CD |
| 2 x 400 GE, 3 x 400 GE | QFX5130-32CD | QFX5130-32CD |
| 2 x 400 GE, 3 x 400 GE | QFX5240-32CD QFX5241-32CD |
QFX5240-32CD QFX5241-32CD |
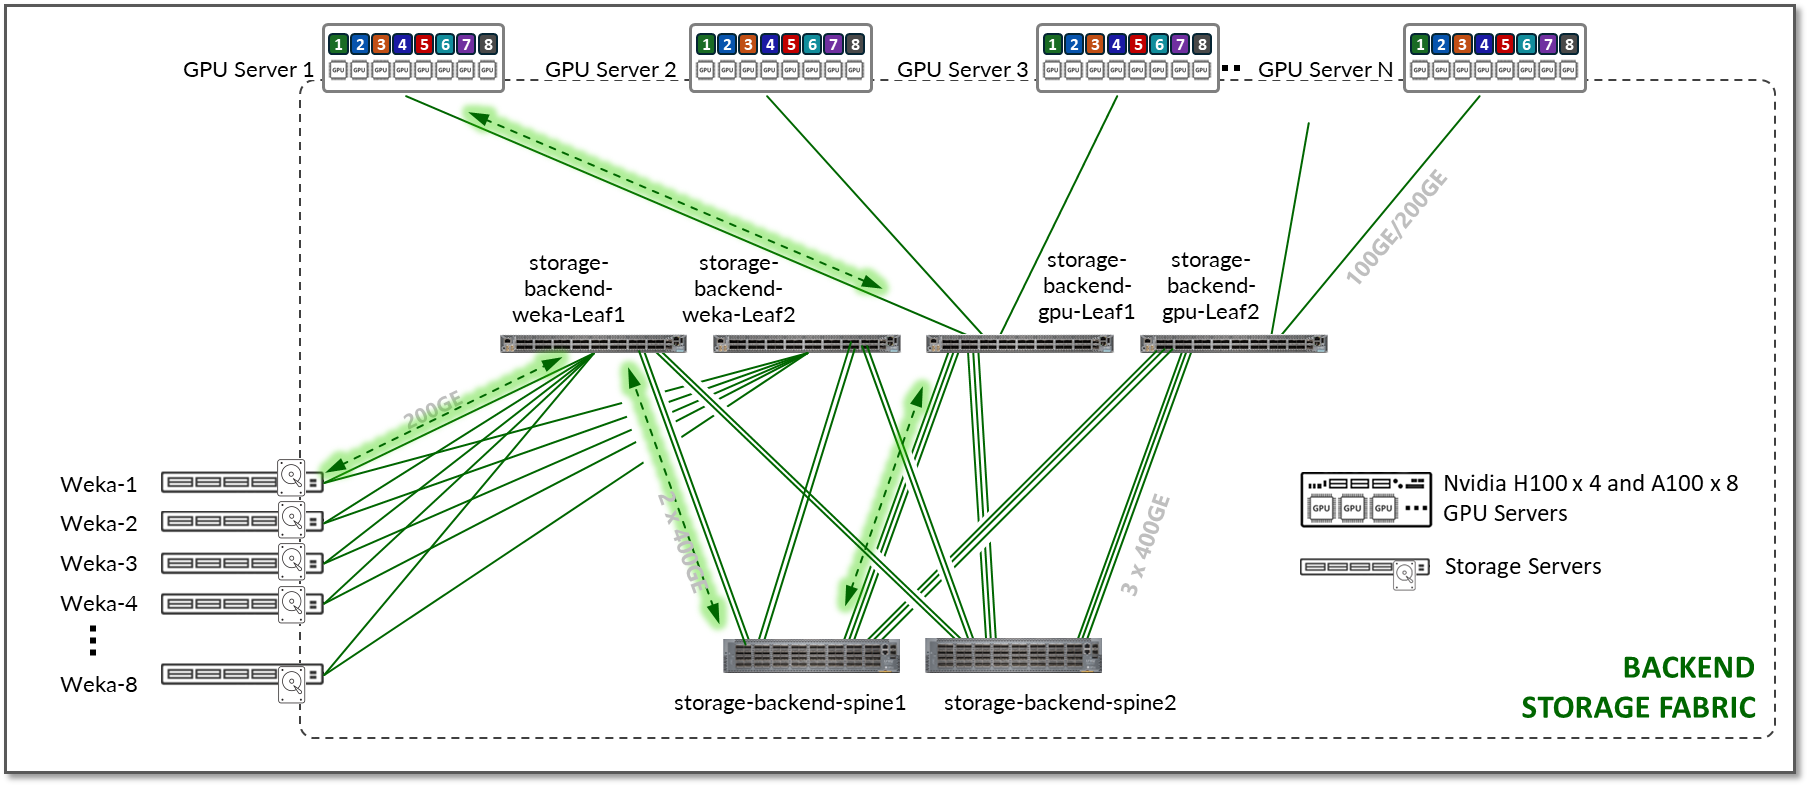
Die Tests für dieses JVD wurden mit 8 NVIDIA A100 GPU-Servern, 4 NVIDIA H100 GPU-Servern und 8 WEKA-Speichergeräten durchgeführt, die mit 4 Leaf-Knoten verbunden waren, die wiederum mit 2 Spine-Knoten verbunden waren, wie in Abbildung 18 dargestellt.
Abbildung 18: JVD-Testtopologie der Speicher-Fabric
- Jeder Nvidia A100-Server ist über 200G-Schnittstellen (ConnectX-7-NICs) mit den Leaf-Knoten verbunden.
- Jeder Nvidia H100-Server ist über 400G-Schnittstellen (ConnectX-7-NICs) mit den Leaf-Knoten verbunden.
- Jedes Weka Gerät
Tabelle 21: Gesamtzahl der Speicherverbindungen und getestete Bandbreite
| GPU-Server <=> Speicher-Leaf-Knoten | Speicher-Leaf-Knoten <=> Frontend-Spine-Knoten |
|---|---|
|
Gesamtzahl der 400GE-Verbindungen zwischen Frontend-Leaf-Knoten und Spine-Knoten = 20 (2-3 Links pro Leaf-to-Spine-Verbindung) |
| Gesamtbandbreite = 5,6 Tbit/s | Gesamtbandbreite = 6,4 Tbit/s |
| Kein Überabonnement. |
GPU-Backend-Fabric-Skalierung
Die Größe eines KI-Clusters variiert stark in Abhängigkeit von den spezifischen Anforderungen der Arbeitsauslastung. Die Anzahl der Knoten in einem KI-Cluster wird unter anderem von der Komplexität der Machine-Learning-Modelle, der Größe der Datensätze, der gewünschten Trainingsgeschwindigkeit und dem zur Verfügung stehenden Budget beeinflusst. Die Anzahl variiert von einem kleinen Cluster mit weniger als 100 Knoten bis zu einem Cluster für das gesamte Datencenter mit 10000 Rechen-, Speicher- und Netzwerkknoten. Es müssen immer mindestens 4 Spines eingesetzt werden, um Pfaddiversität und die Anzahl der PFC-Fehlerpfade zu reduzieren.
Tabelle 22: Fabric-Skalierung – Geräte und Positionierung
| Klein | , Mittel, Groß | |
|---|---|---|
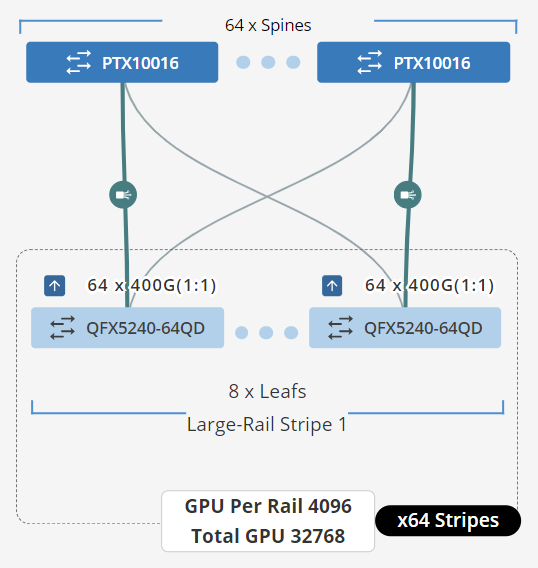
| 64 – 2048 GPU | 2048–8192 GPU | 8192 – 32768 Grafikkarte |
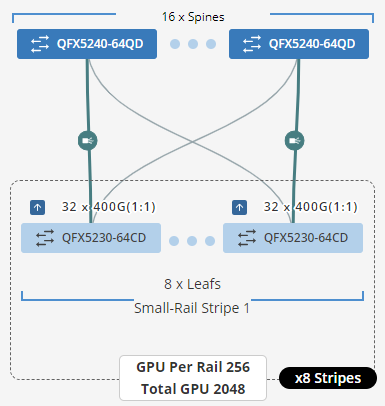
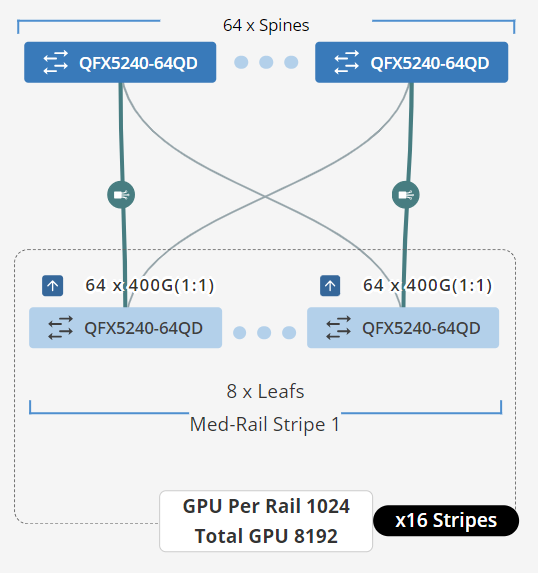
| Mit Unterstützung für bis zu 2048 GPUs können die Juniper QFX5240-64CD/QFX5240-64OD/QD oder QFX5230-64CD als Spine-and-Leaf-Geräte zur Unterstützung von Single- oder Dual-Stripe-Anwendungen verwendet werden. Um den Empfehlungen der Best Practices zu folgen, sollten mindestens 4 Spines bereitgestellt werden, selbst in einer Single-Stripe-Fabric. | Mit Unterstützung für 2048 – 8192 GPUs können die Juniper QFX5240-64CD/QFX5240-64OD/QD als Spine-and-Leaf-Geräte verwendet werden, um eine angemessene Skalierung zu erreichen. Dieses 3-stufige, Rail-basierte Fabric-Design bietet physische Konnektivität zu 16 Stripes von 64 Spines und 1024 Leaf-Knoten und behält ein 1:1-Abonnement-Durchsatzmodell bei. | Für Infrastrukturen, die mehr als 8192 GPUs unterstützen, können die Juniper PTX1000x Chassis-Spine und QFX5240-64CD/QFX5240-64OD/QD-Leaf-Knoten bis zu 32768 GPUs unterstützen. Dieses 3-stufige, Rail-basierte Fabric-Design bietet physische Konnektivität zu 64 Stripes von 64 Spines und 4096 Leaf-Knoten und behält ein 1:1-Abonnement-Durchsatzmodell bei. |
 |
 |
 |
Hardware- und Softwarekomponenten von Juniper
Für dieses Lösungsdesign sind die Produkte und Softwareversionen von Juniper unten aufgeführt. Das in diesem JVD dokumentierte Design gilt als Basisdarstellung für die validierte Lösung. Als Teil einer kompletten Lösungssuite tauschen wir während iterativer Anwendungsfalltests routinemäßig Hardwaregeräte gegen andere Modelle aus. Jede in diesem Dokument validierte Switch-Plattform durchläuft dieselben strengen rollenbasierten Tests mit bestimmten Versionen von Junos OS und Apstra-Verwaltungssoftware.
Validierte Komponenten der Juniper Hardware- und Software-Lösung
Die folgende Tabelle fasst die validierten Juniper Geräte für dieses JVD zusammen und umfasst Geräte, die für KI-Datencenter-Netzwerke mit Juniper Apstra, AMD-GPUs und großem Speicher getestet wurden – Juniper Validated Design (JVD)
Tabelle 23: Validierte Geräte und Positionierung
| GERÄTE-FRONTEND-FABRIC | , GPU-BACKEND-FABRIC | , SPEICHER-FABRIC | ||||
|---|---|---|---|---|---|---|
| BLATT | DREHEN | BLATT | DREHEN | BLATT | DREHEN | |
| QFX5130-32CD | X | X | X | X | ||
| QFX5220-32CD | X | X | X | X | X | |
| QFX5230-32CD | X | X | X | |||
| QFX5230-64CD | X | X | X | X | ||
| QFX5240-64OD | X | X | X | X | ||
| QFX5241-64OD | X | X | X | X | ||
| PTX10008 JNP10K-LC1201 | X | |||||
| PTX10008 JNP10K-LC1301 | X | |||||
Juniper Software-Komponenten
In der folgenden Tabelle sind die getesteten und validierten Softwareversionen nach Rolle zusammengefasst.
Tabelle 24: Empfohlene Version der Plattform
| Plattformrolle | : Junos OS Release | |
|---|---|---|
| QFX5240-64CD | GPU-Backend-Leaf | 23,4 X 100-D20 |
| QFX5240-64OD/QD | GPU-Backend-Spine | 23,4 x 100-D42 |
| QFX5220-32CD | GPU-Backend-Leaf | 23,4 X 100-D20 |
| QFX5230-64CD | GPU-Backend-Leaf | 23,4 X 100-D20 |
| QFX5240-64CD | GPU-Backend-Spine | 23,4 X 100-D20 |
| QFX5240-64OD/QD | GPU-Backend-Spine | 23,4 x 100-D42 |
| QFX5230-64CD | GPU-Backend-Spine | 23,4 X 100-D20 |
| PTX10008 mit LC1201 | GPU-Backend-Spine | 23.4R2-S3 |
| QFX5130-32CD | Frontend-Blatt | 23.43R2-S3 |
| QFX5130-32CD | Frontend Spine | 23.43R2-S3 |
| QFX5220-32CD | Speicher-Backend-Leaf | 23,4 X 100-D20 |
| QFX5230-64CD | Speicher-Backend-Leaf | 23,4 X 100-D20 |
| QFX5240-64CD | Speicher-Backend-Leaf | 23,4 X 100-D20 |
| QFX5240-64OD/QD | Speicher-Backend-Leaf | 23,4 x 100-D42 |
| QFX5220-32CD | Speicher-Backend-Spine | 23,4 X 100-D20 |
| QFX5230-64CD | Speicher-Backend-Spine | 23,4 X 100-D20 |
| QFX5240-64CD | Speicher-Backend-Spine | 23,4 X 100-D20 |
| QFX5240-64OD/QD | Speicher-Backend-Spine | 23,4 x 100-D42 |