
BGP im Überblick
BGP verstehen
BGP ist ein Exterior Gateway Protocol (EGP), das zum Austausch von Routing-Informationen zwischen Routern in verschiedenen autonomen Systemen (ASs) verwendet wird. Die BGP-Routing-Informationen umfassen die vollständige Route zu jedem Ziel. BGP verwendet die Routing-Informationen, um eine Datenbank mit Informationen zur Netzwerkerreichbarkeit zu pflegen, die es mit anderen BGP-Systemen austauscht. BGP verwendet die Informationen zur Netzwerkerreichbarkeit, um ein Diagramm der AS-Konnektivität zu erstellen, mit dem BGP Routing-Schleifen entfernen und Richtlinienentscheidungen auf AS-Ebene durchsetzen kann.
MBGP-Erweiterungen (Multiprotocol BGP) ermöglichen BGP die Unterstützung von IP-Version 6 (IPv6). MBGP definiert die Attribute MP_REACH_NLRI und MP_UNREACH_NLRI, die zur Übertragung von IPv6-Erreichbarkeitsinformationen verwendet werden. NLRI-Aktualisierungsmeldungen (Network Layer Reachability Information) tragen IPv6-Adresspräfixe realisierbarer Routen.
BGP ermöglicht richtlinienbasiertes Routing. Sie können Routing-Richtlinien verwenden, um zwischen mehreren Pfaden zu einem Ziel zu wählen und die Neuverteilung von Routing-Informationen zu steuern.
BGP verwendet TCP als Transportprotokoll und verwendet Port 179 für den Verbindungsaufbau. Durch die Ausführung eines zuverlässigen Transportprotokolls entfällt für BGP die Implementierung von Update-Fragmentierung, erneuter Übertragung, Bestätigung und Sequenzierung.
Die Junos OS Routing-Protokollsoftware unterstützt BGP Version 4. Diese Version von BGP bietet Unterstützung für Classless-Interdomain-Routing (CIDR), wodurch das Konzept der Netzwerkklassen entfällt. Anstatt anhand des ersten Oktetts anzunehmen, welche Bits einer Adresse das Netzwerk repräsentieren, können Sie mit CIDR die Anzahl der Bits in der Netzwerkadresse explizit angeben und so die Größe der Routing-Tabellen verringern. BGP Version 4 unterstützt auch die Aggregation von Routen, einschließlich der Aggregation von AS-Pfaden.
In diesem Abschnitt werden die folgenden Themen behandelt:
- Autonome Systeme
- AS-Pfade und -Attribute
- Externes und internes BGP
- Mehrere Instanzen von BGP
- Protokolldatenverkehr für Schnittstellen in einer Sicherheitszone zulassen
Autonome Systeme
Ein autonomes System (AS) ist eine Gruppe von Routern, die unter einer einzigen technischen Verwaltung stehen und normalerweise ein einziges internes Gateway-Protokoll und einen gemeinsamen Satz von Metriken verwenden, um Routing-Informationen innerhalb der Router weiterzugeben. Für andere AS scheint ein AS einen einzigen, kohärenten internen Routingplan zu haben und ein konsistentes Bild davon zu bieten, welche Ziele über ihn erreichbar sind.
AS-Pfade und -Attribute
Die Routing-Informationen, die BGP-Systeme austauschen, umfassen die vollständige Route zu jedem Ziel sowie zusätzliche Informationen über die Route. Der AS-Pfad ist die Abfolge der autonomen Systeme, die die Route zurückgelegt hat, und zusätzliche Routeninformationen sind in den Pfadattributen enthalten. BGP verwendet den AS-Pfad und die Pfadattribute, um die Netzwerktopologie vollständig zu bestimmen. Sobald BGP die Topologie verstanden hat, kann es Routing-Schleifen erkennen und beseitigen und zwischen Gruppen von Routen auswählen, um administrative Präferenzen und Entscheidungen über Routing-Richtlinien durchzusetzen.
Externes und internes BGP
BGP unterstützt zwei Arten des Austauschs von Routing-Informationen: den Austausch zwischen verschiedenen ASs und den Austausch innerhalb eines einzelnen AS. Bei Verwendung zwischen ASs wird BGP als externes BGP (EBGP) bezeichnet, und BGP-Sitzungen führen Inter-AS-Routing durch. Bei Verwendung innerhalb eines AS wird BGP als internes BGP (IBGP) bezeichnet, und BGP-Sitzungen führen Intra-AS-Routing durch. Abbildung 1 zeigt ASs, IBGP und EBGP.
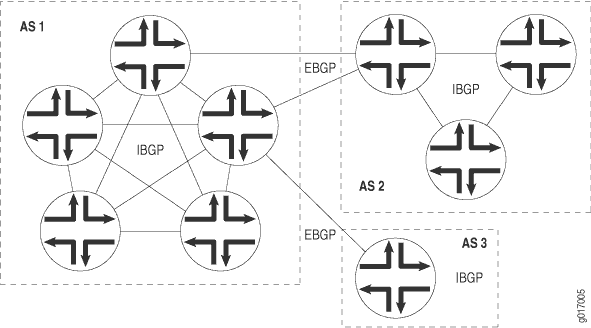
Ein BGP-System teilt Informationen zur Netzwerkerreichbarkeit mit benachbarten BGP-Systemen, die als Nachbarn oder Peers bezeichnet werden.
BGP-Systeme sind in Gruppen angeordnet. In einer IBGP-Gruppe befinden sich alle Peers in der Gruppe – interne Peers genannt – im selben AS. Interne Peers können sich überall im lokalen AS befinden und müssen nicht direkt miteinander verbunden sein. Interne Gruppen verwenden Routen von einem IGP, um Weiterleitungsadressen aufzulösen. Sie übertragen auch externe Routen zwischen allen anderen internen Routern, auf denen IBGP ausgeführt wird, und berechnen den nächsten Hop, indem sie den nächsten BGP-Hop, der mit der Route empfangen wurde, mithilfe von Informationen aus einem der internen Gateway-Protokolle auflösen.
In einer EBGP-Gruppe befinden sich die Peers in der Gruppe – sogenannte externe Peers – in verschiedenen ASs und teilen sich normalerweise ein Subnetz. In einer externen Gruppe wird der nächste Hop in Bezug auf die Schnittstelle berechnet, die zwischen dem externen Peer und dem lokalen Router gemeinsam genutzt wird.
Mehrere Instanzen von BGP
Sie können mehrere Instanzen von BGP auf den folgenden Hierarchieebenen konfigurieren:
-
[edit routing-instances routing-instance-name protocols] -
[edit logical-systems logical-system-name routing-instances routing-instance-name protocols]
Mehrere Instanzen von BGP werden hauptsächlich für die Unterstützung von Layer 3-VPN verwendet.
IGP-Peers und externe BGP-Peers (EBGP) (sowohl Nicht-Multihop- als auch Multihop-Peers) werden alle für Routing-Instanzen unterstützt. BGP-Peering wird über eine der Schnittstellen eingerichtet, die unter der Routing-Instanzen-Hierarchie konfiguriert sind.
Wenn ein BGP-Nachbar BGP-Nachrichten an das lokale Routing-Gerät sendet, muss die eingehende Schnittstelle, auf der diese Nachrichten empfangen werden, in derselben Routing-Instanz konfiguriert sein, in der die BGP-Nachbarkonfiguration vorhanden ist. Dies gilt für Nachbarn, die einen oder mehrere Hops entfernt sind.
Routen, die vom BGP-Peer gelernt wurden, werden standardmäßig der Tabelle instance-name.inet.0 hinzugefügt. Sie können Import- und Exportrichtlinien konfigurieren, um den Informationsfluss in und aus der Instanz-Routing-Tabelle zu steuern.
Für Layer-3-VPN-Unterstützung konfigurieren Sie BGP auf dem Provider-Edge-Router (PE), um Routen vom Kunden-Edge-Router (CE) zu empfangen und die Routen der Instanzen bei Bedarf an den CE-Router zu senden. Sie können mehrere Instanzen von BGP verwenden, um separate Weiterleitungstabellen pro Standort zu verwalten, um den VPN-Datenverkehr auf dem PE-Router getrennt zu halten.
Sie können Import- und Exportrichtlinien konfigurieren, die es dem Service Provider ermöglichen, den Datenverkehr zum und vom Kunden zu kontrollieren und zu begrenzen.
Sie können eine EBGP-Multihop-Sitzung für eine VRF-Routing-Instanz konfigurieren. Außerdem können Sie den EBGP-Peer zwischen den PE- und CE-Routern einrichten, indem Sie die Loopback-Adresse des CE-Routers anstelle der Schnittstellenadressen verwenden.
Protokolldatenverkehr für Schnittstellen in einer Sicherheitszone zulassen
Auf Firewalls der SRX-Serie müssen Sie den erwarteten eingehenden Host-Datenverkehr auf den angegebenen Schnittstellen oder allen Schnittstellen der Zone aktivieren. Andernfalls wird eingehender Datenverkehr, der für dieses Gerät bestimmt ist, standardmäßig verworfen.
Um beispielsweise BGP-Datenverkehr in einer bestimmten Zone Ihrer Firewall der SRX-Serie zuzulassen, gehen Sie wie folgt vor:
[edit]
                                                            user@host# set security zones security-zone trust host-inbound-traffic protocols bgp
[edit]
                                                    user@host# set security zones security-zone trust interfaces ge-0/0/1.0 host-inbound-traffic protocols bgp
Siehe auch
Übersicht über BGP-Routen
Eine BGP-Route ist ein Ziel, das als IP-Adresspräfix beschrieben wird, und Informationen, die den Pfad zum Ziel beschreiben.
Die folgenden Informationen beschreiben den Pfad:
-
AS-Pfad, d. h. eine Liste mit Nummern der ASs, die eine Route durchläuft, um den lokalen Router zu erreichen. Die erste Zahl im Pfad ist die des letzten AS im Pfad – der AS, der dem lokalen Router am nächsten liegt. Die letzte Zahl im Pfad ist die am weitesten vom lokalen Router entfernte AS, der in der Regel der Ursprung des Pfads ist.
-
Pfadattribute, die zusätzliche Informationen über den AS-Pfad enthalten, der in der Routing-Richtlinie verwendet wird.
BGP-Peers kündigen sich gegenseitig Routen in Aktualisierungsnachrichten an.
BGP speichert seine Routen in der Junos OS-Routing-Tabelle (inet.0). In der Routing-Tabelle werden die folgenden Informationen zu BGP-Routen gespeichert:
-
Routing-Informationen, die aus Update-Nachrichten von Peers gelernt werden
-
Lokale Routing-Informationen, die BGP aufgrund lokaler Richtlinien auf Routen anwendet
-
Informationen, die BGP in Aktualisierungsmeldungen an BGP-Peers ankündigt
Für jedes Präfix in der Routing-Tabelle wählt der Routing-Protokollprozess einen einzigen besten Pfad aus, den so genannten aktiven Pfad. Wenn Sie BGP nicht so konfigurieren, dass mehrere Pfade zum selben Ziel angekündigt werden, kündigt BGP nur den aktiven Pfad an.
Der BGP-Router, der eine Route zuerst ankündigt, weist ihr einen der folgenden Werte zu, um ihren Ursprung zu identifizieren. Bei der Routenauswahl wird der niedrigste Ursprungswert bevorzugt.
-
0 – Der Router hat die Route ursprünglich über eine IGP (OSPF, IS-IS oder eine statische Route) gelernt.
-
1 – Der Router hat die Route ursprünglich über eine EGP (höchstwahrscheinlich BGP) gelernt.
-
2: Der Ursprung der Route ist unbekannt.
Siehe auch
Übersicht über die BGP-Routenauflösung
Der nächste Hop einer internen BGP (IBGP)-Route mit einer Next-Hop-Adresse zu einem entfernten BGP-Nachbarn (Protokoll-Next-Hop) muss mit einer anderen Route aufgelöst werden. BGP fügt diese Route dem RPD-Resolver-Modul für eine Next-Hop-Auflösung hinzu. Wenn RSVP im Netzwerk verwendet wird, wird der nächste BGP-Hop über die RSVP-Eingangsroute aufgelöst. Dies führt dazu, dass die BGP-Route auf einen indirekten nächsten Hop und der indirekte nächste Hop auf einen Weiterleitungs-Next-Hop verweist. Der Weiterleitungs-Next-Hop wird vom RSVP-Route-Next-Hop abgeleitet. Es gibt oft eine große Anzahl interner BGP-Routen, die denselben protokollbasierten nächsten Hop haben, und in solchen Fällen würde der Satz von BGP-Routen auf denselben indirekten nächsten Hop verweisen.
Vor Junos OS Version 17.2R1 löste das Resolver-Modul des Routing-Protokollprozesses (RPD) die vom IBGP empfangenen Routen auf folgende Weise auf:
-
Teilweise Routenauflösung: Der nächste Protokoll-Hop wird basierend auf Hilfsrouten wie RSVP- oder IGP-Routen aufgelöst. Die Metrikwerte werden von den Hilfsrouten abgeleitet, und der nächste Hop wird als Resolver bezeichnet, der den nächsten Hop weiterleitet, der von Hilfsrouten geerbt wurde. Diese Metrikwerte werden für die Auswahl von Routen in der Routing-Informationsbasis (RIB) verwendet, die auch als Routing-Tabelle bezeichnet wird.
-
Vollständige Routenauflösung – Der letzte nächste Hop wird abgeleitet und als Kernel-Routing-Tabelle (KRT) bezeichnet, der den nächsten Hop basierend auf der Weiterleitungsexportrichtlinie weiterleitet.
Ab Junos OS Version 17.2R1 ist das Resolver-Modul von rpd optimiert, um den Durchsatz des eingehenden Verarbeitungsflusses zu erhöhen und die Lernrate von RIB und FIB zu beschleunigen. Mit dieser Erweiterung wird die Routenauflösung wie folgt beeinflusst:
-
Die Methoden zur teilweisen und vollständigen Routenauflösung werden für jede IBGP-Route ausgelöst, obwohl jede Route möglicherweise den gleichen aufgelösten nächsten Hop für die Weiterleitung oder die nächsten nächsten LRT-Weiterleitungshops erbt.
-
Die BGP-Pfadauswahl wird so lange verschoben, bis die vollständige Routenauflösung für NLRI (Network Layer Reachability Information) durchgeführt wurde, die von einem BGP-Nachbarn empfangen wurde. Dies ist möglicherweise nicht die beste Route in der RIB nach der Routenauswahl.
Zu den Vorteilen der rpd-Resolver-Optimierung gehören:
-
Niedrigere RIB-Auflösungs-Lookup-Kosten: Die Ausgabe des aufgelösten Pfads wird in einem Resolver-Cache gespeichert, sodass dieselben abgeleiteten Next-Hop- und Metrikwerte an einen anderen Satz von Routen mit demselben Pfadverhalten vererbt werden können, anstatt sowohl einen teilweisen als auch einen vollständigen Routenauflösungsfluss durchzuführen. Dies reduziert die Kosten für die Suche nach Routenauflösung, da nur der häufigste Resolver-Status in einem Cache mit begrenzter Tiefe beibehalten wird.
-
Optimierung der BGP-Routenauswahl: Der BGP-Routenauswahlalgorithmus wird für jede empfangene IBGP-Route zweimal ausgelöst: erstens, während die Route in der RIB mit dem nächsten Hop als unbrauchbar hinzugefügt wird, und zweitens, während die Route mit einem aufgelösten nächsten Hop in der RIB (nach der Routenauflösung) hinzugefügt wird. Dies führt dazu, dass die beste Route zweimal ausgewählt wird. Bei der Resolver-Optimierung wird der Routenauswahlprozess im Empfangsfluss erst ausgelöst, nachdem die Next-Hop-Informationen vom Resolver-Modul abgerufen wurden.
-
Interner Cache zur Vermeidung häufiger Lookups: Der Resolver-Cache behält den häufigsten Resolver-Status bei, sodass die Lookup-Funktionalität, wie Next-Hop-Lookup und Routen-Lookup, über den lokalen Cache ausgeführt wird.
-
Pfadäquivalenzgruppe: Wenn verschiedene Pfade denselben Weiterleitungsstatus aufweisen oder vom selben Protokoll empfangen werden, können die Pfade zu einer Pfadäquivalenzgruppe gehören. Dieser Ansatz vermeidet die Notwendigkeit, eine vollständige Routenauflösung für solche Pfade durchzuführen. Wenn ein neuer Pfad eine vollständige Routenauflösung erfordert, wird er zuerst in der Datenbank der Pfadäquivalenzgruppe nachgeschlagen, die die aufgelöste Pfadausgabe enthält, z. B. indirekter nächster Hop und Weiterleitung des nächsten Hops.
Siehe auch
Übersicht über BGP-Meldungen
Alle BGP-Nachrichten haben denselben Header mit fester Größe. Er enthält die folgenden Felder:
- Marker: Ein 16-Oktett-Feld, das aus Kompatibilitätsgründen auf alle eingestellt werden muss.
-
Länge: Eine 2-Oktett-Ganzzahl, die die Gesamtlänge der Nachricht angibt, einschließlich des Headers in Oktetten. Der Wert des Feldes Länge muss mindestens 19 Oktette und maximal 4096 Oktette betragen.
-
Typ: Eine ganze Zahl von 1 Oktett, die den Nachrichtentyp angibt.
In diesem Abschnitt werden die BGP-Nachrichtentypen erläutert:
- Offene Nachrichten
- Nachrichten aktualisieren
- Keepalive-Nachrichten
- Benachrichtigungen
- Meldungen zur Routen-Aktualisierung
Offene Nachrichten
Nachdem eine TCP-Verbindung zwischen zwei BGP-Systemen hergestellt wurde, tauschen sie offene BGP-Nachrichten aus, um eine BGP-Verbindung zwischen ihnen herzustellen. Sobald die Verbindung hergestellt ist, können die beiden Systeme BGP-Nachrichten und Datenverkehr austauschen.
Offene Nachrichten bestehen aus dem BGP-Header und den folgenden Feldern:
-
Version: Die aktuelle BGP-Versionsnummer lautet 4.
-
Lokale AS-Nummer – Sie konfigurieren dies, indem Sie die
autonomous-systemAnweisung auf der[edit routing-options]ODER-Hierarchieebene[edit logical-systems logical-system-name routing-options]einschließen. -
Haltezeit: Vorgeschlagener Wert für die Haltezeit. Die lokale Haltezeit konfigurieren Sie mit der BGP-Anweisung
hold-time. -
BGP-Kennung: IP-Adresse des BGP-Systems. Diese Adresse wird beim Start des Systems ermittelt und ist für jede lokale Schnittstelle und jeden BGP-Peer gleich. Sie können den BGP-Bezeichner konfigurieren, indem Sie die
router-idAnweisung auf[edit logical-systems logical-system-name routing-options][edit routing-options]oder-Hierarchieebene einschließen. Standardmäßig verwendet BGP die IP-Adresse der ersten Schnittstelle, die es im Router findet. -
Länge des Parameterfelds und der Parameter selbst: Dies sind optionale Felder.
Nachrichten aktualisieren
BGP-Systeme senden Aktualisierungsnachrichten, um Informationen über die Erreichbarkeit des Netzwerks auszutauschen. BGP-Systeme verwenden diese Informationen, um einen Graphen zu erstellen, der die Beziehungen zwischen allen bekannten ASs beschreibt.
Aktualisierungsnachrichten bestehen aus dem BGP-Header und den folgenden optionalen Feldern:
-
Länge der nicht durchführbaren Routen: Länge des Felds "Zurückgezogene Routen"
-
Zurückgezogene Routen: IP-Adresspräfixe für die Routen, die aus dem Verkehr gezogen werden, weil sie nicht mehr als erreichbar gelten
-
Gesamtlänge des Pfadattributs: Länge des Felds für Pfadattribute; Es listet die Pfadattribute für eine machbare Route zu einem Ziel auf
-
Pfadattribute: Eigenschaften der Routen, einschließlich des Pfadursprungs, des Mehrfachexit-Diskriminators (MED), der Präferenz des Ursprungssystems für die Route und Informationen zu Aggregation, Gemeinschaften, Konföderationen und Routenreflexion
-
Network Layer Reachability Information (NLRI) – IP-Adresspräfixe möglicher Routen, die in der Update-Nachricht angekündigt werden
Hinweis: Junos OS- und Junos OS Evolved-Geräte senden eine Benachrichtigung und beenden die BGP-Sitzung, wenn das Markierungsfeld in der Kopfzeile der empfangenen Aktualisierungsnachricht nicht auf "Alle" gesetzt ist.
Keepalive-Nachrichten
BGP-Systeme tauschen Keepalive-Nachrichten aus, um festzustellen, ob eine Verbindung oder ein Host ausgefallen oder nicht mehr verfügbar ist. Keepalive-Nachrichten werden oft genug ausgetauscht, damit der Hold-Timer nicht abläuft. Diese Nachrichten bestehen nur aus dem BGP-Header.
Benachrichtigungen
BGP-Systeme senden Benachrichtigungen, wenn eine Fehlerbedingung erkannt wird. Nach dem Senden der Nachricht werden die BGP-Sitzung und die TCP-Verbindung zwischen den BGP-Systemen geschlossen. Benachrichtigungsmeldungen bestehen aus dem BGP-Header sowie dem Fehlercode und dem Untercode sowie den Daten, die den Fehler beschreiben.
Meldungen zur Routen-Aktualisierung
BGP-Systeme senden nur dann Routenaktualisierungsnachrichten an einen Peer, wenn sie die Ankündigung der Routenaktualisierungsfunktion vom Peer erhalten haben. Ein BGP-System muss seinen Peers die Routenaktualisierungsfunktion mithilfe der Ankündigung von BGP-Funktionen ankündigen, wenn es Routenaktualisierungsnachrichten empfangen möchte. Diese optionale Nachricht wird gesendet, um dynamische, eingehende BGP-Routenaktualisierungen von BGP-Peers anzufordern oder ausgehende Routenaktualisierungen an einen BGP-Peer zu senden.
Routenaktualisierungsmeldungen bestehen aus den folgenden Feldern:
-
AFI – Adressfamilienbezeichner (16 Bit).
-
Res – Reserviertes Feld (8 Bit), das vom Absender auf 0 gesetzt und vom Empfänger ignoriert werden muss.
-
SAFI – Subsequent Address Family Identifier (8 Bit).
Wenn ein Peer ohne die Routenaktualisierungsfunktion eine Routenaktualisierungsanforderungsnachricht von einem Remote-Peer empfängt, ignoriert der Empfänger die Nachricht.
Siehe auch
Grundlegendes zu BGP-RIB-Sharding und BGP-Update-E/A-Thread
Die BGP-Routenverarbeitung umfasst in der Regel mehrere Pipeline-Phasen, wie z. B. das Empfangen von Aktualisierungen, das Analysieren von Aktualisierungen, das Erstellen von Routen, das Auflösen von Next-Hops, das Anwenden der Exportrichtlinie einer BGP-Peer-Gruppe, das Bilden von Aktualisierungen pro Peer und das Senden von Aktualisierungen an Peers.
BGP RIB-Sharding teilt eine einheitliche BGP-RIB in mehrere Sub-RIBs auf, und jede Sub-RIB verarbeitet eine Teilmenge von BGP-Routen. Ein separater RPD-Thread, der als BGP-Shard-Thread bezeichnet wird, bedient jede Sub-RIB, um Parallelität zu erreichen. BGP-Shard-Threads sind für alle Phasen der BGP-Routenverarbeitungspipeline verantwortlich, mit Ausnahme der Bildung von Aktualisierungen pro Peer und des Sendens von Aktualisierungen an Peers. BGP-Shard-Threads empfangen die von Peers gesendeten Aktualisierungen von den BGP-Aktualisierungs-E/A-Threads, wobei die BGP-Aktualisierungs-E/A-Threads die Präfixe in den Aktualisierungen hashen und die Aktualisierungen basierend auf der Hashberechnung an die entsprechenden BGP-Shard-Threads senden. Der BGP-Shard-Thread verarbeitet die Konfiguration auf die gleiche Weise wie der RPD-Hauptthread, erstellt Peers, Gruppen und Routing-Tabellen und verwendet die Konfigurationsinformationen für die BGP-Routenverarbeitung.
BGP-Update-E/A-Threads sind für das Ende dieser BGP-Pipeline verantwortlich, d. h. für das Generieren von Aktualisierungen pro Peer für einzelne BGP-Gruppen und das Senden an die Peers. Ein Update-Thread kann eine oder mehrere BGP-Gruppen bedienen. BGP-Aktualisierungs-E/A-Threads erstellen Aktualisierungen für Gruppen parallel und unabhängig von anderen Gruppen, die von anderen Aktualisierungsthreads bedient werden. Dies kann zu einer erheblichen Verbesserung der Konvergenz bei einer schreiblastigen Arbeitsauslastung führen, bei der viele Peers über viele Gruppen verteilt beworben werden müssen. BGP-Update-E/A-Threads sind auch für das Schreiben und Lesen in die TCP-Sockets der BGP-Peers verantwortlich, was zuvor von BGPIO-Threads bereitgestellt wurde (daher das Suffix IO in BGP Update IO).
BGP-Update-E/A-Threads können unabhängig von der RIB-Sharding-Funktion konfiguriert werden, sind jedoch für die Verwendung mit RIB-Sharding obligatorisch, um eine bessere Effizienz beim Prefix-Packen in ausgehenden BGP-Aktualisierungsnachrichten zu erreichen. Beim BGP-Sharding wird die RIB in mehrere Sub-RIBs aufgeteilt, die von separaten RPD-Threads bedient werden. Daher landen Präfixe, die in ein einzelnes ausgehendes Update hätten einfließen können, in verschiedenen Shards. Um BGP-Aktualisierungen mit Präfixen mit demselben ausgehenden Attribut erstellen zu können, das zu verschiedenen RPD-Shardthreads gehören kann, senden alle Shardthreads kompakte Ankündigungsinformationen für Präfixe, die an einen Updatethread angekündigt werden sollen, der diese BGP-Peer-Gruppe bedient. Dadurch kann der Updatethread, der diese BGP-Peer-Gruppe bedient, Präfixe mit denselben Attributen packen, die möglicherweise zu verschiedenen Shards in derselben ausgehenden Updatenachricht gehören. Dies minimiert die Anzahl der anzukündigenden Updates und trägt somit zur Verbesserung der Konvergenz bei. Update IO Thread verwaltet lokale Caches von Peer-, Gruppen-, Präfix-, TSI- und RIB-Containern.
BGP-Update-Thread und BGP-RIB-Sharding sind standardmäßig deaktiviert. Wenn Sie Update-Threading und Rib-Sharding auf einer Routing-Engine konfigurieren, erstellt RPD Update-Threads. Standardmäßig entspricht die Anzahl der erstellten Update- und Shardthreads der Anzahl der CPU-Kerne auf der Routing-Engine. Update-Threading wird nur bei einem 64-Bit-Routing-Protokollprozess (RPD) unterstützt. Optional können Sie die Anzahl der Threads angeben, die Sie mithilfe von set update-threading <number-of-threads> und-Anweisungen set rib-sharding <number-of-threads> auf Hierarchieebene [edit system processes routing bgp] erstellen möchten. Für den BGP-Updatethread liegt der Bereich derzeit zwischen 1 und 128 und für BGP RIB-Sharding zwischen 1 und 31.
Wenn Sie NSR für die Funktionen BGP RIB-Sharding und BGP-E/A-Update konfigurieren, erstellt der Backup-RPD die gleiche Anzahl von BGP-Shard- und BGP-Update-E/A-Threads in der Backup-Routing-Engine. Die Backup-RPD-BGP-Update-E/A-Threads lesen das replizierte BGP-Update, andere von den Peers empfangene Nachrichten sowie das replizierte BGP-Update und andere Nachrichten, die an die Peers gesendet werden. Basierend auf dem Hashing von Präfixen senden die Backup-RPD-BGP-Update-E/A-Threads diese BGP-Nachrichten an den entsprechenden BGP-Shard und die RPD-Hauptthreads. Der BGP-Shard und die RPD-Hauptthreads im Backup-RPD erstellen den empfangenen und angekündigten Routenstatus mithilfe dieser replizierten BGP-Nachrichten. Wenn die primäre Routing-Engine ausfällt, wird die Backup-Routing-Engine zur primären Routing-Engine und der Backup-RPD wird nahtlos zum primären RPD, ohne die BGP-Sitzungen mit den Peers zu beeinträchtigen.
Grundlegendes zur BGP-Pfadauswahl
Für jedes Präfix in der Routing-Tabelle wählt der Routing-Protokollprozess einen einzigen besten Pfad aus. Nachdem der beste Pfad ausgewählt wurde, wird die Route in der Routing-Tabelle installiert. Der beste Pfad wird zur aktiven Route, wenn dasselbe Präfix nicht von einem Protokoll mit einem niedrigeren (bevorzugten) globalen Präferenzwert gelernt wird, der auch als administrative Distanz bezeichnet wird. Der Algorithmus zur Bestimmung der aktiven Route lautet wie folgt:
-
Stellen Sie sicher, dass der nächste Hop aufgelöst werden kann.
-
Wählen Sie den Pfad mit dem niedrigsten Präferenzwert (Prozesspräferenz für das Routing-Protokoll).
Routen, die nicht für die Weiterleitung verwendet werden können (z. B. weil sie von der Routing-Richtlinie abgelehnt wurden oder weil auf einen nächsten Hop nicht zugegriffen werden kann), haben die Einstellung –1 und werden nie ausgewählt.
-
Bevorzugen Sie den Pfad mit höherer lokaler Präferenz.
Wählen Sie für Nicht-BGP-Pfade den Pfad mit dem niedrigsten Wert preference2 aus.
-
Wenn das Attribut "Accumulated Interior Gateway Protocol (AIGP)" aktiviert ist, fügen Sie die IGP-Metrik hinzu und bevorzugen Sie den Pfad mit dem niedrigeren AIGP-Attribut.
-
Bevorzugen Sie den Pfad mit dem kürzesten Pfadwert des autonomen Systems (AS) (übersprungen, wenn die
as-path-ignoreAnweisung konfiguriert ist).Ein Konföderationssegment (Sequenz oder Menge) hat eine Pfadlänge von 0. Eine AS-Menge hat eine Weglänge von 1.
-
Bevorzugen Sie die Route mit dem unteren Ursprungscode.
Routen, die von einem IGP gelernt wurden, haben einen niedrigeren Ursprungscode als solche, die von einem Exterior Gateway Protocol (EGP) gelernt wurden, und beide haben niedrigere Ursprungscodes als unvollständige Routen (Routen, deren Ursprung unbekannt ist).
-
Bevorzugen Sie den Pfad mit der niedrigsten MED-Metrik (Multiple Exit Discriminator).
Je nachdem, ob das Pfadauswahlverhalten einer nicht-deterministischen Routing-Tabelle konfiguriert ist, gibt es zwei mögliche Fälle:
-
Wenn das Pfadauswahlverhalten der nicht-deterministischen Routing-Tabelle nicht konfiguriert ist (d. h., wenn die
path-selection cisco-nondeterministicAnweisung nicht in der BGP-Konfiguration enthalten ist), bevorzugen Sie für Pfade mit denselben benachbarten AS-Nummern am Anfang des AS-Pfads den Pfad mit der niedrigsten MED-Metrik. Um MEDs immer unabhängig davon zu vergleichen, ob die Peer-ASs der verglichenen Routen identisch sind oder nicht, fügen Sie diepath-selection always-compare-medAnweisung hinzu. -
Wenn das Pfadauswahlverhalten einer nicht-deterministischen Routing-Tabelle konfiguriert ist (d. h., die
path-selection cisco-nondeterministicAnweisung ist in der BGP-Konfiguration enthalten), bevorzugen Sie den Pfad mit der niedrigsten MED-Metrik.
Konföderationen werden bei der Bestimmung benachbarter ASs nicht berücksichtigt. Eine fehlende MED-Metrik wird so behandelt, als ob eine MED vorhanden wäre, aber null.
Hinweis:Der MED-Vergleich funktioniert für die Auswahl einer einzelnen Route innerhalb eines AS (wenn die Route keinen AS-Pfad enthält), obwohl diese Verwendung ungewöhnlich ist.
Standardmäßig werden nur die MEDs von Routen verglichen, die über dieselben autonomen Peer-Systeme (ASs) verfügen. Sie können die Optionen für die Pfadauswahl der Routing-Tabelle konfigurieren, um unterschiedliche Verhaltensweisen zu erhalten.
-
-
Bevorzugen Sie ausschließlich interne Pfade, zu denen IGP-Routen und lokal generierte Routen (statische, direkte, lokale usw.) gehören.
-
Bevorzugen Sie ausschließlich externe BGP (EBGP)-Pfade gegenüber externen Pfaden, die durch interne BGP (IBGP)-Sitzungen erlernt werden.
-
Bevorzugen Sie den Pfad, dessen nächster Hop über die IGP-Route mit der niedrigsten Metrik aufgelöst wird. BGP-Routen, die über IGP aufgelöst werden, werden gegenüber unerreichbaren oder abgelehnten Routen bevorzugt.
Hinweis:Ein Pfad gilt als BGP-Pfad zu gleichen Kosten (und wird für die Weiterleitung verwendet), wenn nach dem vorherigen Schritt ein Tie-Break durchgeführt wird. Es werden alle Pfade mit demselben benachbarten AS berücksichtigt, die von einem Multipath-fähigen BGP-Nachbarn gelernt wurden.
BGP-Multipath gilt nicht für Pfade, die dieselben MED-plus-IGP-Kosten aufweisen, sich jedoch in den IGP-Kosten unterscheiden. Die Multipath-Pfadauswahl basiert auf der IGP-Kostenmetrik, auch wenn zwei Pfade die gleichen MED-plus-IGP-Kosten haben.
-
Wenn beide Pfade extern sind, bevorzugen Sie den ältesten Pfad, d. h. den Pfad, der zuerst gelernt wurde. Dies geschieht, um das Flapping von Routen zu minimieren. Diese Regel wird nicht verwendet, wenn eine der folgenden Bedingungen zutrifft:
-
path-selection external-router-id ist konfiguriert.
-
Beide Peers haben dieselbe Router-ID.
-
Jeder Peer ist ein Konföderations-Peer.
-
Keiner der Pfade ist der derzeit aktive Pfad.
-
-
Bevorzugen Sie den Pfad des Peers mit der niedrigsten Router-ID. Ersetzen Sie bei jedem Pfad mit einem Ursprungs-ID-Attribut die Router-ID während des Router-ID-Vergleichs durch die Absender-ID.
-
Bevorzugen Sie den Pfad mit der kürzesten Länge der Cluster-Liste. Die Länge ist 0 für keine Liste.
-
Bevorzugen Sie den Pfad von dem Peer mit der niedrigsten Peer-IP-Adresse.
-
Bevorzugen Sie eine primäre Route gegenüber einer sekundären Route. Eine primäre Route ist eine Route, die zur Routing-Tabelle gehört. Eine sekundäre Route ist eine Route, die der Routing-Tabelle über eine Exportrichtlinie hinzugefügt wird.
- Auswahl des Routing-Tabellenpfads
- Auswahl des BGP-Tabellenpfads
- Auswirkungen der Ankündigung mehrerer Pfade zu einem Ziel
Auswahl des Routing-Tabellenpfads
Der kürzeste AS-Pfadschritt des Algorithmus wertet standardmäßig die Länge des AS-Pfads aus und bestimmt den aktiven Pfad. Sie können eine Option konfigurieren, die es Junos OS ermöglicht, diesen Schritt des Algorithmus zu überspringen, indem Sie die Option as-path-ignore einschließen.
Ab Junos OS Version 14.1R8, 14.2R7, 15.1R4, 15.1F6 und 16.1R1 wird die Option as-path-ignore für Routing-Instanzen unterstützt.
Die Auswahl des Routing-Prozesspfads erfolgt, bevor BGP den Pfad an die Routing-Tabelle übergibt, um seine Entscheidung zu treffen. Um das Pfadauswahlverhalten der Routing-Tabelle zu konfigurieren, fügen Sie die path-selection folgende Anweisung ein:
path-selection {
    (always-compare-med | cisco-non-deterministic | external-router-id);
    as-path-ignore;
    l2vpn-use-bgp-rules;
    med-plus-igp {
        igp-multiplier number;
        med-multiplier number;
    }
}
Eine Liste der Hierarchieebenen, auf denen Sie diese Anweisung einschließen können, finden Sie im Abschnitt Zusammenfassung der Anweisungen für diese Anweisung.
Die Auswahl des Routing-Tabellenpfads kann auf eine der folgenden Arten konfiguriert werden:
-
Emulieren Sie das Standardverhalten von Cisco IOS (cisco-nicht-deterministisch). Dieser Modus wertet Routen in der Reihenfolge aus, in der sie empfangen werden, und gruppiert sie nicht nach ihrem benachbarten AS. Im
cisco-non-deterministicModus steht der aktive Pfad immer an erster Stelle. Alle inaktiven, aber zulässigen Pfade folgen dem aktiven Pfad und werden in der Reihenfolge ihres Eingangs beibehalten, wobei der neueste Pfad zuerst angezeigt wird. Nicht förderfähige Pfade verbleiben am Ende der Liste.Angenommen, Sie haben drei Pfadankündigungen für die Route 192.168.1.0 /24:
-
Pfad 1 – erlernt durch EBGP; AS-Pfad von 65010; MED von 200
-
Pfad 2 – erlernt durch IBGP; AS-Pfad von 65020; MED von 150; IGP-Kosten von 5
-
Pfad 3 – erlernt durch IBGP; AS-Pfad von 65010; MED von 100; IGP-Kosten von 10
Diese Anzeigen werden in schneller Folge, innerhalb einer Sekunde, in der angegebenen Reihenfolge empfangen. Pfad 3 wird zuletzt empfangen, sodass das Routing-Gerät ihn mit Pfad 2, der nächstletzten Ankündigung, vergleicht. Die Kosten für den IBGP-Peer sind für Pfad 2 besser, sodass das Routing-Gerät Pfad 3 aus Konflikten eliminiert. Beim Vergleich der Pfade 1 und 2 bevorzugt das Routing-Gerät Pfad 1, da er von einem EBGP-Peer empfangen wird. Dadurch kann das Routing-Gerät Pfad 1 als aktiven Pfad für die Route installieren.
Hinweis:Es wird nicht empfohlen, diese Konfigurationsoption in Ihrem Netzwerk zu verwenden. Er dient ausschließlich der Interoperabilität, damit alle Routing-Geräte im Netzwerk konsistente Routen auswählen können.
-
-
MEDs werden immer verglichen, unabhängig davon, ob die Peer-ASs der verglichenen Routen gleich sind oder nicht (always-compare-med).
-
Überschreiben Sie die Regel, dass Wenn beide Pfade extern sind, wird der derzeit aktive Pfad bevorzugt (external-router-id). Fahren Sie mit dem nächsten Schritt (Schritt 15) des Pfadauswahlprozesses fort.
-
Addieren der IGP-Kosten zum Next-Hop-Ziel zum MED-Wert vor dem Vergleich der MED-Werte für die Pfadauswahl (
med-plus-igp).BGP-Multipath gilt nicht für Pfade, die die gleichen MED-plus-IGP-Kosten aufweisen, sich jedoch in den IGP-Kosten unterscheiden. Die Multipath-Pfadauswahl basiert auf der IGP-Kostenmetrik, auch wenn zwei Pfade die gleichen MED-plus-IGP-Kosten haben.
Auswahl des BGP-Tabellenpfads
Die folgenden Parameter werden für die Pfadauswahl von BGP befolgt:
-
Bevorzugen Sie den höchsten lokalen Präferenzwert.
-
Bevorzugen Sie die kürzeste AS-Pfadlänge.
-
Bevorzugen Sie den niedrigsten Ursprungswert.
-
Bevorzugen Sie den niedrigsten MED-Wert.
-
Routen, die von einem EBGP-Peer erlernt wurden, gegenüber einem IBGP-Peer bevorzugen.
-
Bevorzugen Sie den besten Ausstieg aus AS.
-
Bevorzugen Sie für EBGP-empfangene Routen die aktuell aktive Route.
-
Bevorzugen Sie Routen vom Peer mit der niedrigsten Router-ID.
-
Bevorzugen Sie Pfade mit der kürzesten Cluster-Länge.
-
Bevorzugen Sie Routen von dem Peer mit der niedrigsten Peer-IP-Adresse. Die Schritte 2, 6 und 12 sind die RPD-Kriterien.
Auswirkungen der Ankündigung mehrerer Pfade zu einem Ziel
BGP kündigt nur den aktiven Pfad an, es sei denn, Sie konfigurieren BGP so, dass mehrere Pfade zu einem Ziel angekündigt werden.
Angenommen, ein Routinggerät hat in seiner Routing-Tabelle vier Pfade zu einem Ziel und ist so konfiguriert, dass es bis zu drei Pfade ankündigt (add-path send path-count 3). Die drei Pfade werden anhand von Pfadauswahlkriterien ausgewählt. Das heißt, die drei besten Pfade werden in der Reihenfolge der Pfadauswahl ausgewählt. Der beste Pfad ist der aktive Pfad. Dieser Weg wird aus der Betrachtung entfernt und ein neuer bester Weg wird gewählt. Dieser Vorgang wird wiederholt, bis die angegebene Anzahl von Pfaden erreicht ist.
Siehe auch
Verstehen unbekannter optionaler transitiver BGP-Attributverarbeitung für BGP-Aktualisierungsnachrichten
Wenn eine BGP-Aktualisierungsnachricht unbekannte optionale Attribute enthält, können diese Attribute fehlerhaft und transitiv sein. Router können keine Fehlformprüfungen durchführen, sodass diese unbekannten Attribute möglicherweise an andere BGP-Peers weitergeleitet werden. Die Verbreitung von fehlerhaften Attributen kann zu Bedrohungen für die Netzwerksicherheit führen und den BGP-Betrieb gefährden.
Die Verwaltung unbekannter BGP-Attribute verbessert die Netzwerksicherheit und -stabilität durch die Verwaltung unbekannter optionaler transitiver BGP-Attribute innerhalb des BGP-Systems. Sie können das BGP-System so konfigurieren, dass solche BGP-Attribute entweder gelöscht oder Routen mit diesen Attributen zurückgezogen werden, um das Risiko der Weitergabe von fehlerhaften oder potenziell schädlichen Attributen zwischen BGP-Peers zu vermeiden. Sie können auch Ausnahmen angeben, um ausgewählte unbekannte optionale transitive BGP-Attribute auszuschließen, die nicht gelöscht werden sollen oder einen Routenentzug verursachen. Diese Konfigurationen können auf globalem BGP, auf Gruppenebene oder auf einzelne Nachbarn angewendet werden, wodurch eine umfassende Kontrolle über den BGP-Betrieb gewährleistet wird.
Um die BGP-Attribute zu löschen oder Routen mit diesen Attributen zurückzuziehen, konfigurieren Sie die path-attributes drop (attributes <>) oder-Befehle path-attributes withdraw-routes (attributes <>) .
Um die unbekannten optionalen transitiven BGP-Attribute zu löschen oder Routen mit diesen Attributen zu entfernen, konfigurieren Sie die path-attributes drop (unknown-optional-transitive) oder-Befehle path-attributes withdraw-routes (unknown-optional-transitive) .
Um Ausnahmen zu definieren, um ausgewählte unbekannte optionale transitive BGP-Attribute auszuschließen, konfigurieren Sie die path-attributes drop (unknown-optional-transitive [except <>]) oder-Befehle path-attributes withdraw-routes (unknown-optional-transitive [except <>]) .
Wenn Sie mehrere Aktionen für dasselbe Attribut konfigurieren, können Sie nur die Auszahlungsaktion ausführen.
show log messages Die und-Befehle show BGP neighbor zeigen die unbekannten optionalen transitiven BGP-Attribute, die für das Verwerfen oder Auslösen von Routenentzügen konfiguriert sind, mit einem detaillierten Protokoll an. Die erhöhte Visibilität erleichtert ein effektives Netzwerkmanagement und eine effektive Fehlerbehebung, indem sie Transparenz bei der Handhabung von Aktivitäten im Zusammenhang mit BGP-Attributen innerhalb des BGP-Systems bietet.
Verbesserte Service-Routenauflösung für BGP Multipath mit List Nexthop
Junos OS verbessert die Auflösung von Servicerouten auf BGP-Multipath-Hilfsrouten, die List-nexthop-Strukturen verwenden. Der Routenauflöser erstellt und verwaltet jetzt interne Abhängigkeiten für alle beitragenden Pfade in einer Multipath-Route und ermöglicht eine genaue und dynamische Neuauflösung, wenn sich indirekte Nexthops ändern, unabhängig davon, ob die beitragende Route aktiv oder inaktiv ist.
Diese Funktion verbessert die Stabilität von Service-Routen und verhindert veraltete Weiterleitungspfade in Netzwerken, die BGP ECMP mit indirekter Nexthop-Auflösung verwenden.
- Vorteile
- Bevor Sie beginnen
- Funktionsweise der Funktion
- Betriebsbeispiel
- CLI-Befehlsreferenz
- Einschränkungen
Vorteile
- Sorgt für eine präzise Weiterleitung von Servicerouten, die über BGP-Multipath aufgelöst werden.
- Löst eine erneute Auflösung aus, wenn sich ein beitragender Pfad ändert, nicht nur der Lead-Pfad.
- Unterstützt hybride iBGP- und eBGP-Multipath-Topologien mit indirekten Nexthops.
- Verhindert Datenverkehrsverluste aufgrund veralteter oder veralteter Auflösungszustände.
Bevor Sie beginnen
Stellen Sie sicher, dass die BGP-Multipath-Befehlsanweisung list-nexthop für die relevanten Adressfamilien aktiviert ist. Es ist keine neue Konfiguration erforderlich, um diese Funktion zu aktivieren.
Funktionsweise der Funktion
Wenn eine Serviceroute über eine BGP-Multipath-Route mit einem list-nexthop aufgelöst wird, führt RPD die folgenden Aktionen aus:
-
Geht durch alle nexthop-Komponenten in der list-nexthop.
-
Richtet Abhängigkeitsbeziehungen zwischen der Multipath-Hilfsroute und den einzelnen beitragenden Pfaden ein.
-
Speichert diese Abhängigkeiten in einer internen Datenbank unter Verwendung einer Patricia-Baumstruktur. Erstellt diese Beziehungen bei Bedarf:
-
Ein Patricia-Strukturknoten wird nur instanziiert, wenn die erste Serviceroute über die Multipath-Hilfsroute aufgelöst wird.
-
Wenn die letzte abhängige Serviceroute nicht mehr über diese Multipath-Route aufgelöst wird, wird der entsprechende Knoten automatisch aus der Struktur entfernt.
-
-
Überwacht indirekte Nexthop-Änderungen mithilfe von KRT-Hook-Callbacks.
-
Löst die abhängigen Servicerouten erneut auf, wenn sich eine beitragende Route (aktiv oder inaktiv) ändert.
Dieses Verhalten gilt unabhängig davon, ob die beitragende Route im Multipath-Set aktiv oder inaktiv ist.
Betriebsbeispiel
Szenario:
Eine Serviceroute (9.9.9.9/32) wird über eine BGP-Multipath-Route (1.1.1.9/32) mit den folgenden beitragenden Pfaden aufgelöst:
iBGP path-1(Lead/Aktiv): über7.7.7.7→1.2.3.4→10.50.10.1iBGP path-2: über8.8.8.8
Bei iBGP path-2 Änderungen (z. B. aufgrund eines Nexthop-Updates), erkennt Junos OS die Änderung und löst die abhängige Serviceroute erneut auf.
CLI-Befehlsreferenz
Mit den folgenden Befehlen können Sie List-Nexthop-Resolver-Beziehungen anzeigen und Multipath-Routenabhängigkeiten von indirekten NextHops überwachen.
-
show route resolution list-nhZeigt indirekte Next-Hop-Handles (INH) in der internen List-Nexthop-Abhängigkeitsdatenbank zusammen mit den davon abhängigen BGP-Multipath-Routen an. Dieser Befehl zeigt nur die Multipath-Hilfsrouten an, die eine bestimmte INH verwenden.
Beispiel für eine Ausgabe:
user@router> show route resolution list-nh

Indirect next-hop statistics in List-nexthop database:
Inh adds: 9, Inh deletes: 4
Inh change callback: registered

Indirect next-hop:
Inh handle: 0x8969d30; Inh protocol nexthop: 8.8.8.8
Multipath route: 1.1.1.0/24, resolver node: 0xf9e9ed8

Indirect next-hop:
Inh handle: 0x8969b98; Inh protocol nexthop: 7.7.7.7
Multipath route: 1.1.1.0/24, resolver node: 0xf9e9ed8
Multipath route: 3.3.3.0/24, resolver node: 0x8d88cb8
-
show route resolution list-nh protocol-next-hop <nexthop>Zeigt alle Multipath-Routen an, die einen bestimmten indirekten Nexthop verwenden.
Beispiel:
user@router> show route resolution list-nh protocol-next-hop 9.9.9.9 Protocol Nexthop: 9.9.9.9 Used by: - Multipath Route: 1.1.1.0/24 - Multipath Route: 2.2.2.0/24 - Multipath Route: 3.3.3.0/24 -
show krt indirect-next-hopZeigt Kernel-Routing-Tabelleninformationen für einen bestimmten indirekten Nexthop-Index an, einschließlich der Anzahl der Multipath-Routen, die von diesem Nexthop abhängig sind. Dieser Befehl zeigt die Anzahl von Referenzen und Weiterleitungsabhängigkeiten im Zusammenhang mit Multipath-Routen an.
Beispiel für eine Ausgabe:
user@router> show krt indirect-next-hop index 1048574

Indirect Nexthop:
Index: 1048574 Protocol next-hop address: 7.7.7.7
...
INH list-nh dependent count: 2
Der
dependent count: 2bestätigt, dass derzeit zwei Multipath-Routen diesen indirekten Nexthop nutzen.
Einschränkungen
- Gilt nur für BGP-Multipath-Routen mit List-Nexthops, die aus iBGP- oder hybriden iBGP/eBGP-Pfaden bestehen.
- BGP-Multipath-Routen mit nur eBGP-Mitwirkenden sind nicht betroffen.
- Gemischte Adressfamilien in einem einzelnen List-Nexthop werden nicht unterstützt.
Siehe auch
Unterstützte Standards für BGP
Junos OS unterstützt im Wesentlichen die folgenden RFCs und Internet-Entwürfe, die Standards für IP Version 4 (IPv4) BGP definieren.
Eine Liste der unterstützten IP Version 6 (IPv6) BGP-Standards finden Sie unter Unterstützte IPv6-Standards.
Junos OS BGP unterstützt die Authentifizierung für den Protokollaustausch (MD5-Authentifizierung).
-
RFC 1745, BGP4/IDRP für IP-OSPF-Interaktion
-
RFC 1772, Anwendung des Border Gateway Protocol im Internet
-
RFC 1997, BGP Communities Attribut
-
RFC 2283, Multiprotokoll-Erweiterungen für BGP-4
-
RFC 2385, Schutz von BGP-Sitzungen über die TCP MD5-Signaturoption
-
RFC 2439, BGP Routen-Klappendämpfung
-
RFC 2545, Verwendung von BGP-4-Multiprotokollerweiterungen für IPv6-Routing zwischen Domänen
-
RFC 2796, BGP Route Reflection – eine Alternative zu Full Mesh IBGP
-
RFC 2858, Multiprotokoll-Erweiterungen für BGP-4
-
RFC 2918, Route aktualisieren-Funktion für BGP-4
-
RFC 3065, Konföderationen autonomer Systeme für BGP
-
RFC 3107, Übertragung von Label-Informationen in BGP-4
-
RFC 3345, Border Gateway Protocol (BGP) Persistent Route Oscillation Condition
-
RFC 3392, Funktionsanzeige mit BGP-4
-
RFC 4271, A Border Gateway Protocol 4 (BGP-4)
-
RFC 4273, Definitionen verwalteter Objekte für BGP-4
-
RFC 4360, BGP Extended Communities Attribut
-
RFC 4364, BGP/MPLS IP Virtual Private Networks (VPNs)
-
RFC 4456, BGP Route Reflection: Eine Alternative zu Full Mesh Internal BGP (IBGP)
-
RFC 4486, Subcodes für die Benachrichtigung über das Beenden von BGP-Einstellungen
-
RFC 4576, Verwendung eines Link State Advertisement (LSA)-Optionsbits zur Vermeidung von Schleifen in BGP/MPLS IP Virtual Private Networks (VPNs)
-
RFC 4659, BGP-MPLS IP Virtual Private Network (VPN)-Erweiterung für IPv6 VPN
-
RFC 4632, Classless Inter-domain Routing (CIDR): Der Internetadressenzuweisungs- und Aggregationsplan
-
RFC 4684, Eingeschränkte Routenverteilung für Border Gateway Protocol/MultiProtocol Label Switching (BGP/MPLS), Internet Protocol (IP), Virtual Private Networks (VPNs)
-
RFC 4724, Graceful-Restart-Mechanismus für BGP
-
RFC 4760, Multiprotokoll-Erweiterungen für BGP-4
-
RFC 4781, Graceful-Restart-Mechanismus für BGP mit MPLS
-
RFC 4798, Verbinden von IPv6-Inseln über IPv4-MPLS mithilfe von IPv6-Provider-Edge-Routern (6PE)
Option 4b (eBGP-Umverteilung von gekennzeichneten IPv6-Routen von AS zu benachbarten AS) wird nicht unterstützt.
-
RFC 4893, BGP-Unterstützung für AS-Nummernraum mit vier Oktetten
-
RFC 5004, Vermeidung von BGP Beste Pfadübergänge von einem externen zum anderen
-
RFC 5065, Konföderationen autonomer Systeme für BGP
-
RFC 5082, Der allgemeine TTL-Sicherheitsmechanismus (GTSM)
-
RFC 5291, Outbound Route Filtering Capability für BGP-4 (teilweise Unterstützung)
-
RFC 5292, Adresspräfix-basierter ausgehender Routenfilter für BGP-4 (teilweise Unterstützung)
Geräte, auf denen Junos OS ausgeführt wird, können präfixbasierte ORF-Nachrichten empfangen.
-
RFC 5396, Textuelle Darstellung von Nummern autonomer Systeme (AS)
-
RFC 5492, Funktionsanzeige mit BGP-4
-
RFC 5512, der BGP Encapsulation Subsequent Address Family Identifier (SAFI) und das BGP Tunnel Encapsulation Attribute
-
RFC 5549, Werbung für IPv4-Informationen zur Erreichbarkeit auf Netzwerkschicht mit einem IPv6 Next Hop
-
RFC 8955, Verbreitung von Regeln für Flussspezifikationen
-
RFC 8956, Verbreitung von Regeln für Flussspezifikationen für IPv6
-
RFC 5668, 4-Oktett AS-spezifisches BGP Erweiterte Community
-
RFC 5701, IPv6 Address Specific BGP Extended Community Attribute
-
RFC 5925, die TCP-Authentifizierungsoption
-
RFC 6286, autonome systemweite eindeutige BGP-Kennung für BGP-4-konform
-
RFC 6368, internes BGP als Anbieter/Kunden-Edge-Protokoll für BGP/MPLS IP Virtual Private Networks (VPNs)
-
RFC 6774, Verteilung verschiedener BGP-Pfade
-
RFC 6793, BGP-Unterstützung für Nummernraum für autonome Systeme mit vier Oktetten (AS)
-
RFC 6810, The Resource Public Key Infrastructure (RPKI) to Router Protocol
-
RFC 6811, BGP-Präfixursprungsvalidierung
-
RFC 6996, Reservierung für autonome Systeme (AS) für den privaten Gebrauch
-
RFC 7300, Reservierung der Nummern des letzten autonomen Systems (AS)
-
RFC 7311, Das kumulierte IGP-Metrikattribut für BGP
-
RFC 7404, nur Link-lokale Adressierung innerhalb eines IPv6-Netzwerks
-
RFC 7432, BGP MPLS-basiertes Ethernet-VPN (eVPN)
-
RFC 7606, Überarbeitete Fehlerbehandlung für BGP UPDATE-Meldungen
-
RFC 7611, BGP ACCEPT_OWN Community-Attribut
Wir unterstützen den RFC, indem wir es Juniper-Routern ermöglichen, Routen zu akzeptieren, die
accept-ownvon einem Routenreflektor mit dem Community-Wert empfangen werden. -
RFC 7752, North-Bound Distribution von Link-State- und Traffic Engineering (TE)-Informationen mithilfe von BGP
-
RFC 7854, BGP Monitoring Protocol (BMP)
-
RFC 7911, Anzeige mehrerer Pfade in BGP
-
RFC 8097, BGP Prefix Origin Validation State Erweiterte Community
-
RFC 8210, The Resource Public Key Infrastructure (RPKI) to Router Protocol, Version 1
-
RFC 8212, Standardmäßiges externes BGP (EBGP) Routenpropagierungsverhalten ohne Richtlinien – vollständig konform
Ausnahmen:
Die Verhaltensweisen in RFC 8212 sind standardmäßig nicht implementiert, um Unterbrechungen der bestehenden Kundenkonfiguration zu vermeiden. Das Standardverhalten wird weiterhin beibehalten, um alle Routen in Bezug auf EBGP-Peers zu akzeptieren und anzukündigen.
-
RFC 8277, Verwendung von BGP zur Bindung von MPLS-Labels an Adresspräfixe
-
RFC 8326, Graceful-Shutdown der BGP-Sitzung
-
RFC 8481, Erläuterungen zur BGP-Ursprungsvalidierung basierend auf der Resource Public Key Infrastructure (RPKI)
-
RFC 8538, Benachrichtigungsmeldung unterstützt BGP Graceful-Restart
-
RFC 8571, BGP – Link State (BGP-LS) Ankündigung von IGP Traffic Engineering Erweiterungen von Leistungsmetriken
-
RFC 8584, Framework für Ethernet VPN Designated Forwarder Choice Erweiterbarkeit
-
RFC 8642, Richtlinienverhalten für bekannte BGP-Gemeinschaften
-
RFC 8669, Segment-Routing-Präfix Segment-Identifier-Erweiterungen für BGP
-
RFC 8810, Revision der Registrierungsverfahren für Funktionscodes
-
RFC 8814 Signaling Maximum SID Depth (MSD) Using the Border Gateway Protocol – Link State (partial support)
-
RFC 8950, Werbung für IPv4 Netzwerkschicht Reachability Information (NLRI) mit einem IPv6 Next Hop
-
RFC 8955
-
RFC 8956
-
RFC 9003, Erweiterte BGP-Kommunikation zum administrativen Herunterfahren
-
RFC 9012, Das BGP-Tunnelkapselungsattribut
-
RFC 9029, Aktualisierungen der Zuweisungsrichtlinie für die Parameterregister des Border Gateway Protocol - Link State (BGP-LS)
-
RFC 9069, Unterstützung für lokale RIB im BGP Monitoring Protocol (BMP)
-
RFC 9085, Border Gateway Protocol - Link State (BGP-LS) Erweiterungen für Segment-Routing
-
RFC 9117, Überarbeitetes Validierungsverfahren für die Verbreitung von BGP-Flussspezifikationen. Dadurch können die Flow-Spezifikationen innerhalb desselben autonomen Systems erstellt werden wie der BGP-Peer, der die Validierung durchführt.
-
RFC 9234, Verhinderung und Erkennung von Routenlecks mithilfe von Rollen in UPDATE- und OPEN-Nachrichten
-
RFC 9384, A BGP Cease NOTIFICATION Subcode für Bidirectional Forwarding Detection (BFD)
-
Internet draft draft-idr-rfc8203bis-00, BGP Administrative Shutdown Communication (bis Oktober 2018)
-
Internet draft draft-ietf-grow-bmp-adj-rib-out-01, Unterstützung für adj-RIB-out im BGP Monitoring Protocol (BMP) (läuft am 3. September 2018 ab)
-
Internet draft draft-ietf-idr-aigp-06, The Accumulated IGP Metric Attribute for BGP (läuft im Dezember 2011 ab)
-
Internet-Entwurf draft-ietf-idr-as0-06, Kodifizierung der AS 0-Verarbeitung (läuft im Februar 2013 ab)
-
Internetentwurf draft-ietf-idr-link-bandwidth-06.txt, BGP Link Bandwidth Extended Community (läuft ab Juli 2013)
-
Internet draft draft-ietf-sidr-origin-validation-signaling-00, BGP Prefix Origin Validation State Extended Community (teilweise Unterstützung) (läuft im Mai 2011 ab)
Die erweiterte Community (Ursprungsvalidierungsstatus) wird in der Junos OS-Routing-Richtlinie unterstützt. Die angegebene Änderung im Routenauswahlverfahren wird nicht unterstützt.
-
Internetentwurf draft-kato-bgp-ipv6-link-local-00.txt, BGP4+ Peering mit link-lokaler IPv6-Adresse
Die folgenden RFCs und Internet-Entwürfe definieren keine Standards, sondern informieren über BGP und verwandte Technologien. Die IETF klassifiziert sie unterschiedlich als "experimentell" oder "informativ".
-
RFC 1965, Konföderationen autonomer Systeme für BGP
-
RFC 1966, BGP Route Reflection – Eine Alternative zu Full-Mesh-IBGP
-
RFC 2270, Verwendung eines dedizierten AS für Standorte, die von einem einzigen Provider verwaltet werden
-
RFC 3345, Border Gateway Protocol (BGP) Persistent Route Oscillation Condition
-
RFC 3562, Wichtige Überlegungen zur Verwaltung der TCP-MD5-Signaturoption
-
Internet draft draft-ietf-ngtrans-bgp-tunnel-04.txt, Connecting IPv6 Islands across IPv4 Clouds with BGP (Läuft ab Juli 2002)
Siehe auch
Tabellarischer Änderungsverlauf
Die Unterstützung der Funktion hängt von der Plattform und der Version ab, die Sie benutzen. Verwenden Sie den Feature-Explorer , um festzustellen, ob eine Funktion auf Ihrer Plattform unterstützt wird.