
NESTA PÁGINA
-
Exemplo: configuração de rotas BGP IPv6 sobre transporte IPv4
-
Anunciando rotas IPv4 sobre BGP Visão geral das sessões IPv6
-
Entender a redistribuição de rotas IPv4 com o próximo salto IPv6 no BGP
-
Configuração do BGP para redistribuir rotas IPv4 com endereços IPv6 next-hop
-
Exemplo: permitindo que o BGP carregue rotas de especificação de fluxo
-
Exemplo: configurar o BGP para transportar rotas de especificação de fluxo IPv6
-
Configuração da especificação de fluxo BGP Redirecionamento para IP
-
Configuração da ação de especificação de fluxo BGP Redirecionar para IP para filtrar o tráfego DDoS
-
Encaminhamento de tráfego usando a especificação de fluxo BGP Ação DSCP
BGP multiprotocolo
Entender o BGP multiprotocolo
O Multiprotocol BGP (MP-BGP) é uma extensão do BGP que permite que o BGP carregue informações de roteamento para várias camadas de rede e famílias de endereços. O MP-BGP pode transportar as rotas unicast usadas para roteamento multicast separadamente das rotas usadas para encaminhamento de IP unicast.
Para habilitar o MP-BGP, você configura o BGP para transportar informações de alcance de camada de rede (NLRI) para famílias de endereços diferentes do IPv4 unicast, incluindo a family inet declaração:
family inet {
    (any | flow | labeled-unicast | multicast | unicast) {
        accepted-prefix-limit {
            maximum number;
            teardown <percentage> <idle-timeout (forever | minutes)>;
            drop-excess <percentage>;
            hide-excess <percentage>;}
}
        <loops number>;
        prefix-limit {
            maximum number;
            teardown <percentage> <idle-timeout (forever | minutes)>;
            drop-excess <percentage>;
            hide-excess <percentage>;}
 }
        rib-group group-name;
        topology name {
            community {
                target identifier;
            }
        }
    }
}
Para permitir que o MP-BGP carregue NLRI para a família de endereços IPv6, inclua a family inet6 declaração:
family inet6 {
    (any | labeled-unicast | multicast | unicast) {
        accepted-prefix-limit {
            maximum number;
            teardown <percentage> <idle-timeout (forever | minutes)>;
            drop-excess <percentage>;
            hide-excess <percentage>;}
}
        <loops number>;
        prefix-limit {
            maximum number;
            teardown <percentage> <idle-timeout (forever | minutes)>;
            drop-excess <percentage>;
            hide-excess <percentage>;}
 }
        rib-group group-name;
    }
}
Somente em roteadores, para permitir que o MP-BGP carregue NLRI de rede virtual privada (VPN) de Camada 3 para a família de endereços IPv4, inclua a family inet-vpn declaração:
family inet-vpn {
    (any | flow | multicast | unicast) {
        accepted-prefix-limit {
            maximum number;
            teardown <percentage> <idle-timeout (forever | minutes)>;
            drop-excess <percentage>;
            hide-excess <percentage>;}
}
        <loops number>;
        prefix-limit {
            maximum number;
            teardown <percentage> <idle-timeout (forever | minutes)>;
            drop-excess <percentage>;
            hide-excess <percentage>;}
}
        rib-group group-name;
    }
}
Somente em roteadores, para permitir que o MP-BGP carregue NLRI VPN de Camada 3 para a família de endereços IPv6, inclua a family inet6-vpn declaração:
family inet6-vpn {
    (any | multicast | unicast) {
        accepted-prefix-limit {
            maximum number;
            teardown <percentage> <idle-timeout (forever | minutes)>;
            drop-excess <percentage>;
            hide-excess <percentage>;}
}
        <loops number>;
        prefix-limit {
            maximum number;
            teardown <percentage> <idle-timeout (forever | minutes)>;
            drop-excess <percentage>;
            hide-excess <percentage>;}}
        rib-group group-name;
    }
}
Somente em roteadores, para permitir que o MP-BGP carregue NLRI VPN de multicast para a família de endereços IPv4 e para habilitar a sinalização VPN, inclua a family inet-mvpn declaração:
family inet-mvpn {
    signaling {
        accepted-prefix-limit {
            maximum number;
            teardown <percentage> <idle-timeout (forever | minutes)>;
            drop-excess <percentage>;
            hide-excess <percentage>;}}
        <loops number>;
        prefix-limit {
            maximum number;
            teardown <percentage> <idle-timeout (forever | minutes)>;
            drop-excess <percentage>;
            hide-excess <percentage>;}}
    }
}
Para permitir que o MP-BGP carregue NLRI VPN multicast para a família de endereços IPv6 e para habilitar a sinalização VPN, inclua a family inet6-mvpn declaração:
family inet6-mvpn {
    signaling {
        accepted-prefix-limit {
            maximum number;
            teardown <percentage> <idle-timeout (forever | minutes)>;
            drop-excess <percentage>;
            hide-excess <percentage>;}}
        <loops number>;
        prefix-limit {
            maximum number;
            teardown <percentage> <idle-timeout <forever | minutes>;
            drop-excess <percentage>;
            hide-excess <percentage>;}}
    }
}
Para obter mais informações sobre VPNs multicast baseadas em BGP multiprotocolo, consulte o Guia do usuário dos protocolos multicast do Junos OS.
Para obter uma lista de níveis de hierarquia nos quais você pode incluir essas instruções, consulte as seções de resumo da instrução para essas instruções.
Se você alterar a família de endereços especificada no [edit protocols bgp family] nível de hierarquia, todas as sessões BGP atuais no dispositivo de roteamento serão descartadas e restabelecidas.
No Junos OS versão 9.6 e posterior, você pode especificar um valor de loops para uma família de endereços BGP específica.
Por padrão, os peers BGP transportam apenas rotas unicast usadas para fins de encaminhamento unicast. Para configurar os peers BGP para transportar apenas rotas multicast, especifique a multicast opção. Para configurar os pares BGP para transportar rotas unicast e multicast, especifique a any opção.
Quando o MP-BGP é configurado, o BGP instala as rotas MP-BGP em diferentes tabelas de roteamento. Cada tabela de roteamento é identificada pela família de protocolos ou pelo indicador de família de endereços (AFI) e um identificador de família de endereços (SAFI) subsequente.
A lista a seguir mostra todas as combinações possíveis de AFI e SAFI:
-
AFI=1, SAFI=1, IPv4 unicast
-
AFI=1, SAFI=2, IPv4 multicast
-
AFI=1, SAFI=128, L3VPN, IPv4, unicast
-
AFI=1, SAFI=129, L3VPN IPv4 multicast
-
AFI=2, SAFI=1, IPv6 unicast
-
AFI=2, SAFI=2, IPv6 multicast
-
AFI=25, SAFI=65, BGP-VPLS/BGP-L2VPN
-
AFI=2, SAFI=128, L3VPN, IPv6, unicast
-
AFI=2, SAFI=129, L3VPN IPv6 multicast
-
AFI=1, SAFI=132, RT-Restrição
-
AFI=1, SAFI=133, especificação de fluxo
-
AFI=1, SAFI=134, especificação de fluxo
-
AFI=3, SAFI=128, CLNS VPN
-
AFI=1, SAFI=5, NG-MVPN IPv4
-
AFI=2, SAFI=5, NG-MVPN IPv6
-
AFI=1, SAFI=66, MDT-SAFI
-
AFI=1, SAFI=4, rotulado como IPv4
-
AFI=2, SAFI=4, rotulado como IPv6 (6PE)
As rotas instaladas na tabela de roteamento inet.2 só podem ser exportadas para peers MP-BGP porque eles usam o SAFI, identificando-os como rotas para fontes multicast. As rotas instaladas na tabela de roteamento inet.0 só podem ser exportadas para peers BGP padrão.
A tabela de roteamento inet.2 deve ser um subconjunto das rotas que você tem em inet.0, pois é improvável que você tenha uma rota para uma fonte multicast para a qual não possa enviar tráfego unicast. A tabela de roteamento inet.2 armazena as rotas unicast que são usadas para verificações de encaminhamento de caminho reverso multicast e as informações adicionais de acessibilidade aprendidas pelo MP-BGP a partir das atualizações de multicast NLRI. Uma tabela de roteamento inet.2 é criada automaticamente quando você configura o MP-BGP (definindo NLRI como any).
Ao habilitar o MP-BGP, você pode fazer o seguinte:
- Limitando o número de prefixos recebidos em uma sessão de peer BGP
- Limitando o número de prefixos aceitos em uma sessão de peer BGP
- Configuração de grupos de tabelas de roteamento BGP
- Resolvendo rotas para dispositivos de roteamento PE localizados em outros ASs
- Permissão de rotas rotuladas e não rotuladas
Limitando o número de prefixos recebidos em uma sessão de peer BGP
Você pode limitar o número de prefixos recebidos em uma sessão de peer BGP e registrar mensagens com taxa limitada quando o número de prefixos injetados exceder um limite definido. Você também pode derrubar o peering quando o número de prefixos exceder o limite.
Para configurar um limite para o número de prefixos que podem ser recebidos em uma sessão BGP, inclua a prefix-limit declaração:
prefix-limit {
    maximum number;
    teardown <percentage> <idle-timeout (forever | minutes)>;
    drop-excess <percentage>;
    hide-excess <percentage>;
}
Para obter uma lista de níveis de hierarquia nos quais você pode incluir essa instrução, consulte a seção de resumo da instrução para esta declaração.
Para maximum number, especifique um valor no intervalo de 1 a 4.294.967.295. Quando o número máximo especificado de prefixos é excedido, uma mensagem de log do sistema é enviada.
Se você incluir a teardown instrução, a sessão será interrompida quando o número máximo de prefixos for excedido. Se você especificar uma porcentagem, as mensagens serão registradas quando o número de prefixos exceder essa porcentagem do limite máximo especificado. Depois que a sessão é interrompida, ela é restabelecida em um curto espaço de tempo (a menos que você inclua a idle-timeout instrução). Se você incluir a idle-timeout instrução, a sessão poderá ser mantida inativa por um período de tempo especificado ou para sempre. Se você especificar forever, a sessão será restabelecida somente após você emitir um clear bgp neighbor comando. Se você incluir a drop-excess <percentage> opção, as rotas em excesso serão descartadas quando o número máximo de prefixos for atingido. Se você especificar uma porcentagem, as rotas serão registradas quando o número de prefixos exceder esse valor percentual do número máximo. Se você incluir a hide-excess <percentage> opção, as rotas em excesso serão ocultadas quando o número máximo de prefixos for atingido. Se você especificar uma porcentagem, as rotas serão registradas quando o número de prefixos exceder esse valor percentual do número máximo. Se a porcentagem for modificada, as rotas serão reavaliadas automaticamente. Se as rotas ativas caírem abaixo da porcentagem especificada, essas rotas serão mantidas como ocultas.
No Junos OS versão 9.2 e posterior, você pode, alternativamente, configurar um limite para o número de prefixos que podem ser aceitos em uma sessão de peer BGP. Para obter mais informações, consulte Limitando o número de prefixos aceitos em uma sessão de peer BGP.
Limitando o número de prefixos aceitos em uma sessão de peer BGP
No Junos OS versão 9.2 e posterior, você pode limitar o número de prefixos que podem ser aceitos em uma sessão de peer BGP. Quando esse limite especificado é excedido, uma mensagem de log do sistema é enviada. Você também pode especificar para redefinir a sessão BGP se o limite para o número de prefixos especificados for excedido.
Para configurar um limite para o número de prefixos que podem ser aceitos em uma sessão de peer BGP, inclua a accepted-prefix-limit declaração:
accepted-prefix-limit {
    maximum number;
    teardown <percentage> <idle-timeout (forever | minutes)>;
    drop <percentage>;
    hide <percentage>;
}
Para obter uma lista de níveis de hierarquia nos quais você pode incluir essa instrução, consulte a seção de resumo da instrução para esta declaração.
Para máximo number, especifique um valor no intervalo de 1 a 4.294.967.295.
Inclua a teardown instrução para redefinir a sessão de peer BGP quando o número de prefixos aceitos exceder o limite configurado. Você também pode incluir um valor percentual de 1 a 100 para que uma mensagem de log do sistema seja enviada quando o número de prefixos aceitos exceder essa porcentagem do limite máximo. Por padrão, uma sessão BGP que é redefinida é restabelecida em um curto espaço de tempo. Inclua a idle-timeout instrução para impedir que a sessão BGP seja restabelecida por um período de tempo especificado. Você pode configurar um valor de tempo limite de 1 a 2400 minutos. Inclua a opção forever para impedir que a sessão BGP seja restabelecida até que você emita o clear bgp neighbor comando. Se você incluir a drop-excess <percentage> instrução e especificar uma porcentagem, as rotas em excesso serão descartadas quando o número de prefixos exceder a porcentagem. Se você incluir a hide-excess <percentage> instrução e especificar uma porcentagem, as rotas em excesso ficarão ocultas quando o número de prefixos exceder a porcentagem. Se a porcentagem for modificada, as rotas serão reavaliadas automaticamente.
Quando o roteamento ativo sem interrupções (NSR) é habilitado e ocorre uma comutação para um Mecanismo de Roteamento de backup, os peers BGP que estão inativos são reiniciados automaticamente. Os pares são reiniciados mesmo que a idle-timeout forever instrução esteja configurada.
Como alternativa, você pode configurar um limite para o número de prefixos que podem ser recebidos (em vez de aceitos) em uma sessão de peer BGP. Para obter mais informações, consulte Limitando o número de prefixos recebidos em uma sessão de peer BGP.
Configuração de grupos de tabelas de roteamento BGP
Quando uma sessão BGP recebe um NLRI unicast ou multicast, ela instala a rota na tabela apropriada (inet.0 ou inet6.0 para unicast e inet.2 ou inet6.2 para multicast). Para adicionar prefixos unicast às tabelas unicast e multicast, você pode configurar grupos de tabela de roteamento BGP. Isso será útil se você não puder executar a negociação NLRI de multicast.
Para configurar grupos de tabela de roteamento BGP, inclua a rib-group declaração:
rib-group group-name;
Para obter uma lista de níveis de hierarquia nos quais você pode incluir essa instrução, consulte a seção de resumo da instrução para esta declaração.
Resolvendo rotas para dispositivos de roteamento PE localizados em outros ASs
Você pode permitir que rotas rotuladas sejam colocadas na tabela de roteamento inet.3 para resolução de rotas. Essas rotas são então resolvidas para conexões de dispositivo de roteamento de borda de provedor (PE) em que o PE remoto está localizado em outro sistema autônomo (AS). Para que um dispositivo de roteamento PE instale uma rota na instância de roteamento de roteamento de roteamento e encaminhamento de VPN (VRF), o próximo salto deve ser resolvido para uma rota armazenada na tabela inet.3 .
Para resolver rotas na tabela de roteamento inet.3 , inclua a resolve-vpn declaração:
resolve-vpn group-name;
Para obter uma lista de níveis de hierarquia nos quais você pode incluir essa instrução, consulte a seção de resumo da instrução para esta declaração.
Permissão de rotas rotuladas e não rotuladas
Você pode permitir que rotas rotuladas e não rotuladas sejam trocadas em uma única sessão. As rotas rotuladas são colocadas na tabela de roteamento inet.3 ou inet6.3, e as rotas unicast rotuladas e não rotuladas podem ser enviadas ou recebidas pelo dispositivo de roteamento.
Para permitir que rotas rotuladas e não rotuladas sejam trocadas, inclua a rib declaração:
rib (inet.3 | inet6.3);
Para obter uma lista de níveis de hierarquia nos quais você pode incluir essa instrução, consulte a seção de resumo da instrução para esta declaração.
Exemplo: configuração de rotas BGP IPv6 sobre transporte IPv4
Este exemplo demonstra como exportar prefixos IPv6 e IPv4 por uma conexão IPv4 em que ambos os lados são configurados com uma interface IPv4.
Requerimentos
Nenhuma configuração especial além da inicialização do dispositivo é necessária antes de configurar este exemplo.
Visão geral
Lembre-se do seguinte ao exportar prefixos BGP IPv6:
-
O BGP deriva prefixos de próximo salto usando o prefixo IPv6 mapeado em IPv4. Por exemplo, o prefixo
10.19.1.1IPv4 next-hop se traduz no prefixo IPv6 next-hop ::ffff:10.19.1.1.Observação:Deve haver uma rota ativa para o próximo salto IPv6 mapeado em IPv4 para exportar prefixos BGP IPv6.
-
Uma conexão IPv6 deve ser configurada no link. A conexão deve ser um túnel IPv6 ou uma configuração de pilha dupla. O empilhamento duplo é usado neste exemplo.
-
Ao configurar prefixos IPv6 mapeados para IPv4, use uma máscara com mais de 96 bits.
-
Configure uma rota estática se quiser usar prefixos IPv6 normais. Este exemplo usa rotas estáticas.
A Figura 1 mostra a topologia de exemplo.
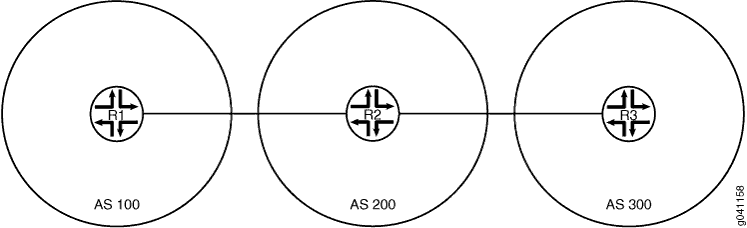 IPv4
Configuração
Configuração rápida da CLI
Para configurar rapidamente este exemplo, copie os comandos a seguir, cole-os em um arquivo de texto, remova quaisquer quebras de linha, altere todos os detalhes necessários para corresponder à sua configuração de rede e, em seguida, copie e cole os comandos na CLI no nível de [edit] hierarquia.
Dispositivo R1
set interfaces fe-1/2/0 unit 1 family inet address 192.168.10.1/24
set interfaces fe-1/2/0 unit 1 family inet6 address ::ffff:192.168.10.1/120
set interfaces lo0 unit 1 family inet address 10.10.10.1/32
set protocols bgp group ext type external
set protocols bgp group ext family inet unicast
set protocols bgp group ext family inet6 unicast
set protocols bgp group ext export send-direct
set protocols bgp group ext export send-static
set protocols bgp group ext peer-as 200
set protocols bgp group ext neighbor 192.168.10.10
set policy-options policy-statement send-direct term 1 from protocol direct
set policy-options policy-statement send-direct term 1 then accept
set policy-options policy-statement send-static term 1 from protocol static
set policy-options policy-statement send-static term 1 then accept
set routing-options rib inet6.0 static route ::ffff:192.168.20.0/120 next-hop ::ffff:192.168.10.10
set routing-options static route 192.168.20.0/24 next-hop 192.168.10.10
set routing-options autonomous-system 100
Dispositivo R2
set interfaces fe-1/2/0 unit 2 family inet address 192.168.10.10/24
set interfaces fe-1/2/0 unit 2 family inet6 address ::ffff:192.168.10.10/120
set interfaces fe-1/2/1 unit 3 family inet address 192.168.20.21/24
set interfaces fe-1/2/1 unit 3 family inet6 address ::ffff:192.168.20.21/120
set interfaces lo0 unit 2 family inet address 10.10.0.1/32
set protocols bgp group ext type external
set protocols bgp group ext family inet unicast
set protocols bgp group ext family inet6 unicast
set protocols bgp group ext export send-direct
set protocols bgp group ext export send-static
set protocols bgp group ext neighbor 192.168.10.1 peer-as 100
set protocols bgp group ext neighbor 192.168.20.1 peer-as 300
set policy-options policy-statement send-direct term 1 from protocol direct
set policy-options policy-statement send-direct term 1 then accept
set policy-options policy-statement send-static term 1 from protocol static
set policy-options policy-statement send-static term 1 then accept
set routing-options autonomous-system 200
Dispositivo R3
set interfaces fe-1/2/0 unit 4 family inet address 192.168.20.1/24
set interfaces fe-1/2/0 unit 4 family inet6 address ::ffff:192.168.20.1/120
set interfaces lo0 unit 3 family inet address 10.10.20.1/32
set protocols bgp group ext type external
set protocols bgp group ext family inet unicast
set protocols bgp group ext family inet6 unicast
set protocols bgp group ext export send-direct
set protocols bgp group ext export send-static
set protocols bgp group ext peer-as 200
set protocols bgp group ext neighbor 192.168.20.21
set policy-options policy-statement send-direct term 1 from protocol direct
set policy-options policy-statement send-direct term 1 then accept
set policy-options policy-statement send-static term 1 from protocol static
set policy-options policy-statement send-static term 1 then accept
set routing-options rib inet6.0 static route ::ffff:192.168.10.0/120 next-hop ::ffff:192.168.20.21
set routing-options static route 192.168.10.0/24 next-hop 192.168.20.21
set routing-options autonomous-system 300
Configurando o dispositivo R1
Procedimento passo a passo
O exemplo a seguir requer que você navegue por vários níveis na hierarquia de configuração. Para obter informações sobre como navegar na CLI, consulte Uso do Editor de CLI no Modo de Configuração no Guia do Usuário da CLI do Junos OS.
Para configurar o dispositivo R1:
-
Configure as interfaces, incluindo um endereço IPv4 e um endereço IPv6.
[edit interfaces]
user@R1# set fe-1/2/0 unit 1 family inet address 192.168.10.1/24
user@R1# set fe-1/2/0 unit 1 family inet6 address ::ffff:192.168.10.1/120
user@R1# set lo0 unit 1 family inet address 10.10.10.1/32
-
Configure EBGP.
[edit protocols bgp group ext]
user@R1# set type external
user@R1# set export send-direct
user@R1# set export send-static
user@R1# set peer-as 200
user@R1# set neighbor 192.168.10.10
-
Habilite o BGP para transportar rotas IPv4 unicast e IPv6 unicast.
[edit protocols bgp group ext]
user@R1# set family inet unicast
user@R1# set family inet6 unicast
As rotas unicast IPv4 são habilitadas por padrão. No entanto, quando você configura outras famílias de endereços NLRI, o IPv4 unicast deve ser configurado explicitamente.
-
Configure a política de roteamento.
[edit policy-options]
user@R1# set policy-statement send-direct term 1 from protocol direct
user@R1# set policy-statement send-direct term 1 then accept
user@R1# set policy-statement send-static term 1 from protocol static
user@R1# set policy-statement send-static term 1 then accept
-
Configure algumas rotas estáticas.
[edit routing-options]
user@R1# set rib inet6.0 static route ::ffff:192.168.20.0/120 next-hop ::ffff:192.168.10.10
user@R1# set static route 192.168.20.0/24 next-hop 192.168.10.10
-
Configure o número do sistema autônomo (AS).
[edit routing-options]
user@R1# set autonomous-system 100
Resultados
No modo de configuração, confirme sua configuração inserindo os show interfacescomandos , show policy-options, , show protocolse show routing-options . Se a saída não exibir a configuração pretendida, repita as instruções neste exemplo para corrigir a configuração.
user@R1# show interfaces
fe-1/2/0 {
    unit 1 {
        family inet {
            address 192.168.10.1/24;
        }
        family inet6 {
            address ::ffff:192.168.10.1/120;
        }
    }
}
lo0 {
    unit 1 {
        family inet {
            address 10.10.10.1/32;
        }
    }
}
user@R1# show policy-options
policy-statement send-direct {
    term 1 {
        from protocol direct;
        then accept;
    }
}
policy-statement send-static {
    term 1 {
        from protocol static;
        then accept;
    }
}
user@R1# show protocols
bgp {
    group ext {
        type external;
        family inet {
            unicast;
        }
        family inet6 {
            unicast;
        }
        export [ send-direct send-static ];
        peer-as 200;
        neighbor 192.168.10.10;
    }
}
user@R1# show routing-options
rib inet6.0 {
    static {
        route ::ffff:192.168.20.0/120 next-hop ::ffff:192.168.10.10;
    }
}
static {
    route 192.168.20.0/24 next-hop 192.168.10.10;
}
autonomous-system 100;
Se você terminar de configurar o dispositivo, entre no commit do modo de configuração. Repita a configuração no dispositivo R2 e no dispositivo R3, alterando os nomes da interface e os endereços IP, conforme necessário.
Verificação
Confirme se a configuração está funcionando corretamente.
Verificando o status do vizinho
Finalidade
Certifique-se de que o BGP esteja habilitado para transportar rotas unicast IPv6.
Ação
Do modo operacional, insira o show bgp neighbor comando.
user@R2> show bgp neighbor
Peer: 192.168.10.1+179 AS 100  Local: 192.168.10.10+54226 AS 200
  Type: External    State: Established    Flags: <Sync>
  Last State: OpenConfirm   Last Event: RecvKeepAlive
  Last Error: None
  Export: [ send-direct send-static ]
  Options: <Preference AddressFamily PeerAS Refresh>
  Address families configured: inet-unicast inet6-unicast
  Holdtime: 90 Preference: 170
  Number of flaps: 0
  Peer ID: 10.10.10.1      Local ID: 10.10.0.1         Active Holdtime: 90
  Keepalive Interval: 30         Peer index: 0
  BFD: disabled, down
  Local Interface: fe-1/2/0.2
  NLRI for restart configured on peer: inet-unicast inet6-unicast
  NLRI advertised by peer: inet-unicast inet6-unicast
  NLRI for this session: inet-unicast inet6-unicast
  Peer supports Refresh capability (2)
  Stale routes from peer are kept for: 300
  Peer does not support Restarter functionality
  NLRI that restart is negotiated for: inet-unicast inet6-unicast
  NLRI of received end-of-rib markers: inet-unicast inet6-unicast
  NLRI of all end-of-rib markers sent: inet-unicast inet6-unicast
  Peer supports 4 byte AS extension (peer-as 100)
  Peer does not support Addpath
  Table inet.0 Bit: 10000
    RIB State: BGP restart is complete
    Send state: in sync
    Active prefixes:              1
    Received prefixes:            3
    Accepted prefixes:            2
    Suppressed due to damping:    0
    Advertised prefixes:          4
  Table inet6.0 Bit: 20000
    RIB State: BGP restart is complete
    Send state: in sync
    Active prefixes:              0
    Received prefixes:            1
    Accepted prefixes:            1
    Suppressed due to damping:    0
    Advertised prefixes:          2
  Last traffic (seconds): Received 24   Sent 12   Checked 60
  Input messages:  Total 132    Updates 6       Refreshes 0     Octets 2700
  Output messages: Total 133    Updates 3       Refreshes 0     Octets 2772
  Output Queue[0]: 0
  Output Queue[1]: 0

Peer: 192.168.20.1+179 AS 300  Local: 192.168.20.21+54706 AS 200
  Type: External    State: Established    Flags: <Sync>
  Last State: OpenConfirm   Last Event: RecvKeepAlive
  Last Error: None
  Export: [ send-direct send-static ]
  Options: <Preference AddressFamily PeerAS Refresh>
  Address families configured: inet-unicast inet6-unicast
  Holdtime: 90 Preference: 170
  Number of flaps: 0
  Peer ID: 10.10.20.1      Local ID: 10.10.0.1         Active Holdtime: 90
  Keepalive Interval: 30         Peer index: 1
  BFD: disabled, down
  Local Interface: fe-1/2/1.3
  NLRI for restart configured on peer: inet-unicast inet6-unicast
  NLRI advertised by peer: inet-unicast inet6-unicast
  NLRI for this session: inet-unicast inet6-unicast
  Peer supports Refresh capability (2)
  Stale routes from peer are kept for: 300
  Peer does not support Restarter functionality
  NLRI that restart is negotiated for: inet-unicast inet6-unicast
  NLRI of received end-of-rib markers: inet-unicast inet6-unicast
  NLRI of all end-of-rib markers sent: inet-unicast inet6-unicast
  Peer supports 4 byte AS extension (peer-as 300)
  Peer does not support Addpath
  Table inet.0 Bit: 10000
    RIB State: BGP restart is complete
    Send state: in sync
    Active prefixes:              1
    Received prefixes:            3
    Accepted prefixes:            2
    Suppressed due to damping:    0
    Advertised prefixes:          4
  Table inet6.0 Bit: 20000
    RIB State: BGP restart is complete
    Send state: in sync
    Active prefixes:              0
    Received prefixes:            1
    Accepted prefixes:            1
    Suppressed due to damping:    0
    Advertised prefixes:          2
  Last traffic (seconds): Received 1    Sent 15   Checked 75
  Input messages:  Total 133    Updates 6       Refreshes 0     Octets 2719
  Output messages: Total 131    Updates 3       Refreshes 0     Octets 2734
  Output Queue[0]: 0
  Output Queue[1]: 0
Significado
As várias ocorrências de inet6-unicast na saída mostram que o BGP está habilitado para transportar rotas unicast IPv6.
Verificando a tabela de roteamento
Finalidade
Certifique-se de que o dispositivo R2 tenha rotas BGP em sua tabela de roteamento inet6.0.
Ação
Do modo operacional, insira o show route protocol bgp inet6.0 comando.
user@R2> show route protocol bgp table inet6.0
inet6.0: 7 destinations, 10 routes (7 active, 0 holddown, 0 hidden)
+ = Active Route, - = Last Active, * = Both

::ffff:192.168.10.0/120  [BGP/170] 01:03:49, localpref 100, from 192.168.20.1
                      AS path: 300 I
                    > to ::ffff:192.168.20.21 via fe-1/2/1.3
::ffff:192.168.20.0/120  [BGP/170] 01:03:53, localpref 100, from 192.168.10.1
                      AS path: 100 I
                    > to ::ffff:192.168.10.10 via fe-1/2/0.2
Anunciando rotas IPv4 sobre BGP Visão geral das sessões IPv6
Em uma rede IPv6, o BGP normalmente anuncia informações de alcance da camada de rede IPv6 em uma sessão IPv6 entre pares BGP. Em versões anteriores, o Junos OS suportava a troca de famílias de endereços inet6 unicast, inet6 multicast ou inet6 rotulados-unicast apenas. Esse recurso permite a troca de todas as famílias de endereços BGP. Em um ambiente de pilha dupla que tem IPv6 em seu núcleo. esse recurso permite que o BGP anuncie a acessibilidade unicast IPv4 com o próximo salto IPv4 em uma sessão BGP IPv6.
Esse recurso é apenas para sessões BGP IPv6, em que o IPv4 é configurado em ambos os endpoints. Pode local-ipv4-address ser um endereço de loopback ou qualquer endereço ipv4 para uma sessão de IBGP ou EBGP de vários saltos. Para alto-falantes BGP externos de salto único que não fazem parte de confederações BGP, se o endereço IPv4 local configurado não estiver conectado diretamente, a sessão BGP será fechada e permanecerá ociosa e um erro será gerado, que é exibido na saída do show bgp neighbor comando.
Para habilitar a publicidade de rota IPv4 na sessão IPv6, configure local-ipv4-address da seguinte maneira:
[edit protocols bgp family inet unicast]
local-ipv4-address local ipv4 address;
Você não pode configurar esse recurso para as famílias de endereços inet6 unicast, inet6 multicast ou inet6 labeled-unicast porque o BGP já tem a capacidade de anunciar essas famílias de endereços em uma sessão BGP IPv6.
O configurado local-ipv4-address é usado somente quando o BGP anuncia rotas com auto-próximo salto. Quando o IBGP anuncia rotas aprendidas com os pares EBGP ou o refletor de rota anuncia rotas BGP para seus clientes, o BGP não altera a rota no próximo salto, ignora o configurado e usa o próximo salto IPv4 local-ipv4-addressoriginal.
Veja também
Exemplo: Publicidade de rotas IPv4 em sessões BGP IPv6
Este exemplo mostra como anunciar rotas IPv4 por sessão BGP IPv6. Em um ambiente dual-stack que tem IPv6 em seu núcleo, há uma necessidade de alcançar hosts IPv4 remotos. Portanto, o BGP anuncia rotas IPv4 com próximos hops IPv4 para peers BGP em sessões BGP usando endereços de origem e destino IPv6. Esse recurso permite que o BGP anuncie a acessibilidade unicast IPv4 com o próximo salto IPv4 em sessões BGP IPv6.
Requerimentos
Este exemplo usa os seguintes componentes de hardware e software:
-
Três roteadores com capacidade de empilhamento duplo
-
Junos OS versão 16.1 ou posterior em execução em todos os dispositivos
Antes de habilitar anúncios IPv4 em sessões BGP IPv6, certifique-se de:
-
Configure as interfaces do dispositivo.
-
Configure o empilhamento duplo em todos os dispositivos.
Visão geral
A partir da versão 16.1, o Junos OS permite que o BGP anuncie a acessibilidade de unicast IPv4 com o próximo salto IPv4 em uma sessão BGP IPv6. Nas versões anteriores do Junos OS, o BGP podia anunciar apenas famílias de endereços unicast inet6, inet6 multicast e inet6 rotuladas como unicast em sessões BGP IPv6. Esse recurso permite que o BGP troque todas as famílias de endereços BGP em uma sessão IPv6. Você pode habilitar o BGP para anunciar rotas IPv4 com próximos hops IPv4 para peers BGP sobre sessão IPv6. O configurado local-ipv4-address é usado somente quando o BGP anuncia rotas com auto-próximo salto.
Você não pode configurar esse recurso para as famílias de endereços inet6 unicast, inet6 multicast ou inet6 labeled-unicast porque o BGP já tem a capacidade de anunciar essas famílias de endereços em uma sessão BGP IPv6.
Topologia
Na Figura 2, uma sessão de BGP externa IPv6 está sendo executada entre os roteadores R1 e R2. Uma sessão de IBGP IPv6 é estabelecida entre o Roteador R2 e o Roteador R3. As rotas estáticas IPv4 são redistribuídas para o BGP em R1. Para redistribuir as rotas IPv4 pela sessão BGP IPv6, o novo recurso deve ser habilitado em todos os roteadores no [edit protocols bgp address family] nível de hierarquia.
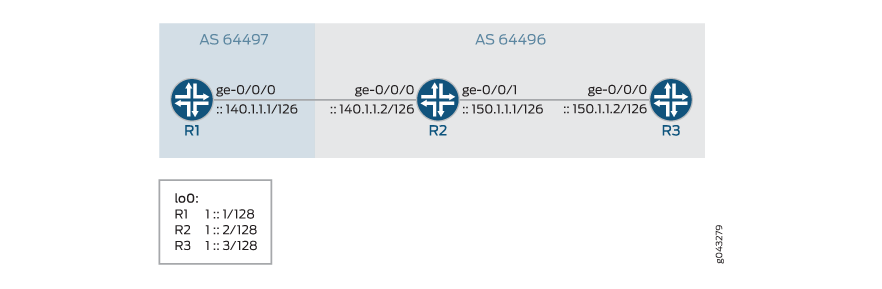 BGP IPv6
Configuração
Configuração rápida da CLI
Para configurar rapidamente este exemplo, copie os comandos a seguir, cole-os em um arquivo de texto, remova quaisquer quebras de linha, altere todos os detalhes necessários para corresponder à sua configuração de rede, copie e cole os comandos na CLI no nível de [edit] hierarquia e, em seguida, entre commit no modo de configuração.
Roteador R1
set interfaces ge-0/0/0 unit 0 description R1->R2
set interfaces ge-0/0/0 unit 0 family inet address 140.1.1.1/24
set interfaces ge-0/0/0 unit 0 family inet6 address ::140.1.1.1/126
set interfaces lo0 unit 0 family inet6 address 1::1/128
set routing-options static route 11.1.1.1/32 discard
set routing-options static route 11.1.1.2/32 discard
set routing-options autonomous-system 64497
set protocols bgp group ebgp-v6 type external
set protocols bgp group ebgp-v6 export p1
set protocols bgp group ebgp-v6 peer-as 64496
set protocols bgp group ebgp-v6 neighbor ::140.1.1.2 description R2
set protocols bgp group ebgp-v6 neighbor ::140.1.1.2 family inet unicast local-ipv4-address 140.1.1.1
set policy-options policy-statement p1 from protocol static
set policy-options policy-statement p1 then accept
Roteador R2
set interfaces ge-0/0/0 unit 0 description R2->R1
set interfaces ge-0/0/0 unit 0 family inet address 140.1.1.2/24
set interfaces ge-0/0/0 unit 0 family inet6 address ::140.1.1.2/126
set interfaces ge-0/0/1 unit 0 description R2->R3
set interfaces ge-0/0/1 unit 0 family inet address 150.1.1.1/24
set interfaces ge-0/0/1 unit 0 family inet6 address ::150.1.1.1/126
set interfaces lo0 unit 0 family inet6 address 1::2/128
set routing-options autonomous-system 64496
set protocols bgp group ibgp-v6 type internal
set protocols bgp group ibgp-v6 export change-nh
set protocols bgp group ibgp-v6 neighbor ::150.1.1.2 description R3
set protocols bgp group ibgp-v6 neighbor ::150.1.1.2 family inet unicast local-ipv4-address 150.1.1.1
set protocols bgp group ebgp-v6 type external
set protocols bgp group ebgp-v6 peer-as 64497
set protocols bgp group ebgp-v6 neighbor ::140.1.1.1 description R1
set protocols bgp group ebgp-v6 neighbor ::140.1.1.1 family inet unicast local-ipv4-address 140.1.1.2
set policy-options policy-statement change-nh from protocol bgp
set policy-options policy-statement change-nh then next-hop self
set policy-options policy-statement change-nh then accept
Roteador R3
set interfaces ge-0/0/0 unit 0 description R3->R2
set interfaces ge-0/0/0 unit 0 family inet address 150.1.1.2/24
set interfaces ge-0/0/0 unit 0 family inet6 address ::150.1.1.2/126
set interfaces lo0 unit 0 family inet6 address 1::3/128
set routing-options autonomous-system 64496
set protocols bgp group ibgp-v6 type internal
set protocols bgp group ibgp-v6 neighbor ::150.1.1.1 description R2
set protocols bgp group ibgp-v6 neighbor ::150.1.1.1 family inet unicast local-ipv4-address 150.1.1.2
Configuração do roteador R1
Procedimento passo a passo
O exemplo a seguir requer que você navegue por vários níveis na hierarquia de configuração. Para obter informações sobre como navegar na CLI, consulte Uso do Editor de CLI no Modo de Configuração no Guia do Usuário da CLI.
Para configurar o Roteador R1:
Repita este procedimento para outros roteadores depois de modificar os nomes de interface apropriados, endereços e outros parâmetros.
-
Configure as interfaces com endereços IPv4 e IPv6.
[edit interfaces]
user@R1# set ge-0/0/0 unit 0 description R1->R2
user@R1# set ge-0/0/0 unit 0 family inet address 140.1.1.1/24
user@R1# set ge-0/0/0 unit 0 family inet6 address ::140.1.1.1/126
-
Configure o endereço de loopback.
[edit interfaces]
user@R1# set lo0 unit 0 family inet6 address 1::1/128
-
Configure uma rota estática IPv4 que precisa ser anunciada.
[edit routing-options]
user@R1# set static route 11.1.1.1/32 discard
user@R1# set static route 11.1.1.2/32 discard
-
Configure o sistema autônomo para hosts BGP.
[edit routing-options]
user@R1# set autonomous-system 64497
-
Configure o EBGP nos roteadores de borda externos.
[edit protocols]
user@R1# set bgp group ebgp-v6 type external
user@R1# set bgp group ebgp-v6 peer-as 64496
user@R1# set bgp group ebgp-v6 neighbor ::140.1.1.2 description R2
-
Habilite o recurso para anunciar o endereço IPv4 140.1.1.1 em sessões BGP IPv6.
[edit protocols]
user@R1# set bgp group ebgp-v6 neighbor ::140.1.1.2 family inet unicast local-ipv4-address 140.1.1.1
-
Defina uma política p1 para aceitar todas as rotas estáticas.
[edit policy-options]
user@R1# set policy-statement p1 from protocol static
user@R1# set policy-statement p1 then accept
-
Aplique a política p1 no grupo EBGP ebgp-v6.
[edit protocols]
user@R1# set bgp group ebgp-v6 export p1
Resultados
No modo de configuração, confirme sua configuração inserindo os show interfacescomandos , show protocols, , show routing-optionse show policy-options . Se a saída não exibir a configuração pretendida, repita as instruções neste exemplo para corrigir a configuração.
[edit]
user@R1# show interfaces
ge-0/0/0 {
    unit 0 {
        description R1->R2;
        family inet {
            address 140.1.1.1/24;
        }
        family inet6 {
            address ::140.1.1.1/126;
        }
    }
    lo0 {
        unit 0 {
            family inet {
                address 1::1/128;
            }
        }
    }
}
[edit]
user@R1# show protocols
bgp {
    group ebgp-v6 {
        type external;
        export p1;
        peer-as 64496;
        neighbor ::140.1.1.2 {
            description R2;
            family inet {
                unicast {
                    local-ipv4-address 140.1.1.1;
                }
            }
        }
    }
}
[edit]
user@R1# show routing-options
static {
    route 11.1.1.1/32 discard;
    route 11.1.1.2/32 discard;
}
autonomous-system 64497;
[edit]
user@R1# show policy-options
policy-statement p1 {
    from {
        protocol static;
    }
    then accept;
}
Se você terminar de configurar o dispositivo, confirme a configuração.
user@R1# commit
Verificação
Confirme se a configuração está funcionando corretamente.
- Verificando se a sessão do BGP está ativa
- Verificando se o endereço IPv4 está sendo anunciado
- Verificando se o roteador vizinho BGP R2 recebe o endereço IPv4 anunciado
Verificando se a sessão do BGP está ativa
Finalidade
Verifique se o BGP está em execução nas interfaces configuradas e se a sessão do BGP está ativa para cada endereço vizinho.
Ação
Do modo operacional, execute o show bgp summary comando no Roteador R1.
user@R1> show bgp summary
Groups: 1 Peers: 1 Down peers: 0
Table          Tot Paths  Act Paths Suppressed    History Damp State    Pending
inet.0
                       0          0          0          0          0          0
Peer                     AS      InPkt     OutPkt    OutQ   Flaps Last Up/Dwn State|#Active/Received/Accepted/Damped...
::140.1.1.2             64496       4140       4158       0       0  1d 7:10:36 0/0/0/0              0/0/0/0
Significado
A sessão BGP está em execução e o peering BGP está estabelecido.
Verificando se o endereço IPv4 está sendo anunciado
Finalidade
Verifique se o endereço IPv4 configurado está sendo anunciado pelo Roteador R1 para os vizinhos BGP configurados.
Ação
Do modo operacional, execute o show route advertising-protocol bgp ::150.1.1.2 comando no Roteador R1.
user@R1> show route advertising-protocol bgp ::150.1.1.2
inet.0: 48 destinations, 48 routes (48 active, 0 holddown, 0 hidden)
  Prefix		  Nexthop	       MED     Lclpref    AS path
* 11.1.1.1/32       Self                         64497        64497 I
* 11.1.1.2/32       Self                         64497        64497 I
Significado
A rota estática IPv4 está sendo anunciada para o roteador vizinho BGP R2.
Verificando se o roteador vizinho BGP R2 recebe o endereço IPv4 anunciado
Finalidade
Verifique se o Roteador R2 recebe o endereço IPv4 que o Roteador R1 está anunciando para o vizinho BGP sobre IPv6.
Ação
user@R2> show route receive-protocol bgp ::140.1.1.1
inet.0: 48 destinations, 48 routes (48 active, 0 holddown, 0 hidden)
  Prefix		  Nexthop	       MED     Lclpref    AS path
* 11.1.1.1/32        140.1.1.1                               64497 I
* 11.1.1.2/32        140.1.1.1                               64497 I

iso.0: 1 destinations, 1 routes (1 active, 0 holddown, 0 hidden)

inet6.0: 9 destinations, 10 routes (9 active, 0 holddown, 0 hidden)
Significado
A presença da rota IPv4 estática na tabela de roteamento do Roteador R2 indica que ela está recebendo as rotas IPv4 anunciadas do Roteador R1.
Entender a redistribuição de rotas IPv4 com o próximo salto IPv6 no BGP
Em uma rede que transporta predominantemente tráfego IPv6, é necessário rotear rotas IPv4 quando necessário. Por exemplo, um Provedor de serviços de Internet que tem uma rede somente IPv6, mas tem clientes que ainda roteiam o tráfego IPv4. Nesse caso, é necessário atender a esses clientes e encaminhar o tráfego IPv4 por uma rede IPv6. Conforme descrito no RFC 5549, Anunciando informações de alcance da camada de rede IPv4 com um próximo salto IPv6 O tráfego IPv4 é tunelado de dispositivos CPE (equipamentos de instalações do cliente) para gateways IPv4 sobre IPv6. Esses gateways são anunciados aos dispositivos CPE por meio de endereços anycast. Os dispositivos de gateway criam túneis IPv4 sobre IPv6 dinâmicos para dispositivos CPE remotos e anunciam rotas agregadas IPv4 para direcionar o tráfego.
O recurso dinâmico de túnel IPv4 sobre IPv6 não oferece suporte a ISSU unificado no Junos OS Release 17.3R1.
Os refletores de rota (RRs) com uma interface programável são conectados através do IBGP aos roteadores de gateway e rotas de host com endereço IPv6 como o próximo salto. Esses RRs anunciam os endereços IPv4/32 para injetar as informações do túnel na rede. Os roteadores de gateway criam túneis IPv4 sobre IPv6 dinâmicos para a borda do provedor do cliente remoto. O roteador de gateway também anuncia as rotas agregadas IPv4 para direcionar o tráfego. Em seguida, o RR anuncia as rotas de origem do túnel para o ISP. Quando o RR remove a rota do túnel, o BGP também retira a rota, fazendo com que o túnel seja demolido e o CPE fique inacessível. O roteador de gateway também retira as rotas agregadas IPv4 e as rotas de origem do túnel IPv6 quando todas as rotas agregadas do colaborador são removidas. O roteador de gateway envia a rota de retirada quando a placa de linha do Mecanismo de Encaminhamento de Pacotes âncora fica inativa, de modo que ela redirecionará o tráfego para outros roteadores de gateway.
As seguintes extensões são introduzidas para dar suporte a rotas IPv4 com um próximo salto IPv6:
- Codificação do próximo salto BGP
- Localização de túneis
- Manuseio de túneis
- Balanceamento de carga de túnel e tratamento de falhas do Mecanismo de Encaminhamento de Pacotes de Pacotes âncora
- Estatísticas de fluxo de loopback de túnel
Codificação do próximo salto BGP
O BGP é estendido com capacidade de codificação de próximo salto que é usada para enviar rotas IPv4 com próximos saltos IPv6. Se esse recurso não estiver disponível no peer remoto, o BGP agrupará os peers com base nesse recurso de codificação e removerá a família BGP sem recurso de codificação da lista de informações de alcance de camada de rede (NLRI) negociada. O Junos OS permite apenas uma tabela de resolução, como inet.0. Para permitir rotas BGP IPv4 com próximo salto IPv6, o BGP cria uma nova árvore de resolução. Esse recurso permite que uma tabela de roteamento do Junos OS tenha várias árvores de resolução.
Além do RFC 5549, Anunciando Informações de Alcance da Camada de Rede IPv4 com um Próximo Salto IPv6 uma nova comunidade de encapsulamento especificada no RFC 5512, O Identificador de Família de Endereços Subsequentes (SAFI) do Encapsulamento BGP e o Atributo de Encapsulamento de Túnel BGP são introduzidos para determinar a família de endereços do endereço do próximo salto. A comunidade de encapsulamento indica o tipo de túneis que o nó de entrada precisa criar. Quando o BGP recebe rotas IPv4 com endereço de próximo salto IPv6 e a comunidade de encapsulamento V4oV6, o BGP cria túneis dinâmicos IPv4 sobre IPv6. Quando o BGP recebe rotas sem a comunidade de encapsulamento, as rotas BGP são resolvidas sem criar o túnel V4oV6.
Uma nova ação dynamic-tunnel-attributes dyan-attribute de política está disponível no nível da [edit policy-statement policy name term then] hierarquia para dar suporte ao novo encapsulamento estendido.
Localização de túneis
A infraestrutura dinâmica de túneis é aprimorada com a localização de túneis para suportar um número maior de túneis. Há uma necessidade de localização de túnel para fornecer resiliência para lidar com o tráfego quando a âncora falha. Um ou mais chassis fazem backup uns dos outros e permitem que o processo de protocolo de roteamento (rpd) direcione o tráfego para longe do ponto de falha para o chassi de backup. O chassi anuncia apenas esses prefixos agregados em vez dos endereços de loopback individuais na rede.
Manuseio de túneis
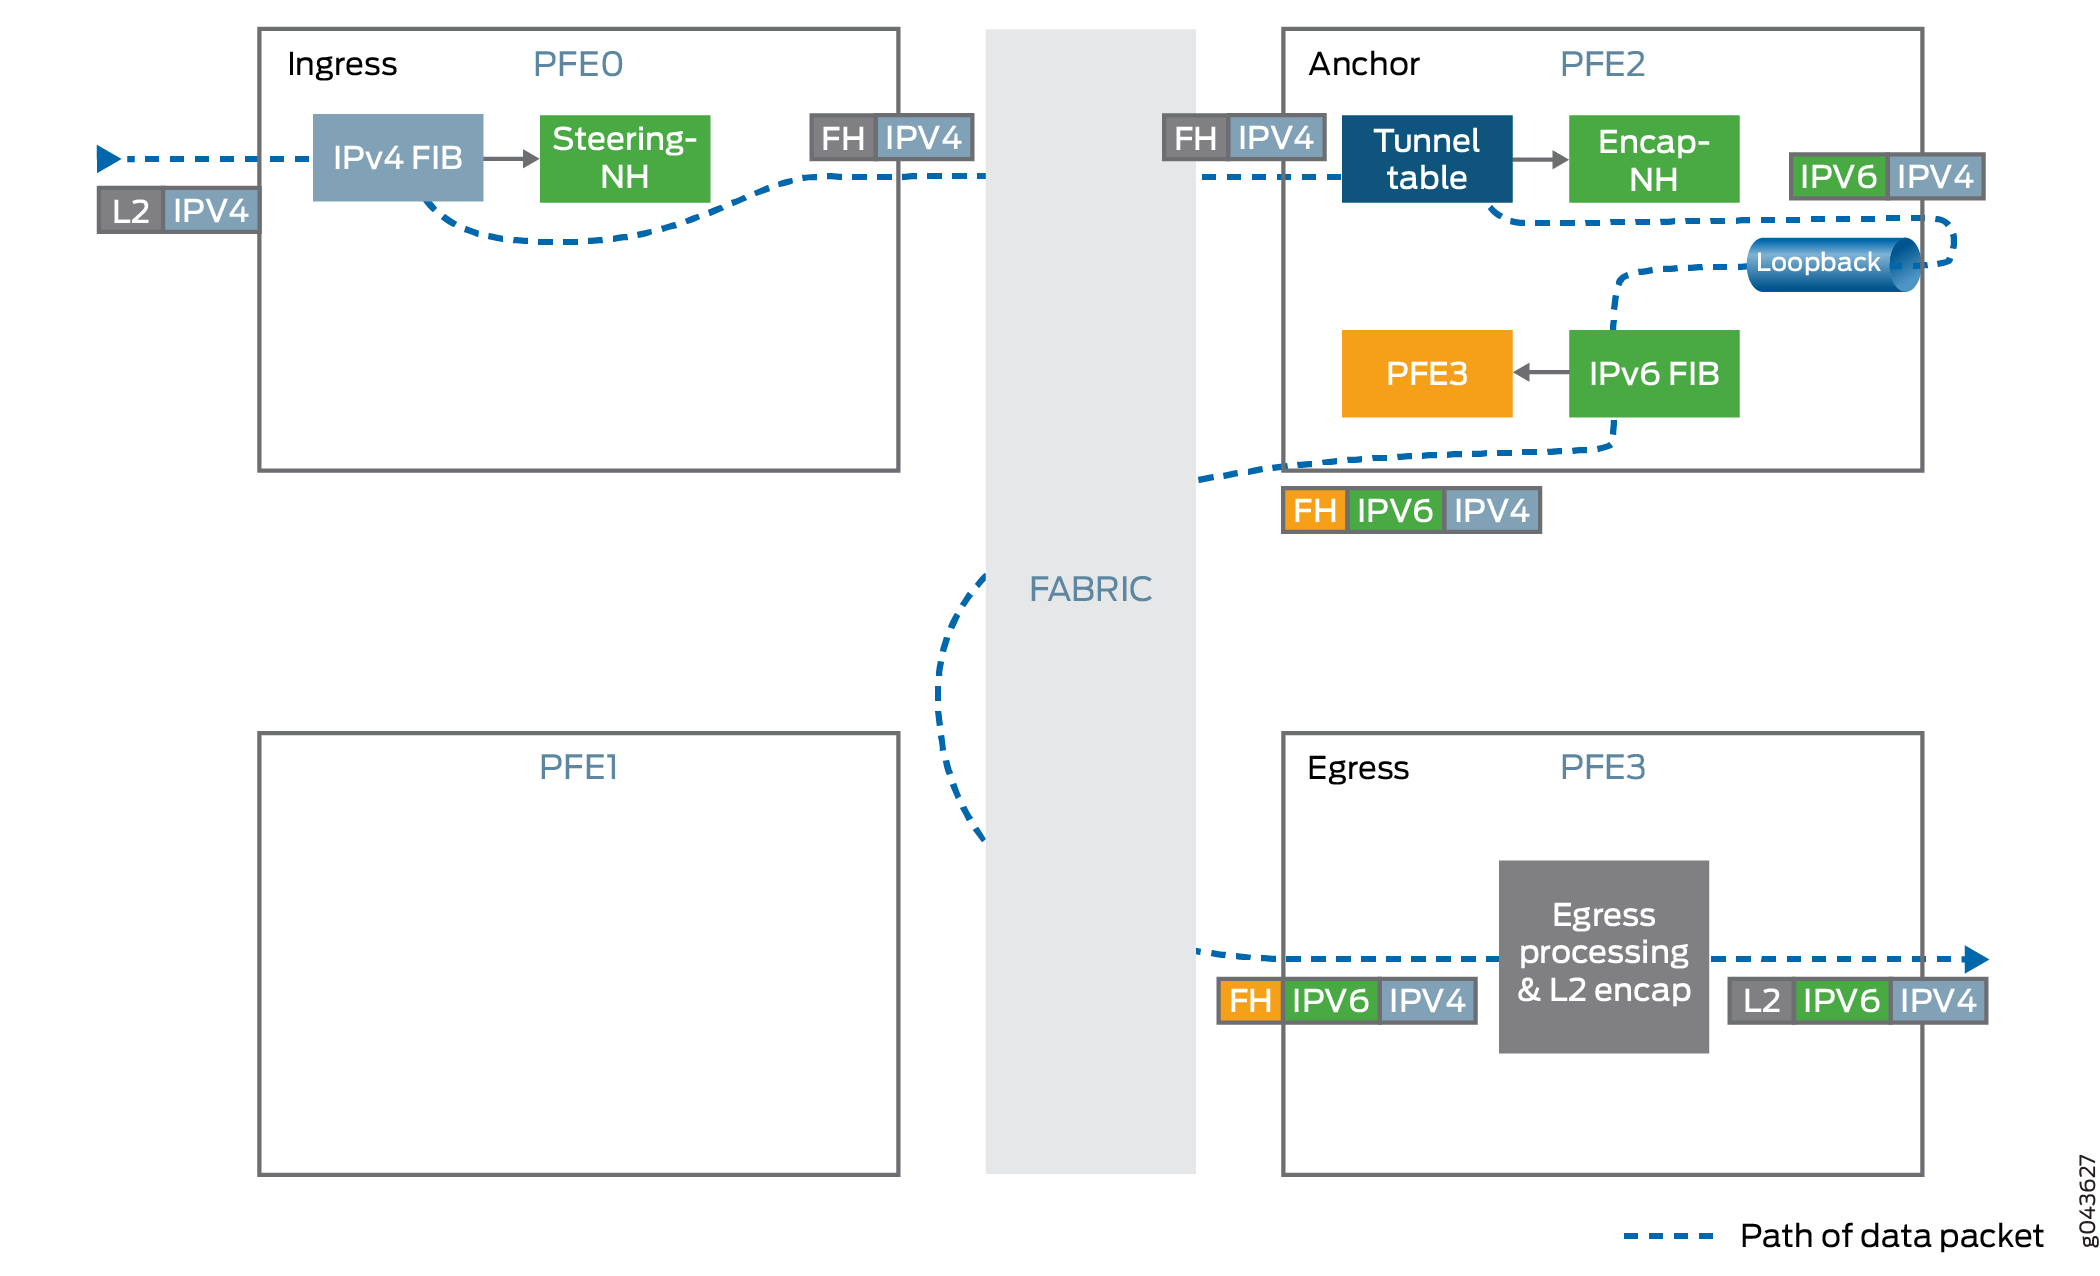
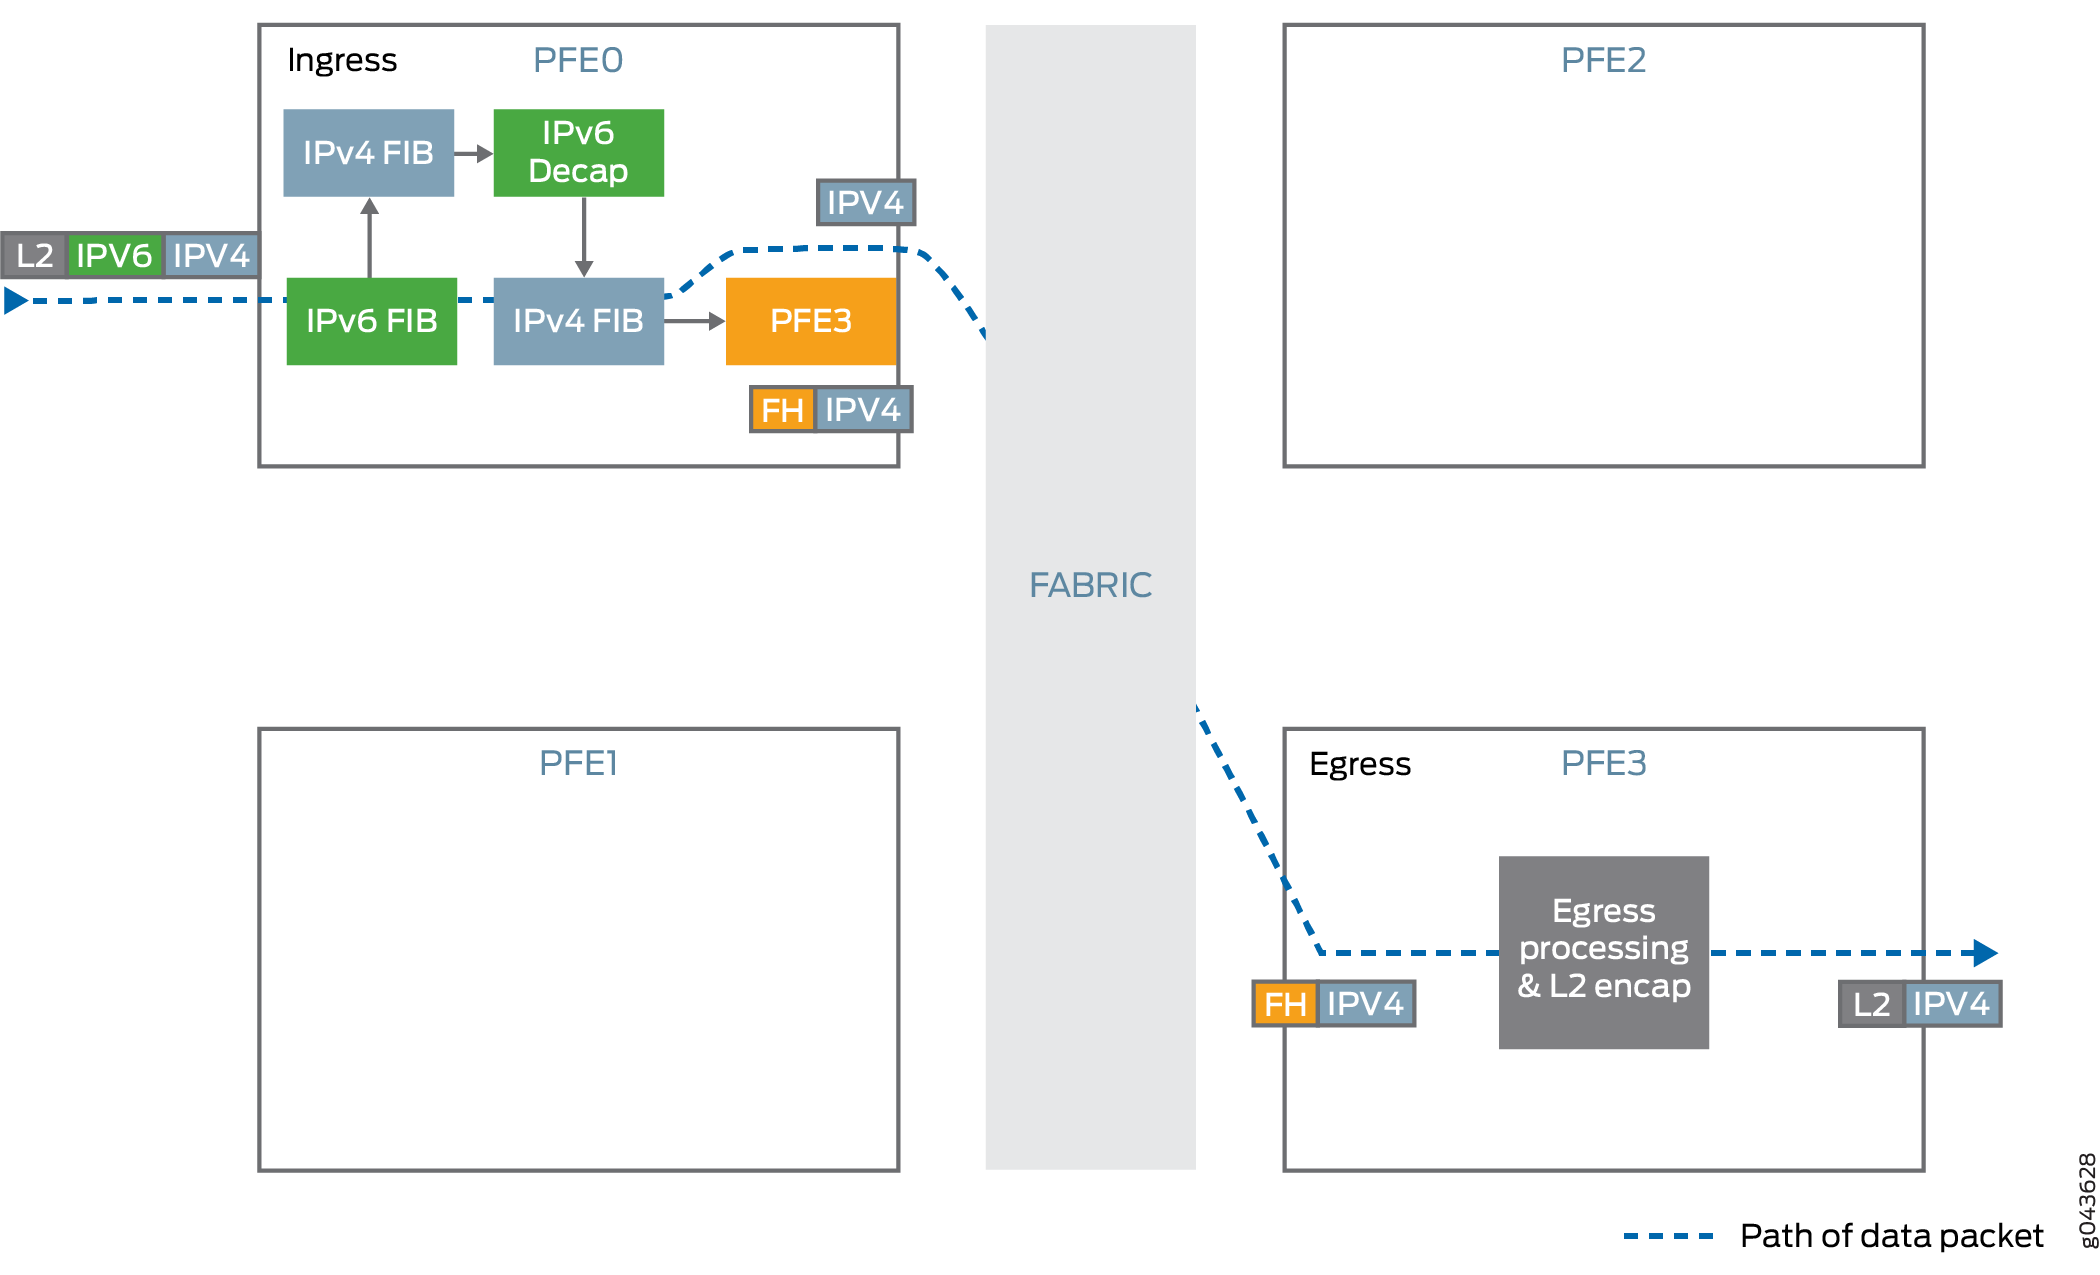
Os túneis IPv4 sobre IPv6 usam a infraestrutura dinâmica de túneis junto com a ancoragem de túneis para suportar a escala ampla de chassis necessária. O estado do túnel é localizado em um Mecanismo de Encaminhamento de Pacotes e os outros Mecanismos de Encaminhamento de Pacotes direcionam o tráfego para a âncora do túnel.
Entrada de túnel
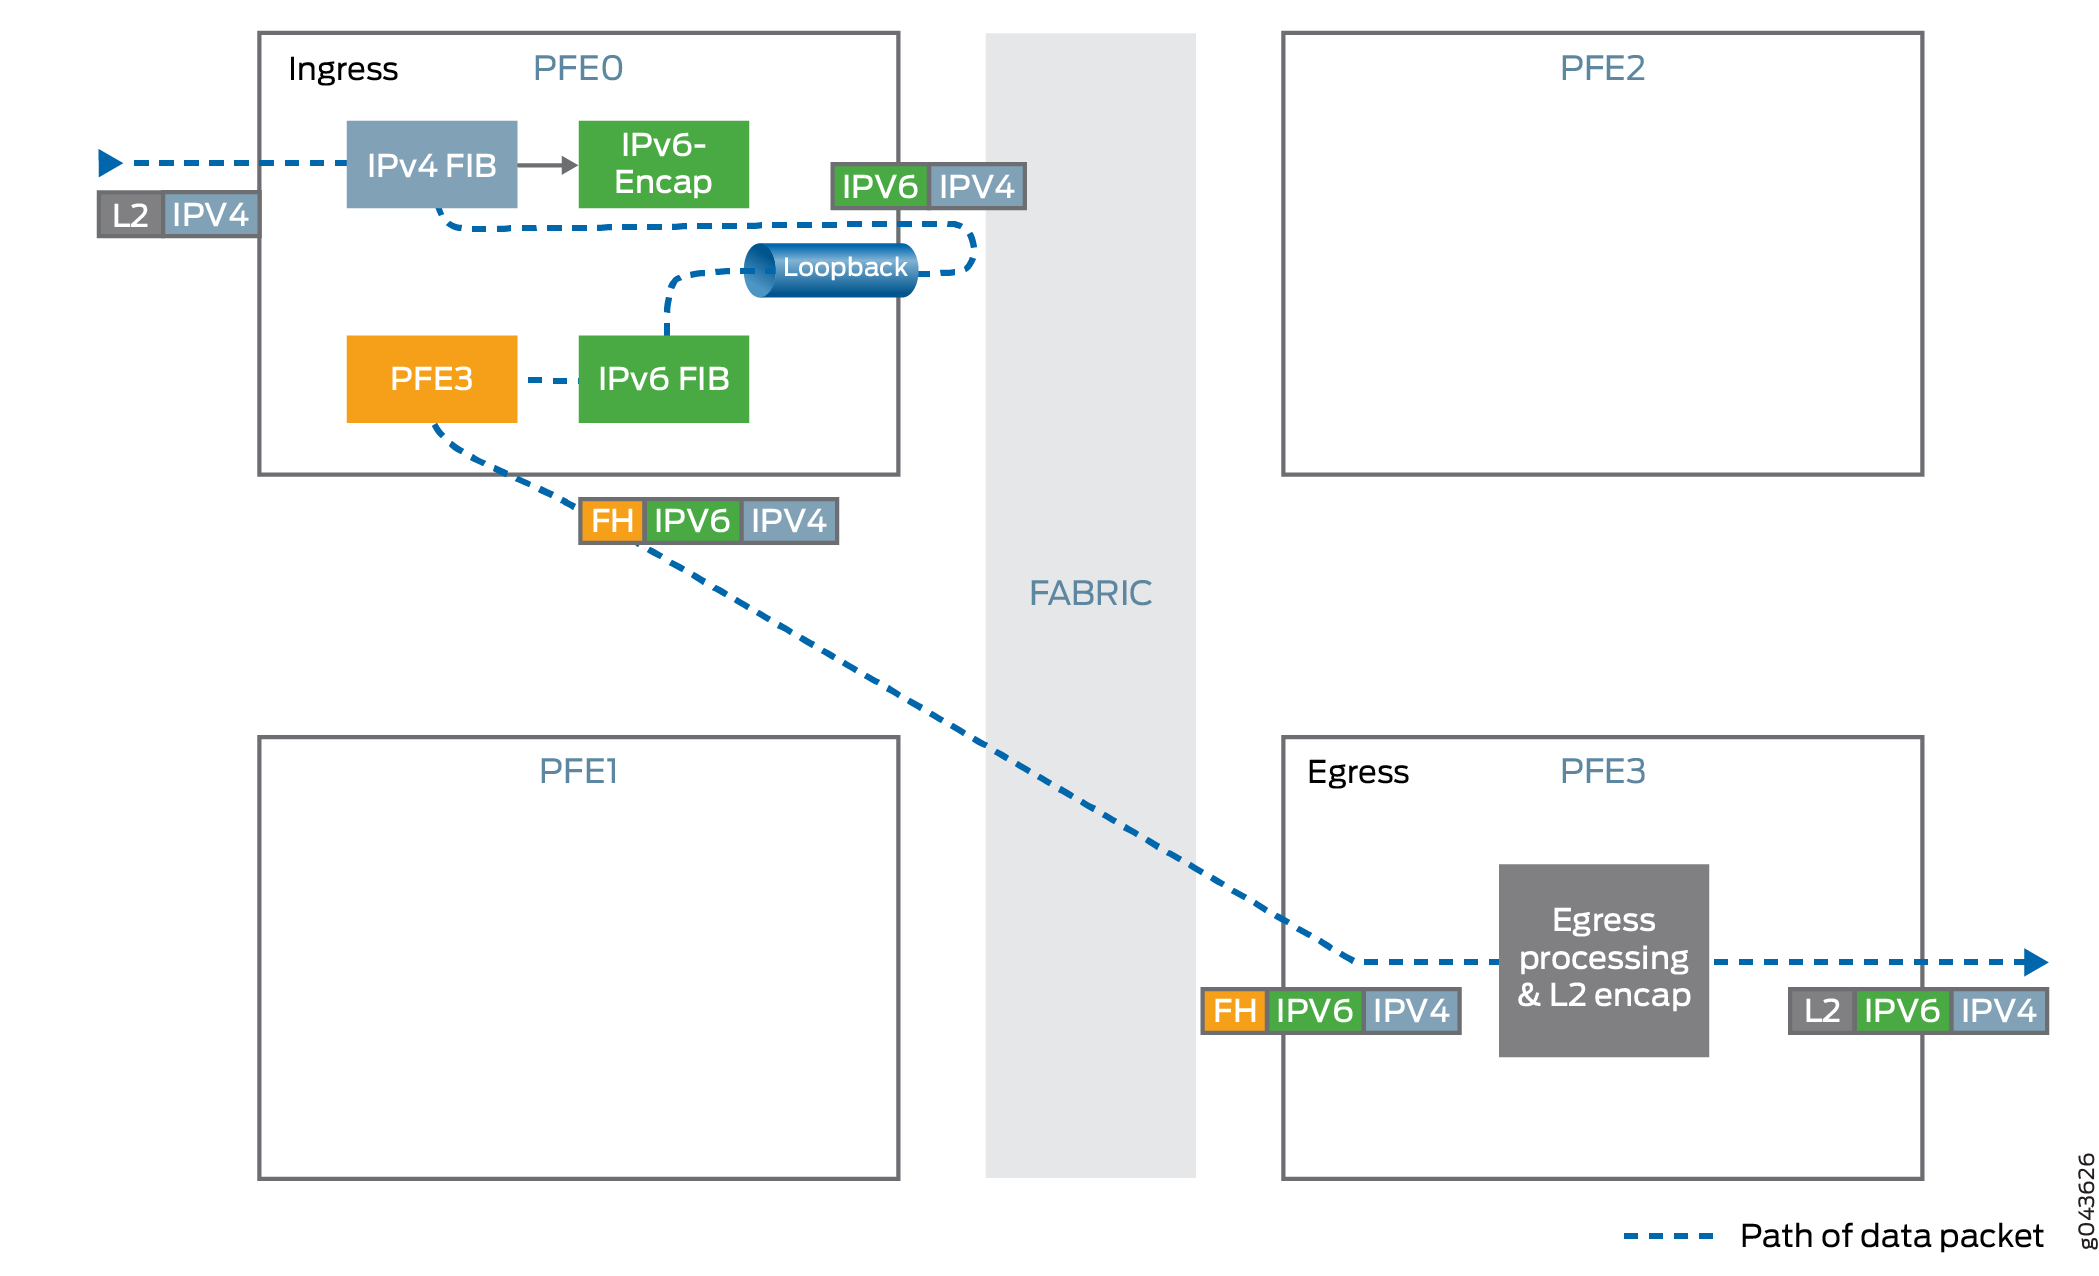
 diferente
-
Encapsula o tráfego IPv4 dentro do cabeçalho IPv6.
A imposição da unidade de transmissão máxima (MTU) é executada antes do encapsulamento. Se o tamanho do pacote encapsulado exceder a MTU do túnel e o pacote IPv4 não estiver definido,
DF-bito pacote será fragmentado e esses fragmentos serão encapsulados. -
Usa balanceamento de carga de tráfego baseado em hash em cabeçalhos de pacotes internos.
-
Encaminha o tráfego para o endereço IPv6 de destino. O endereço IPv6 é obtido do cabeçalho IPv6.
Saída de túnel
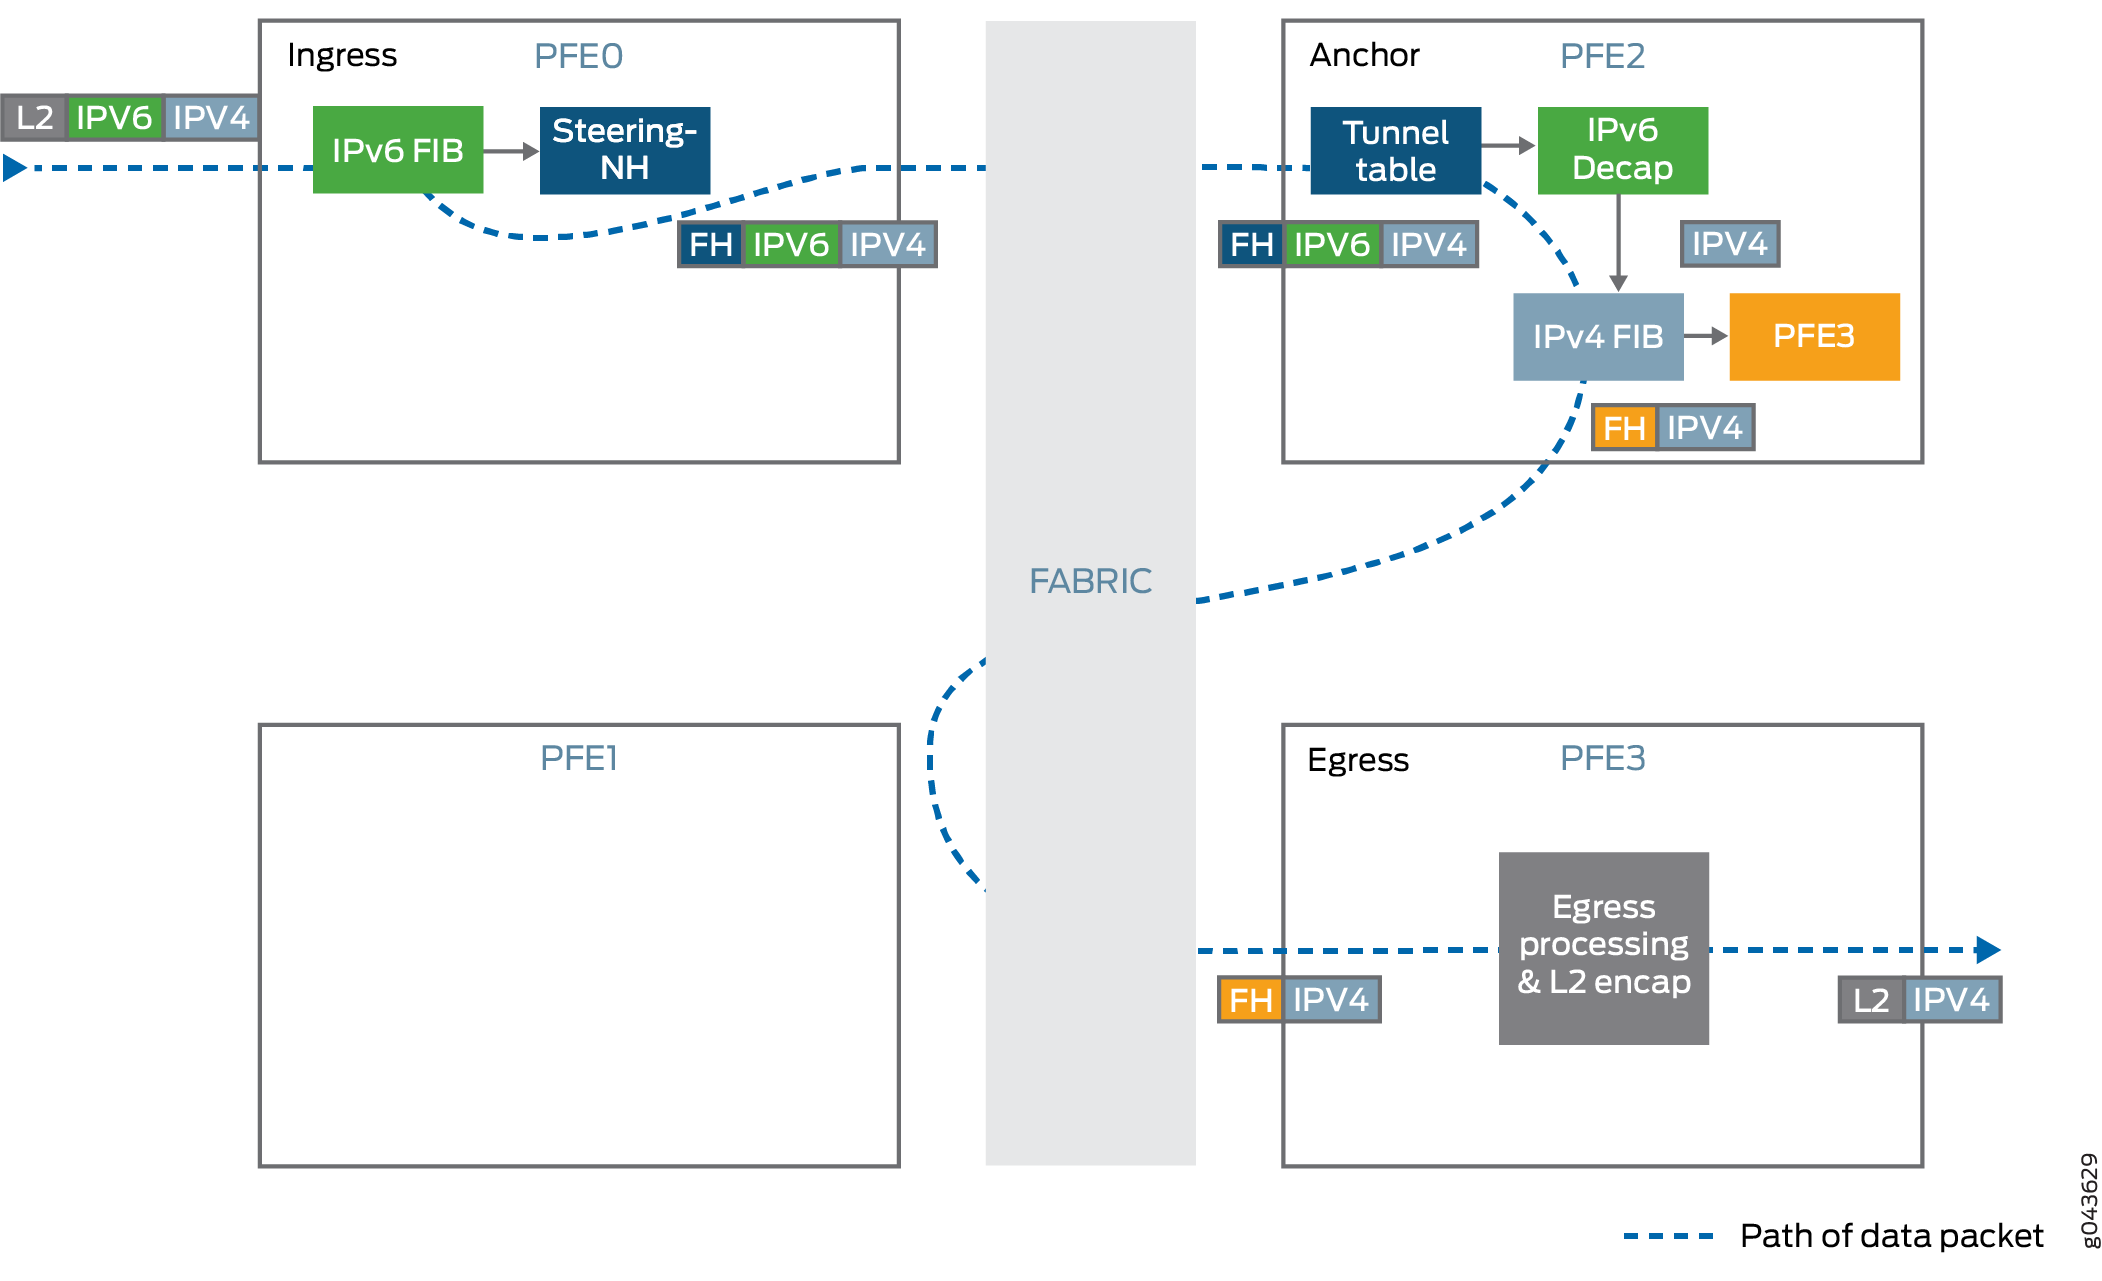 remoto
-
Desencapsula o pacote IPv4 presente dentro do pacote IPv6.
-
Executa a verificação anti-falsificação para garantir que o par IPv6 e IPv4 corresponda às informações que foram usadas para configurar o túnel.
-
Procura o endereço de destino IPv4 do cabeçalho IPv4 do pacote descapsulado e encaminha o pacote para o endereço IPv4 especificado.
Balanceamento de carga de túnel e tratamento de falhas do Mecanismo de Encaminhamento de Pacotes de Pacotes âncora
A falha do Mecanismo de Encaminhamento de Pacotes precisa ser tratada imediatamente para evitar a filtragem de rota nula do tráfego de túnel ancorado no Mecanismo de Encaminhamento de Pacotes. A localização de túneis envolve o uso de anúncios BGP para reparar a falha globalmente. O tráfego do túnel é desviado do ponto de falha para outro chassi de backup que contém o estado de túnel idêntico. Para o balanceamento de carga de tráfego, o chassi é configurado para anunciar diferentes valores de discriminador de saída múltipla (MED) para cada um dos conjuntos de prefixos, de modo que apenas o tráfego de um quarto dos túneis passe por cada chassi. O tráfego CPE também é tratado de maneira semelhante, configurando o mesmo conjunto de endereços anycast em cada chassi e direcionando apenas um quarto do tráfego para cada chassi.
O Mecanismo de Encaminhamento de Pacotes Âncora é a única entidade que faz todo o processamento de um túnel. A seleção do Mecanismo de Encaminhamento de Pacotes âncora é feita por meio de provisionamento estático e vinculada às interfaces físicas do Mecanismo de Encaminhamento de Pacotes. Quando um dos mecanismos de encaminhamento de pacotes fica inativo, o daemon marca todos os mecanismos de encaminhamento de pacotes na placa de linha e comunica essas informações ao processo de protocolo de roteamento, processo de protocolo de roteamento e outros daemons. O processo de protocolo de roteamento envia retiradas BGP para os prefixos que estão ancorados no Mecanismo de Encaminhamento de Pacotes com falha e os endereços IPv6 atribuídos ao Mecanismo de Encaminhamento de Pacotes que está inativo. Esses anúncios redirecionam o tráfego para outro chassi de backup. Quando o Mecanismo de Encaminhamento de Pacotes com falha está ativo novamente, o chassi marca o Mecanismo de Encaminhamento de Pacotes como up e atualiza o processo de protocolo de roteamento. O processo do protocolo de roteamento aciona atualizações de BGP para seus pares de que os túneis ancorados no Mecanismo de Encaminhamento de Pacotes específico agora estão disponíveis para o tráfego de roteamento. Esse processo pode levar minutos para a configuração de túneis em grande escala. Portanto, o Ack mecanismo é integrado ao sistema para garantir uma perda mínima de tráfego ao alternar o tráfego de volta para o chassi original.
Estatísticas de fluxo de loopback de túnel
A infraestrutura de túnel dinâmico usa fluxos de loopback no Mecanismo de Encaminhamento de Pacotes para fazer loop do pacote após o encapsulamento. Como a largura de banda desse fluxo de loopback é limitada, é necessário monitorar o desempenho dos fluxos de loopback de túnel.
Para monitorar as estatísticas do fluxo de loopback, use o comando show pfe statistics traffic detail operacional que exibe as estatísticas agregadas do fluxo de loopback, incluindo taxa de encaminhamento, taxa de pacotes de descarte e taxa de bytes.
Veja também
Configuração do BGP para redistribuir rotas IPv4 com endereços IPv6 next-hop
A partir da versão 17.3R1, os dispositivos Junos OS podem encaminhar tráfego IPv4 por uma rede somente IPv6, que geralmente não pode encaminhar tráfego IPv4. Conforme descrito no RFC 5549, o tráfego IPv4 é encapsulado de dispositivos CPE para gateways IPv4 sobre IPv6. Esses gateways são anunciados aos dispositivos CPE por meio de endereços anycast. Os dispositivos de gateway criam túneis IPv4 sobre IPv6 dinâmicos para equipamentos remotos nas instalações do cliente e anunciam rotas agregadas IPv4 para direcionar o tráfego. Refletores de rota com interfaces programáveis injetam as informações do túnel na rede. Os refletores de rota são conectados através do IBGP aos roteadores de gateway, que anunciam os endereços IPv4 de rotas de host com endereços IPv6 como o próximo salto.
O recurso dinâmico de túnel IPv4 sobre IPv6 não oferece suporte a ISSU unificado no Junos OS Release 17.3R1.
Antes de começar a configurar o BGP para distribuir rotas IPv4 com endereços IPv6 next-hop, faça o seguinte:
-
Configure as interfaces do dispositivo.
-
Configurar o OSPF ou qualquer outro protocolo IGP.
-
Configurar MPLS e LDP.
-
Configure BGP.
Para configurar o BGP para distribuir rotas IPv4 com endereços IPv6 next-hop:
Veja também
Habilitação da sinalização VPN e VPLS de Camada 2
Você pode habilitar o BGP para transportar mensagens VPN de Camada 2 e VPLS NLRI.
Para habilitar a sinalização VPN e VPLS, inclua a family declaração:
family {
    l2vpn {
        signaling {
            prefix-limit {
                maximum number;
                teardown <percentage> <idle-timeout (forever | minutes)>;
                drop-excess <percentage>;
                hide-excess <percentage>;            }
        }
    }
}
Para obter uma lista de níveis de hierarquia nos quais você pode incluir essa instrução, consulte a seção de resumo da instrução para esta declaração.
Para configurar um número máximo de prefixos, inclua a prefix-limit declaração:
prefix-limit {
    maximum number;
    teardown <percentage> <idle-timeout (forever | minutes)>;
    drop-excess <percentage>;
    hide-excess <percentage>;}
Para obter uma lista de níveis de hierarquia nos quais você pode incluir essa instrução, consulte a seção de resumo da instrução para esta declaração.
Quando você define o número máximo de prefixos, uma mensagem é registrada quando esse número é atingido. Se você incluir a teardown instrução, a sessão será interrompida quando o número máximo de prefixos for atingido. Se você especificar uma porcentagem, as mensagens serão registradas quando o número de prefixos atingir essa porcentagem. Uma vez que a sessão é interrompida, ela é restabelecida em pouco tempo. Inclua a idle-timeout instrução para manter a sessão inativa por um período de tempo especificado ou para sempre. Se você especificar forever, a sessão será restabelecida somente depois que você usar o clear bgp neighbor comando. Se você incluir a drop-excess <percentage> instrução e especificar uma porcentagem, as rotas em excesso serão descartadas quando o número de prefixos exceder a porcentagem. Se você incluir a hide-excess <percentage> instrução e especificar uma porcentagem, as rotas em excesso ficarão ocultas quando o número de prefixos exceder a porcentagem. Se a porcentagem for modificada, as rotas serão reavaliadas automaticamente.
Veja também
Entender as rotas de fluxo BGP para filtragem de tráfego
Uma rota de fluxo é uma agregação de condições de correspondência para pacotes IP. As rotas de fluxo são instaladas como filtros de tabela de encaminhamento de entrada (implícitos) e são propagadas pela rede usando mensagens de informações de alcance de camada de rede (NLRI) de especificação de fluxo e instaladas na tabela de roteamento de instance-name.inetflow.0fluxo. Os pacotes podem viajar por rotas de fluxo somente se condições específicas de correspondência forem atendidas.
As rotas de fluxo e os filtros de firewall são semelhantes, pois filtram pacotes com base em seus componentes e executam uma ação nos pacotes correspondentes. As rotas de fluxo fornecem filtragem de tráfego e recursos de limitação de taxa, assim como os filtros de firewall. Além disso, você pode propagar rotas de fluxo em diferentes sistemas autônomos.
As rotas de fluxo são propagadas pelo BGP por meio de mensagens NLRI de especificação de fluxo. Você deve habilitar o BGP para propagar esses NLRIs.
A partir do Junos OS Release 15.1, as mudanças são implementadas para estender o suporte ao roteamento ativo sem interrupções (NSR) para as famílias inet-flow e inetvpn-flow existentes e estender a validação de rota para BGP flowspec por draft-ietf-idr-bgp-flowspec-oid-01. Duas novas declarações são introduzidas como parte desse aprimoramento. Consulte enforce-first-as e no-install.
A partir do Junos OS Release 16.1, o suporte ao IPv6 é estendido para a especificação de fluxo BGP, que permite a propagação de regras de especificação de fluxo de tráfego para pacotes IPv6 e VPN-IPv6. A especificação de fluxo BGP automatiza a coordenação das regras de filtragem de tráfego para mitigar o ataque distribuído de negação de serviço durante o roteamento ativo sem interrupções (NSR).
A partir do Junos OS Release 16.1R1, a especificação de fluxo BGP oferece suporte à ação de filtragem de marcação extended-community de tráfego. Para o tráfego IPv4, o Junos OS modifica os bits do ponto de código DiffServ (DSCP) de um pacote IPv4 em trânsito para o valor correspondente da comunidade estendida. Para pacotes IPv6, o Junos OS modifica os traffic class primeiros seis bits do campo do pacote IPv6 transmissor para o valor correspondente da comunidade estendida.
A partir do Junos OS Release 17.1R1, o BGP pode transportar mensagens de informações de alcance de camada de rede (NLRI) com especificação de fluxo em roteadores da Série PTX que tenham FPCs de terceira geração (FPC3-PTX-U2 e FPC3-PTX-U3 no PTX5000 e FPC3-SFF-PTX-U0 e FPC3-SFF-PTX-U1 no PTX3000) instalados. A propagação de informações de filtro de firewall como parte do BGP permite que você propague filtros de firewall contra ataques de negação de serviço (DOS) dinamicamente em sistemas autônomos.
A partir do Junos OS Release 17.2R1, o BGP pode transportar mensagens de informações de alcance de camada de rede (NLRI) com especificação de fluxo em roteadores PTX1000 que tenham FPCs de terceira geração instalados. A propagação de informações de filtro de firewall como parte do BGP permite que você propague filtros de firewall contra ataques de negação de serviço (DOS) dinamicamente em sistemas autônomos.
A partir do cRPD Release 20.3R1, as rotas de fluxo e as regras de vigilância propagadas por meio da especificação de fluxo BGP NLRI são baixadas para o kernel Linux por meio da estrutura Linux Netfilter em ambientes cRPD.
- Condições de correspondência para rotas de fluxo
- Ações para rotas de fluxo
- Validando rotas de fluxo
- Suporte para o algoritmo de especificação de fluxo BGP versão 7 e posterior
Condições de correspondência para rotas de fluxo
Você especifica as condições que o pacote deve corresponder antes que a ação na declaração seja executada then para uma rota de fluxo. Todas as condições na instrução devem corresponder para from que a ação seja tomada. A ordem na qual você especifica as condições de correspondência não é importante, porque um pacote deve corresponder a todas as condições em um termo para que uma correspondência ocorra.
Para configurar uma condição de correspondência, inclua a match declaração no nível da [edit routing-options flow] hierarquia.
A Tabela 1 descreve as condições de correspondência da rota de fluxo.
|
Condição de correspondência |
Descrição |
|---|---|
|
|
Campo de endereço IP de destino. Você pode usar o |
|
|
Campo de porta de destino TCP ou Protocolo de datagrama de usuário (UDP). Não é possível especificar as condições de correspondência e No lugar do valor numérico, você pode especificar um dos seguintes sinônimos de texto (os números de porta também estão listados): |
|
|
Ponto de código de serviços diferenciados (DSCP). O protocolo DiffServ usa o byte de tipo de serviço (ToS) no cabeçalho IP. Os seis bits mais significativos desse byte formam o DSCP. Você pode especificar o DSCP no formato hexadecimal ou decimal. |
|
|
Combine o valor do rótulo de fluxo. O valor desse campo varia de 0 a 1048575. Essa condição de correspondência é suportada apenas em dispositivos Junos com MPCs aprimorados configurados para o |
|
|
Campo Tipo de fragmento. As palavras-chave são agrupadas pelo tipo de fragmento ao qual estão associadas:
Essa condição de correspondência é suportada apenas em dispositivos Junos OS com MPCs aprimorados configurados para |
|
|
Campo de código ICMP. Esse valor ou palavra-chave fornece informações mais específicas do que No lugar do valor numérico, você pode especificar um dos seguintes sinônimos de texto (os valores de campo também são listados). As palavras-chave são agrupadas pelo tipo de ICMP ao qual estão associadas:
|
|
|
Campo de tipo de pacote ICMP. Normalmente, você especifica essa correspondência em conjunto com a No lugar do valor numérico, você pode especificar um dos seguintes sinônimos de texto (os valores de campo também estão listados): |
|
|
Comprimento total do pacote IP. |
|
|
Campo de porta de origem ou destino TCP ou UDP. Você não pode especificar a No lugar do valor numérico, você pode especificar um dos sinônimos de texto listados em |
|
|
Campo de protocolo IP. No lugar do valor numérico, você pode especificar um dos seguintes sinônimos de texto (os valores de campo também estão listados): Essa condição de correspondência é suportada para IPv6 apenas em dispositivos Junos com MPCs aprimorados configurados para |
|
|
Campo de endereço de origem IP. Você pode usar o |
|
|
Campo de porta de origem TCP ou UDP. Não é possível especificar as condições e No lugar do campo numérico, você pode especificar um dos sinônimos de texto listados em |
|
|
Formato de cabeçalho TCP. |
Ações para rotas de fluxo
Você pode especificar a ação a ser executada se o pacote corresponder às condições que você configurou na rota de fluxo. Para configurar uma ação, inclua a then declaração no nível da [edit routing-options flow] hierarquia.
A Tabela 2 descreve as ações da rota de fluxo.
|
Ação ou modificador de ação |
Descrição |
|---|---|
| Opções | |
|
|
Aceite um pacote. Esse é o padrão. |
|
|
Descarte um pacote silenciosamente, sem enviar uma mensagem ICMP (Internet Control Message Protocol). |
|
|
Substitua todas as comunidades na rota pelas comunidades especificadas. |
|
Marca value |
Defina um valor de DSCP para o tráfego que corresponda a esse fluxo. Especifique um valor de 0 a 63. Essa ação é suportada apenas em dispositivos Junos com MPCs aprimorados configurados para o |
|
|
Continue para a próxima condição de correspondência para avaliação. |
|
|
Especifique uma instância de roteamento para a qual os pacotes são encaminhados. |
|
|
Limite a largura de banda na rota de fluxo. Expresse o limite em bits por segundo (bps). A partir do Junos OS Release 16.1R4, o intervalo de limite de taxa é de [0 a 10000000000000]. |
|
|
Faça uma amostra do tráfego na rota de fluxo. |
Validando rotas de fluxo
O Junos OS instala rotas de fluxo na tabela de roteamento de fluxo somente se elas tiverem sido validadas usando o procedimento de validação. O Mecanismo de Roteamento faz a validação antes da instalação de rotas na tabela de roteamento de fluxo.
As rotas de fluxo recebidas usando as mensagens de informações de alcance de camada de rede (NLRI) BGP são validadas antes de serem instaladas na tabela de roteamento instance.inetflow.0da instância primária do fluxo. O procedimento de validação é descrito no draft-ietf-idr-flow-spec-09.txt, Disseminação de Regras de Especificação de Fluxo. Você pode ignorar o processo de validação para rotas de fluxo usando mensagens BGP NLRI e usar sua própria política de importação específica.
Para rastrear operações de validação, inclua a validation instrução no nível da [edit routing-options flow] hierarquia.
Suporte para o algoritmo de especificação de fluxo BGP versão 7 e posterior
Por padrão, o Junos OS usa o algoritmo de ordenação de termos definido na versão 6 do rascunho de especificação de fluxo do BGP. No Junos OS versão 10.0 e posterior, você pode configurar o roteador para cumprir com o algoritmo de ordenação de termos definido pela primeira vez na versão 7 da especificação de fluxo BGP e suportado pelo RFC 5575, Disseminação de rotas de especificação de fluxo.
Recomendamos que você configure o Junos OS para usar o algoritmo de ordenação de termos definido pela primeira vez na versão 7 do rascunho de especificação de fluxo BGP. Também recomendamos que você configure o Junos OS para usar o mesmo algoritmo de ordenação de termos em todas as instâncias de roteamento configuradas em um roteador.
Para configurar o BGP para usar o algoritmo de especificação de fluxo definido pela primeira vez na versão 7 do rascunho da Internet, inclua a standard [edit routing-options flow term-order] declaração no nível da hierarquia.
Para reverter para o uso do algoritmo de ordenação de termos definido na versão 6, inclua a legacy instrução no nível da [edit routing-options flow term-order] hierarquia.
A ordem dos termos configurada tem apenas significado local. Ou seja, a ordem dos termos não se propaga com rotas de fluxo enviadas aos pares BGP remotos, cuja ordem dos termos é completamente determinada por sua própria configuração de ordem dos termos. Portanto, você deve ter cuidado ao configurar a ação next term dependente da ordem quando não estiver ciente da configuração de ordem de termo dos pares remotos. O local next term pode ser diferente do next term configurado no peer remoto.
No Junos OS Evolved, next term não pode aparecer como o último termo da ação. Não há suporte para um termo de filtro em que next term é especificado como uma ação, mas sem nenhuma condição de correspondência configurada.
A partir do Junos OS Release 16.1, você tem a opção de não aplicar o flowspec filtro ao tráfego recebido em interfaces específicas. Um novo termo é adicionado no início do flowspec filtro que aceita qualquer pacote recebido nessas interfaces específicas. O novo termo é uma variável que cria uma lista de exclusão de termos anexada ao filtro da tabela de encaminhamento como parte do filtro de especificação de fluxo.
Para excluir o flowspec filtro de ser aplicado ao tráfego recebido em interfaces específicas, você deve primeiro configurar uma group-id nessas interfaces incluindo a family inet filter group group-id declaração no nível de [edit interfaces] hierarquia e, em seguida, anexar o flowspec filtro ao grupo de interfaces incluindo a flow interface-group group-id exclude declaração no nível de [edit routing-options] hierarquia. Você pode configurar apenas uma group-id por instância de roteamento com a set routing-options flow interface-group group-id declaração.
Veja também
Exemplo: permitindo que o BGP carregue rotas de especificação de fluxo
Este exemplo mostra como permitir que o BGP carregue mensagens de NLRI (Network Layer Reachability Information, Informações de alcance da camada de rede) com especificação de fluxo.
Requerimentos
Antes de começar:
-
Configure as interfaces do dispositivo.
-
Configure um protocolo de gateway interior (IGP).
-
Configure BGP.
-
Configure uma política de roteamento que exporte rotas (como rotas diretas ou rotas IGP) da tabela de roteamento para o BGP.
Visão geral
A propagação de informações de filtro de firewall como parte do BGP permite que você propague filtros de firewall contra ataques de negação de serviço (DOS) dinamicamente em sistemas autônomos. As rotas de fluxo são encapsuladas no NLRI de especificação de fluxo e propagadas por uma rede ou redes privadas virtuais (VPNs), compartilhando informações semelhantes a filtros. As rotas de fluxo são uma agregação de condições de correspondência e ações resultantes para pacotes. Eles fornecem recursos de filtragem de tráfego e limitação de taxa, como os filtros de firewall. As rotas de fluxo unicast são suportadas para a instância padrão, instâncias de roteamento e encaminhamento VPN (VRF) e instâncias de roteador virtual.
As políticas de importação e exportação podem ser aplicadas à família inet flow ou inet-vpn flow família NLRI, afetando as rotas de fluxo aceitas ou anunciadas, semelhante à forma como as políticas de importação e exportação são aplicadas a outras famílias BGP. A única diferença é que a configuração da política de rib inetflow.0 fluxo deve incluir a from declaração. Essa instrução faz com que a política seja aplicada às rotas de fluxo. Uma exceção a essa regra ocorrerá se a política tiver apenas a then reject instrução ou e then accept nenhuma from instrução. Em seguida, a política afeta todas as rotas, incluindo IP unicast e fluxo de IP.
Os filtros de rota de fluxo são configurados primeiro em um roteador estaticamente, com um conjunto de critérios correspondentes seguidos pelas ações a serem tomadas. Em seguida, além de family inet unicast, family inet flow (ou family inet-vpn flow) é configurado entre esse dispositivo habilitado para BGP e seus pares.
Por padrão, as rotas de fluxo configuradas estaticamente (filtros de firewall) são anunciadas para outros dispositivos habilitados para BGP que oferecem suporte ao ou family inet-vpn flow NLRIfamily inet flow.
O dispositivo habilitado para BGP de recebimento executa um processo de validação antes de instalar o filtro de firewall na tabela de roteamento de instance-name.inetflow.0fluxo. O procedimento de validação é descrito na RFC 5575, Disseminação de Regras de Especificação de Fluxo.
O dispositivo habilitado para BGP de recebimento aceita uma rota de fluxo se passar pelos seguintes critérios:
-
O originador de uma rota de fluxo corresponde ao originador da melhor rota unicast correspondente para o endereço de destino incorporado na rota.
-
Não há rotas unicast mais específicas, quando comparadas ao endereço de destino da rota de fluxo, para as quais a rota ativa foi recebida de um sistema autônomo de next-hop diferente.
O primeiro critério garante que o filtro esteja sendo anunciado pelo próximo salto usado pelo encaminhamento unicast para o endereço de destino incorporado na rota de fluxo. Por exemplo, se uma rota de fluxo for fornecida como 10.1.1.1, proto=6, port=80, o dispositivo habilitado para BGP receptor selecionará a rota unicast mais específica na tabela de roteamento unicast que corresponde ao prefixo de destino 10.1.1.1/32. Em uma tabela de roteamento unicast contendo 10.1/16 e 10.1.1/24, a última é escolhida como a rota unicast a ser comparada. Somente a entrada de rota unicast ativa é considerada. Isso segue o conceito de que uma rota de fluxo é válida se anunciada pelo originador da melhor rota unicast.
O segundo critério aborda situações em que um determinado bloco de endereços é alocado a diferentes entidades. Os fluxos que são resolvidos para uma rota unicast de melhor correspondência que é uma rota agregada só serão aceitos se não cobrirem rotas mais específicas que estão sendo roteadas para diferentes sistemas autônomos de próximo salto.
Você pode ignorar o processo de validação para rotas de fluxo usando mensagens BGP NLRI e usar sua própria política de importação específica. Quando o BGP está transportando mensagens NLRI de especificação de fluxo, a no-validate instrução no nível de [edit protocols bgp group group-name family inet flow] hierarquia omite o procedimento de validação de rota de fluxo depois que os pacotes são aceitos por uma política. Você pode configurar a política de importação para corresponder ao endereço de destino e aos atributos do caminho, como comunidade, próximo salto e caminho AS. Você pode especificar a ação a ser executada se o pacote corresponder às condições que você configurou na rota de fluxo. Para configurar uma ação, inclua a declaração no nível da [edit routing-options flow] hierarquia. O tipo NLRI de especificação de fluxo inclui componentes como prefixo de destino, prefixo de origem, protocolo e portas, conforme definido no RFC 5575. A política de importação pode filtrar uma rota de entrada usando atributos de caminho e endereço de destino na especificação de fluxo NLRI. A política de importação não pode filtrar nenhum outro componente no RFC 5575.
A especificação de fluxo define as extensões de protocolo necessárias para tratar das aplicações mais comuns de filtragem unicast IPv4 e VPN unicast. O mesmo mecanismo pode ser reutilizado e novos critérios de correspondência podem ser adicionados para lidar com filtragem semelhante para outras famílias de endereços BGP (por exemplo, IPv6 unicast).
Depois que uma rota de fluxo é instalada na inetflow.0 tabela, ela também é adicionada à lista de filtros de firewall no kernel.
Somente em roteadores, as mensagens NLRI de especificação de fluxo são suportadas em VPNs. A VPN compara a comunidade estendida de destino de rota no NLRI com a política de importação. Se houver uma correspondência, a VPN poderá começar a usar as rotas de fluxo para filtrar e limitar a taxa de tráfego de pacotes. As rotas de fluxo recebidas são instaladas na tabela de roteamento de instance-name.inetflow.0fluxo. As rotas de fluxo também podem ser propagadas por toda uma rede VPN e compartilhadas entre VPNs. Para permitir que o BGP multiprotocolo (MP-BGP) carregue NLRI de especificação de fluxo para a inet-vpn família de endereços, inclua a flow declaração no nível da [edit protocols bgp group group-name family inet-vpn] hierarquia. As rotas de fluxo de VPN têm suporte apenas para a instância padrão. As rotas de fluxo configuradas para VPNs com família inet-vpn não são validadas automaticamente, portanto, a no-validate declaração não é suportada no nível da [edit protocols bgp group group-name family inet-vpn] hierarquia. Nenhuma validação será necessária se as rotas de fluxo estiverem configuradas localmente entre dispositivos em um único AS.
As políticas de importação e exportação podem ser aplicadas ao family inet flow ou family inet-vpn flow NLRI, afetando as rotas de fluxo aceitas ou anunciadas, semelhante à forma como as políticas de importação e exportação são aplicadas a outras famílias BGP. A única diferença é que a configuração da política de fluxo deve incluir a from rib inetflow.0 declaração. Essa instrução faz com que a política seja aplicada às rotas de fluxo. Uma exceção a essa regra ocorrerá se a política tiver apenas a then reject instrução ou e then accept nenhuma from instrução. Em seguida, a política afeta todas as rotas, incluindo IP unicast e fluxo de IP.
Este exemplo mostra como configurar as seguintes políticas de exportação:
-
Uma política que permite o anúncio de rotas de fluxo especificadas por um filtro de rota. Apenas as rotas de fluxo cobertas pelo bloco 10.13/16 são anunciadas. Essa política não afeta as rotas unicast.
-
Uma política que permite que todas as rotas de fluxo e unicast sejam anunciadas ao vizinho.
-
Uma política que não permite que todas as rotas (unicast ou flow) sejam anunciadas para o vizinho.
Topologia
Configuração
- Configuração de uma rota de fluxo estático
- Rotas de fluxo de publicidade especificadas por um filtro de rota
- Publicidade de todas as rotas de unicast e fluxo
- Publicidade Sem Unicast ou Rotas de Fluxo
- Limitando o número de rotas de fluxo instaladas em uma tabela de roteamento
- Limitando o número de prefixos recebidos em uma sessão de peering BGP
Configuração de uma rota de fluxo estático
Configuração rápida da CLI
Para configurar rapidamente este exemplo, copie os comandos a seguir, cole-os em um arquivo de texto, remova quaisquer quebras de linha, altere todos os detalhes necessários para corresponder à sua configuração de rede e, em seguida, copie e cole os comandos na CLI no nível de [edit] hierarquia.
set routing-options flow route block-10.131.1.1 match destination 10.131.1.1/32
set routing-options flow route block-10.131.1.1 match protocol icmp
set routing-options flow route block-10.131.1.1 match icmp-type echo-request
set routing-options flow route block-10.131.1.1 then discard
set routing-options flow term-order standard
Procedimento passo a passo
O exemplo a seguir requer que você navegue por vários níveis na hierarquia de configuração. Para obter informações sobre como navegar na CLI, consulte Uso do Editor de CLI no Modo de Configuração no Guia do Usuário da CLI do Junos OS.
Para configurar as sessões de peer BGP:
-
Configure as condições de correspondência.
[edit routing-options flow route block-10.131.1.1]
user@host# set match destination 10.131.1.1/32
user@host# set match protocol icmp
user@host# set match icmp-type echo-request
-
Configure a ação.
[edit routing-options flow route block-10.131.1.1]
user@host# set then discard
-
(Recomendado) Para o algoritmo de especificação de fluxo, configure a ordem dos termos baseada em padrão.
[edit routing-options flow]
user@host# set term-order standard
No algoritmo de ordenação de termos padrão, conforme especificado no rascunho de RFC de flowspec Versão 6, um termo com condições de correspondência menos específicas é sempre avaliado antes de um termo com condições de correspondência mais específicas. Isso faz com que o termo com condições de correspondência mais específicas nunca seja avaliado. A versão 7 do RFC 5575 fez uma revisão no algoritmo para que as condições de correspondência mais específicas sejam avaliadas antes das condições de correspondência menos específicas. Para compatibilidade com versões anteriores, o comportamento padrão não é alterado no Junos OS, embora o algoritmo mais recente faça mais sentido. Para usar o algoritmo mais recente, inclua a
term-order standardinstrução na configuração. Esta declaração é suportada no Junos OS Release 10.0 e posterior.
Resultados
No modo de configuração, confirme sua configuração digitando o show routing-options comando. Se a saída não exibir a configuração pretendida, repita as instruções neste exemplo para corrigir a configuração.
[edit]
user@host# show routing-options
flow {
    term-order standard;
    route block-10.131.1.1 {
        match {
            destination 10.131.1.1/32;
            protocol icmp;
            icmp-type echo-request;
        }
        then discard;
    }
}
Se você terminar de configurar o dispositivo, entre no commit modo de configuração.
Rotas de fluxo de publicidade especificadas por um filtro de rota
Configuração rápida da CLI
Para configurar rapidamente este exemplo, copie os comandos a seguir, cole-os em um arquivo de texto, remova quaisquer quebras de linha, altere todos os detalhes necessários para corresponder à sua configuração de rede e, em seguida, copie e cole os comandos na CLI no nível de [edit] hierarquia.
set protocols bgp group core family inet unicast
set protocols bgp group core family inet flow
set protocols bgp group core export p1
set protocols bgp group core peer-as 65000
set protocols bgp group core neighbor 10.12.99.5
set policy-options policy-statement p1 term a from rib inetflow.0
set policy-options policy-statement p1 term a from route-filter 10.13.0.0/16 orlonger
set policy-options policy-statement p1 term a then accept
set policy-options policy-statement p1 term b then reject
set routing-options autonomous-system 65001
Procedimento passo a passo
O exemplo a seguir requer que você navegue por vários níveis na hierarquia de configuração. Para obter informações sobre como navegar na CLI, consulte Uso do Editor de CLI no Modo de Configuração no Guia do Usuário da CLI do Junos OS.
Para configurar as sessões de peer BGP:
-
Configure o grupo BGP.
[edit protocols bgp group core]
user@host# set family inet unicast
user@host# set family inet flow
user@host# set export p1
user@host# set peer-as 65000
user@host# set neighbor 10.12.99.5
-
Configure a política de fluxo.
[edit policy-options policy-statement p1]
user@host# set term a from rib inetflow.0
user@host# set term a from route-filter 10.13.0.0/16 orlonger
user@host# set term a then accept
user@host# set term b then reject
-
Configure o número do sistema autônomo local (AS).
[edit routing-options]
user@host# set autonomous-system 65001
Resultados
No modo de configuração, confirme sua configuração inserindo os show protocolscomandos , show policy-optionse show routing-options . Se a saída não exibir a configuração pretendida, repita as instruções neste exemplo para corrigir a configuração.
[edit]
user@host# show protocols
bgp {
    group core {
        family inet {
            unicast;
            flow;
        }
        export p1;
        peer-as 65000;
        neighbor 10.12.99.5;
    }
}
[edit]
user@host# show policy-options
policy-statement p1 {
    term a {
        from {
            rib inetflow.0;
            route-filter 10.13.0.0/16 orlonger;
        }
        then accept;
    }
    term b {
        then reject;
    }
}
[edit]
user@host# show routing-options
autonomous-system 65001;
Se você terminar de configurar o dispositivo, entre no commit modo de configuração.
Publicidade de todas as rotas de unicast e fluxo
Configuração rápida da CLI
Para configurar rapidamente este exemplo, copie os comandos a seguir, cole-os em um arquivo de texto, remova quaisquer quebras de linha, altere todos os detalhes necessários para corresponder à sua configuração de rede e, em seguida, copie e cole os comandos na CLI no nível de [edit] hierarquia.
set protocols bgp group core family inet unicast
set protocols bgp group core family inet flow
set protocols bgp group core export p1
set protocols bgp group core peer-as 65000
set protocols bgp group core neighbor 10.12.99.5
set policy-options policy-statement p1 term a then accept
set routing-options autonomous-system 65001
Procedimento passo a passo
O exemplo a seguir requer que você navegue por vários níveis na hierarquia de configuração. Para obter informações sobre como navegar na CLI, consulte Uso do Editor de CLI no Modo de Configuração no Guia do Usuário da CLI do Junos OS.
Para configurar as sessões de peer BGP:
-
Configure o grupo BGP.
[edit protocols bgp group core]
user@host# set family inet unicast
user@host# set family inet flow
user@host# set export p1
user@host# set peer-as 65000
user@host# set neighbor 10.12.99.5
-
Configure a política de fluxo.
[edit policy-options policy-statement p1]
user@host# set term a then accept
-
Configure o número do sistema autônomo local (AS).
[edit routing-options]
user@host# set autonomous-system 65001
Resultados
No modo de configuração, confirme sua configuração inserindo os show protocolscomandos , show policy-optionse show routing-options . Se a saída não exibir a configuração pretendida, repita as instruções neste exemplo para corrigir a configuração.
[edit]
user@host# show protocols
bgp {
    group core {
        family inet {
            unicast;
            flow;
        }
        export p1;
        peer-as 65000;
        neighbor 10.12.99.5;
    }
}
[edit]
user@host# show policy-options
policy-statement p1 {
    term a {
        prefix-list inetflow;
        }
        then accept;
    }
}
[edit]
user@host# show routing-options
autonomous-system 65001;
Se você terminar de configurar o dispositivo, entre no commit modo de configuração.
Publicidade Sem Unicast ou Rotas de Fluxo
Configuração rápida da CLI
Para configurar rapidamente este exemplo, copie os comandos a seguir, cole-os em um arquivo de texto, remova quaisquer quebras de linha, altere todos os detalhes necessários para corresponder à sua configuração de rede e, em seguida, copie e cole os comandos na CLI no nível de [edit] hierarquia.
set protocols bgp group core family inet unicast
set protocols bgp group core family inet flow
set protocols bgp group core export p1
set protocols bgp group core peer-as 65000
set protocols bgp group core neighbor 10.12.99.5
set policy-options policy-statement p1 term a then reject
set routing-options autonomous-system 65001
Procedimento passo a passo
O exemplo a seguir requer que você navegue por vários níveis na hierarquia de configuração. Para obter informações sobre como navegar na CLI, consulte Uso do Editor de CLI no Modo de Configuração no Guia do Usuário da CLI do Junos OS.
Para configurar as sessões de peer BGP:
-
Configure o grupo BGP.
[edit protocols bgp group core]
user@host# set family inet unicast
user@host# set family inet flow
user@host# set export p1
user@host# set peer-as 65000
user@host# set neighbor 10.12.99.5
-
Configure a política de fluxo.
[edit policy-options policy-statement p1]
user@host# set term a then reject
-
Configure o número do sistema autônomo local (AS).
[edit routing-options]
user@host# set autonomous-system 65001
Resultados
No modo de configuração, confirme sua configuração inserindo os show protocolscomandos , show policy-optionse show routing-options . Se a saída não exibir a configuração pretendida, repita as instruções neste exemplo para corrigir a configuração.
[edit]
user@host# show protocols
bgp {
    group core {
        family inet {
            unicast;
            flow;
        }
        export p1;
        peer-as 65000;
        neighbor 10.12.99.5;
    }
}
[edit]
user@host# show policy-options
policy-statement p1 {
    term a {
        then reject;
    }
}
[edit]
user@host# show routing-options
autonomous-system 65001;
Se você terminar de configurar o dispositivo, entre no commit modo de configuração.
Limitando o número de rotas de fluxo instaladas em uma tabela de roteamento
Configuração rápida da CLI
Para configurar rapidamente este exemplo, copie os comandos a seguir, cole-os em um arquivo de texto, remova quaisquer quebras de linha, altere todos os detalhes necessários para corresponder à sua configuração de rede e, em seguida, copie e cole os comandos na CLI no nível de [edit] hierarquia.
set routing-options rib inetflow.0 maximum-prefixes 1000
set routing-options rib inetflow.0 maximum-prefixes threshold 50
Procedimento passo a passo
O exemplo a seguir requer que você navegue por vários níveis na hierarquia de configuração. Para obter informações sobre como navegar na CLI, consulte Uso do Editor de CLI no Modo de Configuração no Guia do Usuário da CLI do Junos OS.
A aplicação de um limite de rota pode resultar em um comportamento imprevisível do protocolo de rota dinâmica. Por exemplo, quando o limite é atingido e as rotas estão sendo rejeitadas, o BGP não tenta necessariamente reinstalar as rotas rejeitadas depois que o número de rotas cai abaixo do limite. As sessões de BGP podem precisar ser limpas para resolver esse problema.
Para limitar as rotas de fluxo:
-
Defina um limite superior para o número de prefixos instalados na
inetflow.0tabela.[edit routing-options rib inetflow.0] user@host# set maximum-prefixes 1000
-
Defina um valor limite de 50 por cento, em que, quando 500 rotas são instaladas, um aviso é registrado no log do sistema.
[edit routing-options rib inetflow.0]
user@host# set maximum-prefixes threshold 50
Resultados
No modo de configuração, confirme sua configuração digitando o show routing-options comando. Se a saída não exibir a configuração pretendida, repita as instruções neste exemplo para corrigir a configuração.
[edit]
user@host# show routing-options
rib inetflow.0 {
    maximum-prefixes 1000 threshold 50;
}
Se você terminar de configurar o dispositivo, entre no commit modo de configuração.
Limitando o número de prefixos recebidos em uma sessão de peering BGP
Configuração rápida da CLI
Para configurar rapidamente este exemplo, copie os comandos a seguir, cole-os em um arquivo de texto, remova quaisquer quebras de linha, altere todos os detalhes necessários para corresponder à sua configuração de rede e, em seguida, copie e cole os comandos na CLI no nível de [edit] hierarquia.
set protocols bgp group x1 neighbor 10.12.99.2 family inet flow prefix-limit maximum 1000
set protocols bgp group x1 neighbor 10.12.99.2 family inet flow prefix-limit teardown 50
set protocols bgp group x1 neighbor 10.12.99.2 family inet flow prefix-limit drop-excess 50
set protocols bgp group x1 neighbor 10.12.99.2 family inet flow prefix-limit hide-excess 50
Você pode incluir a teardown <percentage>opção de instrução , drop-excess <percentage>, ou hide-excess<percentage> uma de cada vez.
Procedimento passo a passo
O exemplo a seguir requer que você navegue por vários níveis na hierarquia de configuração. Para obter informações sobre como navegar na CLI, consulte Uso do Editor de CLI no Modo de Configuração no Guia do Usuário da CLI do Junos OS.
A configuração de um limite de prefixo para um vizinho específico fornece um controle mais previsível sobre qual peer pode anunciar quantas rotas de fluxo.
Para limitar o número de prefixos:
-
Defina um limite de 1000 rotas BGP do vizinho 10.12.99.2.
[edit protocols bgp group x1]
user@host# set neighbor 10.12.99.2 family inet flow prefix-limit maximum 1000
-
Configure a sessão vizinha ou os prefixos para executar
teardown <percentage>a opção de instrução ,drop-excess <percentage>ouhide-excess<percentage>quando a sessão ou os prefixos atingirem seu limite.[edit routing-options rib inetflow.0] user@host# set neighbor 10.12.99.2 family inet flow prefix-limit teardown 50 set neighbor 10.12.99.2 family inet flow prefix-limit drop-excess 50 set neighbor 10.12.99.2 family inet flow prefix-limit hide-excess 50
Se você especificar a
teardown <percentage>instrução e especificar uma porcentagem, as mensagens serão registradas quando o número de prefixos atingir essa porcentagem. Depois que a sessão é interrompida, a sessão é restabelecida em um curto espaço de tempo, a menos que você inclua aidle-timeoutinstrução.Se você especificar a
drop-excess <percentage>instrução e especificar uma porcentagem, as rotas excedentes serão descartadas quando o número de prefixos exceder essa porcentagemSe você especificar a
hide-excess <percentage>instrução e especificar uma porcentagem, as rotas em excesso serão ocultadas quando o número de prefixos exceder essa porcentagem.
Resultados
No modo de configuração, confirme sua configuração digitando o show protocols comando. Se a saída não exibir a configuração pretendida, repita as instruções neste exemplo para corrigir a configuração.
[edit]
user@host# show protocols
bgp {
    group x1 {
        neighbor 10.12.99.2 {
                flow {
                    prefix-limit {
                        maximum 1000;
                        teardown 50;
                        drop-excess <percentage>;
                        hide-excess <percentage>;
                    }
                }
            }
        }
    }
}
Se você terminar de configurar o dispositivo, entre no commit modo de configuração.
Verificação
Confirme se a configuração está funcionando corretamente.
- Verificando o NLRI
- Verificando rotas
- Verificando a validação de fluxo
- Verificando filtros de firewall
- Verificando o log do sistema ao exceder o número de rotas de fluxo permitidas
- Verificando o log do sistema ao exceder o número de prefixos recebidos em uma sessão de peering BGP
Verificando o NLRI
Finalidade
Veja o NLRI habilitado para o vizinho.
Ação
Do modo operacional, execute o show bgp neighbor 10.12.99.5 comando. inet-flow Procure na saída.
user@host> show bgp neighbor 10.12.99.5
Peer: 10.12.99.5+3792 AS 65000 Local: 10.12.99.6+179 AS 65002
Type: External State: Established Flags: <Sync>
Last State: OpenConfirm Last Event: RecvKeepAlive
Last Error: None
Export: [ direct ]
Options: <Preference HoldTime AddressFamily PeerAS Refresh>
Address families configured: inet-unicast inet-multicast inet-flow
Holdtime: 90 Preference: 170
Number of flaps: 1
Error: 'Cease' Sent: 0 Recv: 1
Peer ID: 10.255.71.161 Local ID: 10.255.124.107 Active Holdtime: 90
Keepalive Interval: 30 Peer index: 0
Local Interface: e1-3/0/0.0
NLRI advertised by peer: inet-unicast inet-multicast inet-flow
NLRI for this session: inet-unicast inet-multicast inet-flow
Peer supports Refresh capability (2)
Table inet.0 Bit: 10000
RIB State: BGP restart is complete
Send state: in sync
Active prefixes: 2
Received prefixes: 2
Suppressed due to damping: 0
Advertised prefixes: 3
Table inet.2 Bit: 20000
RIB State: BGP restart is complete
Send state: in sync
Active prefixes: 0
Received prefixes: 0
Suppressed due to damping: 0
Advertised prefixes: 0
Table inetflow.0 Bit: 30000
RIB State: BGP restart is complete
Send state: in sync
Active prefixes: 0
Received prefixes: 0
Suppressed due to damping: 0
Advertised prefixes: 0
Last traffic (seconds): Received 29 Sent 15 Checked 15
Input messages: Total 5549 Updates 2618 Refreshes 0 Octets 416486
Output messages: Total 2943 Updates 1 Refreshes 0 Octets 55995
Output Queue[0]: 0
Output Queue[1]: 0
Output Queue[2]: 0
Verificando rotas
Finalidade
Observe as rotas de fluxo. A saída de exemplo mostra uma rota de fluxo aprendida com o BGP e uma rota de fluxo configurada estaticamente.
Para rotas de fluxo configuradas localmente (configuradas no nível de [edit routing-options flow] hierarquia), as rotas são instaladas pelo protocolo de fluxo. Portanto, você pode exibir as rotas de fluxo especificando a tabela, como em show route table inetflow.0 ou show route table instance-name.inetflow.0, onde instance-name é o nome da instância de roteamento. Ou você pode exibir todas as rotas de fluxo configuradas localmente em várias instâncias de roteamento executando o show route protocol flow comando.
Se uma rota de fluxo não estiver configurada localmente, mas recebida do peer BGP do roteador, essa rota de fluxo será instalada na tabela de roteamento pelo BGP. Você pode exibir as rotas de fluxo especificando a tabela ou executando show route protocol bgp, que exibe todas as rotas BGP (fluxo e não fluxo).
Ação
Do modo operacional, execute o show route table inetflow.0 comando.
user@host> show route table inetflow.0
inetflow.0: 2 destinations, 2 routes (2 active, 0 holddown, 0 hidden)
+ = Active Route, - = Last Active, * = Both

100.100.100.100,*,proto=1,icmp-type=8/term:1
                   *[BGP/170] 00:00:18, localpref 100, from 100.0.12.2
                      AS path: 2000 I, validation-state: unverified
                      Fictitious
200.200.200.200,*,proto=6,port=80/term:2
                   *[BGP/170] 00:00:18, localpref 100, from 100.0.12.2
                      AS path: 2000 I, validation-state: unverified
                      Fictitious
user@host> show route table inetflow.0 extensive
inetflow.0: 3 destinations, 3 routes (3 active, 0 holddown, 0 hidden)
7.7.7.7,8.8.8.8/term:1 (1 entry, 1 announced)
TSI:
KRT in dfwd;
Action(s): accept,count
        *Flow   Preference: 5
                Next hop type: Fictitious
                Address: 0x8d383a4
                Next-hop reference count: 3
                State: <Active>
                Local AS: 65000
                Age: 9:50
                Task: RT Flow
                Announcement bits (1): 0-Flow
                AS path: I
user@host> show route hidden
inetflow.0: 2 destinations, 2 routes (0 active, 0 holddown, 2 hidden)
+ = Active Route, - = Last Active, * = Both

100.100.100.100,*,proto=1,icmp-type=8/term:N/A
                    [BGP ] 00:00:17, localpref 100, from 100.0.12.2
                      AS path: 2000 I, validation-state: unverified
                      Fictitious
200.200.200.200,*,proto=6,port=80/term:N/A
                    [BGP ] 00:00:17, localpref 100, from 100.0.12.2
                      AS path: 2000 I, validation-state: unverified
                      Fictitious
Significado
Uma rota de fluxo representa um termo de um filtro de firewall. Ao configurar uma rota de fluxo, você especifica as condições de correspondência e as ações. Nos atributos de correspondência, você pode corresponder a um endereço de origem, um endereço de destino e outros qualificadores, como a porta e o protocolo. Para uma única rota de fluxo que contém várias condições de correspondência, todas as condições de correspondência são encapsuladas no campo de prefixo da rota. Quando você emite o show route comando em uma rota de fluxo, o campo de prefixo da rota é exibido com todas as condições de correspondência. 10.12.44.1,* significa que a condição correspondente é match destination 10.12.44.1/32. Se o prefixo na saída fosse *,10.12.44.1, isso significaria que a condição de correspondência era match source 10.12.44.1/32. Se as condições correspondentes contiverem uma origem e um destino, o asterisco será substituído pelo endereço.
Os números de ordem de termo indicam a sequência dos termos (rotas de fluxo) que estão sendo avaliados no filtro de firewall. O show route extensive comando exibe as ações para cada termo (rota).
Verificando a validação de fluxo
Finalidade
Exibir informações de rota de fluxo.
Ação
Do modo operacional, execute o show route flow validation detail comando.
user@host> show route flow validation detail
inet.0:
0.0.0.0/0
                Internal node: best match, inconsistent
10.0.0.0/8
                Internal node: no match, inconsistent
10.12.42.0/24
                Internal node: no match, consistent, next-as: 65003
                Active unicast route
                    Dependent flow destinations: 1
                    Origin: 10.255.124.106, Neighbor AS: 65003
10.12.42.1/32
                Flow destination (1 entries, 1 match origin)
                    Unicast best match: 10.12.42.0/24
                    Flags: Consistent
10.131.0.0/16
                Internal node: no match, consistent, next-as: 65001
                Active unicast route
                    Dependent flow destinations: 5000
                    Origin: 10.12.99.2, Neighbor AS: 65001
10.131.0.0/19
                Internal node: best match
10.131.0.0/20
                Internal node: best match
10.131.0.0/21
Verificando filtros de firewall
Finalidade
Exiba os filtros de firewall instalados no kernel.
Ação
Do modo operacional, execute o show firewall comando.
user@host> show firewall
Filter: __default_bpdu_filter__
Filter: __flowspec_default_inet__
Counters:
Name                                                Bytes              Packets
10.12.42.1,*                                            0                    0
196.1.28/23,*                                           0                    0
196.1.30/24,*                                           0                    0
196.1.31/24,*                                           0                    0
196.1.32/24,*                                           0                    0
196.1.56/21,*                                           0                    0
196.1.68/24,*                                           0                    0
196.1.69/24,*                                           0                    0
196.1.70/24,*                                           0                    0
196.1.75/24,*                                           0                    0
196.1.76/24,*                                           0                    0
Verificando o log do sistema ao exceder o número de rotas de fluxo permitidas
Finalidade
Se você configurar um limite no número de rotas de fluxo instaladas, conforme descrito em Limitando o número de rotas de fluxo instaladas em uma tabela de roteamento, visualize a mensagem de log do sistema quando o limite for atingido.
Ação
Do modo operacional, execute o show log <message> comando.
user@host> show log message
Jul 12 08:19:01  host rpd[2748]: RPD_RT_MAXROUTES_WARN: Number of routes (1000) in
table inetflow.0 exceeded warning threshold (50 percent of configured maximum 1000)
Verificando o log do sistema ao exceder o número de prefixos recebidos em uma sessão de peering BGP
Finalidade
Se você configurar um limite no número de rotas de fluxo instaladas, conforme descrito em Limitando o número de prefixos recebidos em uma sessão de emparelhamento BGP, visualize a mensagem de log do sistema quando o limite for atingido.
Ação
Do modo operacional, execute o show log message comando.
Se você especificar a opção de teradown <percentage> instrução:
user@host> show log message
Jul 12 08:44:47  host rpd[2748]: 10.12.99.2 (External AS 65001): Shutting down peer due to
exceeding configured maximum  prefix-limit(1000) for inet-flow nlri: 1001
Se você especificar a opção de drop-excess <percentage> instrução:
user@host> show log message
Jul 27 15:26:57  R1_re rpd[32443]: BGP_DROP_PREFIX_LIMIT_EXCEEDED: 1.1.1.2 (Internal
AS 1): Exceeded drop-excess maximum prefix-limit(4) for inet-unicast nlri: 5 (instance master)
Se você especificar a opção de hide-excess <percentage> instrução:
user@host> show log message
Jul 27 15:26:57  R1_re rpd[32443]: BGP_HIDE_PREFIX_LIMIT_EXCEEDED: 1.1.1.2 (Internal
AS 1): Exceeded hide-excess maximum prefix-limit(4) for inet-unicast nlri: 5 (instance master)
Exemplo: configurar o BGP para transportar rotas de especificação de fluxo IPv6
Este exemplo mostra como configurar a especificação de fluxo IPv6 para filtragem de tráfego. A especificação de fluxo BGP pode ser usada para automatizar a coordenação entre domínios e intradomínios de regras de filtragem de tráfego a fim de mitigar ataques de negação de serviço.
Requerimentos
Este exemplo usa os seguintes componentes de hardware e software:
-
Dois roteadores da Série MX
-
Junos OS versão 16.1 ou posterior
Antes de habilitar o BGP para transportar rotas de especificação de fluxo IPv6:
-
Configure endereços IP nas interfaces do dispositivo.
-
Configure BGP.
-
Configure uma política de roteamento que exporte rotas (como rotas estáticas, rotas diretas ou rotas IGP) da tabela de roteamento para o BGP.
Visão geral
A especificação de fluxo fornece proteção contra ataques de negação de serviço e restringe o tráfego ruim que consome a largura de banda e o interrompe próximo à origem. Nas versões anteriores do Junos OS, as regras de especificação de fluxo eram propagadas para IPv4 sobre BGP como informações de alcance da camada de rede. A partir do Junos OS Release 16.1, o recurso de especificação de fluxo é suportado na família IPv6 e permite a propagação de regras de especificação de fluxo de tráfego para IPv6 e VPN IPv6.
Topologia
A Figura 7 mostra a topologia de exemplo. O roteador R1 e o roteador R2 pertencem a sistemas autônomos diferentes. A especificação de fluxo IPv6 está configurada no Roteador R2. Todo o tráfego de entrada é filtrado com base nas condições de especificação de fluxo e o tráfego é tratado de forma diferente dependendo da ação especificada. Neste exemplo, todo o tráfego que vai para abcd::11:11:11:10/128 que corresponde às condições de especificação de fluxo é descartado; Considerando que, o tráfego destinado a ABCD::11:11:11:30/128 e que corresponda às condições de especificação de fluxo é aceito.
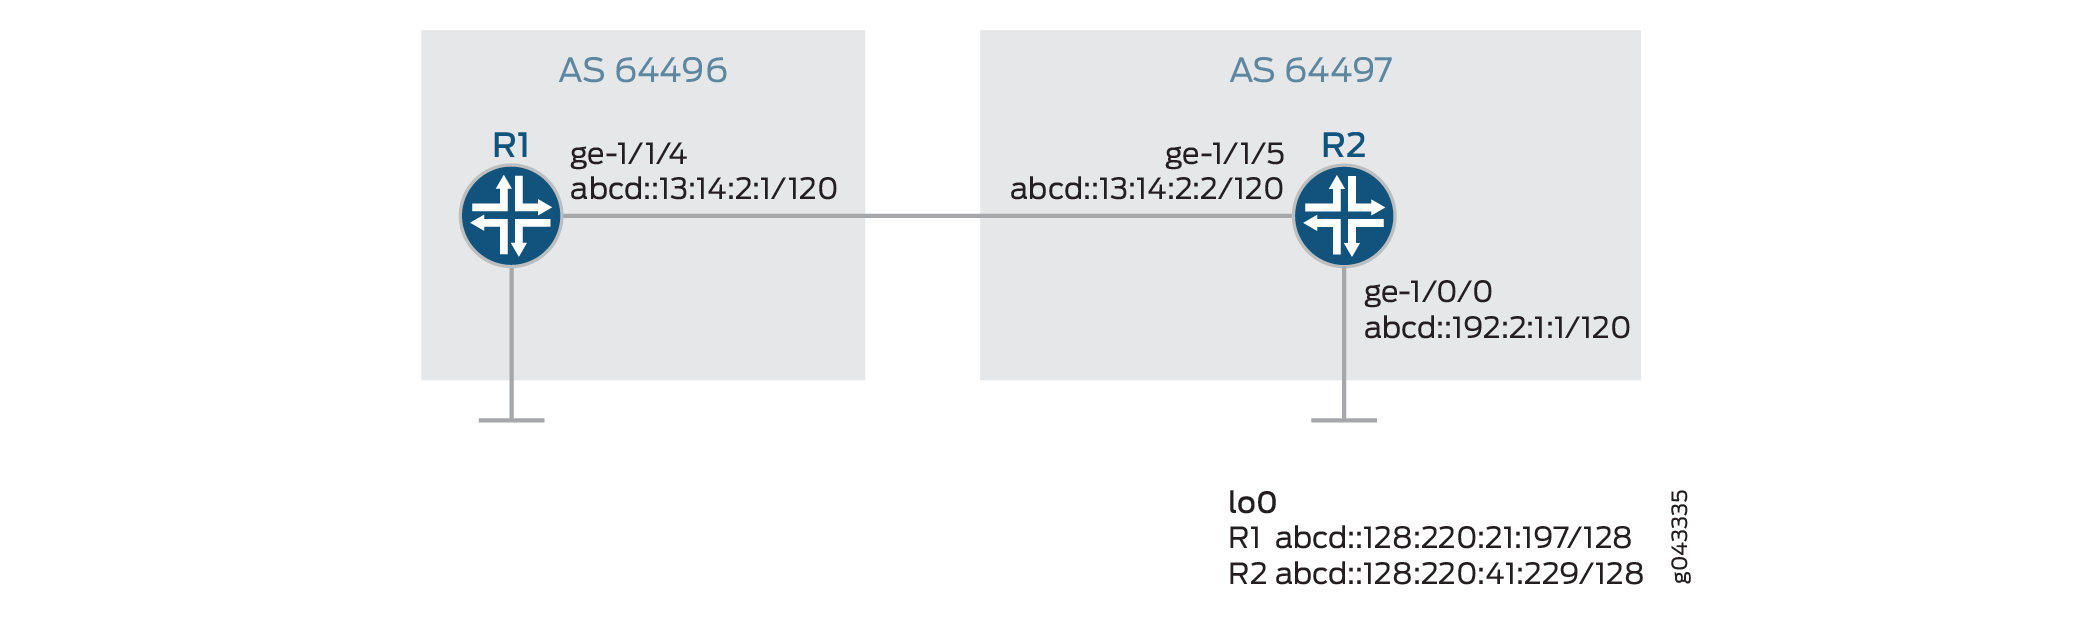 de fluxo IPv6
Configuração
Configuração rápida da CLI
Para configurar rapidamente este exemplo, copie os comandos a seguir, cole-os em um arquivo de texto, remova quaisquer quebras de linha, altere todos os detalhes necessários para corresponder à sua configuração de rede, copie e cole os comandos na CLI no nível de [edit] hierarquia e, em seguida, entre commit no modo de configuração.
Roteador R1
set interfaces ge-1/1/4 unit 0 family inet6 address abcd::13:14:2:1/120
set interfaces lo0 unit 0 family inet6 address abcd::128:220:21:197/128
set routing-options router-id 128.220.21.197
set routing-options autonomous-system 64496
set protocols bgp group ebgp type external
set protocols bgp group ebgp family inet6 unicast
set protocols bgp group ebgp family inet6 flow
set protocols bgp group ebgp peer-as 64497
set protocols bgp group ebgp neighbor abcd::13:14:2:2
Roteador R2
set interfaces ge-1/0/0 unit 0 family inet6 address abcd::192:2:1:1/120
set interfaces ge-1/1/5 unit 0 family inet6 address abcd::13:14:2:2/120
set interfaces lo0 unit 0 family inet6 address abcd::128:220:41:229/128
set routing-options rib inet6.0 static route abcd::11:11:11:0/120 next-hop abcd::192:2:1:2
set routing-options rib inet6.0 flow route route-1 match destination abcd::11:11:11:10/128
set routing-options rib inet6.0 flow route route-1 match protocol tcp
set routing-options rib inet6.0 flow route route-1 match destination-port http
set routing-options rib inet6.0 flow route route-1 match source-port 65535
set routing-options rib inet6.0 flow route route-1 then discard
set routing-options rib inet6.0 flow route route-2 match destination abcd::11:11:11:30/128
set routing-options rib inet6.0 flow route route-2 match icmp6-type echo-request
set routing-options rib inet6.0 flow route route-2 match packet-length 100
set routing-options rib inet6.0 flow route route-2 match dscp 10
set routing-options rib inet6.0 flow route route-2 then accept
set routing-options router-id 128.220.41.229
set routing-options autonomous-system 64497
set protocols bgp group ebgp type external
set protocols bgp group ebgp family inet6 unicast
set protocols bgp group ebgp family inet6 flow
set protocols bgp group ebgp export redis
set protocols bgp group ebgp peer-as 64496
set protocols bgp group ebgp neighbor abcd::13:14:2:1
set policy-options policy-statement redis from protocol static
set policy-options policy-statement redis then accept
Configurando o roteador R2
Procedimento passo a passo
O exemplo a seguir requer que você navegue por vários níveis na hierarquia de configuração. Para obter informações sobre como navegar na CLI, consulte Uso do Editor de CLI no Modo de Configuração no Guia do Usuário da CLI.
Para configurar o Roteador R2:
Repita este procedimento para o Roteador R1 depois de modificar os nomes de interface apropriados, endereços e outros parâmetros.
-
Configure as interfaces com endereços IPv6.
[edit interfaces]
user@R2# set ge-1/0/0 unit 0 family inet6 address abcd::192:2:1:1/120
user@R2# set ge-1/1/5 unit 0 family inet6 address abcd::13:14:2:2/120
-
Configure o endereço de loopback IPv6.
[edit interfaces]
user@R2# set lo0 unit 0 family inet6 address abcd::128:220:41:229/128
-
Configure o ID do roteador e o número do sistema autônomo (AS).
[edit routing-options]
user@R2# set router-id 128.220.41.229
user@R2# set autonomous-system 64497
-
Configure uma sessão de peering EBGP entre o Roteador R1 e o Roteador R2.
[edit protocols]
user@R2# set bgp group ebgp type external
user@R2# set bgp group ebgp family inet6 unicast
user@R2# set bgp group ebgp family inet6 flow
user@R2# set bgp group ebgp export redis
user@R2# set bgp group ebgp peer-as 64496
user@R2# set bgp group ebgp neighbor abcd::13:14:2:1
-
Configure uma rota estática e um próximo salto. Assim, uma rota é adicionada à tabela de roteamento para verificar o recurso neste exemplo.
[edit routing-options]
user@R2# set rib inet6.0 static route abcd::11:11:11:0/120 next-hop abcd::192:2:1:2
-
Especifique as condições de especificação de fluxo.
[edit routing-options]
user@R2# set rib inet6.0 flow route route-1 match destination abcd::11:11:11:10/128
user@R2# set rib inet6.0 flow route route-1 match protocol tcp
user@R2# set rib inet6.0 flow route route-1 match destination-port http
user@R2# set rib inet6.0 flow route route-1 match source-port 65535
-
Configure uma discard ação para descartar pacotes que correspondam às condições de correspondência especificadas.
[edit routing-options]
user@R2# set rib inet6.0 flow route route-1 then discard
-
Especifique as condições de especificação de fluxo.
[edit routing-options]
user@R2# set rib inet6.0 flow route route-2 match destination abcd::11:11:11:30/128
user@R2# set rib inet6.0 flow route route-2 match icmp6-type echo-request
user@R2# set rib inet6.0 flow route route-2 match packet-length 100
user@R2# set rib inet6.0 flow route route-2 match dscp 10
-
Configure uma accept ação para aceitar pacotes que correspondam às condições de correspondência especificadas
[edit routing-options]
user@R2# set rib inet6.0 flow route route-2 then accept
-
Defina uma política que permita que o BGP aceite rotas estáticas.
[edit policy-options]
user@R2# set policy-statement redis from protocol static
user@R2# set policy-statement redis then accept
Resultados
No modo de configuração, confirme sua configuração inserindo os show interfacescomandos , show protocols, , show routing-optionse show policy-options . Se a saída não exibir a configuração pretendida, repita as instruções neste exemplo para corrigir a configuração.
[edit]
user@R2# show interfaces
ge-1/0/0 {
    unit 0 {
        family inet6 {
            address abcd::192:2:1:1/120;
        }
    }
}
ge-1/1/5 {
    unit 0 {
        family inet6 {
            address abcd::13:14:2:2/120;
        }
    }
}
lo0 {
    unit 0 {
        family inet6 {
            address abcd::128:220:41:229/128;
        }
    }
}
[edit]
user@R2# show protocols
bgp {
    group ebgp {
        type external;
        family inet6 {
            unicast;
            flow;
        }
        export redis;
        peer-as 64496;
        neighbor abcd::13:14:2:1;
    }
}
[edit]
user@R2# show routing-options
rib inet6.0 {
    static {
        route abcd::11:11:11:0/120 next-hop abcd::192:2:1:2;
    }
    flow {
        route route-1 {
            match {
                destination abcd::11:11:11:10/128;
                protocol tcp;
                destination-port http;
                source-port 65535;
            }
            then discard;
        }
        route route-2 {
            match {
                destination abcd::11:11:11:30/128;
                icmp6-type echo-request;
                packet-length 100;
                dscp 10;
            }
            then accept;
        }
    }
}
router-id 128.220.41.229;
autonomous-system 64497;
[edit]
user@R2# show policy-options
policy-statement redis {
    from protocol static;
    then accept;
}
Verificação
Confirme se a configuração está funcionando corretamente.
- Verificando a presença de rotas de especificação de fluxo IPv6 na tabela inet6flow
- Verificando as informações de resumo do BGP
- Verificando a validação de fluxo
- Verificando a especificação de fluxo de rotas IPv6
Verificando a presença de rotas de especificação de fluxo IPv6 na tabela inet6flow
Finalidade
Exiba as inet6flow rotas na tabela nos roteadores R1 e R2 e verifique se o BGP aprendeu as rotas de fluxo.
Ação
Do modo operacional, execute o show route table inet6flow.0 extensive comando no Roteador R1.
user@R1>
                  show route table inet6flow.0 extensive
inet6flow.0: 2 destinations, 2 routes (2 active, 0 holddown, 0 hidden)
abcd::11:11:11:10/128,*,proto=6,dstport=80,srcport=65535/term:1 (1 entry, 1 announced)
TSI:
KRT in dfwd;
Action(s): discard,count
        *BGP    Preference: 170/-101
                Next hop type: Fictitious, Next hop index: 0
                Address: 0x9b24064
                Next-hop reference count: 2
                State:<Active Ext>
                Local AS:   64496 Peer AS:  64497
                Age: 20:55
                Validation State: unverified
                Task: BGP_64497.abcd::13:14:2:2
                Announcement bits (1): 0-Flow
                AS path: 64497 I
                Communities: traffic-rate:64497:0
                Accepted
                Validation state: Accept, Originator: abcd::13:14:2:2, Nbr AS: 64497
                Via: abcd::11:11:11:0/120, Active
                Localpref: 100
                Router ID: 128.220.41.229

abcd::11:11:11:30/128,*,icmp6-type=128,len=100,dscp=10/term:2 (1 entry, 1 announced)
TSI:
KRT in dfwd;
Action(s): accept,count
        *BGP    Preference: 170/-101
                Next hop type: Fictitious, Next hop index: 0
                Address: 0x9b24064
                Next-hop reference count: 2
                State:  <Active Ext>
                Local AS:   64496 Peer AS:  64497
                Age: 12:51
                Validation State: unverified
                Task: BGP_64497.abcd::13:14:2:2
                Announcement bits (1): 0-Flow
                AS path: 64497 I
                Accepted
                Validation state: Accept, Originator: abcd::13:14:2:2, Nbr AS: 64497
                Via: abcd::11:11:11:0/120, Active
                Localpref: 100
                Router ID: 128.220.41.229
Do modo operacional, execute o show route table inet6flow.0 extensive comando no Roteador R2.
user@R2> show route table inet6flow.0 extensive
inet6flow.0: 2 destinations, 2 routes (2 active, 0 holddown, 0 hidden)
abcd::11:11:11:10/128,*,proto=6,dstport=80,srcport=65535/term:1 (1 entry, 1 announced)
TSI:
KRT in dfwd;
Action(s): discard,count
Page 0 idx 0, (group pe-v6 type External) Type 1 val 0xaec8850 (adv_entry)
   Advertised metrics:
     Nexthop: Self
     AS path: [64497]
     Communities: traffic-rate:64497:0
Path abcd::11:11:11:10/128,*,proto=6,dstport=80,srcport=65535 Vector len 4.  Val: 0
        *Flow   Preference: 5
                Next hop type: Fictitious, Next hop index: 0
                Address: 0x9b24064
                Next-hop reference count: 3
                State:  <Active>
                Local AS:  64497
                Age: 14:21
                Validation State: unverified
                Task: RT Flow
                Announcement bits (2): 0-Flow 1-BGP_RT_Background
                AS path: I
                Communities: traffic-rate:64497:0


abcd::11:11:11:30/128,*,proto=17,port=65535/term:2 (1 entry, 1 announced)
TSI:
KRT in dfwd;
Action(s): accept,count
Page 0 idx 0, (group pe-v6 type External) Type 1 val 0xaec8930 (adv_entry)
 Advertised metrics:
  Nexthop: Self
  AS path: [64497]
  Communities:
Path abcd::11:11:11:30/128,*,proto=17,port=65535 Vector len 4.  Val: 0
*Flow   Preference: 5
    Next hop type: Fictitious, Next hop index: 0
    Address: 0x9b24064
    Next-hop reference count: 3
    State: <Active>
    Local AS:  64497
    Age: 14:21
    Validation State: unverified
    Task: RT Flow
    Announcement bits (2): 0-Flow 1-BGP_RT_Background
    AS path: I
Significado
A presença das rotas abcd::11:11:11:10/128 e abcd::11:11:11:30/128 na tabela confirma que o inet6flow BGP aprendeu as rotas de fluxo.
Verificando as informações de resumo do BGP
Finalidade
Verifique se a configuração do BGP está correta.
Ação
Do modo operacional, execute o show bgp summary comando nos roteadores R1 e R2.
user@R1> show bgp summary

Groups: 1 Peers: 1 Down peers: 0
Table          Tot Paths  Act Paths Suppressed    History Damp State    Pending
inet6.0
                       1          1          0          0          0          0
inet6flow.0
                       2          2          0          0          0          0
Peer                     AS      InPkt     OutPkt    OutQ   Flaps Last Up/Dwn State|#Active/Received/Accepted/Damped...
abcd::13:14:2:2        2000         58         58       0       2       19:48 Establ
  inet6.0: 1/1/1/0
  inet6flow.0: 2/2/2/0
user@R2> show bgp summary
 Groups: 1 Peers: 1 Down peers: 0
Table          Tot Paths  Act Paths Suppressed    History Damp State    Pending
inet6.0
                       0          0          0          0          0          0
inet6flow.0
                       0          0          0          0          0          0
Peer                     AS      InPkt     OutPkt    OutQ   Flaps Last Up/Dwn State|#Active/Received/Accepted/Damped...
abcd::13:14:2:1         64496         51         52       0       0       23:03 Establ
  inet6.0: 0/0/0/0
  inet6flow.0: 0/0/0/0
Significado
Verifique se a inet6.0 tabela contém o endereço do vizinho BGP e se uma sessão de emparelhamento foi estabelecida com seu vizinho BGP.
Verificando a validação de fluxo
Finalidade
Exibir informações de rota de fluxo.
Ação
Do modo operacional, execute o show route flow validation comando no Roteador R1.
user@R1> show route flow validation
inet6.0:
abcd::11:11:11:0/120
                Active unicast route
                    Dependent flow destinations: 2
                    Origin: abcd::13:14:2:2, Neighbor AS: 64497
abcd::11:11:11:10/128
                Flow destination (1 entries, 1 match origin, next-as)
                    Unicast best match: abcd::11:11:11:0/120
                    Flags: Consistent
abcd::11:11:11:30/128
                Flow destination (1 entries, 1 match origin, next-as)
                    Unicast best match: abcd::11:11:11:0/120
                    Flags: Consistent
Significado
A saída exibe as rotas de fluxo na inet6.0 tabela.
Verificando a especificação de fluxo de rotas IPv6
Finalidade
Exiba o número de pacotes que são descartados e aceitos com base nas rotas de especificação de fluxo especificadas.
Ação
Do modo operacional, execute o show firewall filter_flowspec_default_inet6_ comando no Roteador R2.
user@R2> show firewall filter __flowspec_default_inet6__
Filter: __flowspec_default_inet6__
Counters:
Name                                                																Bytes              Packets
abcd::11:11:11:10/128,*,proto=6,dstport=80,srcport=65535            0                     0
abcd::11:11:11:30/128,*,proto=17,port=65535              			  6395472                88826
Significado
A saída indica que os pacotes destinados a abcd::11:11:11:10/128 são descartados e 88826 pacotes foram aceitos para a rota abcd::11:11:11:11:30/128.
Configuração da especificação de fluxo BGP Redirecionamento para IP
O recurso de redirecionamento de especificação de fluxo BGP para IP aprimora os recursos de engenharia de tráfego, permitindo o redirecionamento de tráfego com base nas regras de especificação de fluxo (FlowSpec). Esse recurso dá suporte ao redirecionamento para um endereço IPv4 ou IPv6, conforme descrito no rascunho da Internet BGP Flow-Spec: draft-ietf-idr-flowspec-redirect-ip-02.txt, Redirecionar para Ação de IP. Ele é particularmente benéfico para a mitigação de DDoS em redes de Provedor de serviços (SP) e encaminhamento baseado em políticas em ambientes de serviço virtualizados (vSCG).
Casos de uso
-
Mitigação de DDoS — Redireciona o tráfego malicioso para centros de limpeza para análise e limpeza.
-
Encaminhamento baseado em políticas — Permite o gerenciamento avançado de tráfego, direcionando fluxos de tráfego para destinos específicos com base em regras predefinidas.
Topologia
-
Figura 8: Fluxo
 existente
-
Quando um ataque é detectado, o redirecionamento FlowSpec para VRF é aplicado no roteador Ingress Provider Edge (PE).
-
O VRF sujo então redireciona o tráfego para um purificador conectado ao Head-End PE (HE-PE).
-
Depois que o tráfego é limpo, o HE-PE o encaminha para o destino pretendido.
-
-
Figura 9: Novo fluxo
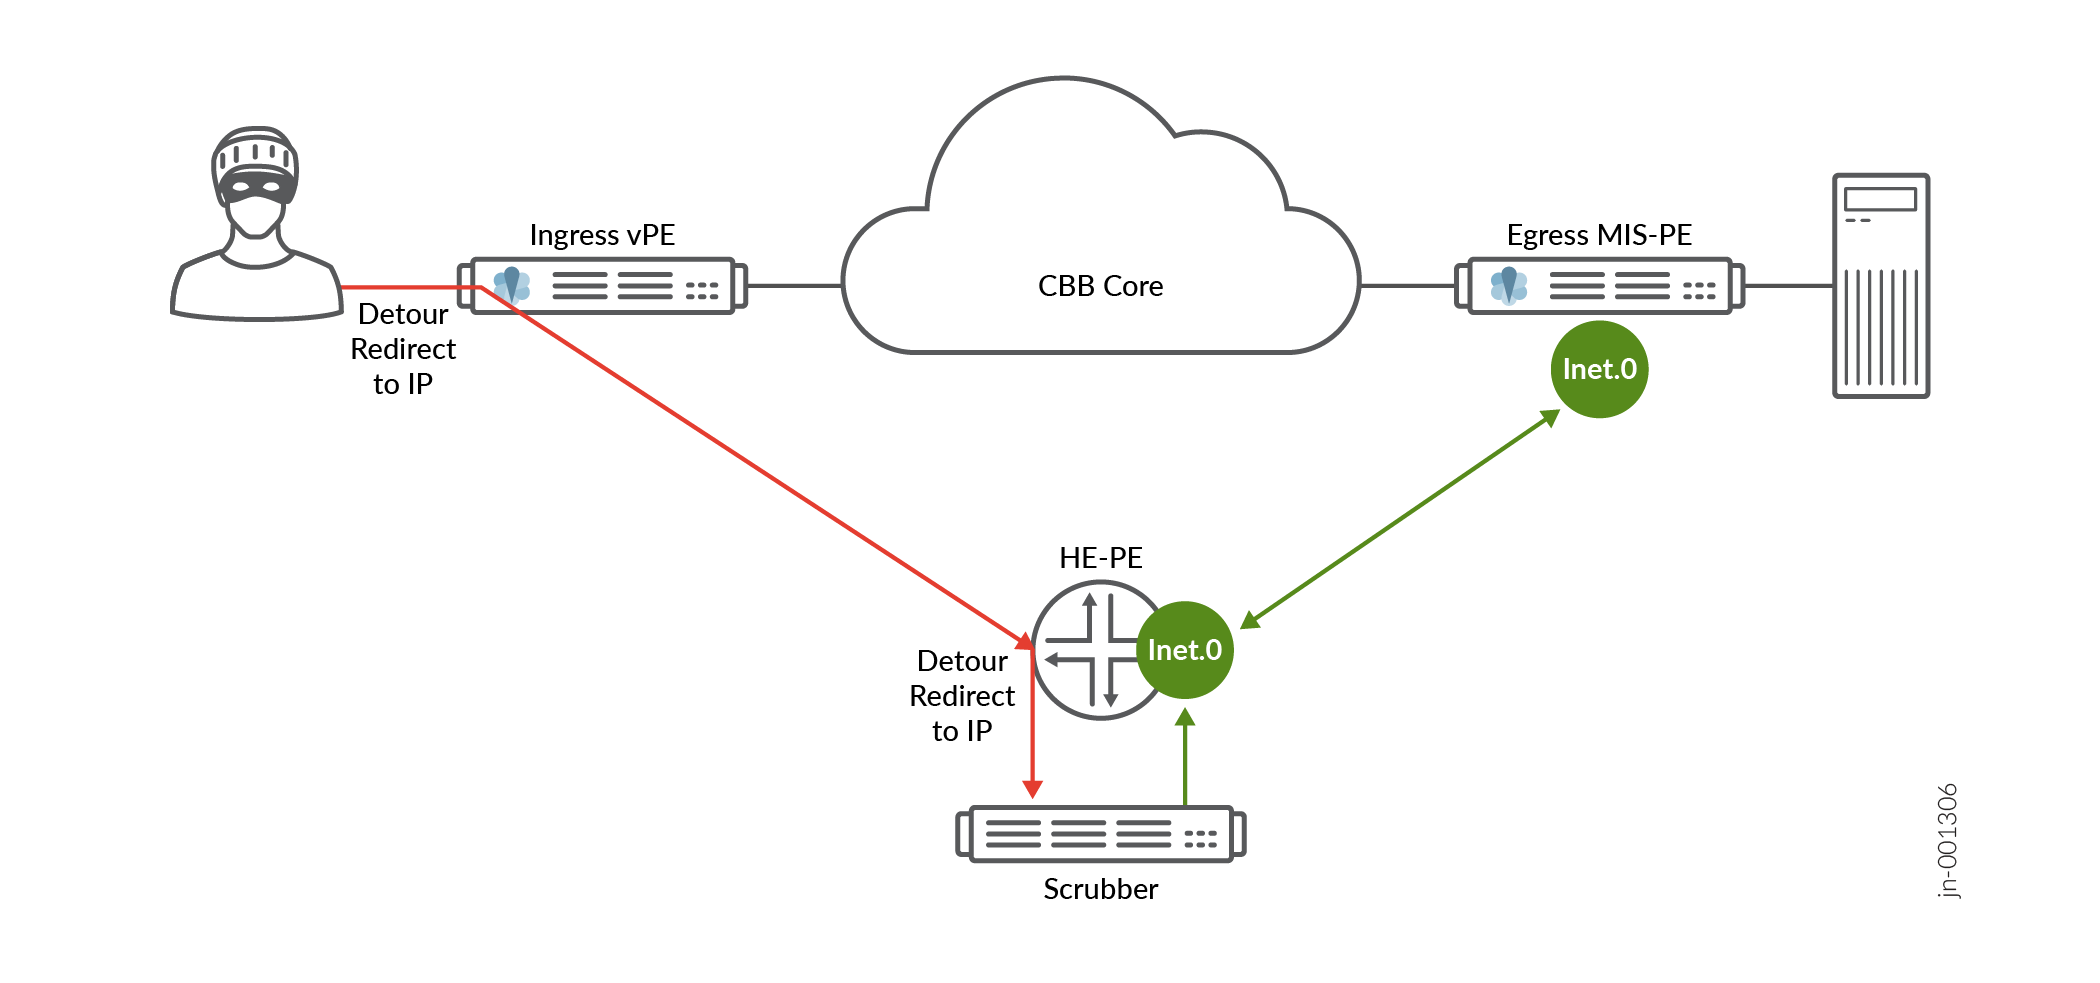
-
Em vez de redirecionar para VRF, o redirecionamento para IP do FlowSpec é aplicado em interfaces externas do PE de entrada.
-
O tráfego malicioso é encaminhado diretamente para o HE-PE.
-
O HE-PE redireciona o tráfego para o purificador com base na regra de redirecionamento para IP.
-
O tráfego limpo é encaminhado ao seu destino sem exigir um VRF sujo dedicado.
-
Plataformas visadas
-
vMX, roteadores da Série MX
Metas de desempenho e dimensionamento
-
O recurso visa oferecer suporte a 1.000 dessas rotas FlowSpec para gerenciar com eficácia o redirecionamento de tráfego.
Comandos de verificação:
show firewall filter FLOWSPEC
Esse recurso garante maior escalabilidade, latência reduzida e mitigação eficiente de DDoS, simplificando o processo de redirecionamento por meio do tratamento de tráfego baseado em IP em vez da segmentação baseada em VRF.
Veja também
Configuração da ação de especificação de fluxo BGP Redirecionar para IP para filtrar o tráfego DDoS
A partir Junos OS versão 18.4R1, BGP especificação de fluxo, conforme descrito em BGP draft-ietf-idr-flowspec-redirect-ip-02.txt de rascunho da Internet Flow-Spec, há suporte para a ação de redirecionamento para IP . A ação de redirecionamento para IP usa a comunidade BGP estendida para fornecer opções de filtragem de tráfego para mitigação de DDoS em redes de provedores de serviços. O redirecionamento de especificação de fluxo herdado para IP usa o atributo nexthop BGP. O Junos OS anuncia o redirecionamento para a ação de especificação de fluxo de IP usando a comunidade estendida por padrão. Esse recurso é necessário para dar suporte ao encadeamento de serviços no gateway de controle de serviço virtual (vSCG). A ação de redirecionamento para IP permite desviar o tráfego de especificação de fluxo correspondente para um endereço globalmente acessível que pode ser conectado a um dispositivo de filtragem que pode filtrar o tráfego DDoS e enviar o tráfego limpo para o dispositivo de saída.
O IPv6 é suportado apenas no modo de codificação de redirecionamento para Nexthop herdado. Não oferecemos suporte ao novo formato de codificação de redirecionamento para IP para IPv6.
Antes de começar a redirecionar o tráfego para o IP para rotas de especificação de fluxo BGP, faça o seguinte:
-
Configure as interfaces do dispositivo.
-
Configurar o OSPF ou qualquer outro protocolo IGP.
-
Configurar MPLS e LDP.
-
Configure BGP.
Configure o recurso de redirecionamento para IP usando a comunidade estendida do BGP.
Configure o redirecionamento de especificação de fluxo herdado para o recurso IP usando o atributo nexthop.
Você não pode configurar políticas para redirecionar o tráfego para um endereço IP usando a comunidade estendida do BGP e o redirecionamento legado para o endereço IP do próximo salto juntos.
-
Configure o redirecionamento de especificação de fluxo herdado para o IP especificado no rascunho da Internet draft-ietf-idr-flowspec-redirect-ip-00.txt BGP Comunidade estendida de especificação de fluxo para redirecionamento de tráfego para a inclusão do próximo salto de IP no nível de hierarquia.
[edit group bgp-group neighbor bgp neighbor family inet flow]
user@host# set legacy-redirect-ip-action
-
Defina uma política para corresponder ao atributo do próximo salto.
[edit policy options]
user@host#policy statement policy_name
user@host#from community community-name
user@host#from next-hop ip-address
Por exemplo, defina uma política p1 para redirecionar o tráfego para o endereço IP do próximo salto 10.1.1.1.
[edit policy options]
user@host#policy statement p1
user@host#from community redirnh
user@host#from next-hop 10.1.1.1
-
Defina uma política para definir, adicionar ou excluir a comunidade BGP usando a ação de redirecionamento de atributo de próximo salto de especificação de fluxo legado para IP.
[edit policy-options]
user@host# policy-statement policy_name
user@host# then community set community-name
user@host# then community add community-name
user@host# then community delete community-name
user@host# then next-hop next-hop-address
Por exemplo, defina uma política p1 e defina, adicione ou exclua um redirecionamento de comunidade BGP para redirecionar o tráfego DDoS para o endereço IP do próximo salto 10.1.1.1.
[edit policy-options policy-statement p1]
user@host# then community set redirnh
user@host# then community add redirnh
user@host# then community delete redirnh
user@host# then next-hop 10.1.1.1
Veja também
Encaminhamento de tráfego usando a especificação de fluxo BGP Ação DSCP
Configure a ação DSCP da especificação de fluxo BGP (FlowSpec) para encaminhar pacotes usando as informações de classe de encaminhamento e prioridade de perda pela rede de forma eficaz.
Benefícios do BGP FlowSpec Ação DSCP para encaminhar pacotes
-
Encaminha o tráfego para as filas COS pretendidas, onde as políticas COS são aplicadas ao tráfego corretamente.
-
Influencia o comportamento de encaminhamento local (por exemplo, seleção do túnel) com base no valor de DSCP provisionado.
-
Ajuda a gerenciar o tráfego em sua rede de forma eficaz.
Quando um pacote entra em um roteador, ele passa pelos recursos (como firewall, COS, etc.) aplicados na interface de entrada. Quando você configura o filtro BGP FlowSpec na interface de entrada, o filtro é aplicado nos pacotes por instância de roteamento com base na ação DSCP. A ação DSCP classifica e reescreve os pacotes, juntamente com a alteração do código DSCP por meio do filtro BGP FlowSpec. Com base nas informações de classe de encaminhamento e prioridade de perda, os pacotes são colocados na fila de encaminhamento correta. Os pacotes viajam por rotas de fluxo somente se condições específicas de correspondência forem atendidas. As condições correspondentes podem ser endereço IP de origem e destino, porta de origem e destino, DSCP, número de protocolo, etc. As informações de classe de encaminhamento e prioridade de perda são atualizadas por meio da tabela de mapeamento reverso.
Aqui está uma topologia de uma sessão BGP estabelecida entre o provedor de serviços e as redes de clientes corporativos.
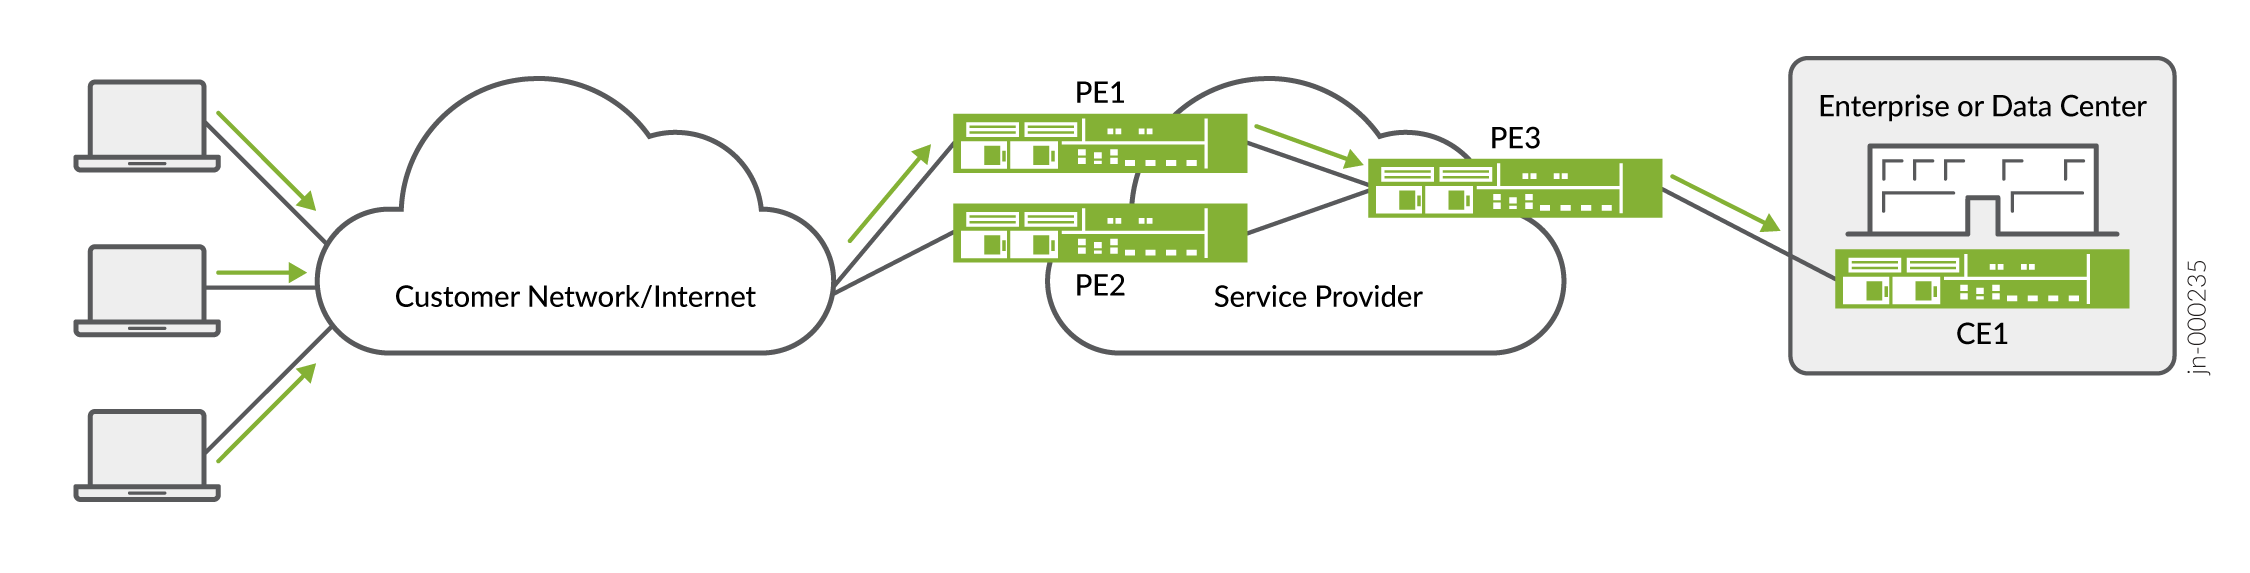
Nessa topologia, uma sessão BGP é configurada entre o provedor de serviços e a rede do cliente empresarial para o BGP FlowSpec. O filtro BGP FlowSpec é aplicado em roteadores PE1 e PE2. Os pacotes que entram nesses roteadores são reescritos com base no filtro BGP FlowSpec e na ação DSCP.
Para habilitar o filtro BGP FlowSpec em um dispositivo, você precisa adicionar a dscp-mapping-classifier declaração de configuração no nível deedit forwarding-options family (inet | inet6) [] hierarquia:
forwarding-options {
    family inet {
        dscp-mapping-classifier ipv4-classifer;
    }
    family inet6 {
        dscp-mapping-classifier ipv6-classifer;
    }
}
A seguinte classe de exemplo de configuração de serviço mapeia o código DSCP aponta para a classe de encaminhamento e prioridade de perda:
class-of-service {
	classifiers {
		dscp dscp1 {
        		forwarding-class best-effort {
            		loss-priority low code-points 000000;
        		}
		}
      }
}
Configuração de políticas para validação de rota de fluxo
Quando a especificação de fluxo é usada para distribuir filtros pela rede para os pontos de emparelhamento, o formato dos filtros de especificação de fluxo é validado na origem. Se você quiser rotas de fluxo de sinal sobre a sessão EBGP para os pares, os filtros de especificação de fluxo devem ser validados nos roteadores de borda.
As políticas podem ser usadas para realizar essa validação adicional de rotas de fluxo. Uma política pode filtrar as condições de correspondência da rota de fluxo para evitar a admissão de rotas de fluxo malformadas, sem suporte ou indesejadas injetadas da origem. Ela também pode impedir que as rotas de fluxo bloqueiem acidentalmente ou maliciosamente as sessões de protocolo.
As políticas podem ser usadas para
-
Verifique se existe uma determinada condição de correspondência/ação de especificação de fluxo
-
Evite programar condições de correspondência inválidas ou indesejadas.
- Configuração de políticas para verificar se existe uma condição de correspondência/ação de especificação de fluxo
- Configuração de políticas para verificar se a especificação de fluxo corresponde a atributos
Configuração de políticas para verificar se existe uma condição de correspondência/ação de especificação de fluxo
Você pode configurar políticas para verificar se uma determinada condição de correspondência/ação de fluxo é anunciada da origem e tomar as medidas necessárias. Cada rota de fluxo tem uma condição de correspondência e uma condição de ação. Configure as instruções a seguir especificando a condição de correspondência e a ação a ser executada se ocorrer uma correspondência.
set policy-options flowspec-attribute <> match condition <>
set policy-options flowspec-attribute < Flow Route action >
Essas configurações de política procuram correspondências exatas ou parciais na rota de fluxo e, quando encontradas, a política corresponderá à rota de fluxo. Se você configurar várias condições de correspondência, a correspondência ocorrerá somente quando todas as condições forem atendidas.
Você pode usar a opção de correspondência 'inverter' para excluir uma determinada condição de correspondência. Por exemplo; Nas declarações de configuração abaixo, a política corresponde às rotas de fluxo 'sem protocolo TCP' e, em seguida, corresponde 'ao valor DSCP 'x'. Se ambas as correspondências forem encontradas, a política aceitará as rotas de fluxo.
set policy-options flowspec-attribute fl1 invert-match protocol value tcp

set policy-options flowspec-attribute fl1 match dscp value <x>

set policy-options policy-statement pl1 term 1 from flowspec-attribute fl1
set policy-options policy-statement pl1 term 1 then accept
Configuração de políticas para verificar se a especificação de fluxo corresponde a atributos
Você pode configurar políticas para verificar se a rota de fluxo corresponde ao valor específico de uma condição de correspondência de fluxo. Isso pode impedir que as rotas de fluxo bloqueiem acidentalmente ou maliciosamente as sessões de protocolo.
Configure a instrução a seguir especificando o valor específico do atributo.
set policy-options flowspec-attribute < match value >
Os atributos de correspondência de política de espectificação de fluxo específicos do IPv4 não afetam as rotas de fluxo IPv6 e vice-versa.
Tabela de histórico de alterações
A compatibilidade com recursos é determinada pela plataforma e versão utilizada. Use o Explorador de recursos para determinar se um recurso é compatível com sua plataforma.
extended-community de tráfego.