ジュニパーRDMA対応ロードバランシング(LB)およびBGP-DPF - GPUバックエンドファブリックIPサービス
このセクションでは、トラフィックの輻輳に対処し、バックエンドGPUファブリック内の負荷分散を最適化するために採用される戦略について説明します。
混雑管理と混雑制御の設定
DCQCN(Data Center Quantized Congestion Notification)アプローチを使用して輻輳管理と輻輳制御が実装され、トラフィックの公平性を確保し、ロスレスファブリック全体の安定性を維持します。
AIクラスターは、頻繁なエレファントフローと最小限のフロー変動を特徴とする、高密度で低エントロピーのトラフィックパターンにより、ネットワークインフラストラクチャに独自の要求を課します。さらに、ほとんどのAIトレーニングワークロードでは、中断のないロスレスパケット配信を正常に完了する必要があります。したがって、AIトラフィックフロー用のネットワークインフラストラクチャを設計する場合、ロスレス運用を確保しながら、スループットの最大化、遅延の最小化、ネットワーク干渉の最小化が主な目的となります。このような要件には、効果的な混雑制御メカニズムの導入が必要です。
DCQCN(Data Center Quantized Congestion Notification) は、 RoCEv2 環境におけるエンドツーエンドの混雑制御のための業界標準的な方法となっています。DCQCNは、パケットのドロップに頼らずに輻輳イベントに応じてトラフィックレートを調整するメカニズムを提供し、トラフィックレートの削減と継続的なトラフィックフローの維持のバランスをとっています。
DCQCNは、主にAIワークロードトラフィックの大部分が存在する GPUバックエンドファブリックで必要であることに注意することが重要です。フロントエンドおよびストレージバックエンドファブリックでは一般的に不要です。
DCQCNは、2つの補完的なメカニズムを組み合わせて、フローと混雑の制御を実装します。
- 優先順位に基づくフロー制御(PFC)
- 明示的輻輳通知(ECN)
優先順位に基づくフロー制御(PFC) は、 IEEE 802.1pの優先度 またはキューにマッピングされた DSCPマーキング に基づいて、特定のトラフィッククラスのトラフィック送信を一時停止することでデータ損失を軽減します。
輻輳が検出されると、PFCは PAUSE制御フレームを アップストリームに送信して動作し、特定の優先度に関連するトラフィックの送信を停止するよう送信側に要求します。送信者は、輻輳が収まるか、PAUSEタイマーが終了するまで、その優先度のトラフィックの送信を完全に停止します。
PFCはパケットのドロップを防ぎ、受信者が追いつくようにしますが、影響を受けるキューを使用するトラフィックのアプリケーションパフォーマンスにも影響を与えます。さらに、一時停止後に送信を再開すると、トラフィックが突然急増し、混雑が再び引き起こされる可能性があります。これらの理由から、PFCは最後のリソースとして使用されるように慎重に設定する必要があります。
ECN(Explicit Congestion Notification) は、事前対応型の混雑シグナリングメカニズムを提供し、伝送レートを下げながら、混雑期間中もトラフィックの流れを継続できるようにします。
輻輳が発生すると、IPヘッダーのECNビットがマーク(11)され、送信元に伝送レートを調節するよう送信元に通知する CNP(Congestion Notification Packet)を生成するよう受信側に促します。PFCとは異なり、ECNはトラフィックを完全に停止したりパケットドロップを引き起こすことなく、輻輳を徐々に緩和することを目指しています。
ベストプラクティス:PFCとECNを組み合わせることで、RoCEv2をサポートするロスレスIPファブリックで最も効果的な輻輳制御戦略を提供します。PFCの前にECNメカニズムがトリガーされるように、それらのパラメーターを慎重に調整する必要があります。
より詳細なガイダンスについては、ジュニパーAIネットワークの混雑制御の概要を参照してください。DCQCN(ECNおよびPFC)混雑制御手法と動的ロードバランシング(DLB)を使用して、AIワークロード用のロスレスファブリックを構築するためのベストプラクティスの概要を説明しています。このドキュメントは、DLRMトレーニングモデルに対する検証に基づいており、ECNしきい値、PFCパラメーター、入力ドロップ、テールドロップを監視および調整して、RoCEv2トラフィックのファブリックパフォーマンスを最適化する方法を示しています。
ジュニパーでは一般的な推奨事項とラボで検証済みのパラメーターを提供していますが、各AIワークロードには異なるトラフィックパターンが示される場合があります。サービス クラス(CoS)とロードバランシングの属性は、特定のモデルやクラスター環境の特定の特性に合わせてさらに調整する必要がある場合があります。
JVD内のこのリーフノードとスパインノードは、最高のパフォーマンスを提供すると判断されたCoSパラメーターで設定されています。
以下の設定は、ファブリック内のすべてのデバイスに統一に適用されます。
トラフィック分類
set class-of-service classifiers dscp fabric-dscp forwarding-class CNP loss-priority low code-points 110000
set class-of-service classifiers dscp fabric-dscp forwarding-class NO-LOSS loss-priority low code-points 011010
set class-of-service interfaces et-* unit * classifiers dscp fabric-dscp
トラフィック分類はDSCPに基づいており、 NO-LOSS と CNP の 2 つの転送クラスを定義する fabric-dscp 分類子を使用して実装されます。この分類子は、すべてのet-*ユニット*論理インターフェイスに適用されます。
DSCP 011010(26)が付いたすべての着信トラフィックは NO-LOSSとして分類され、DSCP 110000(48)でマークされたトラフィックは CNPとして分類されます。すべてのGPUサーバーは、 RoCEv2トラフィック をDSCP 26でマークし、混 雑通知パケット(CNP)を DSCP 48でマークするように設定されています。
NvidiaおよびAMD GPUサーバーでDCQCNパラメーターを設定する方法の詳細については、Juniper Apstra、NVIDIA GPU、およびWEKAストレージJVDを使用したAIデータセンターネットワークの「NVIDIA DCQCN – ECNの設定」セクションと「Juniper Apstra、AMD GPU、およびVast Storage JVDを使用したAIデータセンターネットワーク」の「AMD DCQCNの設定 – ECN」セクションを参照してください。
set class-of-service forwarding-classes class CNP queue-num 3
set class-of-service forwarding-classes class NO-LOSS queue-num 4
set class-of-service forwarding-classes class NO-LOSS no-loss
set class-of-service forwarding-classes class NO-LOSS pfc-priority
CNP トラフィックは出力キュー 3 に割り当てられ、NO-LOSS トラフィックは出力キュー 4 に割り当てられます。
キュー4は、no-loss属性を使用してロスレスとして設定され、PFC優先度3にマッピングされています。キューをロスレスとして定義することで、このクラスにマッピングされたパケットが、RoCEv2の必須要件である混雑によってドロップされることがなくなります。フォワーディングクラスをロスレスとして設定すると、スイッチのバッファ割り当てにも影響が及び、PFCなどのフロー制御メカニズムをサポートするための追加スペースが確保されます。
バッファには2種類あります。
- 共有バッファープール:すべてのポートで動的に共有されるグローバルメモリスペース。これは、ロス トラフィック タイプとロスレス トラフィック タイプに分割されます。共有バッファーが大きいほど、トラフィック バーストの吸収に役立ちます。
- 専用バッファープール:ポートごとに割り当てられるメモリーの予約部分で、そのポートのキューに分割されます。調整することはできますが、システムによって常に最小量が予約されます。専用バッファプールが大きいということは、トラフィックがそれほど多くの共有バッファ領域を使用する必要がないため、あるポートでの輻輳が別のポートのトラフィックに影響を与える可能性が低いことを意味します。専用バッファプールが大きいほど、動的共有バッファメモリが少なくなるため、スイッチが処理できるバースト性トラフィックは低くなります。
このJVDの共有バッファと専用バッファの推奨値を以下に示します。
set class-of-service shared-buffer ingress buffer-partition lossless percent 66
set class-of-service shared-buffer ingress buffer-partition lossless dynamic-threshold 10
set class-of-service shared-buffer ingress buffer-partition lossless-headroom percent 24
set class-of-service shared-buffer ingress buffer-partition lossy percent 10
set class-of-service shared-buffer egress buffer-partition lossless percent 66
set class-of-service shared-buffer egress buffer-partition lossy percent 10
共有バッファー:
- イングレスロスレスパーセント66: イングレス共有バッファー領域の 66% を ロスレストラフィック 用に予約します(例:RoCEv2)。
- イングレス ロスレス ヘッドルーム パーセント 24:特にバースト吸収のためのヘッドルームとして、侵入バッファースペースのさらに24%を切り出します。これにより、PFCポーズフレームが有効になるのを待機している間、RoCEv2フローにマイクロバーストを収容するのに十分なスペースを確保することができます。
- Ingress lossy percent 10: イングレス共有バッファー領域の 10% を 非可損失トラフィック用に確保します。
- イングレスロスレス動的しきい値 10:ロスレスバッファプールを未使用のロスバッファー領域に最大10%動的に拡張できるため、高負荷下でも柔軟性が得られます。
- エグレス ロスレス パーセント 66: エグレス共有バッファー領域の 66% を ロスレス トラフィック用に予約します。
- Egress損失率10:損失が多いトラフィックに10%を割り当てます。
専用バッファ(ポート単位またはキュー単位):
- Ingress percent 15:ingressバッファー容量の 合計の15% を 専用 バッファーとして割り当てます。これらは共有されず、特定のトラフィッククラスまたはポート用に予約されています。
- エグレス割合30:エグレスバッファー領域の 30% を専用用に確保します。
このバッファー領域がいっぱいになり始めると、PFCメカニズムはイーサネットPAUSEフレームをトラフィックソースに送信し、送信を一時的に停止してパケット損失を防ぐように指示します。
トラフィック分類はDSCPベースであり、GPUサーバーとリーフノード間のインターフェイスは タグなしであるため、PFC実装は DSCPベースのPFCです。すべてのet-*インターフェイスに適用されるcongestion-notification-profile pfcは、PFCの動作の詳細を定義します。
set class-of-service interfaces et-* congestion-notification-profile pfc
set class-of-service congestion-notification-profile pfc pfc-watchdog
set class-of-service congestion-notification-profile pfc input dscp code-point 011010 pfc
set class-of-service congestion-notification-profile pfc output ieee-802.1 code-point 011 flow-control-queue 4
Congestion-notification-profileは、ECN(Congestion Notification Packets)に関連するものとして解釈される場合があります。Congestion-notification-profileは、一部のドキュメントではCNPと略されることもできます。ただし、このプロファイルはECNではなくPFCの動作を定義します。
PFCウォッチドッグ機能は、永続的なPFCの一時停止状態によって引き起こされるデッドロックまたはスタックキューを監視します。キューが長時間一時停止されたままになる場合(ヘッドオブラインブロックの可能性を示す)、ウォッチドッグはトラフィックの停滞状態を回避するために是正措置を講じることができます。
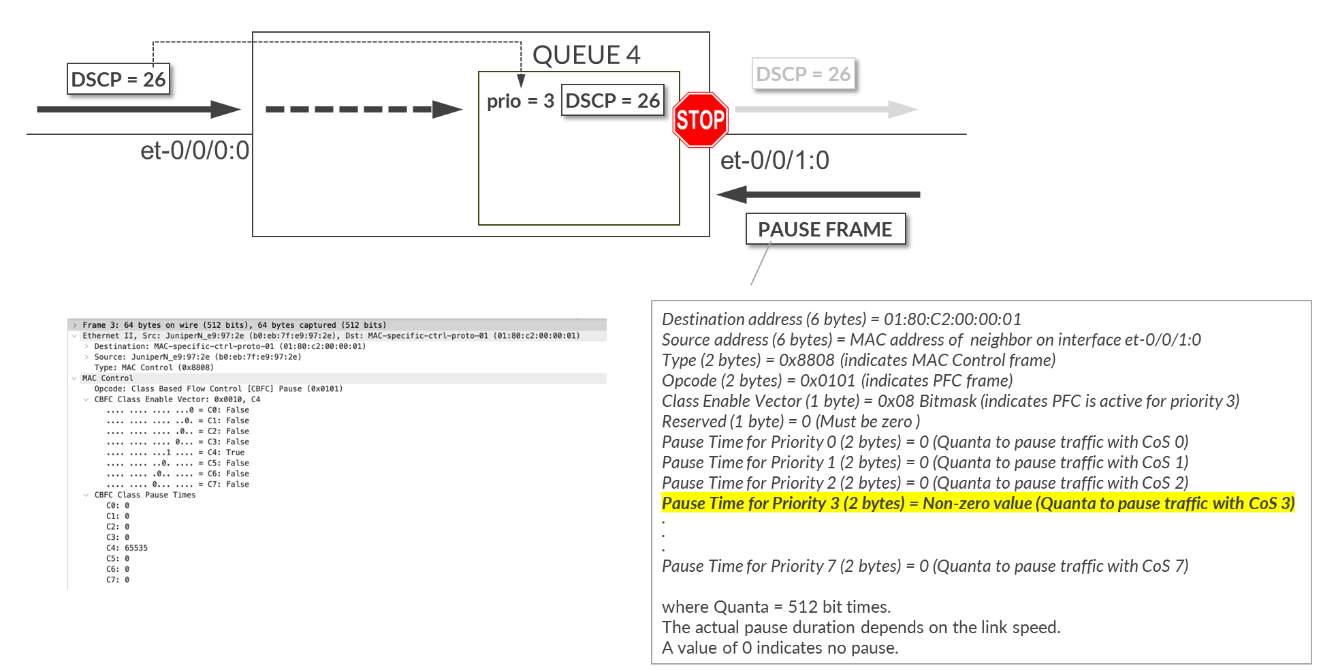
入力dscp コードポイント 011010 pfc ステートメントは、DSCP 値 011010(10 進数 26)でマークされた着信トラフィックが輻輳を検出したときに PFC をトリガーすることを指定します。基本的に、DSCP 26(RoCEv2)トラフィックに輻輳が発生している場合、プライオリティ 3 の PFC フレームが生成され、アップストリーム送信者(PFC プライオリティ 3 はコード ポイント 26 にマッピング)を一時停止します。一時停止フレームは、前述の転送クラスのNO-LOS設定に基づいて、優先度3に対して生成されます。
以下の例では:
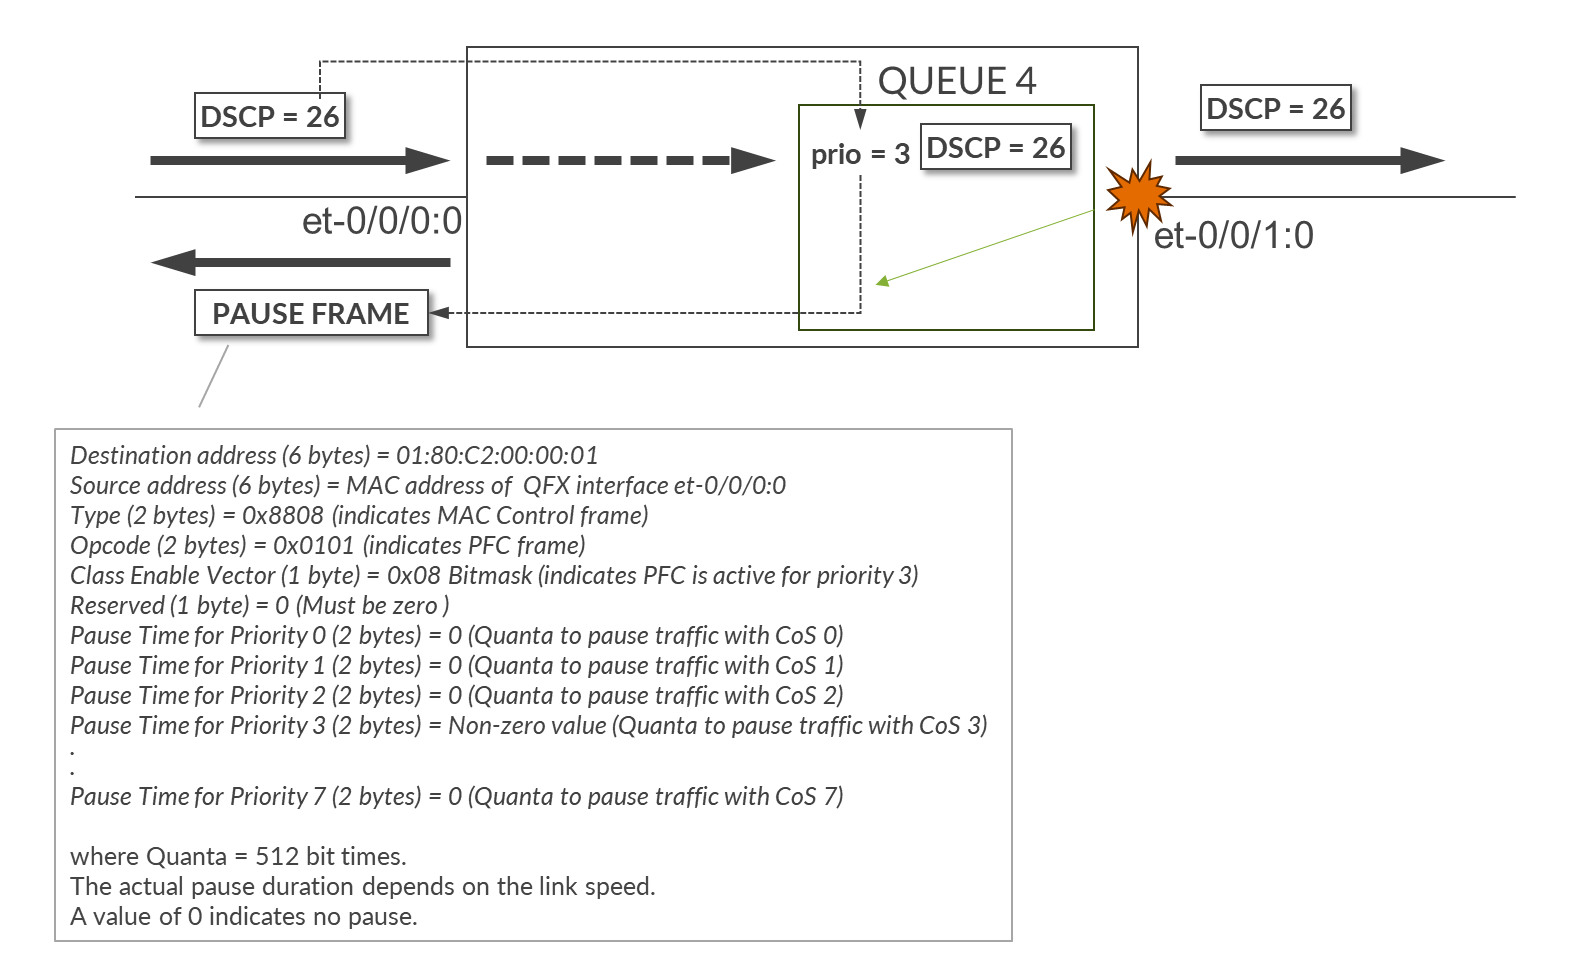
インターフェイス et-0/0/0:0 と et-0/0/1:0 に適用された以下のコマンドの組み合わせにより、DSCP 26 を持つすべてのインバウンド トラフィックを、キュー 4 に割り当てられ、pfc-priority 3 にマッピングされた転送クラス NO-LOSS に分類するようにデバイスが設定され、キュー 4 を無損失キューにし、DSCP 26 のトラフィックに対して PFC が有効になります。
set class-of-service classifiers dscp fabric-dscp forwarding-class NO-LOSS loss-priority low code-points 011010
set class-of-service forwarding-classes class NO-LOSS queue-num 4
set class-of-service forwarding-classes class NO-LOSS no-loss
set class-of-service forwarding-classes class NO-LOSS pfc-priority 3
set class-of-service congestion-notification-profile pfc input dscp code-point 011010 pfc
出力ieee-802.1コードポイント011 flow-control-queue 4ステートメントは、優先度3の一時停止フレームを受信した場合に、キュー4のトラフィックを停止する必要があることを指定します。
トラフィックのスケジューリング
set class-of-service interfaces et-* scheduler-map sm1
set class-of-service scheduler-maps sm1 forwarding-class CNP scheduler s2-cnp
set class-of-service scheduler-maps sm1 forwarding-class NO-LOSS scheduler s1
スケジューラマップsm1は、すべてのet-*インターフェイスに適用され、各転送クラスのトラフィックをどのようにスケジューリングするかを定義します。
2つの スケジューラ が含まれています。
- NO-LOSSトラフィックのs1(キュー4)
- CNPトラフィック用s2-cnp(キュー3)
NO-LOSS トラフィック スケジューリング(スケジューラ s1)
set class-of-service schedulers s1 drop-profile-map loss-priority any protocol any drop-profile dp1
set class-of-service schedulers s1 explicit-congestion-notification
set class-of-service drop-profiles dp1 interpolate fill-level 55
set class-of-service drop-profiles dp1 interpolate fill-level 90
set class-of-service drop-profiles dp1 interpolate drop-probability 0
set class-of-service drop-profiles dp1 interpolate drop-probability 100
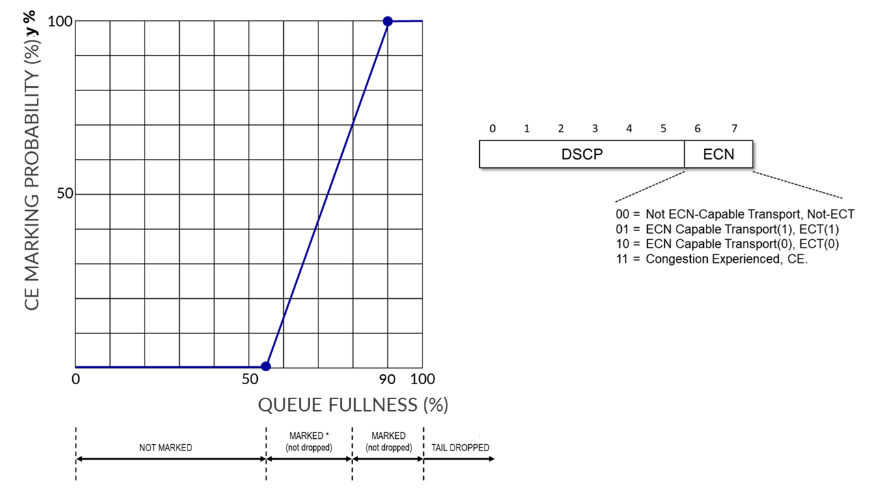
スケジューラ s1 は、NO-LOSS 転送クラス(キュー 4)内のトラフィックの処理方法を制御します。ドロッププロファイルdp1を適用し、explicit-congestion-notificationステートメントを使用してExplicit Congestion Notification(ECN)マーキングを有効にします。
Junosのドロッププロファイルは、キューバッファがいっぱいになったときにパケットをどれだけ積極的にドロップするかを制御するために一般的に使用されます。ただし、ECNが有効な場合、プロファイルはパケットをドロップするのではなく、マークするために使用されます。パケットをマーキングするということは、設定されたしきい値に基づいてIPヘッダーに混雑経験値(CE)ビットを設定することを意味します。
 例
プロファイルdp1は、線形ドロップカーブを定義します。
- バッファー が55%充填されると、パケットは マークされません (確率0%)。
- バッファーが90%満たされると、一致するすべてのパケットがマークされます(100%の確率)。
- 55%から90%の間で、マーキング確率は0%から100%に 直線的に増加します 。
このアプローチにより、ロスレス配信を維持しながら、RoCEv2エンドポイントへの輻輳の早期フィードバックが保証されます。
CNPトラフィックスケジューリング(スケジューラs2-cnp)
スケジューラ s2-cnp は、キュー 3 の CNP トラフィックの処理方法を指定します。キューに 絶対に高い優先度 を割り当て、インターフェイス帯域幅の 5% を予約します。
set class-of-service schedulers s2-cnp transmit-rate percent 5
set class-of-service schedulers s2-cnp priority strict-high
最小帯域幅とともに厳密に高い優先度を割り当てることで、輻輳時にDCQCNのソースベースのレート削減をトリガーするために必要な輻輳通知パケット(CNP)をファブリック全体に確実に送信できるようになります。
優先度が最も高いキューは、優先度の低いトラフィックを枯渇させる可能性がある他の優先度の高いキューを除き、常に他のキューよりも先に処理されます。ただし、 CNP トラフィックの量は一般に非常に少ないため、この場合の飢餓のリスクは最小限に抑えられます。したがって、このキューを レート制限する必要はありません 。
混雑管理と混雑制御検証
show class-of-service interface <interface>コマンドは、スケジューラマップ、輻輳通知が有効になっているかどうか、プロファイル名、インターフェイスに適用されている分類子を表示します。
jnpr@stripe1-leaf2> show class-of-service interface et-0/0/0:0
Physical interface: et-0/0/0:0, Index: 1292
Maximum usable queues: 12, Queues in use: 5
Exclude aggregate overhead bytes: disabled
Logical interface aggregate statistics: disabled
  Scheduler map: sm1
  Congestion-notification: Enabled, Name: cnp, Index: 1

  Logical interface: et-0/0/0:0.0, Index: 1256
Object                  Name                   Type                    Index
Classifier              fabric-dscp            dscp                        5
show class-of-service classifier <classifier-name>コマンドは、DSCP値と転送クラス間のマッピングを示し、正しい割り当てを確認するために使用できます(CNP => 48、およびNO-LOSS => 26)
jnpr@stripe1-leaf2> show class-of-service classifier name fabric-dscp
Classifier: fabric-dscp, Code point type: dscp, Index: 5
  Code point         Forwarding class                    Loss priority
  011010             NO-LOSS                             low
  110000             CNP                                 low
show class-of-service forwarding-classコマンドの出力は、転送クラスからキューへのマッピングを示しています。正しいマッピング(CNP => キュー 3、および NO-LOSS => キュー 4)、および NO-LOSS キューの No-loss ステータスと PFC 優先度を確認するために使用できます。
jnpr@stripe1-leaf2> show class-of-service forwarding-class
Forwarding class                       ID      Queue  Policing priority  No-Loss   PFC priority
  CNP                                  1         3         normal        disabled       0
  NO-LOSS                              2         4         normal        enabled        3
  best-effort                          0         0         normal        disabled       0
  mcast                                8         8         normal        disabled       0
  network-control                      3         7         normal        disabled       0
show class-of-service scheduler-map sm1コマンドの出力には、スケジューラマップsm1、スケジューラs1、s2-cnpとその優先度、割り当てレート、ECNが有効なかどうかが表示されます。
jnpr@spine1> show class-of-service scheduler-map sm1
 Scheduler map: sm1, Index: 2

  Scheduler: s2-cnp, Forwarding class: CNP, Index: 7
    Transmit rate: 5 percent, Rate Limit: none, Buffer size: unspecified, Buffer Limit: none, Buffer dynamic threshold:
    unspecified,
    Priority: strict-high
    Excess Priority: unspecified, Excess rate: unspecified, Explicit Congestion Notification: disable, ECN pfc no assist:
    disable
    Drop profiles:
      Loss priority   Protocol    Index    Name
      Low             any             0    default-drop-profile
      Medium high     any             0    default-drop-profile
      High            any             0    default-drop-profile


  Scheduler: s1, Forwarding class: NO-LOSS, Index: 6
    Transmit rate: unspecified, Rate Limit: none, Buffer size: unspecified, Buffer Limit: none, Buffer dynamic threshold:
    unspecified,
    Priority: low
    Excess Priority: unspecified, Excess rate: unspecified, Explicit Congestion Notification: enable, ECN pfc no assist: mark
    Drop profiles:
      Loss priority   Protocol    Index    Name
      Low             any             0    dp1
      Medium high     any             0    dp1
      High            any             0    dp1
show interfaces queue <interface>コマンドをさまざまなオプションや出力フィルターと組み合わせることで、パケットドロップ、ECNマーキング、PFCフレームの一時停止があったかどうかを判断できます。
jnpr@stripe1-leaf2> show interfaces queue et-0/0/0:0 forwarding-class CNP
Physical interface: et-0/0/0:0, up, Physical link is Up
  Interface index: 1292, SNMP ifIndex: 703
   Description: facing_spine1:et-0/0/1:0
Forwarding classes: 12 supported, 5 in use
Egress queues: 12 supported, 5 in use
Queue: 3, Forwarding classes: CNP
  Queued:
   Packets              : 	0	0 pps
   Bytes                : 	0	0 bps
  Transmitted:
    Packets              : 	0	0 pps
    Bytes                : 	0	0 bps
    Tail-dropped packets :  	0	0 pps
    Tail-dropped bytes   : 	0	0 bps
    RED-dropped packets  : 	0	0 pps
    RED-dropped bytes    : 	0	0 bps
    ECN-CE packets       :	0	0 pps
    ECN-CE bytes         :	0	0 bps
出力は、キューに入れられたCNPパケット(DSCP 48)の数を示しています。この値の増加は、パスに沿って輻輳が検出され、受信者が CE = 1 のパケットに応答して CNP パケットを送信していることを示します。
jnpr@stripe1-leaf2> show interfaces queue et-0/0/0:0 forwarding-class NO-LOSS
Physical interface: et-0/0/0:0, up, Physical link is Up
  Interface index: 1292, SNMP ifIndex: 703
  Description: facing_spine1:et-0/0/1:0
Forwarding classes: 12 supported, 5 in use
Egress queues: 12 supported, 5 in use
Queue: 4, Forwarding classes: NO-LOSS
  Queued:
    Packets              :            1375227202      	0 pps
    Bytes                :         4236817861328      	0 bps
  Transmitted:
    Packets              :            1375227202       	0 pps
    Bytes                :         4236817861328      	0 bps
    Tail-dropped packets :                     0       	0 pps
    Tail-dropped bytes   :                     0        	0 bps
    RED-dropped packets  :                     0     	0 pps
    RED-dropped bytes    :                     0        	0 bps

    ECN-CE packets       :                     0                0 pps
    ECN-CE bytes         :                     0                0 bps
出力は、CE=1 でマークされた NO-LOSS パケット(DSCP = 26)の数を示しています。この数値が増加している場合は、輻輳が検出されたことを示しています。
jnpr@stripe1-leaf2> show interfaces et-0/0/0:0 extensive | match ecn
    Resource errors: 0, ECN Marked packets: 0
出力は、インターフェイス et-0/0/0:0 で確認された、CE=1 でマークされたパケットの数を示しています。
jnpr@stripe1-leaf2> show interfaces et-0/0/0:0 extensive | find "MAC Priority Flow Control Statistics"
    MAC Priority Flow Control Statistics:
    Priority :  0        0                0
    Priority :  1        0                0
    Priority :  2        0                0
    Priority :  3        0                0
    Priority :  4        0                0
    Priority :  5        0                0
    Priority :  6        0                0
    Priority :  7        0                0
出力は、インターフェイス et-0/0/0:0 で優先度ごとに送受信された PFC 一時停止フレームの数を示しています。
jnpr@stripe1-leaf2> show interfaces et-0/0/0:0 extensive | find "  CoS information:"
  CoS information:
    Direction : Output
    CoS transmit queue
                Bandwidth		Buffer          Priority	Limit
                %	bps	      %	      usec
      3 CNP      5	20000000000   r 	0 	strict-high	none
      4 NO-LOSS  r 	r     	      r 	0       low    	        none
出力は、インターフェイスet-0/0/0:0の転送クラスCNPおよびNO-LOSの帯域幅割り当て、送信レート、キュー優先度を示しています。
jnpr@stripe1-leaf2> show interfaces queue buffer-occupancy et-0/0/0:0
Physical interface: et-0/0/0:0, Enabled, Physical link is Up
  Interface index: 1292, SNMP ifIndex: 703
Forwarding classes: 12 supported, 5 in use
Egress queues: 12 supported, 5 in use
            Queue: 0, Forwarding classes: best-effort
                Queue-depth bytes  :
                Peak               : 0
            Queue: 3, Forwarding classes: CNP
                Queue-depth bytes  :
                Peak               : 0
            Queue: 4, Forwarding classes: NO-LOSS
                Queue-depth bytes  :
                Peak               : 0
            Queue: 7, Forwarding classes: network-control
                Queue-depth bytes  :
                Peak               : 254
            Queue: 8, Forwarding classes: mcast
                Queue-depth bytes  :
                Peak               : 0
出力は、インターフェイス et-0/0/0:0 上の各キューのピーク キュー占有率を示しています。
jnpr@stripe1-leaf2> show class-of-service shared-buffer
Ingress:
  Total Buffer     :  169207 KB
  Dedicated Buffer :  4627 KB
  Shared Buffer    :  143472 KB
    Lossless                   :  94691 KB
    Lossless Headroom          :  34432 KB
    Lossy                      :  14347 KB
    Lossless dynamic threshold :  10
    Lossy dynamic threshold    :  10

  Lossless Headroom Utilization:
  Node Device         Total          Used                  Free
  0                   34432 KB       29235 KB              5197 KB

  ITM0 Headroom Utilization:
  Total           Used            Free
  17216 KB        15260 KB        1956 KB

  ITM1 Headroom Utilization:
  Total           Used            Free
  17216 KB        13975 KB        3241 KB

Egress:
  Total Buffer     :  169207 KB
  Dedicated Buffer :  14162 KB
  Shared Buffer    :  143472 KB
    Lossless                 :  94691 KB
    Lossy                    :  14347 KB
    Lossy dynamic threshold  :  7
出力は、システムバッファの割り当てを示しています。
ジュニパー ITM(Ingress Traffic Manager) は、パケットのバッファリングとキューを管理するコンポーネントです。
負荷分散障害シナリオ – DLBへのフォールバック
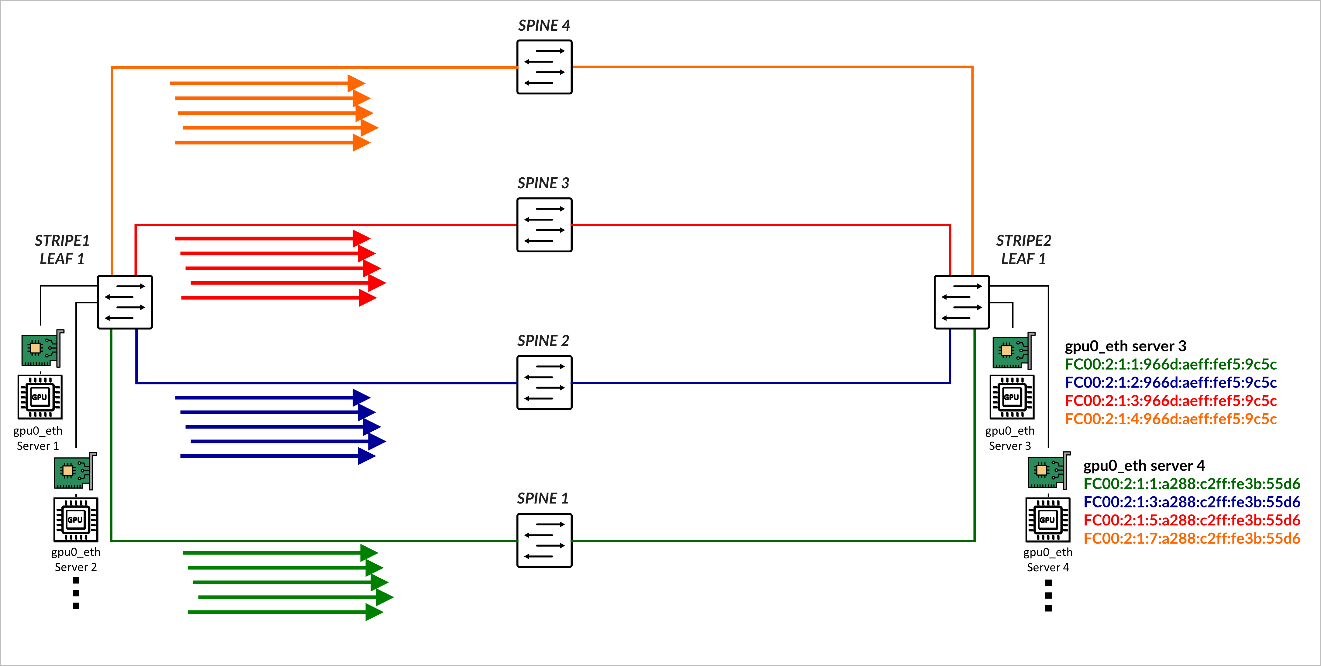
このドキュメントで説明されているRDMA対応ロードバランシングは主要なロードバランシングソリューションですが、リンクまたはスイッチに障害が発生すると、トラフィックはバックアップECMPマルチパスにフォールバックし、ECMPの決定にDLBを活用します。例として、4つのスパインが存在し、4つの色が設定されているシナリオを考えてみましょう。
set policy-options community blue members color:0:2
set policy-options community color-all members color:0:*
set policy-options community green members color:0:1
set policy-options community orange members color:0:4
set policy-options community red members color:0:3
set protocols bgp fabric-advertise route fc00:1:1:1::/64 color green
set protocols bgp fabric-advertise route fc00:1:1:1::/64 backup-color all-colors
set protocols bgp fabric-advertise route fc00:1:1:2::/64 color blue
set protocols bgp fabric-advertise route fc00:1:1:2::/64 backup-color all-colors
set protocols bgp fabric-advertise route fc00:1:1:3::/64 color red
set protocols bgp fabric-advertise route fc00:1:1:3::/64 backup-color all-colors
set protocols bgp fabric-advertise route fc00:1:1:4::/64 color orange
set protocols bgp fabric-advertise route fc00:1:1:4::/64 backup-color all-colors
set protocols bgp group spine1 fabric-color green
set protocols bgp group spine2 fabric-color blue
set protocols bgp group spine3 fabric-color red
set protocols bgp group spine4 fabric-color orange
その結果、トラフィックは優先パスを経由して転送されます。
| カラー | 優先パス | バックアップ パス |
|---|---|---|
| 緑色 | スパイン1 | スパイン2、スパイン3、スパイン4 |
| 青 | スパイン2 | スパイン1、スパイン3、スパイン4 |
| 赤 | スパイン3 | スパイン1、スパイン2、スパイン4 |
| オレンジ色 | スパイン4 | スパイン1、スパイン2、スパイン3 |
Stripe 1 Leaf 1とSPINE 4の間のリンクに障害が発生した場合、オレンジ色のトラフィックはバックアップパスを介して再ルーティングされます。負荷はDLBに基づいて分散されます。
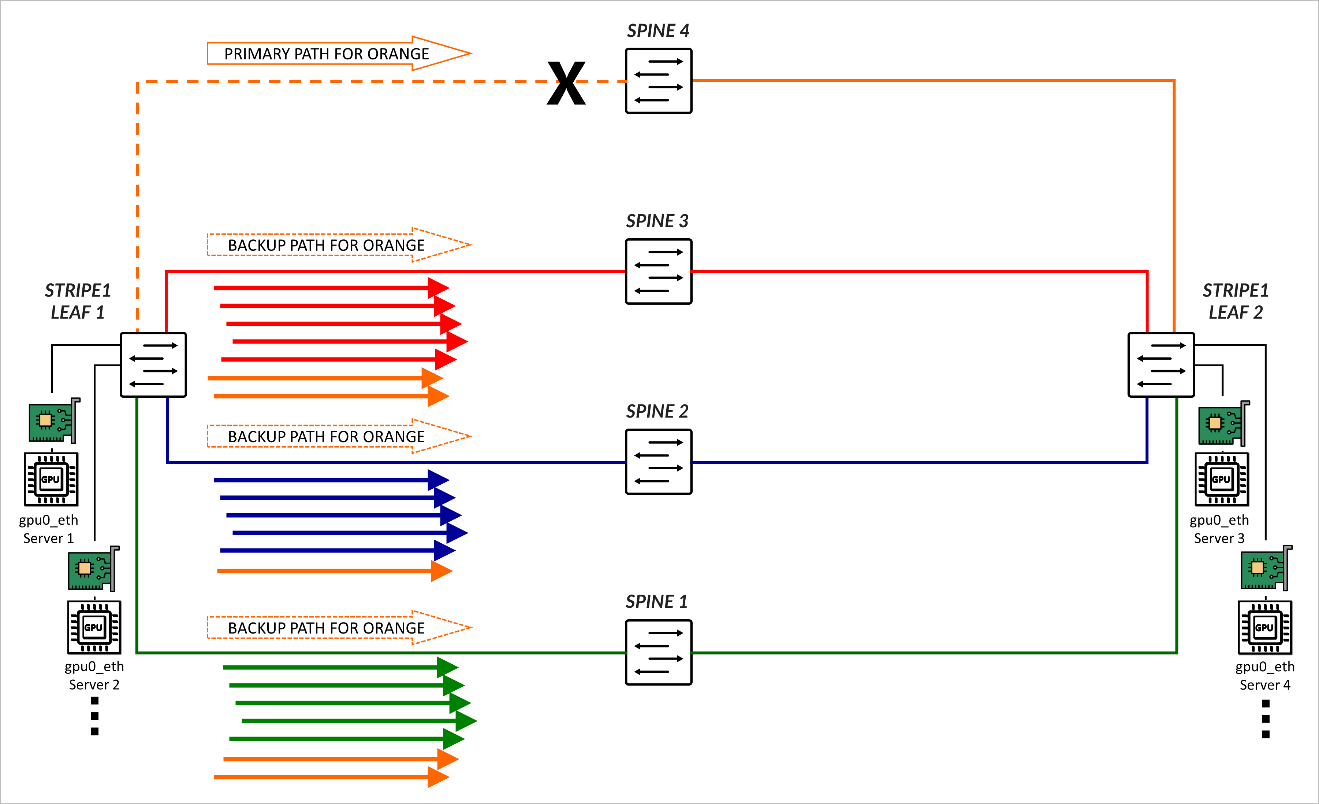 後のバックアップパス間のトラフィックフォワーディング
ダイナミックロードバランシング(DLB)
DLB(動的ロードバランシング)は、パケットヘッダーを確認するだけでなく、パスを選択する際にポート負荷(リンク使用率)とポートキューの深さに基づいてリアルタイムのリンク品質を考慮することで、すべてのパスがより公平に利用されるようにします。この方法では、大量のデータを移動する複数の長時間のフローでロードバランシングする必要がある場合に、より良い結果が得られます。
DLBは、2種類のモードで設定できます。
- パケットごとモード: 同じフローからのパケットは、IP ECMP グループのリンク メンバー間にスプレーされ、パケットの順不同に到着することがあります。
- フローレットモード:同じフローからのパケットは、IP ECMPグループのリンクメンバーを介して送信されます。フローレットは、非アクティブ期間で区切られた同じフローのバーストとして定義されます。設定された非アクティブタイマーよりも長くフローが一時停止した場合、リンクメンバーの品質を再評価し、フローを別のリンクに再割り当てすることができます。
このJVDでは、リーフノードとスパインノードの両方が、IPv4とIPv6トラフィックの両方に適用される 動的ロードバランシングフローレットモードを使用してトラフィックをロードバランシングするように設定されています。
詳細については、「 データセンターのロードバランシング」 を参照してください。このページでは、さまざまなロードバランシングメカニズムと、データセンターのニーズに合わせて進化した方法について包括的に詳しく解説しています。
以下の例は、すべてのデバイスに適用された設定を示しています。
jnpr@gpu-backend-rack1-001-leaf2> show configuration forwarding-options | display set
set forwarding-options hash-key family inet layer-3
set forwarding-options hash-key family inet layer-4
set forwarding-options enhanced-hash-key ecmp-dlb flowlet inactivity-interval 128
set forwarding-options enhanced-hash-key ecmp-dlb flowlet flowset-table-size 2048
set forwarding-options enhanced-hash-key ecmp-dlb ether-type ipv4
set forwarding-options enhanced-hash-key ecmp-dlb ether-type ipv6
set forwarding-options enhanced-hash-key ecmp-dlb sampling-rate 1000000
この設定では、リアルタイムの輻輳とフロー特性に基づいて、フローを識別する方法と、代替ECMPパスに再割り当てする条件を定義します。
hash-key family inet layer-3 および hash-key family inet layer-4 ステートメントは、IPアドレスとTCP/UDPポートの両方を含むようにECMPハッシュ機能を設定し、ECMPパス全体にIPv4フローをきめ細かく分散させます。
enhanced-hash-keyのパラメーターは、ECMPトラフィック転送用のDLBハッシュアルゴリズムを変更し、フローレットベースの検出とインテリジェントな再割り当てを可能にします。それらには次のものが含まれます。
ecmp-dlb flowlet inactivity-interval
フローレット間の境界を検出するために使用する最小パケット間ギャップ(マイクロ秒単位)を指定します。このしきい値を超えると、新しいフローレットが認識されます。
推奨値は128μsecです。
ecmp-dlb flowset-table-size
DLBハッシュテーブルに格納できるフローセット(マクロフロー)エントリーの最大数を定義します。これにより、デバイスが動的な再割り当てのために追跡できるアクティブなフローの数が制御されます。この値は 8 の倍数である必要があります。
推奨値は2048です。
sampling rate:
QFX転送ASICを設定して輻輳を検出するためのサンプリングレートを定義し、egress ECMPメンバーのポート負荷をサンプリングし、品質スコアを更新します。
推奨値は1,000,000です。これは、オーバーヘッドと応答性のバランスを取って、100万パケットに1パケットがサンプリングされることを意味します。
ether-type ipv4およびether-type ipv6:
IPv4 と IPv6 の両方のパケットで拡張 ECMP DLB を有効にします
負荷分散の検証
現在使用中のDLBパラメーターを確認するには、次の操作コマンドを使用します: show forwarding-options enhanced-hash-key 。出力は、フローレットの動作を含む、ECMP DLB(動的ロードバランシング)にシステムによって適用される値を示しています。
jnpr@stripe1-leaf1> show forwarding-options enhanced-hash-key

Current RTAG7 Settings
-------------------------
   Hash-Mode                 :layer2-payload
   Hash-Seed                 :112443776

inet  RTAG7 settings:
----------------------
inet packet fields
  protocol                  :yes
  Destination IPv4 Addr     :yes
  Source IPv4 Addr          :yes
  destination L4 Port       :yes
  Source L4 Port            :yes
  Vlan id                   :no
  RDMA Queue Pair           :yes
inet non-packet fields
  incoming port             :yes

inet6  RTAG7 settings:
----------------------
inet6 packet fields
  next-header               :yes
  Destination IPv6 Addr     :yes
  Source IPv6 Addr          :yes
  destination L4 Port       :yes
  Source L4 Port            :yes
  Vlan id                   :no
  RDMA Queue Pair           :yes
inet6 non-packet fields
  incoming port             :yes

Hash-Parameter Settings for ECMP:
------------------------------------
  Hash Function   = CRC16_BISYNC
  Hash offset base = 16
  Hash offset     = 5
  Hash preprocess = 0

Hash-Parameter Settings for LAG:
------------------------------------
  Hash Function   = CRC16_CCITT
  Hash offset base = 0
  Hash offset     = 5
  Hash preprocess = 0

Ecmp Resilient Hash   = Disabled

ECMP DLB Load Balancing Options:
---------------------------------------------------
  Load Balancing Method              : Flowlet
  Inactivity Interval                : 128 (us)
  Flowset Table size                 : 2048 (entries per ECMP)
  Reassignment Probability Threshold : 0
  Reassignment Quality Delta         : 0
  Egress Port Load Weight            : 50
  EgressBytes Min Threshold          : 10
  EgressBytes Max Threshold          : 50
  Sampling Rate                      : 1000000
  Ether Type                         : Ipv4 Ipv6
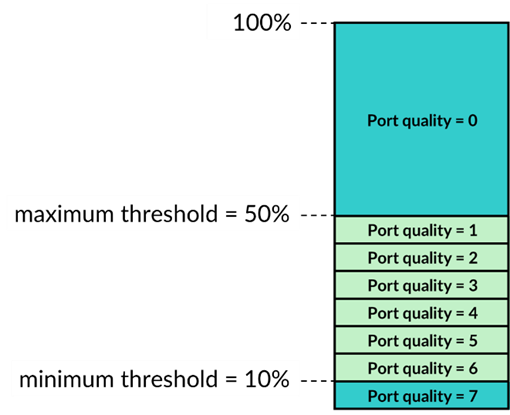
出力に表示されるエ グレスポート負荷の重み は、 ポート品質 スコアを計算する際にポート負荷とポートキューの長さに与えられる重みを定義します。 EgressBytes Min および EgressBytes Max Thresholdsは、 品質帯域を定義します。DLBは、ポート負荷がこの最小値を下回るエグレスポートを最高品質バンド(7)に割り当てます。最大しきい値よりも大きいポート負荷は、最低品質帯域(0)に分類されます。DLBは、残りのポート負荷量を品質バンド1から6に分割します。
デフォルト値の エグレスポート負荷重 み(50)、 エグレスバイト最小 しきい値(10)、 エグレスバイト最大しきい値(50 )を維持することをお勧めします。これらの値を使用するための設定は必要ありません。