
このページの内容
GPUハードウェアトラフィック監視プローブ
導入
GPUハードウェアトラフィック監視プローブは、GPU NICインターフェイス上の重要なRDMA over Converged Ethernet(RoCEv2)カウンターを監視し、輻輳などのトラフィック管理の問題を特定するのに役立つように設計されています。プローブは、AIワークロードのパフォーマンスとダウンタイムに影響を与える重要なネットワークパフォーマンスメトリックを監視します。
このプローブは、リモートダイレクトメモリアクセス(RDMA)環境におけるGPUネットワークパフォーマンスの重要な指標であるOut of Sequence(OOS)パケットとCongestion Notification Packets(CNP)を監視することで輻輳を検出します。これらの状態を監視することで、データ破損、エラー、パフォーマンスの問題など、NVIDIA GPU NIC の輻輳の問題を迅速に特定して解決し、最適なネットワーク パフォーマンスを確保し、ダウンタイムを削減できます。
プローブの概要
GPUハードウェアトラフィック監視プローブは、NVIDIA GPU NICから直接データを収集して分析します。プローブは以下を注意深く監視します。
-
Out of Sequence(OOS)パケット:検出および受信されたOOSパケットの両方。OOSパケットは、送信された順序とは異なる順序で到着するパケットです。これは通常、ファブリックのロードバランシングポリシーがNICに対してあまりにも積極的に設定されていることが原因です。ほとんどの標準NICはパケットを順番に表示することを想定するため、パケットの順序が外れていると遅延やパフォーマンスの問題が発生する可能性があります。一部の新しいNICは並べ替えに対応できます。積極的なロードバランシングポリシーは、特に並べ替えができないデバイスでOOSパケットが発生する可能性を高めます。ロードバランシング設定がOOSパケットを引き起こし、ネットワークパフォーマンスに影響を与える可能性がある場合は、ユーザーに警告することが重要です。
-
Congestion Notification Packets(CNP):CNPは、トラフィックの速度を落とす必要があるときに信号を送ることで、ネットワークの混雑の管理に役立ちます。ネットワークデバイスは、輻輳しきい値(通常は約55%)に近いトラフィックを検出すると、特定のパケットにECN(明示的輻輳通知)をマークします。これらのマークされたパケットはGPUサーバーなどの宛先に到達し、次にCNPパケットを元の送信者(別のGPUノードなど)に送り返します。送信者がこのCNPを受信すると、混雑を最小限に抑えるためにスループットが50%削減されます。
このプローブは、MLX5 Linux ハードウェア カウンターを 30 個収集することで機能します。これらのカウンターは、イーサネットとInfiniBandの両方を介したRDMAトラフィックに関連しています。これらのハードウェアレベルのカウンターは、特にRDMA over Converged Ethernet version 2(ROCEv2)などのRDMAテクノロジーを使用するワークロードにおいて、標準的なネットワーク監視ツールでは捉えることができないネットワーク状態を可視化します。
これらのカウンターの詳細については、「 mlx5 Linux カウンターとステータス パラメーターについて」を参照してください。
AI データセンターの RDMA と ROCEv2 の詳細については、「 イーサネットでの AI/ML データ センターネットワーク」を参照してください。
プローブによって収集されたデータはデフォルトで14日間保存され、リアルタイムの監視と過去の傾向分析が可能になります。
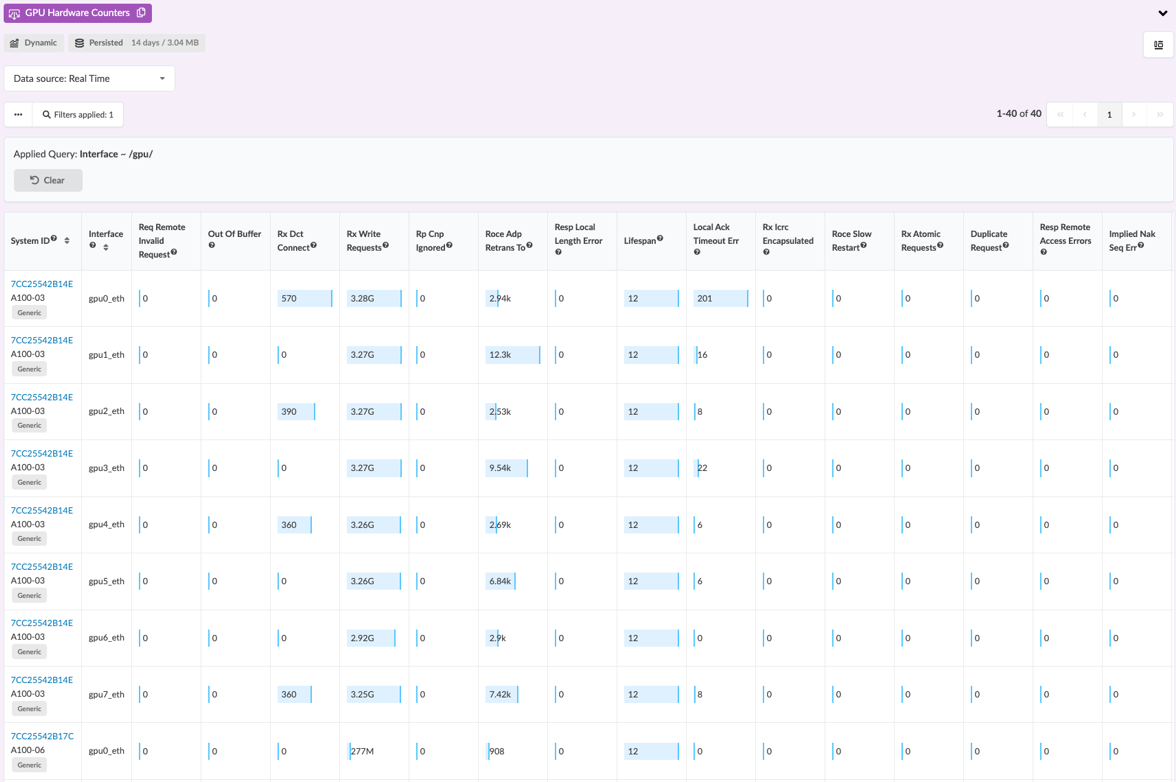
GPUハードウェアカウンター
GPUハードウェアトラフィック監視プローブは、NVIDIA MLX5ハードウェアカウンターを監視する以下のテレメトリサービスを使用します。
- Gpu_Hardware_Counters サービス: このサービスは、こちらの公式ドキュメントで定義されている次のメトリックを注意深く監視します。 mlx5 Linux カウンターとステータス パラメーターについて。
- packet_seq_err
- out_of_sequence
- np_cnp_sent
- rp_cnp_handled
- out_of_buffer
-
Gpu_Infiniband_Dev_To_Interfaceサービス: このサービスは、GPUハードウェアカウンターを関連するInfinibandインターフェイスにマッピングします。CPUやメモリ使用率などのカウンター情報をGPU NICメトリックと関連付けます。
プローブ設定
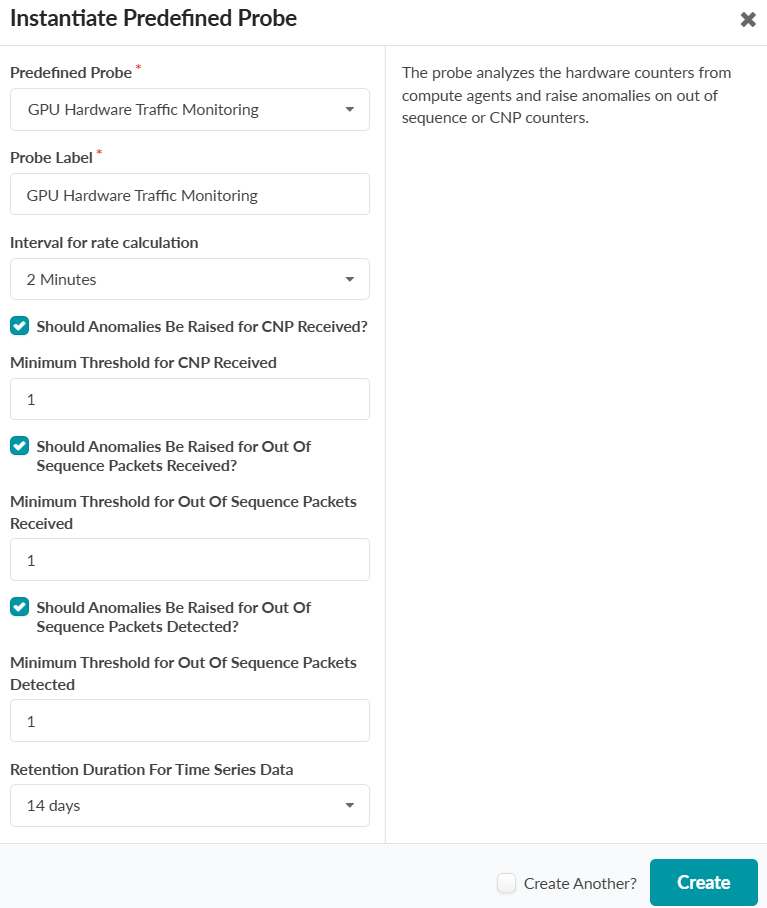
|
設定 |
説明 |
|---|---|
|
プローブラベル |
プローブの名前 |
|
レート計算の間隔 |
サンプリング間隔。デフォルト値は2分です。 |
|
受信したCNPに異常を報告する必要がありますか? |
有効にすると、CNPしきい値を超えたときにプローブがアラートを発生させます |
|
CNP受信の最小しきい値 |
異常アラートをトリガーするCNPの最小数。デフォルト値は1です。 |
|
受信したOut Of Sequenceパケットの異常検知 |
有効にすると、プローブは受信側で順序外のパケットに対してアラートを発します |
|
受信した順序外パケットの最小しきい値 |
受信側でOOSパケットのアラートをトリガーするための最小しきい値カウントを設定します。デフォルト値は1です。 |
|
順序外のパケットが検出された場合、異常を発生させる必要がありますか? |
有効にすると、プローブは検出されたOOSパケットに対してアラートを発生させます |
|
検出された順序外パケットの最小しきい値 |
OOSパケット検出アラートをトリガーするための最小カウントしきい値。デフォルト値は1です。 |
|
時系列データの保持期間 |
システムが履歴データを保存する期間。デフォルト値は14日です。 |
GPU監視ダッシュボード
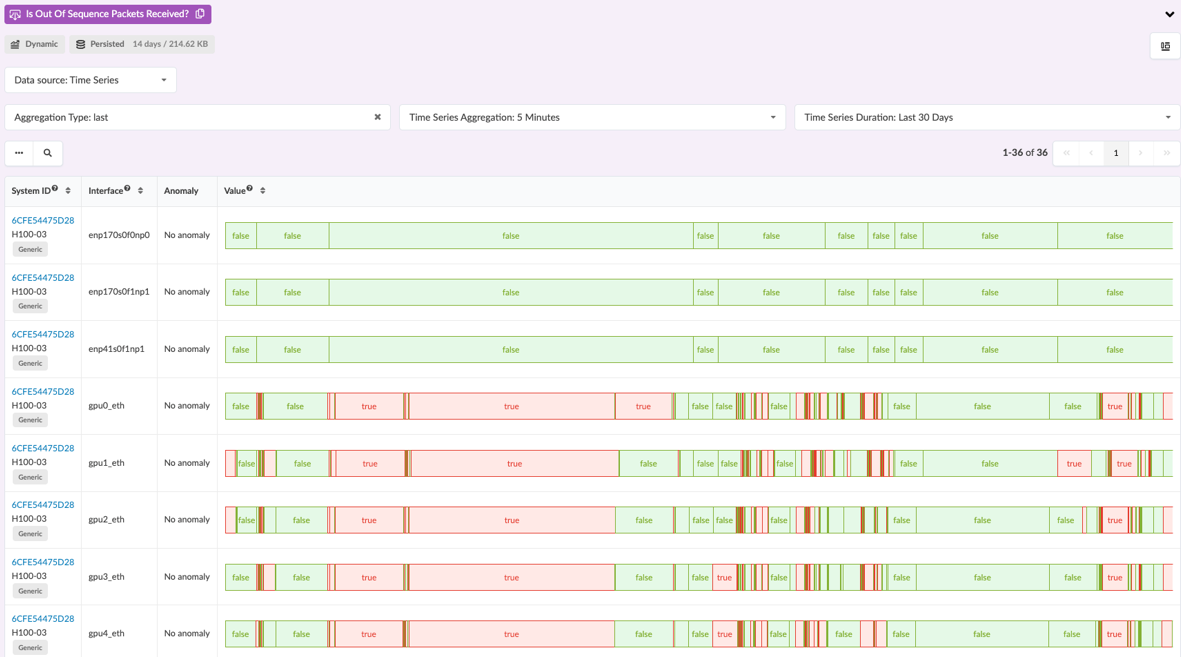
GPU監視ダッシュボードは、GPU NICトラフィック管理の健全性と統計を直感的に表示する方法を提供します。ダッシュボードには、リアルタイムおよび過去のGPU NICメトリックが視覚化されます。特定のGPUインターフェイスにドリルダウンして、詳細を確認できます。
ダッシュボードは、 分析 > ダッシュボードの下にブループリントに表示されます。
ダッシュボードには、以下のデータソースのウィジェットが含まれています。
-
順序外のパケットが検出されました
-
受信したシーケンス外パケット
-
CNP受信
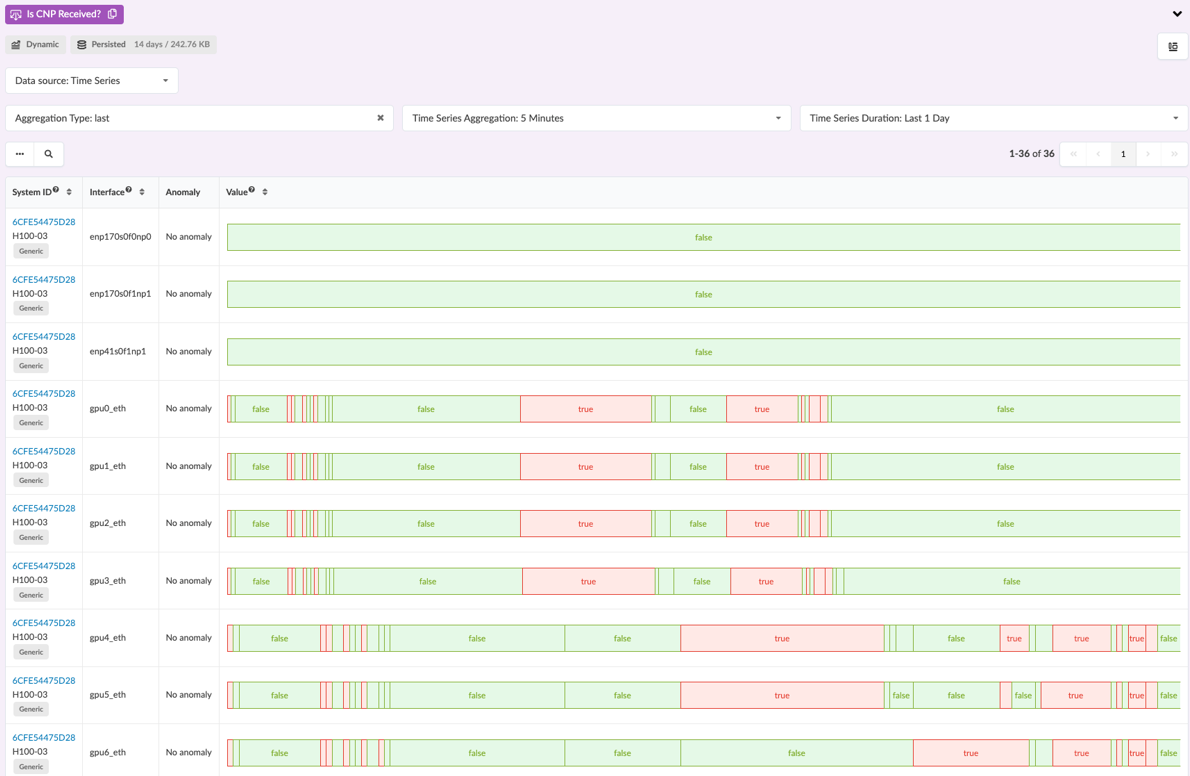
検出されたプローブ値が設定されたしきい値を下回っている場合、各ウィジェットに「異常はありません!」と表示されることに注意してください。
プローブには、以下を表示するGPU Infinibandポート情報テーブルも含まれています。
-
システムID
-
InfiniBandデバイス識別子(mlx5_X)
-
インターフェース名
-
ポート
-
ステータス