
Solution Architecture
Les trois fabrics décrites dans la section précédente (front-end, back-end GPU et back-end de stockage) sont interconnectées dans l’architecture globale de la solution IA JVD illustrée à la figure 2.
Figure 2 : Architecture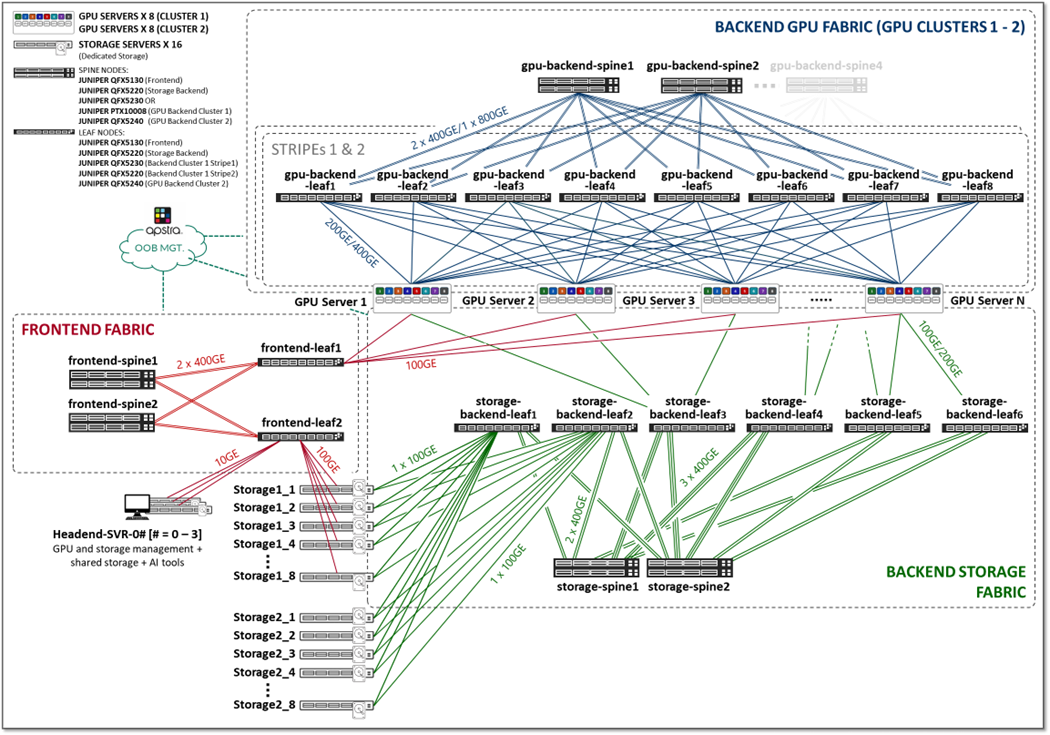 de la solution JVD d’IA
Fabric front-end
La fabric front-end fournit l’infrastructure permettant aux utilisateurs d’interagir avec les systèmes d’IA pour orchestrer les tâches d’entraînement et d’inférence à l’aide d’outils tels que SLURM, Kubernetes et d’autres gestionnaires de flux de travail d’IA qui gèrent la planification des tâches, l’allocation des ressources et la gestion du cycle de vie.
Ces interactions ne génèrent pas de flux de données lourds et n’imposent pas d’exigences strictes en matière de latence ou de perte de paquets. Par conséquent, le trafic du plan de contrôle n’impose pas d’exigences de performances rigoureuses à la fabric.
La conception du fabric front-end consiste en une fabric IP L3 à 3 niveaux sans haute disponibilité (HA), comme illustré à la figure 3. Cette architecture fournit une solution simple et efficace pour la connectivité requise dans le Frontend. Cependant, n’importe quelle architecture de fabric, y compris EVPN/VXLAN, peut être utilisée. Si vous avez besoin d’une fabric front-end compatible avec la HA, nous vous recommandons de suivre le programme en trois étapes avec la JVD de Juniper Apstra.
Figure 3 : Architecture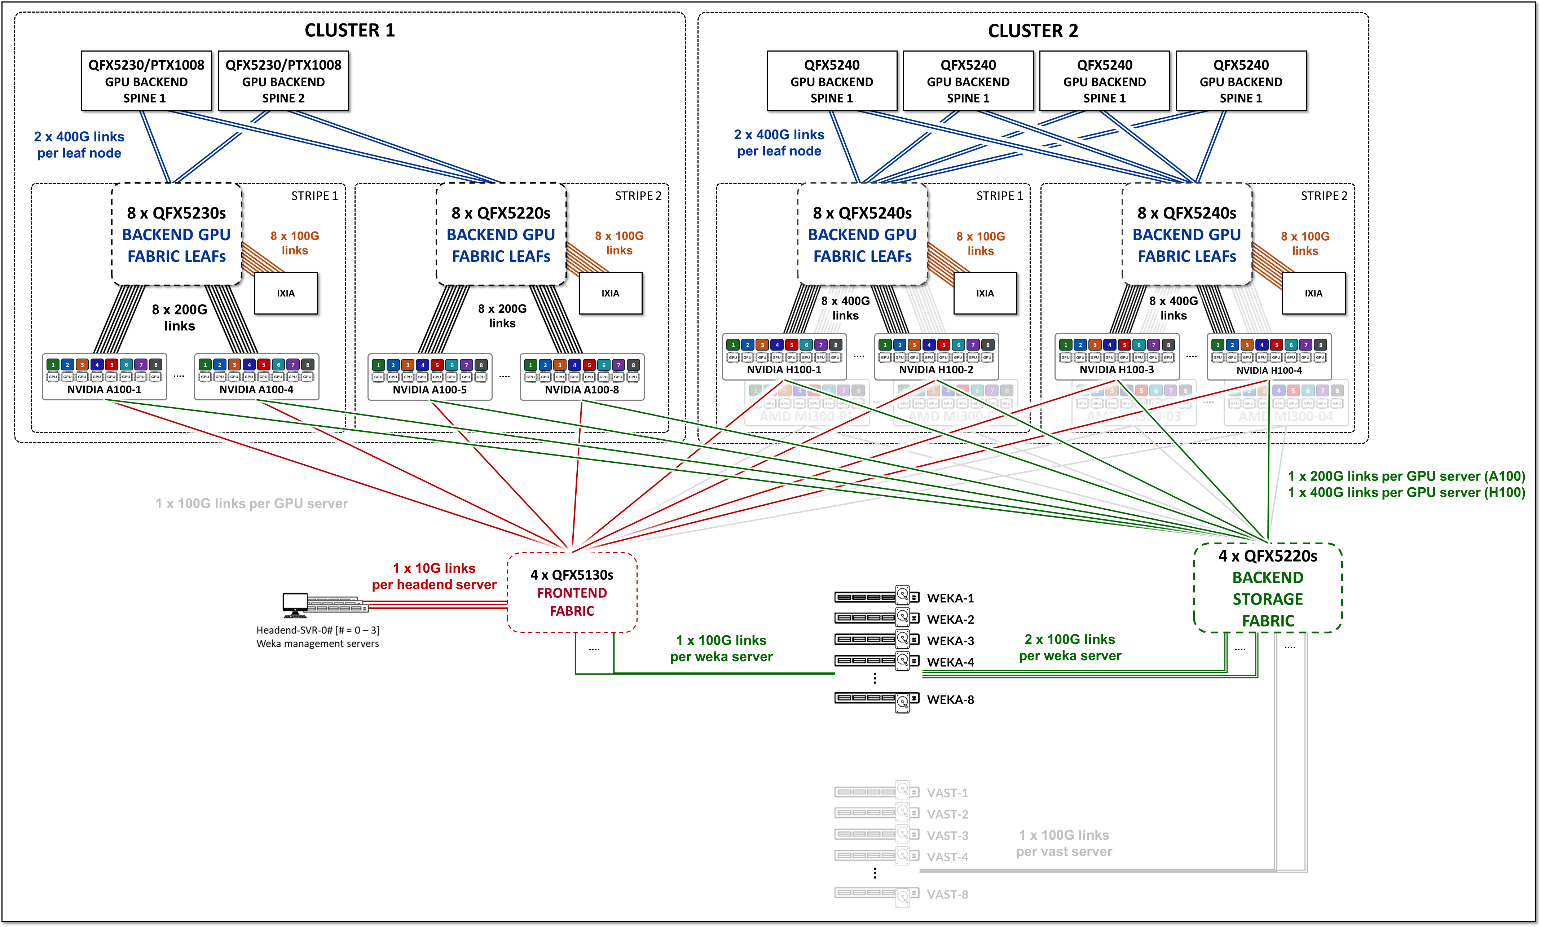 fabric front-end
Le nombre de nœuds Leaf dépend du nombre de serveurs et de périphériques de stockage dans le cluster IA, ainsi que de tout autre périphérique utilisé pour IA planification des tâches, l’allocation des ressources et la gestion du cycle de vie.
Le nombre de nœuds spine dépend du facteur d’abonnement souhaité pour la conception. Un facteur d’abonnement de 1:1 n’est pas requis. Un surabonnement modéré est acceptable pour le trafic du plan de contrôle, à condition que la conception maintienne la résilience et évite la congestion qui aurait un impact sur la stabilité du plan de contrôle.
Il s’agit d’une structure IP de couche 3 qui utilise EBGP pour l’annonce de route avec adressage IP et les détails de configuration EBGP décrits dans la section mise en réseau de ce document. Aucun mécanisme d’équilibrage de charge spécial n’est requis. ECMP sur des chemins L3 redondants est généralement suffisant.
Étant donné que le trafic du plan de contrôle n’est généralement pas gourmand en bande passante par rapport aux fabrics de stockage ou de GPU, des mécanismes de QoS stricts sont facultatifs et uniquement recommandés en cas de partage de liens avec un trafic sans contrôle en rafales.
Les appareils et la connectivité dans la fabric front-end validée dans cette JVD sont résumés dans les tableaux suivants :
Tableau 1 : Équipements de gestion et serveurs GPU validés connectés à la fabric front-end
| Serveurs GPU, | périphériques de stockage | , serveurs de tête de réseau |
|---|---|---|
|
Weka CSE-LB16TS-R860AWP-A |
Supermicro SYS-6019U-TR4 |
Tableau 2 : nœuds leaf et spine de la fabric front-end validée
| Nœud leaf de fabric front-end modèle de commutateur | Nœud de spine de fabric front-end modèle de commutateur |
|---|---|
| QFX5130-32CD | QFX5130-32CD |
| QFX5220-32CD | QFX5220-32CD |
Tableau 3 : connexions validées entre les serveurs principaux et les nœuds Leaf dans la fabric front-end
| Liens par serveur GPU vers la connexion leaf | Type de serveur |
|---|---|
| 1 x 10GE | Supermicro SYS-6019U-TR4 |
Tableau 4 : connexions validées entre les serveurs GPU et les nœuds Leaf dans le frontend
| Liens par serveur GPU vers la connexion leaf | Type de serveur |
|---|---|
| 1 x 100GE | NVIDIA A100 |
| 1 x 100GE | NVIDIA H100 |
Tableau 5 : connexions validées entre les nœuds leaf et spine dans le front-end
| Liens par connexion leaf et spine | Modèle de nœud leaf | Modèlede nœud spine |
|---|---|---|
| 2 x 400GE | QFX5130-32CD | QFX5130-32CD |
Les tests de cette JVD ont été effectués sur 8 serveurs GPU NVIDIA A100 et 4 serveurs GPU NVIDIA H100 connectés à deux nœuds Leaf, eux-mêmes connectés à deux nœuds Spine, comme illustré :
Figure 4 : topologie de test JVD de la fabric front-end
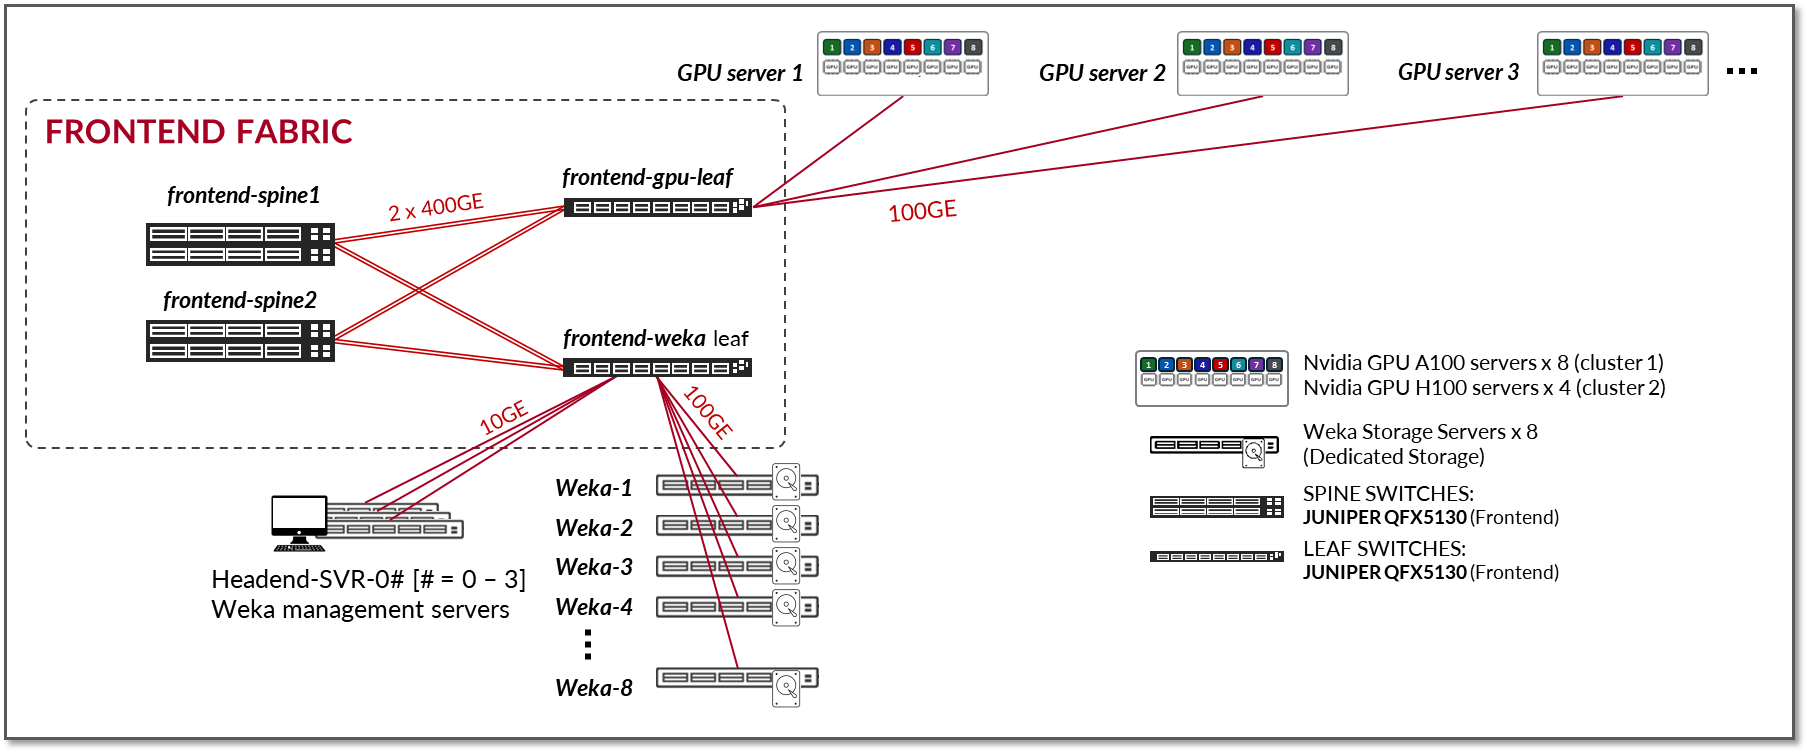
- Les serveurs GPU sont connectés aux nœuds Leaf à l’aide d’interfaces 100G (cartes réseau ConnectX-6/ConnectX-7).
- Les appareils Weka sont connectés aux nœuds Leaf à l’aide d’interfaces 100G
Tableau 6 : Serveurs GPU front-end agrégés <=> nœuds leaf front-end Nombre de liaisons et bande passante testée
| Serveurs GPU <=> bande passante des nœuds leaf frontaux | |
|---|---|
| Nombre de liaisons 100GE Serveurs GPU ó nœuds leaf front-end = 12 (1 par serveur) |
12 x 100GE = 1,2 Tbit/s |
| Nombre de liaisons 100GE entre le périphérique de stockage ó les nœuds leaf frontaux = 8 (1 par périphérique de stockage) |
8 x 100GE = 0,8 Tbit/s |
| Bande passante totale = | 2,0 Tbit/s |
Tableau 7 : Nœuds leaf front-end agrégés <=> nœuds spine front-end Nombre de liaisons et bande passante testée
| Nœuds leaf front-end <=> bande passante des nœuds spine front-end | ||
|---|---|---|
| Nombre de liaisons 400GE entre les nœuds leaf front-end et les nœuds spine = 8 (2 nœuds leaf x 2 nœuds spines x 2 liens par connexion leaf vers le cœur de réseau) |
8 x 400GE = 3,2 Tbit/s | |
| Bande passante totale = | 3,2 Tbit/s | |
| Pas de surabonnement. | ||
Fabric back-end de GPU
La fabric back-end des GPU fournit l’infrastructure permettant aux GPU de communiquer entre eux au sein d’un cluster, à l’aide de RDMA sur Ethernet convergé (RoCEv2). ROCEv2 améliore l’efficacité du datacenter, réduit la complexité globale et augmente les performances de livraison des données en permettant aux GPU de communiquer comme ils le feraient avec le protocole InfiniBand.
Contrairement à la fabric front-end, la fabric back-end GPU achemine un trafic de plan de données qui consomme beaucoup de bande passante et est sensible à la latence. La perte de paquets, une latence excessive ou une gigue peuvent avoir un impact significatif sur les délais d’exécution des tâches et doivent donc être évitées. Par conséquent, l’un des principaux objectifs de conception du fabric de back-end GPU est de fournir une fabric Ethernet quasi sans perte, tout en offrant une débit maximale, une latence minimale et une interférence réseau minimale pour le trafic GPU à GPU. RoCEv2 fonctionne plus efficacement dans les environnements où la perte de paquets est minimisée, ce qui contribue directement à optimiser les délais d’exécution des tâches.
La fabric back-end GPU de cette JVD a été conçue pour répondre à ces exigences. La conception suit une architecture IP Clos à 3 niveaux, Rail Optimized Stripe, comme illustré sur la figure 5. Les détails de l’architecture Rail Optimized Stripe sont décrits dans une section ultérieure.
Figure 5 : Architecture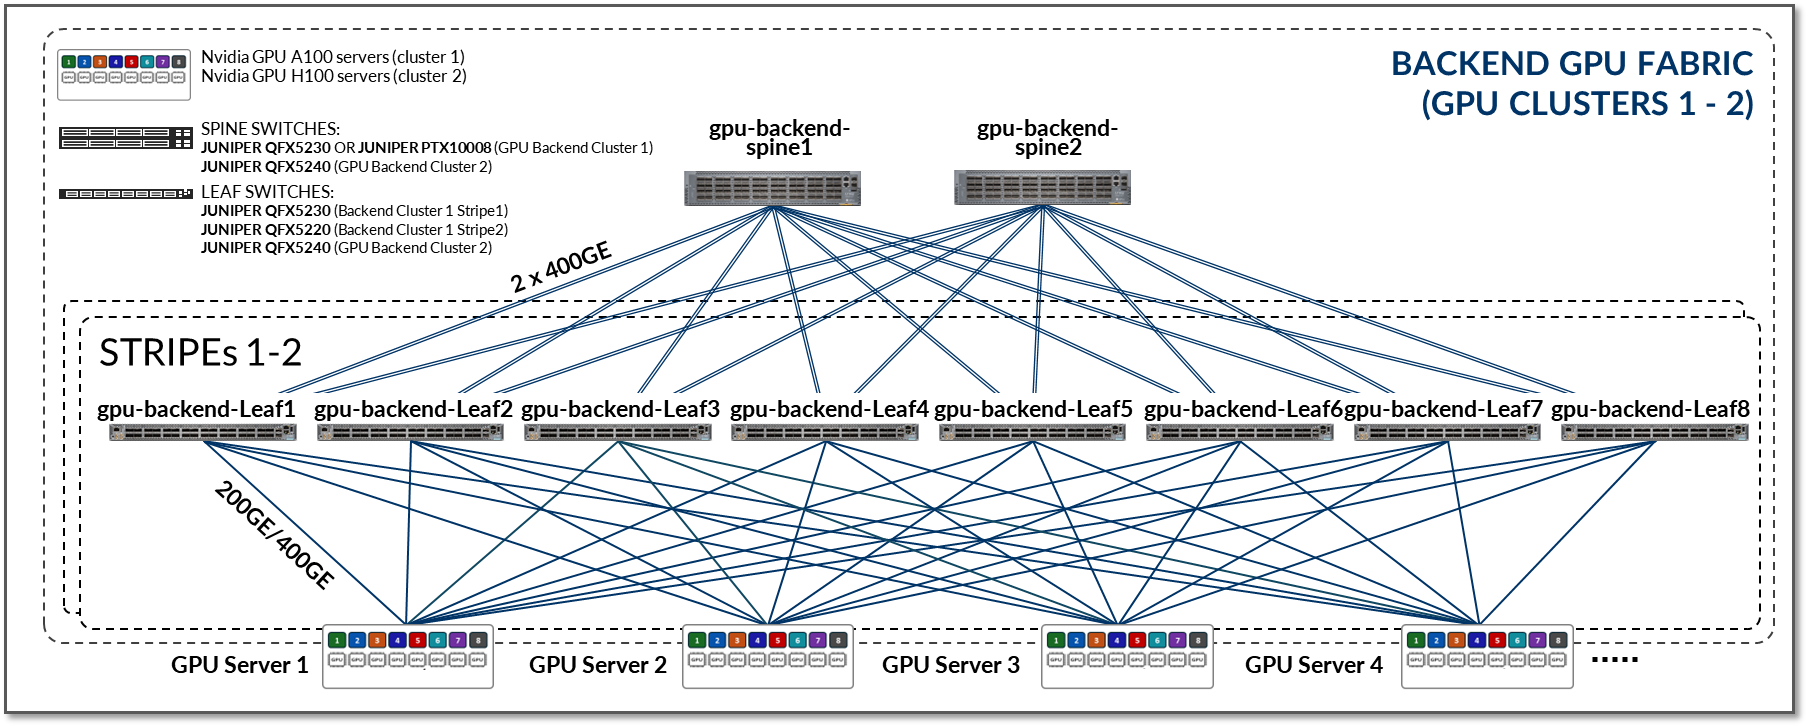 fabric backend GPU
La structure fonctionne comme une structure IP L3 avec EBGP pour la publication de route avec adressage IP et les détails de configuration EBGP décrits dans la section réseau de ce document.
Dans une architecture rail-optimized (rail-optimized), le nombre de nœuds Leaf est déterminé par le nombre de GPU par serveur, qui est de 8 pour les serveurs Nvidia inclus dans cette JVD. Le nombre de nœuds spine, ainsi que la vitesse et le nombre de liaisons entre les serveurs GPU et les nœuds leaf, et entre les nœuds leaf et spine, déterminent la bande passante effective et les caractéristiques de surabonnement de la fabric back-end GPU.
Contrairement à la fabric front-end, la fabric back-end GPU nécessite une conception sans surabonnement (facteur d’abonnement 1:1) afin de garantir une bande passante suffisante pour le trafic RoCEv2 à volume élevé et d’éviter la congestion, la perte de paquets et la latence excessive.
La distribution du trafic au sein de la fabric back-end de GPU repose sur ECMP sur plusieurs chemins L3 à coût égal, combiné à des techniques d’équilibrage de charge avancées telles que l’équilibrage de charge dynamique (DLB), l’équilibrage de charge global et l’équilibrage de charge adaptatif (ALB). Ils sont décrits dans la section Équilibrage de charge de ce document.
Étant donné que le fabric back-end GPU transporte un trafic RoCEv2 sensible aux pertes et aux latence, la conception intègre DCQCN (Data Center Quantized Congestion Notification), qui exploite l’ECN (Explicit Congestion Notification) et peut éventuellement utiliser PFC (Priority Flow Control) pour obtenir un comportement sans perte ou quasi sans perte pour le trafic RDMA. Ces mécanismes sont décrits en détail dans la section Classe de service du présent document.
Les appareils et la connectivité dans la fabric back-end des GPU validée dans cette JVD sont résumés dans les tableaux suivants :
Tableau 8 : Équipements de gestion validés et serveurs GPU connectés à la fabric back-end GPU.
| Serveurs GPU, | périphériques de stockage | , serveurs de tête de réseau |
|---|---|---|
|
Weka CSE-LB16TS-R860AWP-A |
Supermicro SYS-6019U-TR4 |
Tableau 9 : nœuds leaf de la fabric back-end GPU validés
| Modèle de commutateur de nœuds leaf de la fabric back-end GPU |
|---|
| QFX5220-32CD |
| QFX5230-64CD |
| QFX5240-64OD |
| QFX5241-64OD |
Tableau 10 : nœuds de cœur de fabric back-end GPU validés
| Modèle de commutateur de nœuds de spine de fabric back-end GPU |
|---|
| QFX5230-64CD |
| QFX5240-64OD |
| QFX5241-64OD |
| PTX10008 LC1201 |
| PTX10008 LC1301 |
Tableau 11 : connexions validées entre les serveurs GPU et les nœuds Leaf dans la fabric back-end de GPU
| Liens par serveur GPU vers la connexion leaf | Type de serveur |
|---|---|
| 1 x 200GE | NVIDIA A100 |
| 1 x liens 400GE par serveur GPU vers connexion leaf | NVIDIA H100 |
Tableau 12 : connexions validées entre les nœuds leaf et spine dans la fabric back-end de GPU
| Liens par connexion leaf et spine | Modèle de nœud leaf | Modèlede nœud spine |
|---|---|---|
| 1 x 400GE | QFX5220-32CD | QFX5230-32CD |
| 1 x 400GE | QFX5230-32CD | QFX5230-32CD |
| 2 x 400GE | QFX5240-64OD | QFX5240-64OD |
| 1 x 800GE | QFX5240-64OD | QFX5240-64OD |
| 1 x 400GE | QFX5220-32CD | PTX10008 LC1201 |
| 1 x 400GE | QFX5230-32CD | PTX10008 LC1201 |
| 1 x 800GE | QFX5240-64OD | PTX10008 LC1301 |
| 2 x 800GE | QFX5240-64OD | PTX10008 LC1301 |
Les tests de cette JVD ont été effectués sur 8 serveurs GPU NVIDIA A100 et 4 serveurs GPU NVIDIA H100 connectés sur deux bandes, comme indiqué :
Figure 6 : Topologie de test JVD de la fabric back-end de GPU
- Chaque serveur Nvidia A100 est connecté aux nœuds Leaf à l’aide d’interfaces 200G (cartes réseau ConnectX-7).
- Chaque serveur Nvidia H100 est connecté aux nœuds Leaf à l’aide d’interfaces 400G (cartes réseau ConnectX-7).
Tableau 13 : Bande passante serveur-leaf par bande
| Bande | Nombre de serveurs par Stripe |
Nombre de serveurs <=> liens leaf par serveur (identique au nombre de nœuds Leaf et au nombre de GPU par serveur) |
< serveur = bande passante de liaison leaf > [Gbit/s] |
Nombre total de serveurs <=> liens de branche Bande passante par bande [Tbit/s] |
|---|---|---|---|---|
| 1 | 2 H100 | 8 | 400 Gbit/s | 2 x 8 x 400 Gbit/s = 6,4 Tbit/s |
| 4 A100 | 8 | 200 Gbit/s | 4 x 8 x 200 Gbit/s = 6,4 Tbit/s | |
| 2 | 2 H100 | 8 | 400 Gbit/s | 2 x 8 x 400 Gbit/s = 6,4 Tbit/s |
| 4 A100 | 8 | 200 Gbit/s | 4 x 8 x 200 Gbit/s = 6,4 Tbit/s | |
| < serveur total = bande passante leaf > | 25,6 Tbit/s | |||
Tableau 14 : bande passante leaf-spine par bande avec QFX5240 en tant que leaf et spines
| Bande | Nombre de nœuds Leaf |
Nombre de nœuds spine | Nombre de 400 Gbit/s < leaf = > liens spine par nœud Leaf |
Serveur <=> Leaf Bande passante de liaison [Gbit/s] |
Bande passante Leaf <=> dos par bande [Tbit/s] |
|---|---|---|---|---|---|
| 1 | 8 | 4 | 2 | 400 | 8 x 2 x 2 x 400 Gbit/s = 12,8 Tbit/s |
| 2 | 8 | 4 | 2 | 400 | 8 x 2 x 2 x 400 Gbit/s = 12,8 Tbit/s |
| Total des serveurs < = > bande passante leaf | 25,6 Tbit/s | ||||
Facteur d’abonnement à la fabric back-end GPU
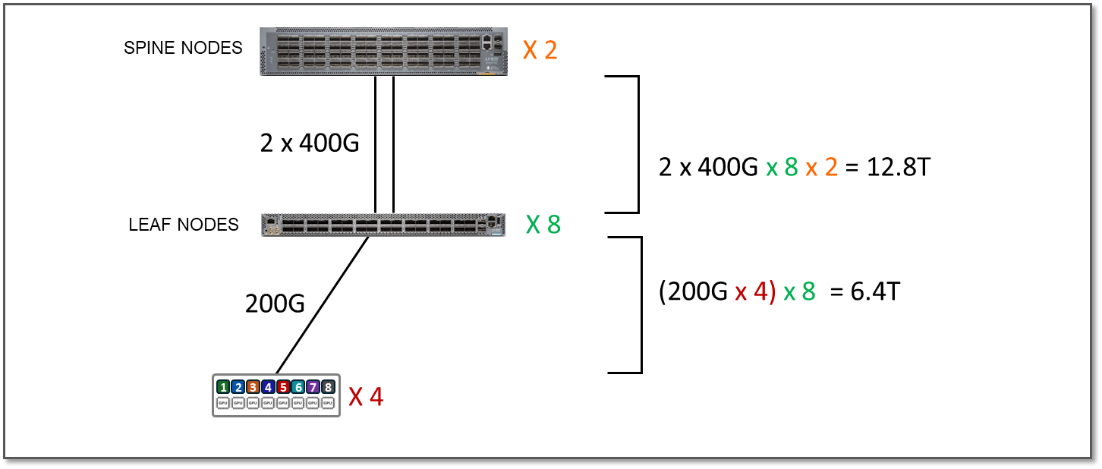
Le facteur de souscription est simplement calculé en comparant les chiffres des deux tableaux ci-dessus :
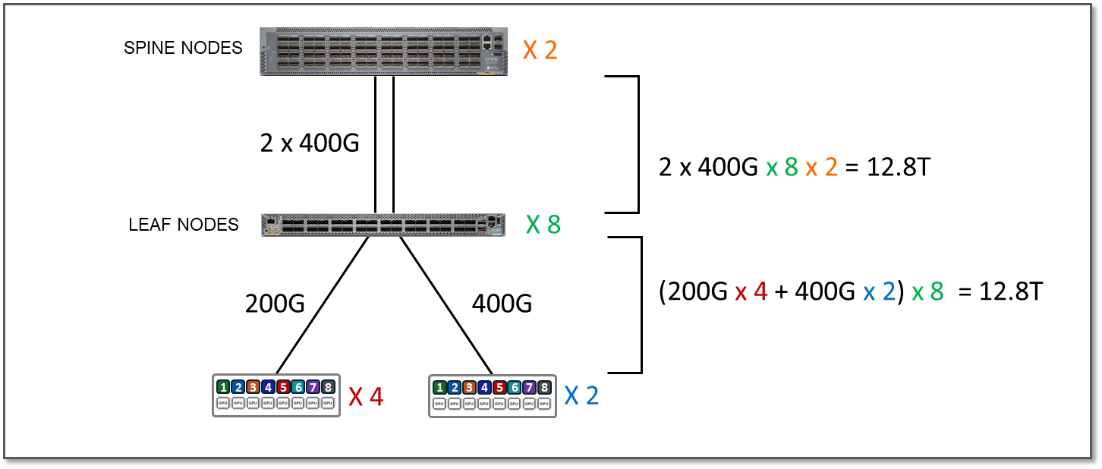
Dans l’environnement de test JVD, la bande passante entre les serveurs et les nœuds leaf est de 25,6 Tbit/s par bande, tandis que la bande passante disponible entre les nœuds leaf et spine est de 25,6 Tbit/s par bande. Cela signifie que la structure a une capacité suffisante pour traiter tout le trafic entre les GPU, même lorsque ce trafic était 100 % interbande, mais qu’il n’y a plus de capacité supplémentaire pour accueillir des serveurs supplémentaires. Dans ce cas, le facteur d’abonnement est de 1:1 (pas d’abonnement).
Figure 7 : Facteur d’abonnement 1:1
Pour exécuter des tests de surabonnement, certaines interfaces entre le commutateur Leaf et le commutateur Spine ont été désactivées, ce qui a réduit la bande passante disponible, comme le montre l’exemple de la figure 8 :
Figure 8 : Facteur d’abonnement 2:1 (surabonnement)
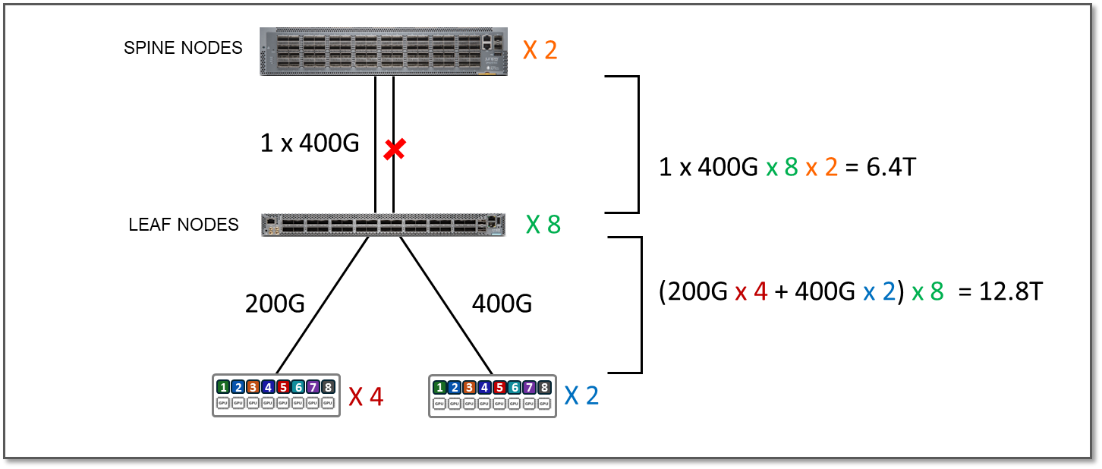
La bande passante totale des serveurs vers les liens de branche par bande n’a pas changé. Il est toujours de 12,8 Tbit/s, comme indiqué dans le tableau 15 du scénario précédent.
Cependant, la bande passante disponible entre les nœuds leaf et spine n’est plus que de 6,4 Tbit/s par bande.
Tableau 15 : bande passante par bande passante leaf-spine
| Bande passante leaf-spine par bande | |||
| Leaf <=> liens Spine par nœud Spine et par bande | Vitesse de Leaf <=> liens vers le dos [Gbit/s] |
Nombre de nœuds spine | Bande passante totale feuille <=> dos par bande [Tbit/s] |
| 8 | 1 x 400 | 2 | 6.4 |
Cela signifie que la fabric n’a plus la capacité suffisante pour traiter tout le trafic entre les GPU, même si ce trafic était 100 % interbande, ce qui pouvait provoquer des congestions et des pertes de trafic. Dans ce cas, le facteur de surabonnement est de 2:1.
Les résultats des tests d’encombrement et de défaillance sont inclus dans le rapport de test de la JVD.
Optimisation de la communication GPU à GPU
L’optimisation dans les topologies rail-optimized fait référence à la façon dont la communication GPU est gérée pour minimiser la congestion et la latence tout en maximisant le débit. Un élément clé de cette stratégie d’optimisation consiste à maintenir le trafic local dans la mesure du possible. En veillant à ce que la communication du GPU reste sur le même rail ou la même bande, ou même au sein du serveur, le besoin de traverser des spines ou des liaisons externes est réduit, ce qui diminue la latence, minimise la congestion et améliore l’efficacité globale.
Bien que la localisation du trafic soit une priorité, la communication entre bandes sera nécessaire dans les grands clusters de GPU. La communication entre les bandes est optimisée au moyen de techniques de routage et d’équilibrage appropriées sur les liaisons disponibles afin d’éviter les goulots d’étranglement et la perte de paquets.
L’essence de l’optimisation réside dans l’utilisation de la topologie pour diriger le trafic sur les chemins les plus courts et les moins encombrés, garantissant ainsi des performances constantes même lorsque le réseau évolue. Le trafic entre GPU sur les mêmes serveurs peut être transféré localement sur la fabric interne du serveur (selon le fournisseur), tandis que le trafic entre GPU sur différents serveurs s’effectue sur l’infrastructure backend GPU externe. La communication entre les GPU de différents serveurs peut se faire intra-rail ou interrail/interbande.
Le trafic intrarail est commuté (traité au niveau de la couche 2) sur le nœud Leaf local. Ainsi, les données entre les GPU de différents serveurs (mais dans la même bande) sont toujours déplacées sur le même rail et sur un seul commutateur. Cela garantit que les GPU sont à 1 saut les uns des autres et créera des canaux indépendants distincts à large bande passante, ce qui minimise les conflits et optimise les performances. D’autre part, le trafic interrail/interbande est acheminé à travers les interfaces IRB sur les nœuds leaf et les nœuds spine reliant les nœuds leaf (traité en couche 3).
Prenons l’exemple illustré à la figure 8
- La communication entre le GPU 1 et le GPU 2 du serveur 1 s’effectue sur la fabric interne du serveur (1)
- La communication entre les GPU 1 des serveurs 1 à 4 et entre les GPU 8 des serveurs 1 à 4 se produit respectivement sur les branches 1 et 8 (2), et
- La communication entre les GPU 1 et GPU 8 (dans les serveurs 1 à 4) s’effectue à travers leaf1, les nœuds spine et leaf8 (3)
Figure 8 : Communication GPU-GPU interrail et intrarail
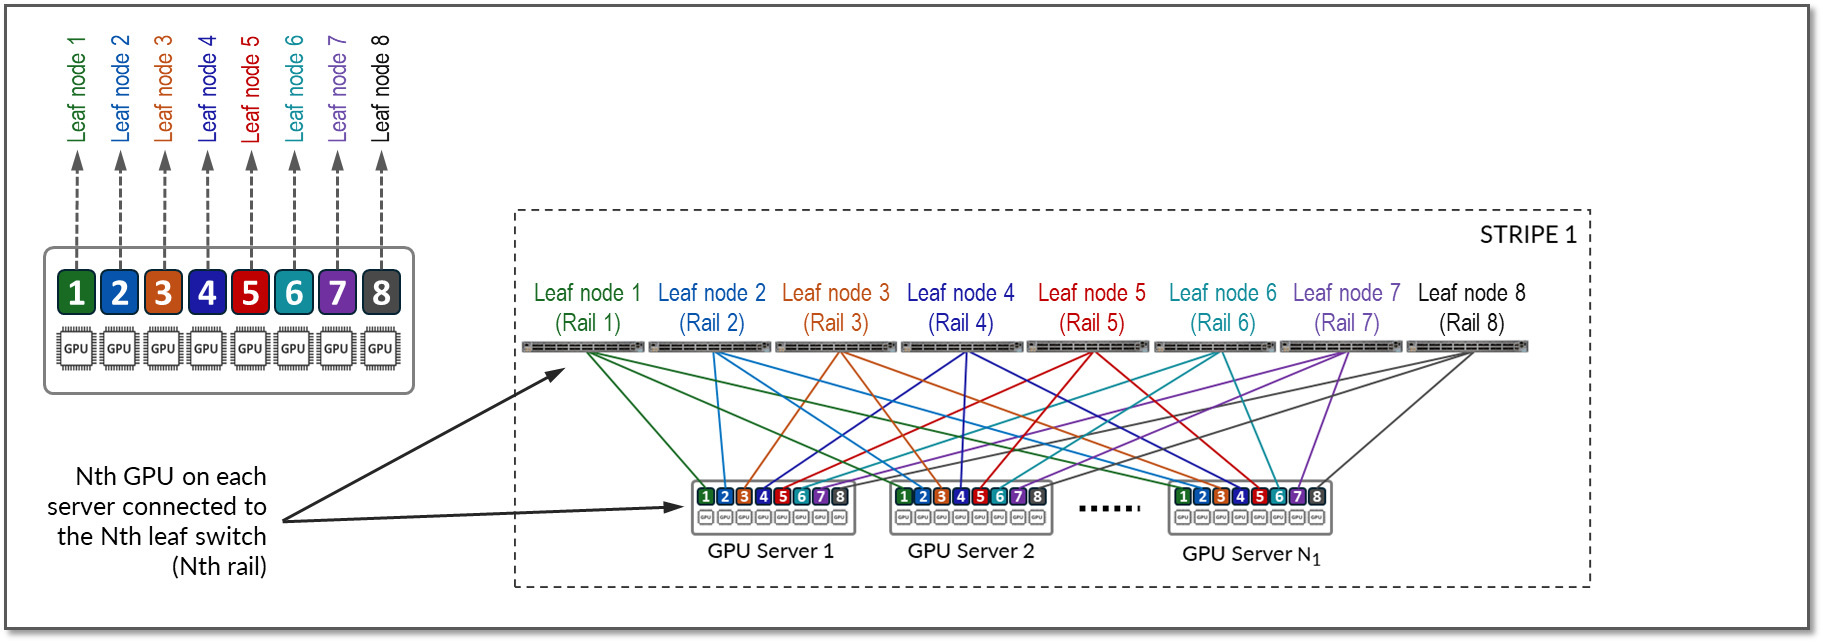
La figure 10 représente une topologie avec une bande et 8 rails reliant les GPU 1 à 8 sur des commutateurs leaf 1 à 8 respectivement.
La communication entre le GPU 7 et le GPU 8 du serveur 1 s’effectue sur la fabric interne, tandis que la communication entre le GPU 1 du serveur 1 et le GPU 1 du serveur N1 s’effectue via le commutateur leaf 1 (dans le même rail).
Notez que si une communication entre des GPU de différentes bandes et différents serveurs est nécessaire (par exemple, un GPU 4 dans le serveur 1 communiquant avec le GPU 5 dans le serveur N1), les données sont d’abord déplacées vers une interface GPU dans le même rail que le GPU de destination, envoyant ainsi les données au GPU de destination sans traverser les rails.
Ainsi, les données entre les GPU de différents serveurs (mais dans la même bande) sont toujours déplacées sur le même rail et sur un seul commutateur, ce qui garantit que les GPU sont distants d’un saut les uns des autres et crée des canaux indépendants distincts à large bande passante, ce qui minimise les conflits et optimise les performances.
Sur les serveurs GPU NVIDIA H100s, les GPU sont interconnectés via NVLink et NVswitches, qui fournissent une communication bidirectionnelle GPU à GPU à large bande passante de 400 Gbit/s, à faible latence, GPU à GPU au sein d’un seul serveur, comme illustré sur la Figure 9.
Figure 9 : Architecture d’interconnexion des GPU NVIDIA HGX/DGX
Pour plus de détails, reportez-vous à Introduction aux systèmes NVIDIA DGX H100/H200 — Guide de l’utilisateur NVIDIA DGX H100/H200
Les GPU NVIDIA exploitent NVLink et NVSwitch pour fournir une communication à haute bande passante et à faible latence entre les GPU, les CPU et d’autres composants système. Cette structure d’interconnexion gère dynamiquement le trafic sur plusieurs liaisons, offrant des chemins optimisés pour la communication intra-nœud entre les GPU et permettant des opérations collectives efficaces.
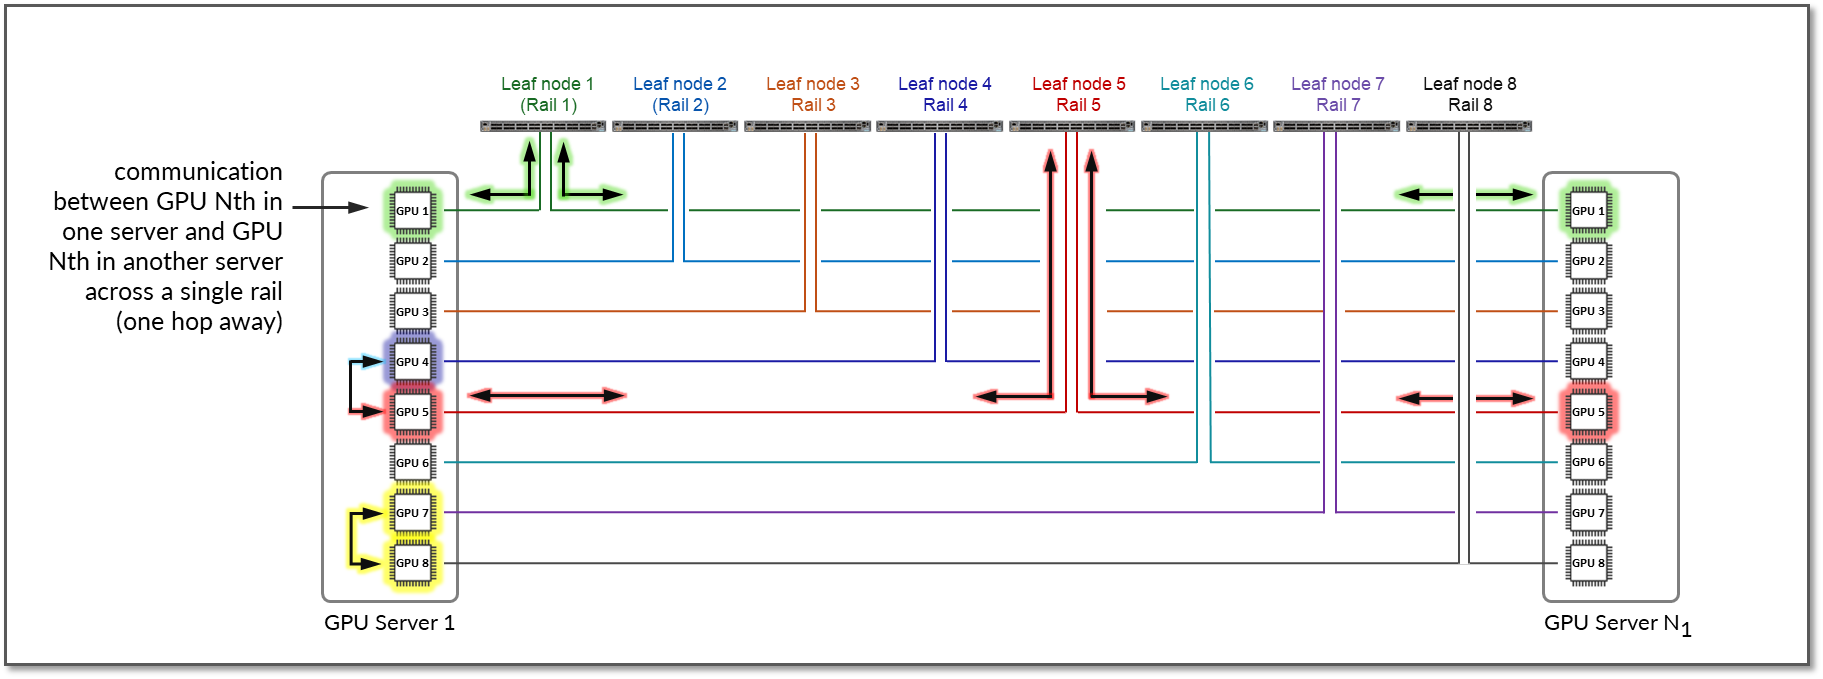
Par défaut, les plates-formes GPU NVIDIA implémentent un routage et une optimisation locale basés sur la topologie, implémentés à l’aide de PXN (Parallel Execution Networks), afin de minimiser la latence du trafic GPU à GPU. Les communications entre les GPU des mêmes serveurs sont transmises sur la fabric Infinity et restent à l’intérieur du nœud et ne traversent pas la fabric Ethernet externe. Le trafic entre GPU de même rang sur plusieurs serveurs reste intrabande.
La figure 12 montre un exemple où le GPU 1 du serveur 1 communique avec le GPU 1 du serveur 2. Le trafic est acheminé par le nœud Leaf 1 et reste sur le rail 1.
De plus, si le GPU 4 du serveur 1 souhaite communiquer avec le GPU 5 du serveur 2 et que le GPU 5 du serveur 1 est disponible en tant que saut local dans la fabric Infinity d’AMD, le trafic préfère naturellement ce chemin pour optimiser les performances et maintenir la communication GPU à GPU à l’intérieur du rail.
Figure 10 : Communication interrail GPU à GPU entre deux serveurs avec optimisation locale.
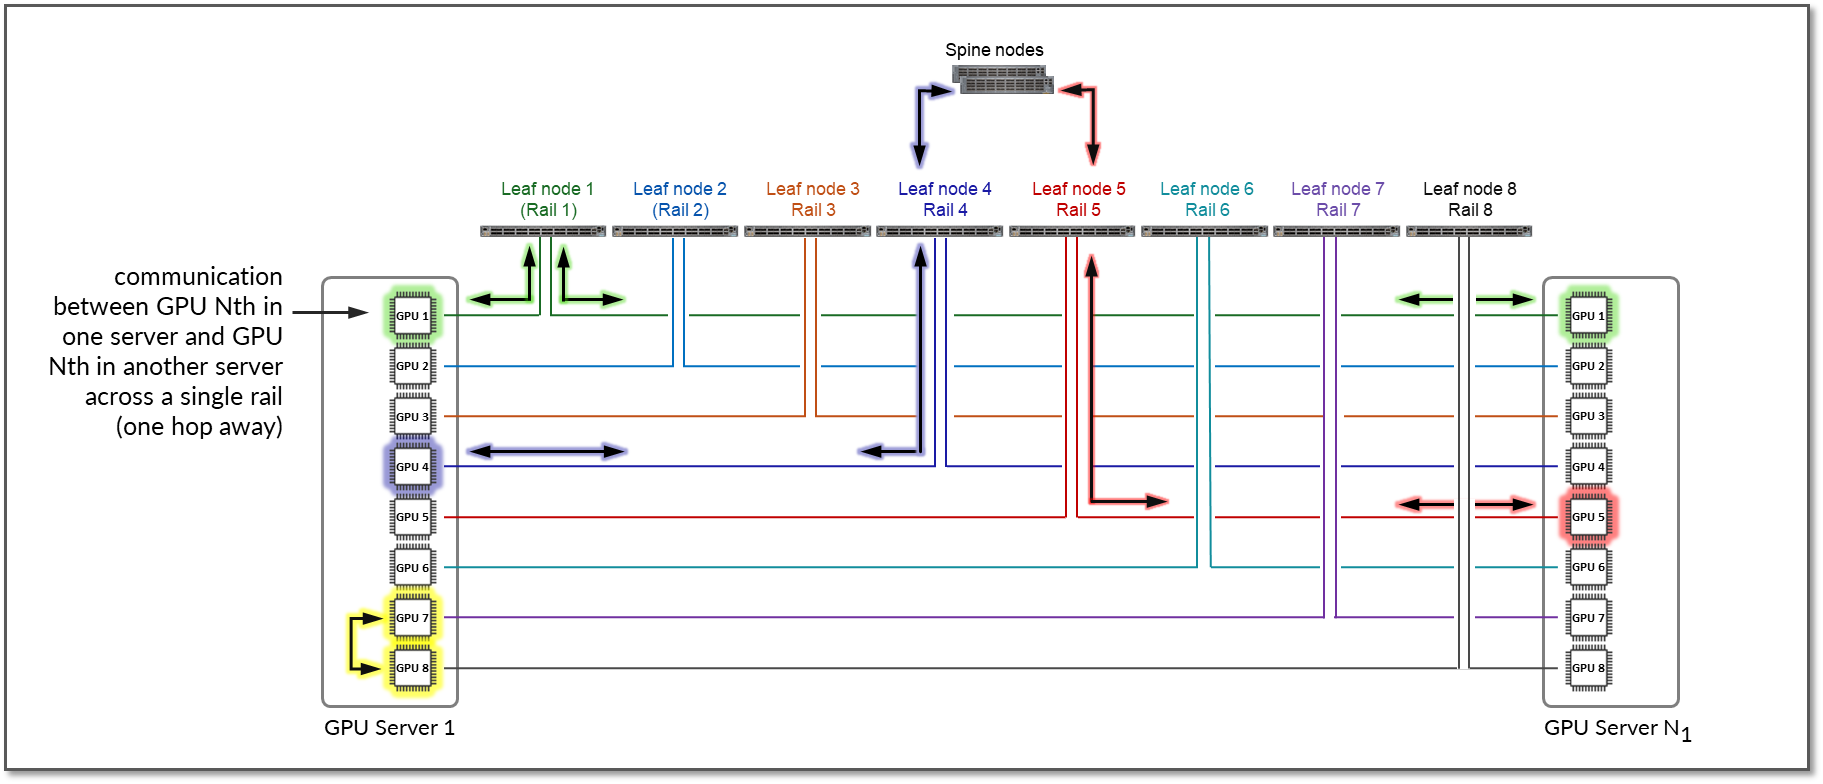
Si l’optimisation locale n’est pas réalisable en raison de contraintes de charge de travail, par exemple, le trafic doit contourner les sauts locaux (fabric interne) et utiliser RDMA (communication basée sur des NIC hors nœud). Dans ce cas, le GPU 4 du serveur 1 communique avec le GPU 5 du serveur 2 en envoyant des données directement sur la NIC à l’aide de RDMA, qui sont ensuite transmises à travers la fabric, comme illustré à la Figure 11.
Figure 11 : Communication interrail de GPU à GPU entre deux serveurs sans optimisation locale.
L’exemple montre que la communication entre le GPU 4 du serveur 1 et le GPU 5 du serveur N1 passe par le commutateur leaf 1, les nœuds Spine et le commutateur leaf 5 (entre deux rails différents).
Architecture de répartition optimisée pour les rails GPU back-end
Comme décrit précédemment, une architecture Rail Optimized Stripe assure un transfert de données efficace entre les GPU, en particulier lors de tâches gourmandes en calcul telles que les charges de travail d’entraînement des grands modèles de langage (LLM) de l’IA, où un transfert transparent des données est nécessaire pour accomplir les tâches dans un délai raisonnable. Une topologie rail-optimized vise à maximiser les performances en minimisant les conflits de bande passante, la latence et les interférences réseau, garantissant ainsi une transmission efficace et fiable des données sur le réseau.
Dans une architecture à bandes optimisée pour le rail, il existe deux concepts importants : rail et stripe.
Les GPU d’un serveur sont numérotés de 1 à 8, où le nombre représente la position du GPU sur le serveur, comme illustré sur la Figure 6. Ce nombre est parfois appelé rang ou plus précisément « rang local » par rapport aux GPU du serveur où se trouve le GPU, ou « classement global » par rapport à tous les GPU (dans plusieurs serveurs) affectés à une seule tâche.
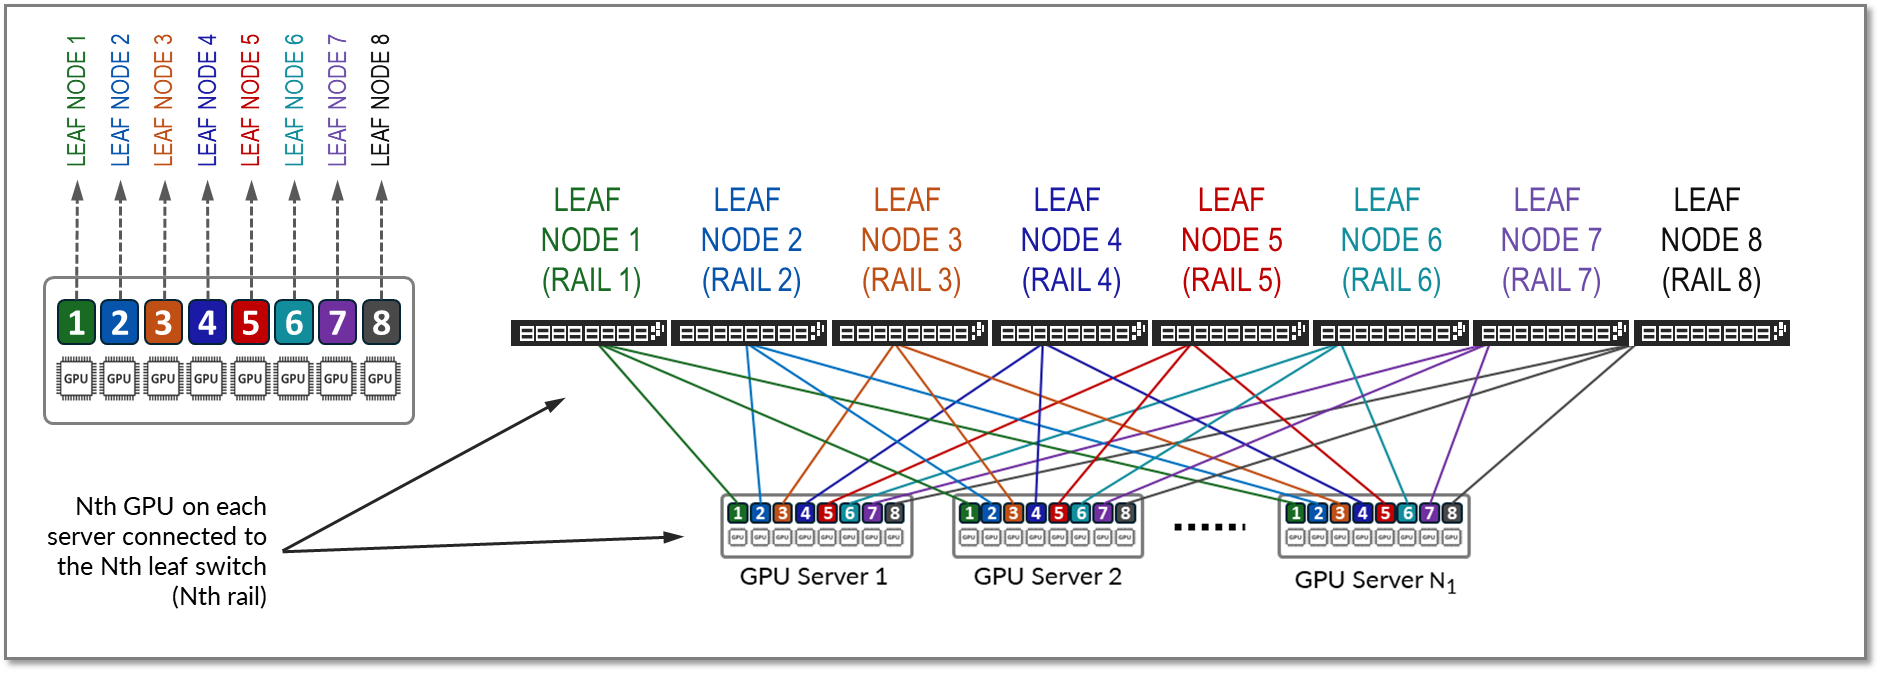
Un rail relie des GPU du même ordre sur l’un des nœuds Leaf de la fabric ; c’est-à-dire que rail Nth connecte tous les GPU en position Nth sur tous les serveurs, au nœud Leaf Nth, comme illustré sur la Figure 10.
Figure 10 : Rails dans une architecture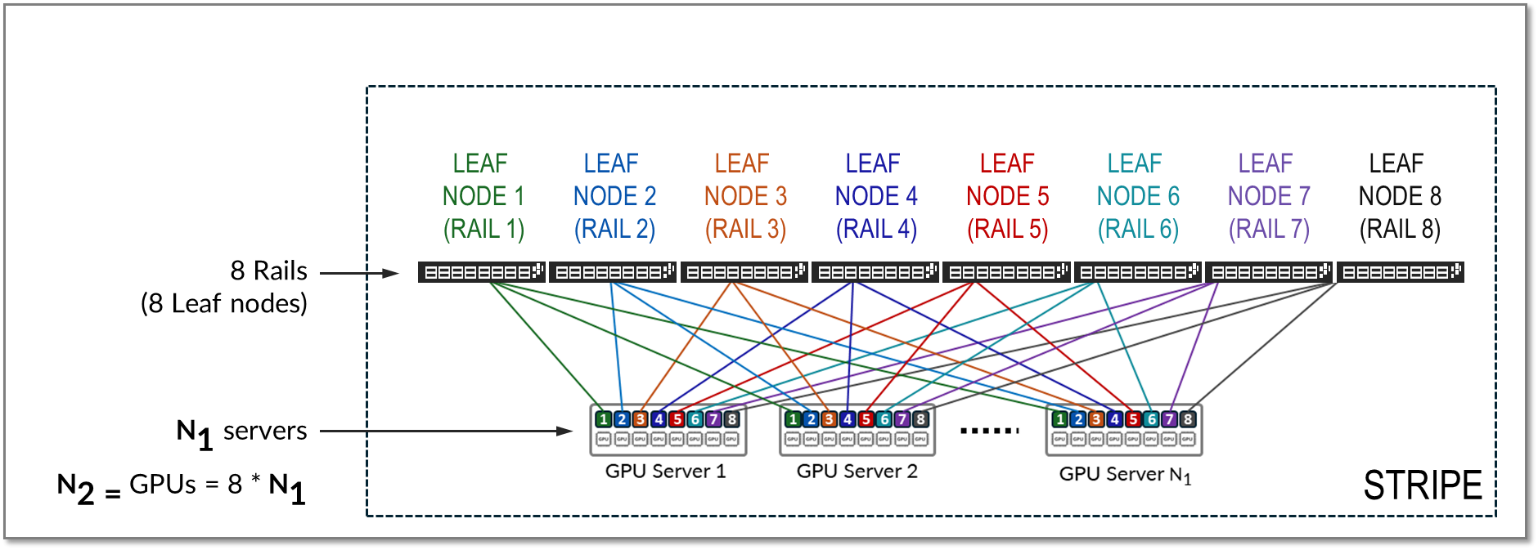 optimisée pour le rail
Une bande fait référence à un module de conception ou à un bloc modulaire, composé de plusieurs rails, et qui comprend un certain nombre de nœuds Leaf et de serveurs GPU, comme illustré dans la Figure 11. Ce bloc modulaire peut être répliqué pour mettre à l’échelle le cluster d’IA.
Figure 11 : Rayures dans une architecture optimisée pour le rail
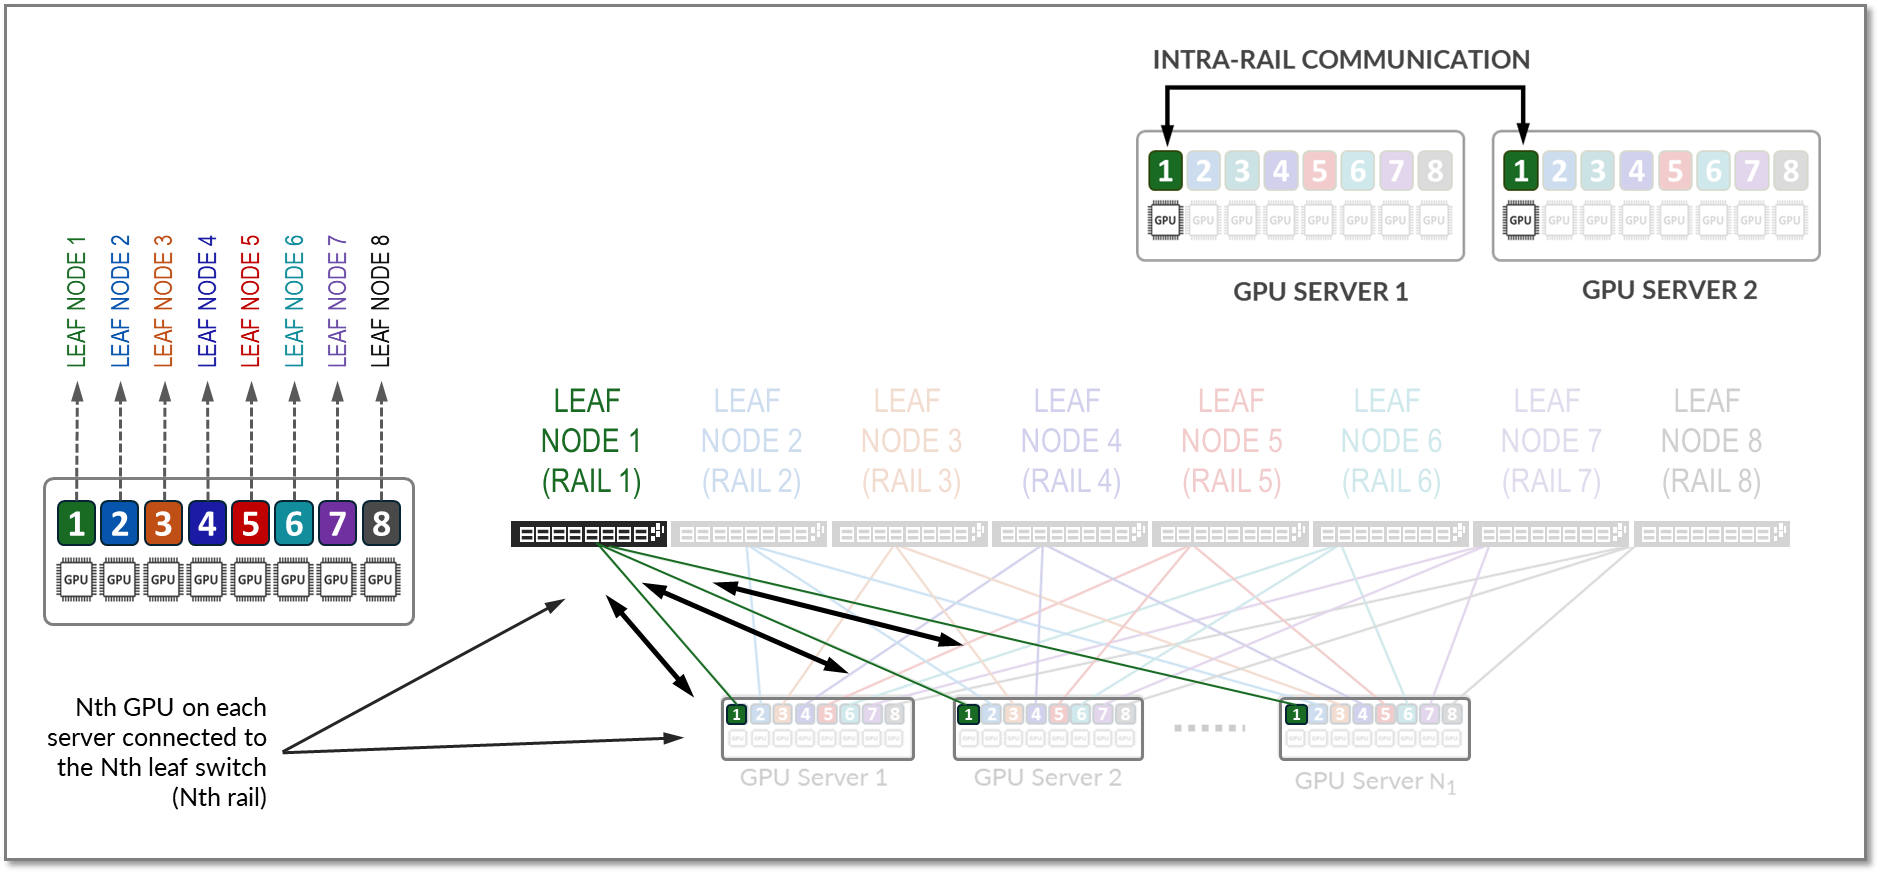
Tout le trafic entre GPU de même rang (trafic intrarail) est transféré au niveau du nœud Leaf, comme illustré à la Figure 12.
Figure 12 : Exemple de trafic intrarail de GPU à GPU.
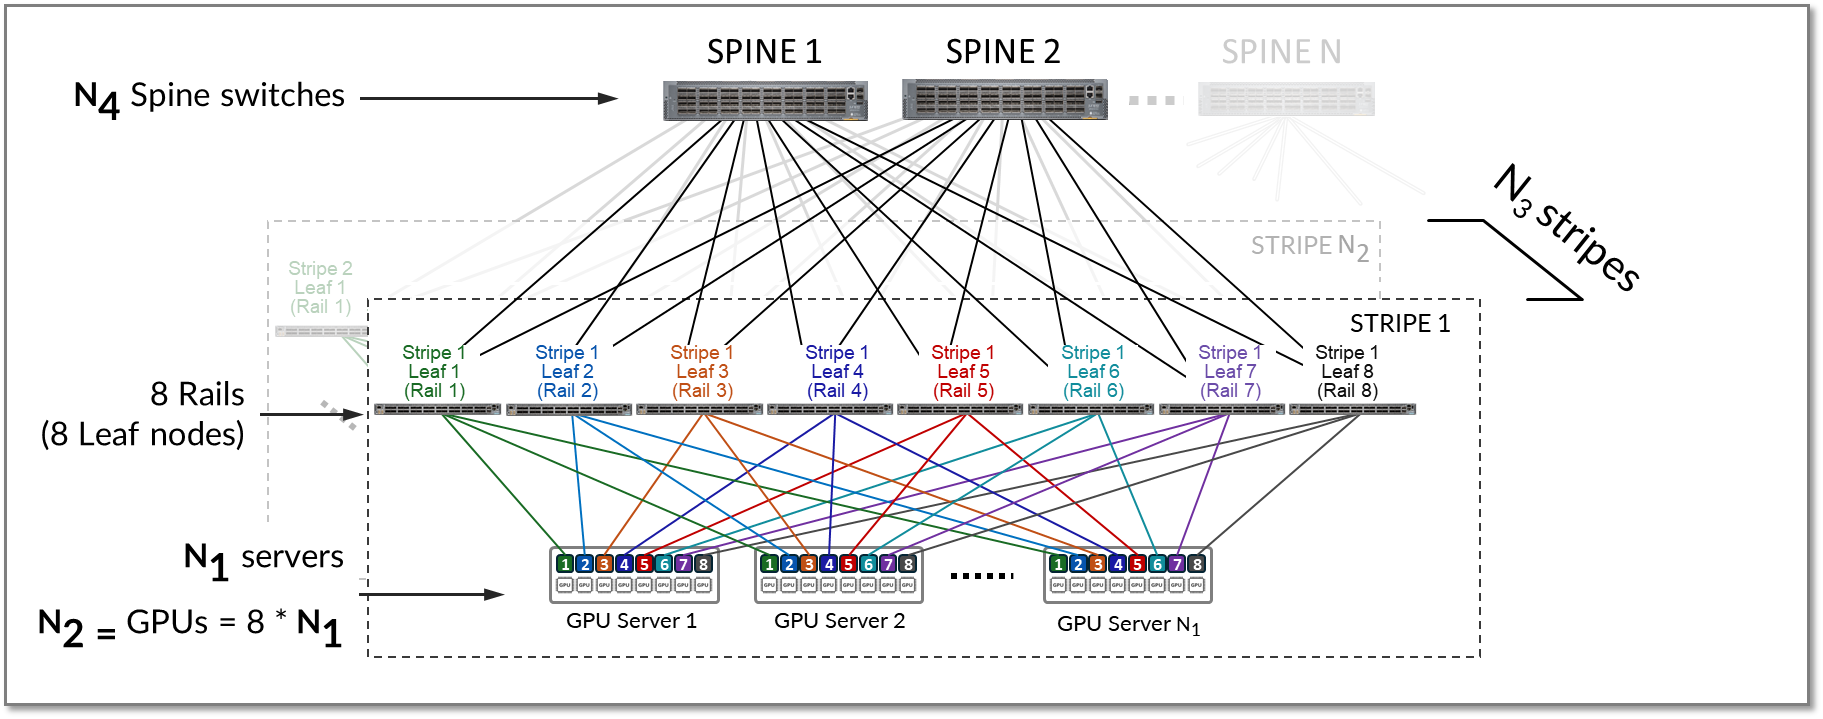
Une bande peut être répliquée pour augmenter le nombre de serveurs (N1) et de GPU (N2) dans un cluster d’IA. Plusieurs bandes (N3) sont ensuite connectées sur les commutateurs Spine, comme illustré sur la Figure 13.
Figure 13 : Plusieurs bandes connectées via des nœuds Spine
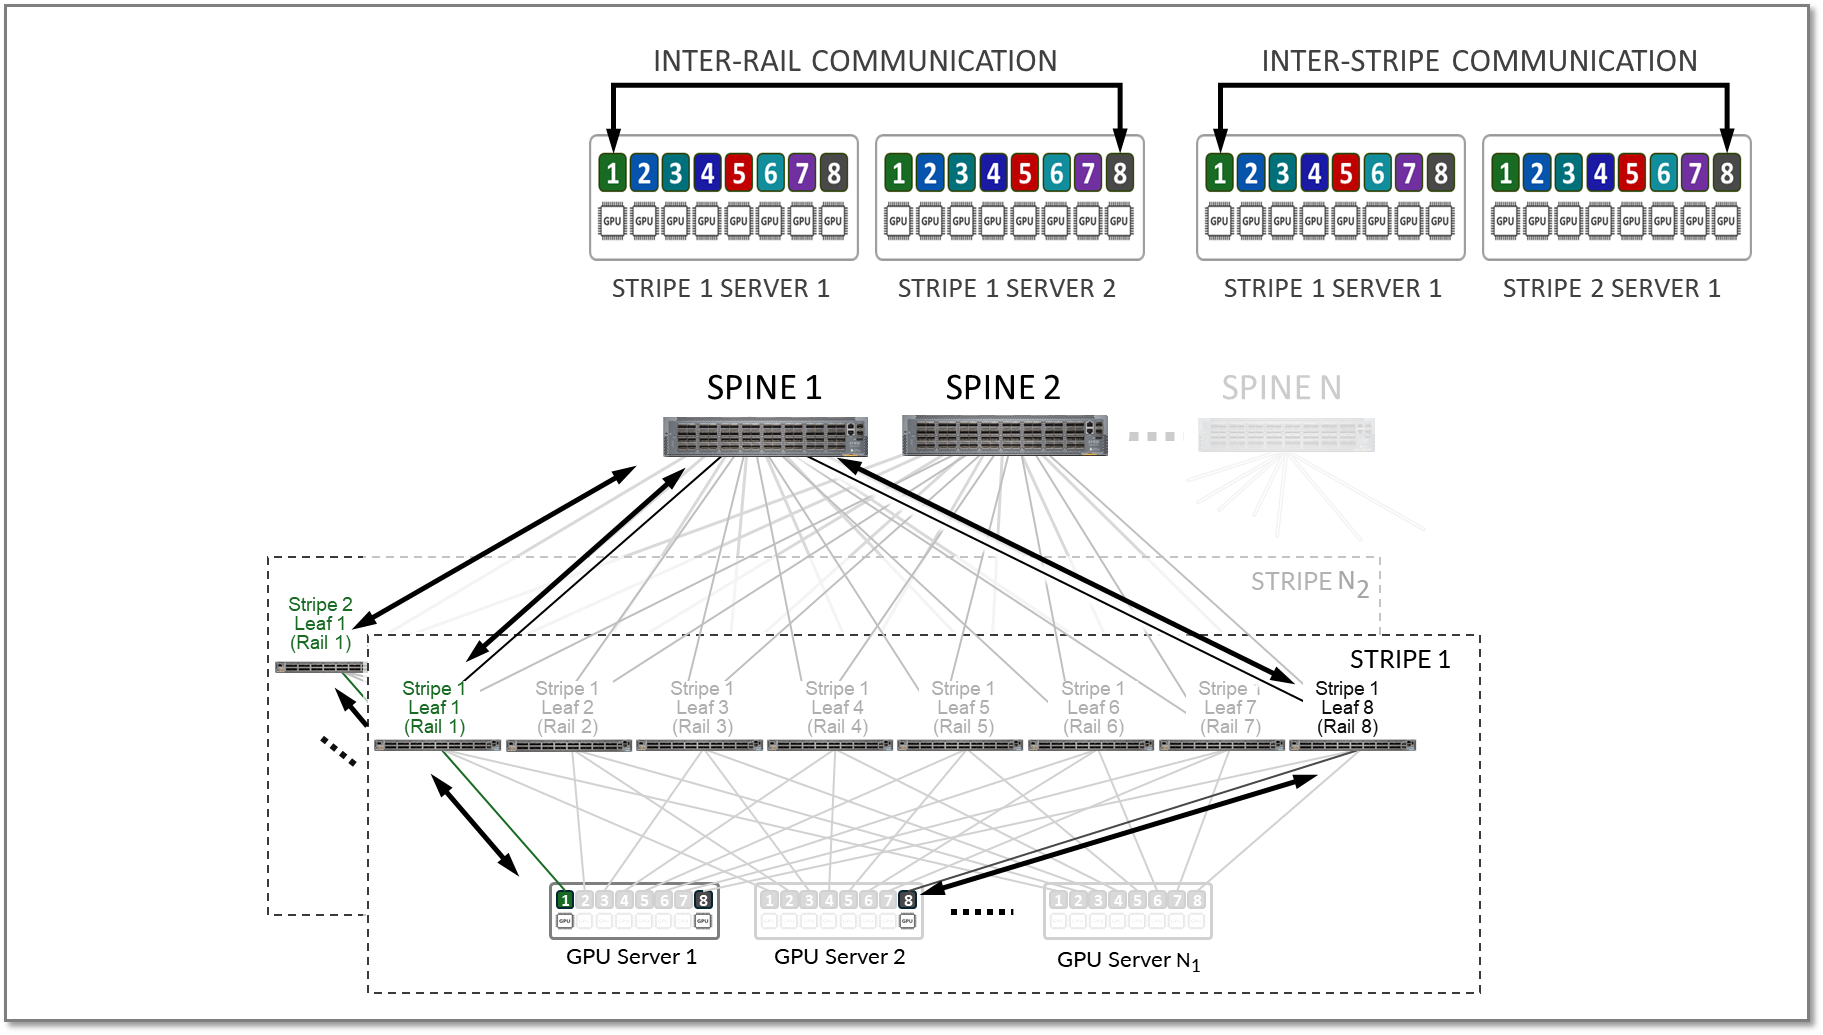
Le trafic interrail et interbande sera acheminé à travers les nœuds Spines, comme le montre la figure 14.
Graphique 14. Exemple de trafic interrail et interbande de GPU à GPU.
Calcul du nombre de nœuds leaf et spine, de serveurs et de GPU dans une architecture rail-optimized
Le nombre de nœuds Leaf dans une seule bande dans une architecture optimisée pour les rails est défini par le nombre de GPU par serveur (nombre de rails). Chaque serveur GPU NVIDIA DGX H100 comprend 8 GPU NVIDIA H100 Tensor Core. Par conséquent, une seule bande comprend 8 nœuds leaf (8 rails).
Nombre de nœuds Leaf = nombre de GPU par serveur = 8
Le nombre maximal de serveurs pris en charge dans une seule bande (N1) est défini par le nombre de ports disponibles sur le nœud Leaf, qui dépend du modèle du commutateur.
Pour maintenir un ratio d’abonnement de 1:1, la bande passante totale entre les serveurs GPU et les nœuds Leaf doit correspondre à la bande passante totale entre les nœuds Leaf et Spine.
En supposant que toutes les interfaces du nœud Leaf fonctionnent à la même vitesse, la moitié des interfaces sera utilisée pour se connecter aux serveurs GPU et l’autre moitié pour se connecter aux spines. Ainsi, le nombre maximal de serveurs dans une bande est calculé comme la moitié du nombre de ports disponibles sur chaque nœud Leaf.
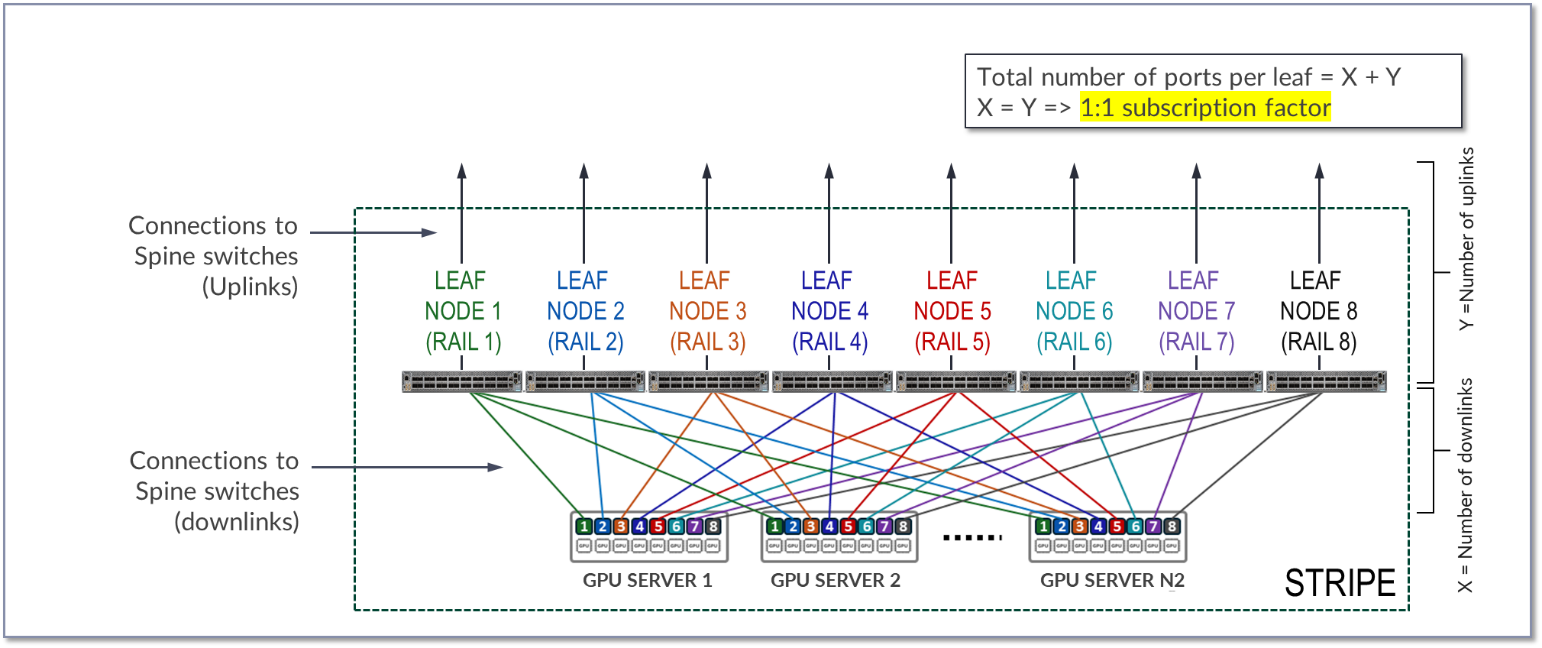
Graphique 15. Nombre de liaisons montantes et descendantes pour un facteur d’abonnement 1:1
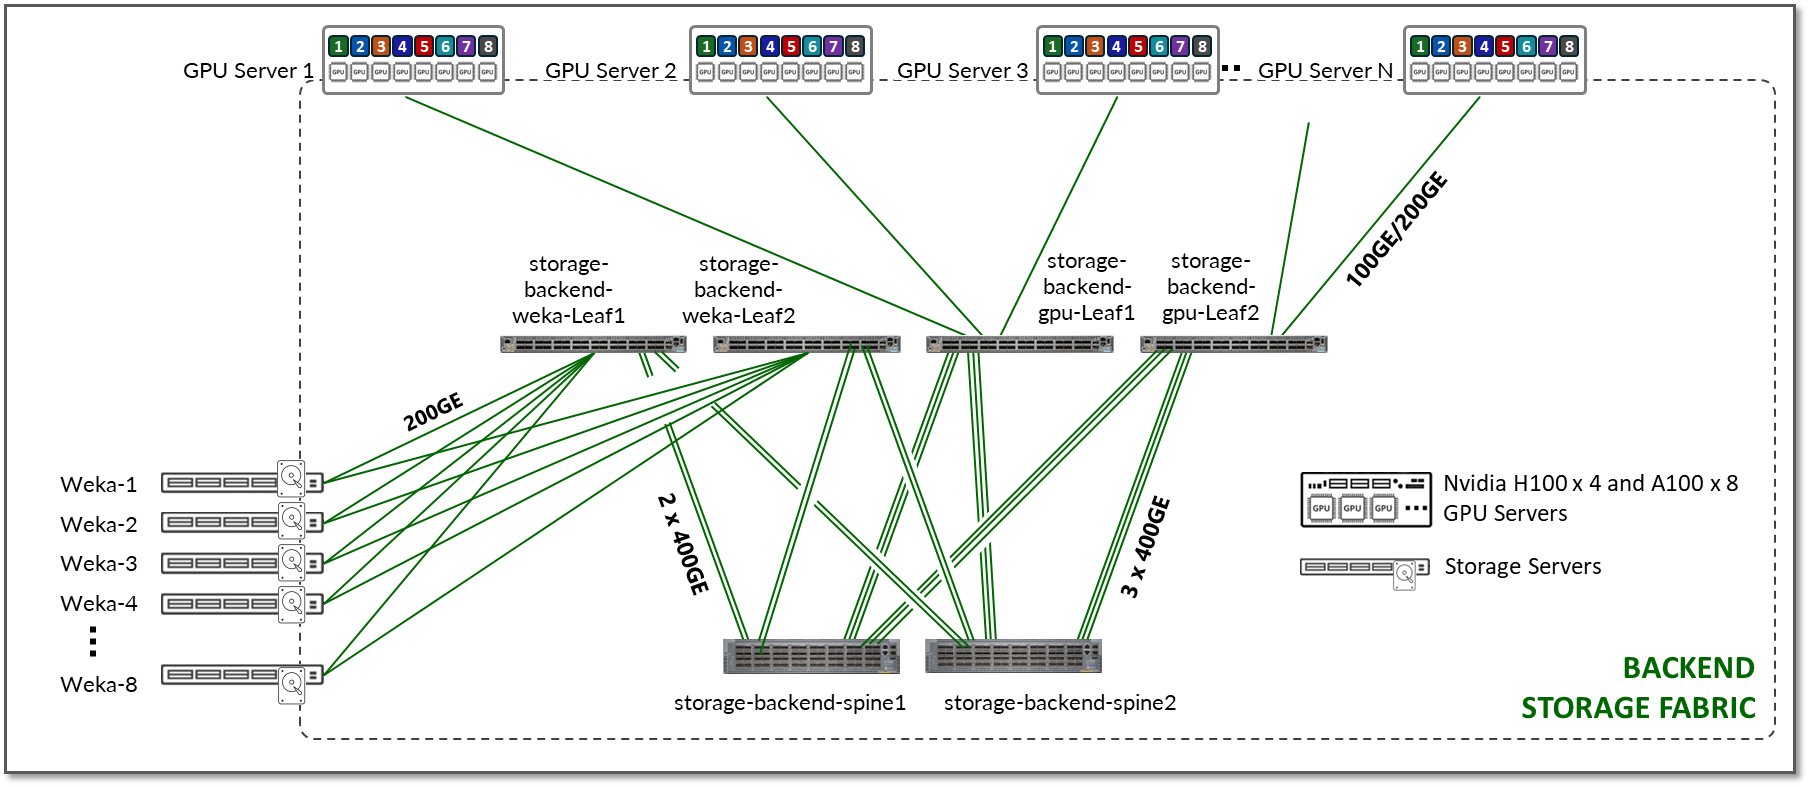
Sur le diagramme, X représente le nombre de liaisons descendantes (liaisons entre les nœuds leaf et les serveurs GPU), tandis que Y représente le nombre de liaisons montantes (liaisons entre les nœuds leaf et les nœuds spine). Pour permettre un facteur d’abonnement de 1:1, X doit être égal à Y.
Le nombre de ports disponibles sur chaque nœud Leaf est égal à X + Y ou 2 * X.
Étant donné que tous les serveurs d’une bande ont un port connecté à chaque branche de la bande, le nombre maximal de serveurs dans la bande (N1) est égal à X.
N1 (nombre maximal de serveurs par bande) = nombre de ports disponibles ÷ 2
Le nombre maximal de GPU dans la bande est calculé en multipliant simplement le nombre de GPU par serveur.
N2 (nombre maximal de GPU) = N1 (nombre maximal de serveurs par bande) * 8
Le nombre total de ports disponibles dépend du modèle de commutateur utilisé pour le nœud Leaf. Le tableau 16 en donne quelques exemples.
Tableau 16 : nombre maximal de GPU pris en charge par bande
| Nœud Leaf Modèle du commutateur QFX |
nombre total de ports 400GE disponibles par commutateur | Nombre maximal de serveurs pris en charge par bande pour un abonnement 1:1 (N1) |
GPU par serveur | Nombre maximal de GPU pris en charge par bande (N2) |
|---|---|---|---|---|
| QFX5220-32CD | 32 | 32 ÷ 2 = 16 | 8 | 16 serveurs x 8 GPU/serveur = 128 GPU |
| QFX5230-64CD | 64 | 64 ÷ 2 = 32 | 8 | 32 serveurs x 8 GPU/serveur = 256 GPU |
| QFX5240-64OD QFX5241-64OD |
128 | 128 ÷ 2 = 64 | 8 | 64 serveurs x 8 GPU/serveur = 512 GPU |
- Les commutateurs QFX5220-32CD sont dotés de 32 ports 400GE (16 pour se connecter aux serveurs et 16 pour les nœuds spine)
- Les commutateurs QFX5230-64CD offrent jusqu’à 64 ports 400GE (32 pour se connecter aux serveurs et 32 pour se connecter aux nœuds spine).
- Les commutateurs QFX5240-64OD fournissent jusqu’à 128 ports 400GE (64 pour se connecter aux serveurs et 64 pour les nœuds spine).
Pour obtenir des échelles plus grandes, plusieurs bandes (N3) peuvent être connectées à l’aide d’un ensemble de nœuds Spine (N4), comme illustré sur la Figure 10.
Figure 16 : Plusieurs bandes connectées à travers des nœuds Spine.
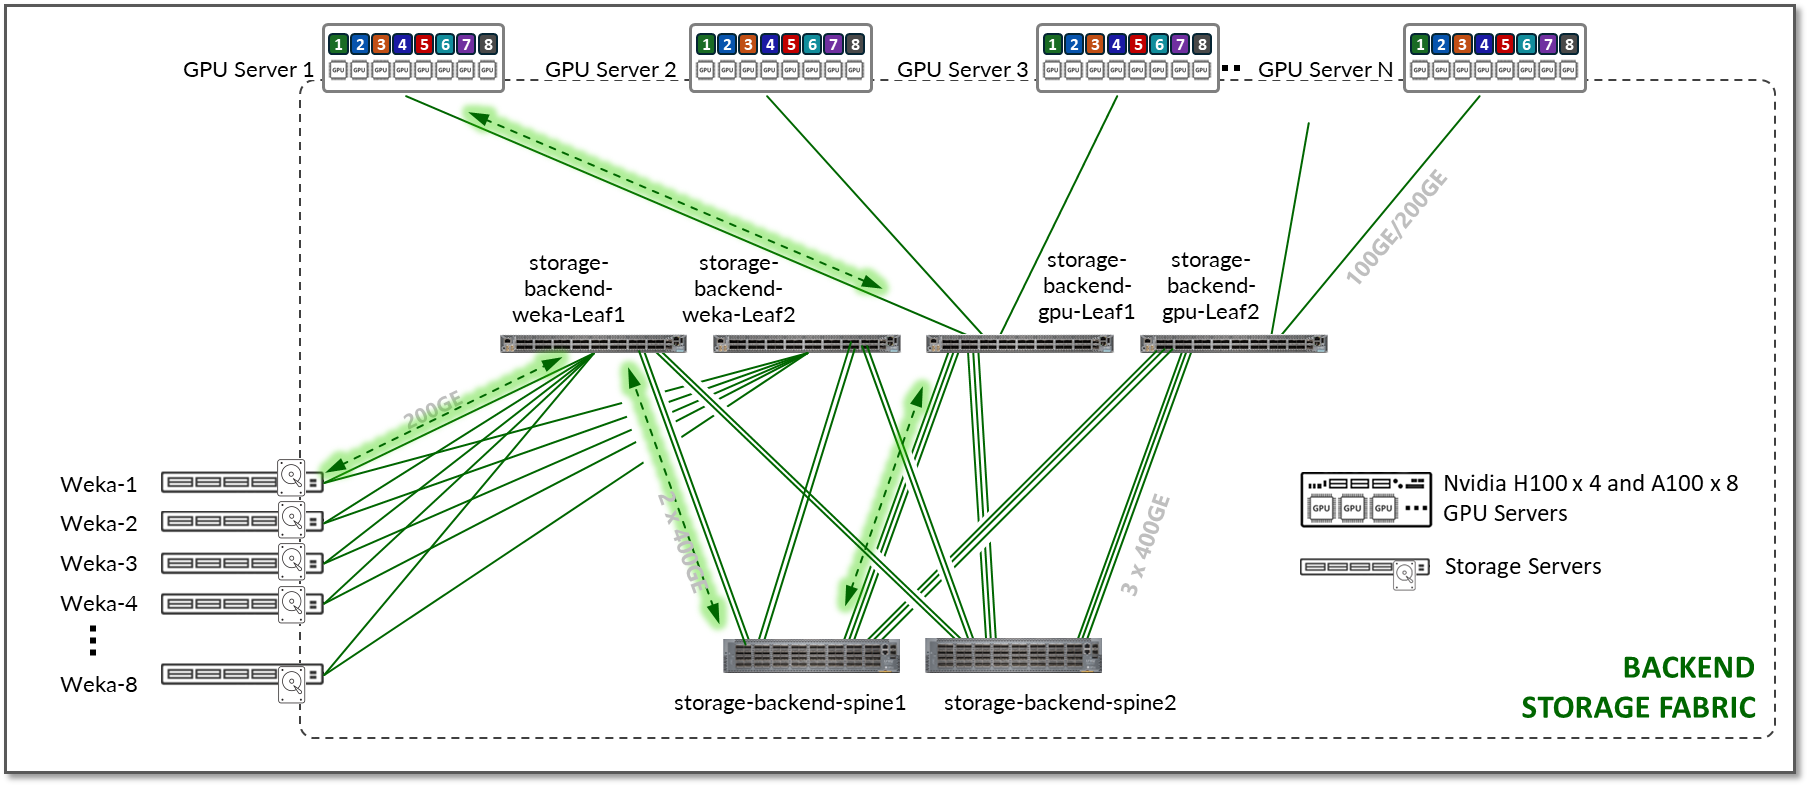
Le nombre de bandes requises (N3 ) est calculé en fonction du nombre requis de GPU et du nombre maximal de GPU par bande (N2).
Par exemple, supposons que le nombre requis de GPU (GPU) est de 16 000 et que la fabric utilise QFX5240-64OD comme nœuds Leaf.
Le nombre de ports 400G disponibles est de 128, ce qui signifie que :
- nombre maximal de serveurs par bande (N1) = 64
- nombre maximal de GPU par bande (N2) = 512
Le nombre de bandes (N3) requis est calculé en divisant le nombre de GPU requis et le nombre de GPU par bande comme indiqué :
N 3 (nombre de bandes) = GPU ÷ N 2 (nombre maximal de GPU par bande) = 16000 ÷ 512 = 32 bandes (arrondi à l’unité supérieure)
Avec 32 bandes et 64 serveurs par bande, le cluster peut fournir 16 384 GPU.
Connaissant le nombre de bandes requises (N 3) et le nombre de ports de liaison montante par nœud Leaf (Y), vous pouvez calculer le nombre de nœuds spine nécessaires.
Rappelez-vous X = Y = N1
Tout d’abord, le nombre total de nœuds feuilles peut être calculé en multipliant le nombre de bandes requises par 8 (nombre de nœuds feuilles par bande).
Nombre total de nœuds leaf = N3 x 8 = 32 x 8 = 256
On peut alors obtenir le nombre total de liaisons montantes en multipliant le nombre de liaisons montantes par nœud Leaf (N1) et le nombre total de nœuds Leaf.
Nombre total de liaisons montantes = N1 x 256 = 64 x 256 = 16384
Le nombre de cœurs requis (N4 ) peut ensuite être déterminé en divisant le nombre total de liaisons montantes par le nombre de ports disponibles sur chaque nœud Spine, qui, comme pour les nœuds Leaf, dépend du modèle de commutateur utilisé pour le rôle Spine.
Nombre de cœurs de réseau requis (N4 ) = 16384 / nombre de ports disponibles sur chaque nœud de cœur de réseau
Par exemple, si les nœuds spine sont QFX5240/41, le nombre de ports disponibles sur chaque nœud spine est de 128.
Tableau 17 : Nombre de nœuds épineux pour deux bandes.
| Nœud Spine Modèle du commutateur QFX |
Nombre maximal d’interfaces 400GE par commutateur | Nombre de cœurs de réseau requis (N4) avec 64 bandes |
|---|---|---|
| QFX5240-64OD | 128 | 32768 ÷ 128 = 128 |
| PTX10008 LC1201 | 288 | 32768 ÷ 288 ~ 57 |
| PTX10008 LC1301 |
576 | 32768 ÷ 576 ~ 29 |
fabric back-end de stockage
La fabric back-end de stockage fournit l’infrastructure de connectivité pour que les périphériques de stockage soient accessibles à partir des serveurs GPU.
Les performances de l’infrastructure de stockage ont un impact significatif sur l’efficacité des workflows d’IA. Un système de stockage qui fournit un accès rapide aux données peut réduire considérablement le temps nécessaire à l’entraînement des modèles d’IA. De même, un système de stockage qui prend en charge l’interrogation et l’indexation efficaces des données peut minimiser le temps de prétraitement et d’extraction des caractéristiques dans un workflow d’IA.
Dans les petits clusters, il peut suffire d’utiliser le stockage local sur chaque serveur GPU ou de l’agréger à l’aide d’un logiciel open source ou commercial. Dans les clusters plus grands avec des charges de travail plus lourdes, un système de stockage externe dédié est nécessaire pour assurer la mise en relation du jeu de données pour l’ingestion et pour le point de contrôle du cluster pendant l’entraînement.
Deux plates-formes de premier plan, WEKA et Vast Storage, fournissent des solutions de pointe pour le stockage partagé dans les environnements GPU. Bien que nous ayons testé les deux solutions dans notre laboratoire, cette JVD se concentre sur la solution de stockage Weka. Ainsi, le reste de ceci, ainsi que d’autres sections de ce document, couvrira des détails sur les périphériques de stockage Weka et la connectivité à la fabric backend de stockage.
Les détails sur le stockage Vast sont inclus dans le réseau de datacenter IA avec Juniper Apstra, les GPU AMD, la carte réseau Broadcom NIC, AMD Pollara NIC et le stockage Vast - Conception validée Juniper (JVD).
La conception de la fabric back-end de stockage de la JVD suit également une architecture IP Clos à trois niveaux, comme illustré à la figure 17. Il n’existe pas de concept d’optimisation rail dans un cluster de stockage. Chaque serveur GPU dispose d’une seule connexion aux nœuds Leaf, au lieu d’une par GPU.
Figure 17 : Architecture de la fabric back-end de stockage
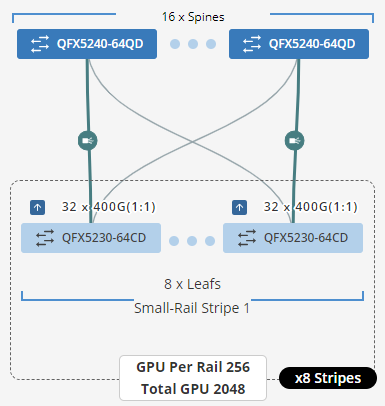
Le nombre de nœuds Leaf dépend du nombre de GPU de serveurs et de périphériques de stockage dans le cluster d’IA.
Le nombre de nœuds spine dépend du facteur d’abonnement souhaité pour la conception. Comme le fabric back-end GPU, le fabric de stockage nécessite une conception sans surabonnement (facteur d’abonnement de 1:1) afin de garantir une bande passante suffisante pour le trafic élevé et d’éviter les congestion, les pertes de paquets et les latence excessives.
Le trafic de stockage peut utiliser différents mécanismes de transport, notamment NFS, POSIX et RoCEv2. Pour RoCEv2, les mêmes mécanismes d’équilibrage de charge et de classe de service que ceux décrits pour la fabric back-end des GPU doivent être implémentés. Ils sont décrits dans les sections Équilibrage de charge et Classe de service de ce document.
Les équipements et la connectivité dans la fabric de stockage validée dans cette JVD sont résumés dans les tableaux suivants :
Tableau 18 : stockage validé fabric nœuds leaf et spine
| Modèle de commutateur de nœuds leaf de fabric de stockage | Modèlede commutateur de nœuds spine de fabric de stockage |
|---|---|
| QFX5130-32CD | QFX5130-32CD |
| QFX5220-32CD | QFX5220-32CD |
| QFX5230-32CD | QFX5230-32CD |
| QFX5230-64CD | QFX5230-64CD |
| QFX5240-64OD | QFX5240-64OD |
Tableau 19 : connexions validées entre les serveurs GPU, les périphériques de stockage et les nœuds Leaf dans la fabric de stockage
| Liens par serveur GPU vers la connexion leaf | Type de serveur |
|---|---|
| 1 x 100GE | NVIDIA A100 |
| 1 x 100GE | NVIDIA H100 |
| 1 x 200GE | WEKA |
Tableau 20 : connexions validées entre les nœuds leaf et spine dans la fabric de stockage
| Liens par connexion leaf et spine | Modèle de nœud leaf | Modèlede nœud spine |
|---|---|---|
| 2 x 400GE, 3 x 400GE | QFX5130-32CD | QFX5130-32CD |
| 2 x 400GE, 3 x 400GE | QFX5130-32CD | QFX5130-32CD |
| 2 x 400GE, 3 x 400GE | QFX5240-32CD QFX5241-32CD |
QFX5240-32CD QFX5241-32CD |
Les tests de cette JVD ont été effectués sur 8 serveurs GPU NVIDIA A100, 4 serveurs GPU NVIDIA H100 et 8 périphériques de stockage WEKA connectés à 4 nœuds Leaf, eux-mêmes connectés à 2 nœuds Spine, comme illustré à la Figure 18.
Figure 18 : Topologie de test JVD de la fabric de stockage
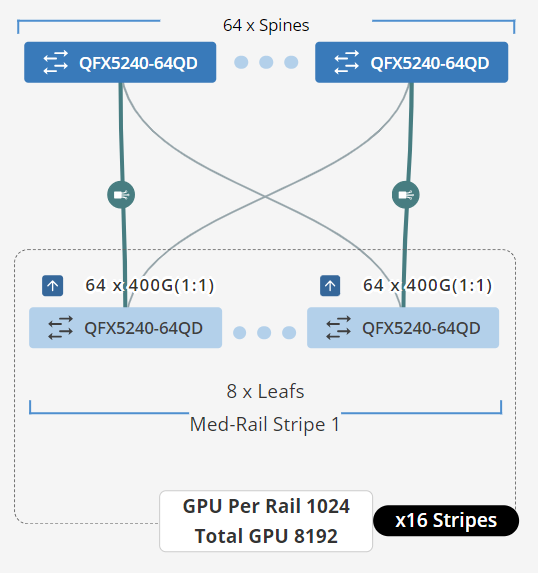
- Chaque serveur Nvidia A100 est connecté aux nœuds Leaf à l’aide d’interfaces 200G (cartes réseau ConnectX-7).
- Chaque serveur Nvidia H100 est connecté aux nœuds Leaf à l’aide d’interfaces 400G (cartes réseau ConnectX-7).
- Chaque appareil Weka
Tableau 21 : Nombre total de liaisons de stockage et bande passante testée
| Serveurs GPU <=> nœuds leaf de stockage | nœuds leaf de stockage <=> nœuds spine front-end |
|---|---|
|
Nombre total de liaisons 400GE entre nœuds leaf et spine front-end = 20 (2 à 3 liens par connexion Leaf vers le cœur de réseau) |
| Bande passante totale = 5,6 Tbit/s | Bande passante totale = 6,4 Tbit/s |
| Pas de surabonnement. |
Mise à l’échelle de la fabric back-end GPU
La taille d’un cluster d’IA varie considérablement en fonction des exigences spécifiques de la charge de travail. Le nombre de nœuds dans un cluster d’IA dépend de facteurs tels que la complexité des modèles de machine learning, la taille des jeux de données, la vitesse d’entraînement souhaitée et le budget disponible. Le nombre varie d’un petit cluster de moins de 100 nœuds à un cluster à l’échelle d’un datacenter comprenant des milliers de nœuds de calcul, de stockage et de réseau. Un minimum de 4 spines doit toujours être déployé pour diversifier les chemins et réduire les chemins de défaillance des PFC.
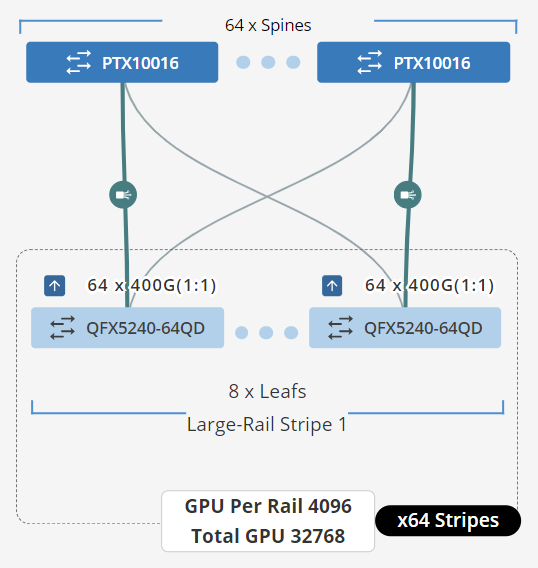
Tableau 22 : Mise à l’échelle de la fabric - Appareils et positionnement
| Petit, | Moyen, | Grand |
|---|---|---|
| 64 – 2048 GPU | GPU 2 048 – 8 192 | GPU 8192 – 32768 |
| Prenant en charge jusqu’à 2 048 GPU, les Juniper QFX5240-64CD/QFX5240-64OD/QD ou QFX5230-64CD peuvent être utilisés comme équipements Spine et Leaf pour prendre en charge des applications à une ou deux bandes. Pour respecter les bonnes pratiques, un minimum de 4 Spines doit être déployé, même dans un fabric à une seule bande. | Avec la prise en charge de 2048 à 8 192 GPU, le Juniper-QFX5240 64CD/QFX5240-64OD/QD peut être utilisé comme équipement Spine et Leaf pour obtenir une évolutivité appropriée. Cette conception de fabric en 3 étapes, basée sur rail, fournit une connectivité physique à 16 Stripes à partir de 64 nœuds Spines et 1024 nœuds Leaf, tout en maintenant un modèle de débit d’abonnement 1:1. | Pour les infrastructures prenant en charge plus de 8 192 GPU, la dorsale Juniper du châssis PTX1000x et les nœuds leaf QFX5240-64CD/QFX5240-64OD/QD peuvent prendre en charge jusqu’à 3 2 768 GPU. Cette conception de fabric basée sur rail en trois étapes fournit une connectivité physique à 64 Stripes à partir de 64 nœuds Spines et 4096 nœuds Leaf, tout en maintenant un modèle de débit d’abonnement 1:1. |
 |
 |
 |
Composants matériels et logiciels Juniper
Les produits et versions logicielles de Juniper sont disponibles ci-dessous pour la conception de cette solution. La conception documentée dans cette JVD est considérée comme la représentation de base de la solution validée. Dans le cadre d’une suite de solutions complètes, nous échangeons régulièrement des périphériques matériels contre d’autres modèles lors de tests de cas d’utilisation itératifs. Chaque plate-forme de commutation validée dans ce document est soumise aux mêmes tests rigoureux basés sur les rôles à l’aide de versions spécifiées de Junos OS et du logiciel de gestion Apstra.
Composants matériels et logiciels validés de la solution Juniper
Le tableau suivant récapitule les appareils Juniper validés pour cette JVD et inclut les appareils testés pour le réseau de datacenter IA avec Juniper Apstra, des GPU AMD et un vaste stockage – Conception validée Juniper (JVD)
Tableau 23 : Appareils validés et positionnement
| FABRIC FRONT-END DE L’APPAREIL | , GPU, FABRIC BACK-END, FABRIC DE | STOCKAGE | ||||
|---|---|---|---|---|---|---|
| FEUILLE | Colonne vertébrale | FEUILLE | Colonne vertébrale | FEUILLE | Colonne vertébrale | |
| QFX5130-32CD | X | X | X | X | ||
| QFX5220-32CD | X | X | X | X | X | |
| QFX5230-32CD | X | X | X | |||
| QFX5230-64CD | X | X | X | X | ||
| QFX5240-64OD | X | X | X | X | ||
| QFX5241-64OD | X | X | X | X | ||
| PTX10008 JNP10K-LC1201 | X | |||||
| PTX10008 JNP10K-LC1301 | X | |||||
Composants logiciels Juniper
Le tableau suivant récapitule les versions logicielles testées et validées par rôle.
Tableau 24 : Version recommandée pour la plate-forme
| Rôle | de plate-forme | Versionde Junos OS |
|---|---|---|
| QFX5240-64CD | Leaf back-end GPU | 23,4 X 100 À D20 |
| QFX5240-64OD/QD | Spine back-end GPU | 23,4 X 100 À D42 |
| QFX5220-32CD | Leaf back-end GPU | 23,4 X 100 À D20 |
| QFX5230-64CD | Leaf back-end GPU | 23,4 X 100 À D20 |
| QFX5240-64CD | Spine back-end GPU | 23,4 X 100 À D20 |
| QFX5240-64OD/QD | Spine back-end GPU | 23,4 X 100 À D42 |
| QFX5230-64CD | Spine back-end GPU | 23,4 X 100 À D20 |
| PTX10008 avec LC1201 | Spine back-end GPU | 23.4R2-S3 |
| QFX5130-32CD | Leaf front-end | 23.43R2-S3 |
| QFX5130-32CD | Front-end Spine | 23.43R2-S3 |
| QFX5220-32CD | Leaf back-end de stockage | 23,4 X 100 À D20 |
| QFX5230-64CD | Leaf back-end de stockage | 23,4 X 100 À D20 |
| QFX5240-64CD | Leaf back-end de stockage | 23,4 X 100 À D20 |
| QFX5240-64OD/QD | Leaf back-end de stockage | 23,4 X 100 À D42 |
| QFX5220-32CD | Back-end de stockage au cœur de réseau | 23,4 X 100 À D20 |
| QFX5230-64CD | Back-end de stockage au cœur de réseau | 23,4 X 100 À D20 |
| QFX5240-64CD | Back-end de stockage au cœur de réseau | 23,4 X 100 À D20 |
| QFX5240-64OD/QD | Back-end de stockage au cœur de réseau | 23,4 X 100 À D42 |