
SUR CETTE PAGE
Exemple : Configuration de routes IPv6 BGP sur un transport IPv4
Publicité des routes IPv4 sur BGP Présentation des sessions IPv6
Comprendre la redistribution des routes IPv4 avec IPv6 Prochain saut dans BGP
Configuration de BGP pour redistribuer les routes IPv4 avec des adresses de saut suivant IPv6
Comprendre les routes de flux BGP pour le filtrage du trafic
Exemple : Activation de BGP pour transporter des routes de spécification de flux
Exemple : configuration de BGP pour transporter des routes de spécification de flux IPv6
Configuration de la spécification de flux BGP Redirection vers IP
Configuration de l’action de spécification de flux BGP Rediriger vers IP pour filtrer le trafic DDoS
Transfert du trafic à l’aide de l’action DSCP de spécification de flux BGP
Configuration des stratégies pour la validation de l’itinéraire de flux
Multiprotocol BGP
Comprendre le protocole BGP multiprotocole
Multiprotocol BGP (MP-BGP) est une extension de BGP qui permet à BGP de transporter les informations de routage pour plusieurs couches réseau et familles d’adresses. MP-BGP peut transporter les routes unicast utilisées pour le routage multicast séparément des routes utilisées pour le transfert IP unicast.
Pour activer MP-BGP, configurez BGP pour qu’il transporte les informations d’accessibilité de la couche réseau (NLRI) pour les familles d’adresses autres que l’IPv4 unicast en incluant l’instruction family inet :
family inet {
    (any | flow | labeled-unicast | multicast | unicast) {
        accepted-prefix-limit {
            maximum number;
            teardown <percentage> <idle-timeout (forever | minutes)>;
            drop-excess <percentage>;
            hide-excess <percentage>;}
}
        <loops number>;
        prefix-limit {
            maximum number;
            teardown <percentage> <idle-timeout (forever | minutes)>;
            drop-excess <percentage>;
            hide-excess <percentage>;}
 }
        rib-group group-name;
        topology name {
            community {
                target identifier;
            }
        }
    }
}
Pour permettre à MP-BGP de transporter NLRI pour la famille d’adresses IPv6, ajoutez l’affirmation family inet6 :
family inet6 {
    (any | labeled-unicast | multicast | unicast) {
        accepted-prefix-limit {
            maximum number;
            teardown <percentage> <idle-timeout (forever | minutes)>;
            drop-excess <percentage>;
            hide-excess <percentage>;}
}
        <loops number>;
        prefix-limit {
            maximum number;
            teardown <percentage> <idle-timeout (forever | minutes)>;
            drop-excess <percentage>;
            hide-excess <percentage>;}
 }
        rib-group group-name;
    }
}
Sur les routeurs uniquement, pour permettre à MP-BGP de transporter le NLRI VPN (Virtual Private Network) de couche 3 pour la famille d’adresses IPv4, incluez la family inet-vpn déclaration :
family inet-vpn {
    (any | flow | multicast | unicast) {
        accepted-prefix-limit {
            maximum number;
            teardown <percentage> <idle-timeout (forever | minutes)>;
            drop-excess <percentage>;
            hide-excess <percentage>;}
}
        <loops number>;
        prefix-limit {
            maximum number;
            teardown <percentage> <idle-timeout (forever | minutes)>;
            drop-excess <percentage>;
            hide-excess <percentage>;}
}
        rib-group group-name;
    }
}
Sur les routeurs uniquement, pour permettre au MP-BGP de transporter un NLRI VPN de couche 3 pour la famille d’adresses IPv6, incluez la family inet6-vpn déclaration :
family inet6-vpn {
    (any | multicast | unicast) {
        accepted-prefix-limit {
            maximum number;
            teardown <percentage> <idle-timeout (forever | minutes)>;
            drop-excess <percentage>;
            hide-excess <percentage>;}
}
        <loops number>;
        prefix-limit {
            maximum number;
            teardown <percentage> <idle-timeout (forever | minutes)>;
            drop-excess <percentage>;
            hide-excess <percentage>;}}
        rib-group group-name;
    }
}
Sur les routeurs uniquement, pour permettre à MP-BGP de transporter le NLRI VPN multicast pour la famille d’adresses IPv4 et pour activer la signalisation VPN, incluez la family inet-mvpn déclaration :
family inet-mvpn {
    signaling {
        accepted-prefix-limit {
            maximum number;
            teardown <percentage> <idle-timeout (forever | minutes)>;
            drop-excess <percentage>;
            hide-excess <percentage>;}}
        <loops number>;
        prefix-limit {
            maximum number;
            teardown <percentage> <idle-timeout (forever | minutes)>;
            drop-excess <percentage>;
            hide-excess <percentage>;}}
    }
}
Pour permettre à MP-BGP de transporter le NLRI VPN multicast pour la famille d’adresses IPv6 et pour activer la signalisation VPN, ajoutez la family inet6-mvpn déclaration :
family inet6-mvpn {
    signaling {
        accepted-prefix-limit {
            maximum number;
            teardown <percentage> <idle-timeout (forever | minutes)>;
            drop-excess <percentage>;
            hide-excess <percentage>;}}
        <loops number>;
        prefix-limit {
            maximum number;
            teardown <percentage> <idle-timeout <forever | minutes>;
            drop-excess <percentage>;
            hide-excess <percentage>;}}
    }
}
Pour plus d’informations sur les VPN multicast multiprotocoles basés sur BGP, consultez le Guide de l’utilisateur des protocoles multicast Junos OS.
Pour obtenir la liste des niveaux hiérarchiques auxquels vous pouvez inclure ces instructions, consultez les sections récapitulatives de ces instructions.
Si vous modifiez la famille d’adresses spécifiée au niveau de la [edit protocols bgp family] hiérarchie, toutes les sessions BGP en cours sur l’équipement de routage sont supprimées, puis rétablies.
À partir de la version 9.6 de Junos OS, vous pouvez spécifier une valeur de boucles pour une famille d’adresses BGP spécifique.
Par défaut, BGP homologues ne transportent que unicast routes utilisées à des fins de transfert unicast. Pour configurer les homologues BGP afin qu’ils ne transportent que des routes de multicast, spécifiez l’option multicast . Pour configurer les homologues BGP afin qu’ils transportent à la fois des routes unicast et multicast, spécifiez l’option any .
Lorsque MP-BGP est configuré, BGP installe les routes MP-BGP dans différentes tables de routage. Chaque table de routage est identifiée par la famille de protocoles ou l’indicateur de famille d’adresses (AFI) et un identifiant de famille d’adresses (SAFI) ultérieur.
La liste suivante présente toutes les combinaisons AFI et SAFI possibles :
AFI=1, SAFI=1, IPv4 unicast
AFI=1, SAFI=2, IPv4 multicast
AFI=1, SAFI=128, L3VPN IPv4 unicast
AFI=1, SAFI=129, L3VPN IPv4 multicast
AFI=2, SAFI=1, IPv6 unicast
AFI=2, SAFI=2, multicast IPv6
AFI=25, SAFI=65, BGP-VPLS/BGP-L2VPN
AFI=2, SAFI=128, L3VPN IPv6 unicast
AFI=2, SAFI=129, L3VPN IPv6 multicast
AFI=1, SAFI=132, RT-Contraindre
AFI=1, SAFI=133, Flow-spec
AFI=1, SAFI=134, Flow-spec
AFI=3, SAFI=128, CLNS VPN
AFI=1, SAFI=5, NG-MVPN IPv4
AFI=2, SAFI=5, NG-MVPN IPv6
AFI=1, SAFI=66, MDT-SAFI
AFI=1, SAFI=4, étiqueté IPv4
AFI=2, SAFI=4, étiqueté IPv6 (6PE)
Les routes installées dans la table de routage inet.2 ne peuvent être exportées vers des homologues MP-BGP que parce qu’ils utilisent le SAFI, les identifiant comme des routes vers des sources de multicast. Les routes installées dans la table de routage inet.0 ne peuvent être exportées que vers des homologues BGP standard.
La table de routage inet.2 doit être un sous-ensemble des routes que vous avez dans inet.0, car il est peu probable que vous ayez une route vers une source de multicast vers laquelle vous ne pourriez pas envoyer de trafic unicast. La table de routage inet.2 stocke les routes unicast utilisées pour les vérifications de transfert de chemin inverse multicast et les informations supplémentaires d’accessibilité apprises par MP-BGP à partir des mises à jour multicast NLRI. Une table de routage inet.2 est automatiquement créée lorsque vous configurez MP-BGP (en définissant NLRI sur any).
Lorsque vous activez MP-BGP, vous pouvez effectuer les opérations suivantes :
- Limitation du nombre de préfixes reçus sur une session homologue BGP
- Limitation du nombre de préfixes acceptés sur une session homologue BGP
- Configuration des groupes de tables de routage BGP
- Résolution des routes vers des périphériques de routage PE situés dans d’autres AS
- Autoriser les routes étiquetées et non étiquetées
Limitation du nombre de préfixes reçus sur une session homologue BGP
Vous pouvez limiter le nombre de préfixes reçus sur une session d’pair BGP et journaliser des messages à débit limité lorsque le nombre de préfixes injectés dépasse une limite définie. Vous pouvez également supprimer l’appairage lorsque le nombre de préfixes dépasse la limite.
Pour configurer une limite au nombre de préfixes pouvant être reçus sur une session BGP, incluez l’instruction prefix-limit :
prefix-limit {
    maximum number;
    teardown <percentage> <idle-timeout (forever | minutes)>;
    drop-excess <percentage>;
    hide-excess <percentage>;
}
Pour obtenir la liste des niveaux hiérarchiques auxquels vous pouvez inclure cette instruction, consultez la section résumé de la déclaration de cette déclaration.
Pour maximum number, spécifiez une valeur comprise entre 1 et 4 294 967 295. Lorsque le nombre maximal spécifié de préfixes est dépassé, un message de journal système est envoyé.
Si vous incluez cette teardown instruction, la session est interrompue lorsque le nombre maximal de préfixes est dépassé. Si vous spécifiez un pourcentage, les messages sont consignés lorsque le nombre de préfixes dépasse ce pourcentage de la limite maximale spécifiée. Une fois la session supprimée, elle est rétablie en peu de temps (sauf si vous incluez la idle-timeout déclaration). Si vous incluez la idle-timeout déclaration, la session peut être interrompue pendant une durée spécifiée, ou pour toujours. Si vous spécifiez forever, la session n’est rétablie qu’après l’exécution d’une clear bgp neighbor commande. Si vous incluez l’option drop-excess <percentage> , les routes excédentaires sont supprimées lorsque le nombre maximal de préfixes est atteint. Si vous spécifiez un pourcentage, les itinéraires sont journalisés lorsque le nombre de préfixes dépasse cette valeur de pourcentage du nombre maximum. Si vous incluez l’option hide-excess <percentage> , les routes excédentaires sont masquées lorsque le nombre maximal de préfixes est atteint. Si vous spécifiez un pourcentage, les itinéraires sont journalisés lorsque le nombre de préfixes dépasse cette valeur de pourcentage du nombre maximum. Si le pourcentage est modifié, les routes sont réévaluées automatiquement. Si les routes actives tombent en dessous du pourcentage spécifié, ces routes sont conservées comme masquées.
À partir de la version 9.2 de Junos OS, vous pouvez également configurer une limite au nombre de préfixes pouvant être acceptés sur une session d’pair BGP. Pour plus d’informations, consultez Limitation du nombre de préfixes acceptés sur une session homologue BGP.
Limitation du nombre de préfixes acceptés sur une session homologue BGP
À partir de la version 9.2 de Junos OS, vous pouvez limiter le nombre de préfixes pouvant être acceptés sur une session d’pair BGP. Lorsque cette limite spécifiée est dépassée, un message de journal système est envoyé. Vous pouvez également spécifier de réinitialiser la session BGP si la limite du nombre de préfixes spécifiés est dépassée.
Pour configurer une limite au nombre de préfixes pouvant être acceptés sur une session de pair BGP, incluez l’instruction accepted-prefix-limit :
accepted-prefix-limit {
    maximum number;
    teardown <percentage> <idle-timeout (forever | minutes)>;
    drop <percentage>;
    hide <percentage>;
}
Pour obtenir la liste des niveaux hiérarchiques auxquels vous pouvez inclure cette instruction, consultez la section résumé de la déclaration de cette déclaration.
Pour Maximum number, spécifiez une valeur comprise entre 1 et 4 294 967 295.
Incluez l’instruction teardown permettant de réinitialiser la session d’pair BGP lorsque le nombre de préfixes acceptés dépasse la limite configurée. Vous pouvez également inclure une valeur de pourcentage comprise entre 1 et 100 pour qu’un message de journal système soit envoyé lorsque le nombre de préfixes acceptés dépasse ce pourcentage de la limite maximale. Par défaut, une session BGP réinitialisée est rétablie dans un court laps de temps. Incluez l’instruction idle-timeout permettant d’empêcher le rétablissement de la session BGP pendant une période spécifiée. Vous pouvez configurer une valeur de délai d’attente comprise entre 1 et 2400 minutes. Incluez l’option forever pour empêcher le rétablissement de la session BGP jusqu’à ce que vous émettriez la clear bgp neighbor commande. Si vous incluez l’instruction drop-excess <percentage> et spécifiez un pourcentage, les itinéraires excédentaires sont supprimés lorsque le nombre de préfixes dépasse le pourcentage. Si vous incluez l’instruction hide-excess <percentage> et spécifiez un pourcentage, les itinéraires excédentaires sont masqués lorsque le nombre de préfixes dépasse le pourcentage. Si le pourcentage est modifié, les routes sont réévaluées automatiquement.
Lorsque le routage actif ininterrompu (NSR) est activé et qu’un basculement vers un moteur de routage de secours se produit, les homologues BGP qui sont en panne sont automatiquement redémarrés. Les homologues sont redémarrés même si l’instruction idle-timeout forever est configurée.
Vous pouvez également configurer une limite au nombre de préfixes pouvant être reçus (et non acceptés) sur une session d’pair BGP. Pour plus d’informations, consultez Limitation du nombre de préfixes reçus sur une session homologue BGP.
Configuration des groupes de tables de routage BGP
Lorsqu’une session BGP reçoit un NLRI unicast ou multicast, elle installe la route dans la table appropriée (inet.0 ou inet6.0 pour unicast, et inet.2 ou inet6.2 pour multicast). Pour ajouter des préfixes de unicast aux tables de unicast et de multicast, vous pouvez configurer des groupes de tables de routage BGP. Ceci est utile si vous ne pouvez pas effectuer de négociation NLRI multicast.
Pour configurer des groupes de tables de routage BGP, incluez l’instruction rib-group :
rib-group group-name;
Pour obtenir la liste des niveaux hiérarchiques auxquels vous pouvez inclure cette instruction, consultez la section résumé de la déclaration de cette déclaration.
Résolution des routes vers des périphériques de routage PE situés dans d’autres AS
Vous pouvez autoriser le placement de routes étiquetées dans la table de routage inet.3 pour la résolution de route. Ces routes sont ensuite résolues pour les connexions d’équipements de routage en périphérie (PE) du fournisseur lorsque le PE distant est situé sur un autre système autonome (AS). Pour qu’un périphérique de routage PE installe une route dans l’instance de routage VRF (VPN Routing and Forwarding), le saut suivant doit être résolu en une route stockée dans la table inet.3 .
Pour résoudre les routes dans la table de routage inet.3 , incluez l’instruction resolve-vpn :
resolve-vpn group-name;
Pour obtenir la liste des niveaux hiérarchiques auxquels vous pouvez inclure cette instruction, consultez la section résumé de la déclaration de cette déclaration.
Autoriser les routes étiquetées et non étiquetées
Vous pouvez autoriser l’échange de routes étiquetées et non étiquetées au cours d’une même session. Les routes étiquetées sont placées dans le table de routage inet.3 ou inet6.3, et les routes unicast étiquetées et non étiquetées peuvent être envoyées ou reçues par le périphérique de routage.
Pour permettre l’échange de routes étiquetées et non étiquetées, incluez l’affirmation rib :
rib (inet.3 | inet6.3);
Pour obtenir la liste des niveaux hiérarchiques auxquels vous pouvez inclure cette instruction, consultez la section résumé de la déclaration de cette déclaration.
Exemple : Configuration de routes IPv6 BGP sur un transport IPv4
Cet exemple montre comment exporter des préfixes IPv6 et IPv4 sur une connexion IPv4 où les deux côtés sont configurés avec une interface IPv4.
Exigences
Aucune configuration spéciale au-delà de l’initialisation de l’appareil n’est requise avant de configurer cet exemple.
Vue d’ensemble
Gardez à l’esprit lorsque vous exportez des préfixes BGP IPv6 :
BGP dérive les préfixes de saut suivant à l’aide du préfixe IPv6 mappé IPv4. Par exemple, le préfixe
10.19.1.1de saut suivant IPv4 se traduit par le préfixe de saut suivant IPv6 ::ffff :10.19.1.1.Remarque :Il doit y avoir une route active vers le saut suivant IPv6 mappé IPv4 pour exporter les préfixes BGP IPv6.
Une connexion IPv6 doit être configurée sur la liaison. La connexion doit prendre la forme d’un tunnel IPv6 ou d’une configuration à double pile. Le double empilement est utilisé dans cet exemple.
Lorsque vous configurez des préfixes IPv6 mappés IPv4, utilisez un masque de plus de 96 bits.
Configurez une route statique si vous souhaitez utiliser des préfixes IPv6 normaux. Cet exemple utilise des routes statiques.
La figure 1 montre l’exemple de topologie.
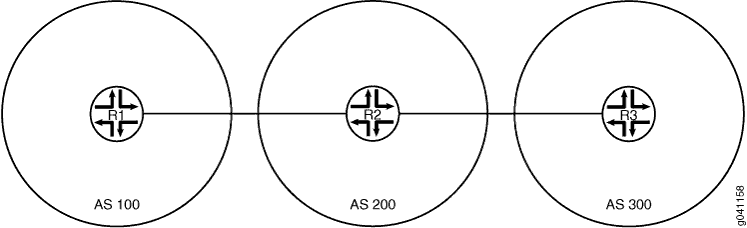 IPv4
La configuration
Configuration rapide de la CLI
Pour configurer rapidement cet exemple, copiez les commandes suivantes, collez-les dans un fichier texte, supprimez les sauts de ligne, modifiez tous les détails nécessaires pour qu’ils correspondent à votre configuration réseau, puis copiez-collez les commandes dans le CLI au niveau de la [edit] hiérarchie.
Appareil R1
set interfaces fe-1/2/0 unit 1 family inet address 192.168.10.1/24
set interfaces fe-1/2/0 unit 1 family inet6 address ::ffff:192.168.10.1/120
set interfaces lo0 unit 1 family inet address 10.10.10.1/32
set protocols bgp group ext type external
set protocols bgp group ext family inet unicast
set protocols bgp group ext family inet6 unicast
set protocols bgp group ext export send-direct
set protocols bgp group ext export send-static
set protocols bgp group ext peer-as 200
set protocols bgp group ext neighbor 192.168.10.10
set policy-options policy-statement send-direct term 1 from protocol direct
set policy-options policy-statement send-direct term 1 then accept
set policy-options policy-statement send-static term 1 from protocol static
set policy-options policy-statement send-static term 1 then accept
set routing-options rib inet6.0 static route ::ffff:192.168.20.0/120 next-hop ::ffff:192.168.10.10
set routing-options static route 192.168.20.0/24 next-hop 192.168.10.10
set routing-options autonomous-system 100
Appareil R2
set interfaces fe-1/2/0 unit 2 family inet address 192.168.10.10/24
set interfaces fe-1/2/0 unit 2 family inet6 address ::ffff:192.168.10.10/120
set interfaces fe-1/2/1 unit 3 family inet address 192.168.20.21/24
set interfaces fe-1/2/1 unit 3 family inet6 address ::ffff:192.168.20.21/120
set interfaces lo0 unit 2 family inet address 10.10.0.1/32
set protocols bgp group ext type external
set protocols bgp group ext family inet unicast
set protocols bgp group ext family inet6 unicast
set protocols bgp group ext export send-direct
set protocols bgp group ext export send-static
set protocols bgp group ext neighbor 192.168.10.1 peer-as 100
set protocols bgp group ext neighbor 192.168.20.1 peer-as 300
set policy-options policy-statement send-direct term 1 from protocol direct
set policy-options policy-statement send-direct term 1 then accept
set policy-options policy-statement send-static term 1 from protocol static
set policy-options policy-statement send-static term 1 then accept
set routing-options autonomous-system 200
Appareil R3
set interfaces fe-1/2/0 unit 4 family inet address 192.168.20.1/24
set interfaces fe-1/2/0 unit 4 family inet6 address ::ffff:192.168.20.1/120
set interfaces lo0 unit 3 family inet address 10.10.20.1/32
set protocols bgp group ext type external
set protocols bgp group ext family inet unicast
set protocols bgp group ext family inet6 unicast
set protocols bgp group ext export send-direct
set protocols bgp group ext export send-static
set protocols bgp group ext peer-as 200
set protocols bgp group ext neighbor 192.168.20.21
set policy-options policy-statement send-direct term 1 from protocol direct
set policy-options policy-statement send-direct term 1 then accept
set policy-options policy-statement send-static term 1 from protocol static
set policy-options policy-statement send-static term 1 then accept
set routing-options rib inet6.0 static route ::ffff:192.168.10.0/120 next-hop ::ffff:192.168.20.21
set routing-options static route 192.168.10.0/24 next-hop 192.168.20.21
set routing-options autonomous-system 300
Configuration de l’équipement R1
Procédure étape par étape
L’exemple suivant vous oblige à naviguer à différents niveaux dans la hiérarchie de configuration. Pour plus d’informations sur la navigation dans la CLI, reportez-vous à la section Utilisation de l’éditeur CLI en mode configuration dans le Guide de l’utilisateur de la CLI de Junos OS.
Pour configurer l’appareil R1 :
Configurez les interfaces, y compris une adresse IPv4 et une adresse IPv6.
[edit interfaces]
user@R1# set fe-1/2/0 unit 1 family inet address 192.168.10.1/24
user@R1# set fe-1/2/0 unit 1 family inet6 address ::ffff:192.168.10.1/120
user@R1# set lo0 unit 1 family inet address 10.10.10.1/32
Configurez EBGP.
[edit protocols bgp group ext]
user@R1# set type external
user@R1# set export send-direct
user@R1# set export send-static
user@R1# set peer-as 200
user@R1# set neighbor 192.168.10.10
-
Permettez aux BGP d’acheminer des routes unicast IPv4 unicast et IPv6.
[edit protocols bgp group ext]
user@R1# set family inet unicast
user@R1# set family inet6 unicast
Les routes unicast IPv4 sont activées par défaut. Toutefois, lorsque vous configurez d’autres familles d’adresses NLRI, l’unicast IPv4 doit être configuré explicitement.
-
Configurez la politique de routage.
[edit policy-options]
user@R1# set policy-statement send-direct term 1 from protocol direct
user@R1# set policy-statement send-direct term 1 then accept
user@R1# set policy-statement send-static term 1 from protocol static
user@R1# set policy-statement send-static term 1 then accept
Configurez des routes statiques.
[edit routing-options]
user@R1# set rib inet6.0 static route ::ffff:192.168.20.0/120 next-hop ::ffff:192.168.10.10
user@R1# set static route 192.168.20.0/24 next-hop 192.168.10.10
Configurez le numéro du système autonome (AS).
[edit routing-options]
user@R1# set autonomous-system 100
Résultats
En mode configuration, confirmez votre configuration en entrant les show interfacescommandes , show policy-optionsshow protocols, , et show routing-options . Si la sortie n’affiche pas la configuration prévue, répétez les instructions de cet exemple pour corriger la configuration.
user@R1# show interfaces
fe-1/2/0 {
    unit 1 {
        family inet {
            address 192.168.10.1/24;
        }
        family inet6 {
            address ::ffff:192.168.10.1/120;
        }
    }
}
lo0 {
    unit 1 {
        family inet {
            address 10.10.10.1/32;
        }
    }
}
user@R1# show policy-options
policy-statement send-direct {
    term 1 {
        from protocol direct;
        then accept;
    }
}
policy-statement send-static {
    term 1 {
        from protocol static;
        then accept;
    }
}
user@R1# show protocols
bgp {
    group ext {
        type external;
        family inet {
            unicast;
        }
        family inet6 {
            unicast;
        }
        export [ send-direct send-static ];
        peer-as 200;
        neighbor 192.168.10.10;
    }
}
user@R1# show routing-options
rib inet6.0 {
    static {
        route ::ffff:192.168.20.0/120 next-hop ::ffff:192.168.10.10;
    }
}
static {
    route 192.168.20.0/24 next-hop 192.168.10.10;
}
autonomous-system 100;
Si vous avez terminé de configurer l’appareil, entrez Valider à partir du mode configuration. Répétez la configuration sur l’équipement R2 et l’équipement R3, en modifiant les noms d’interface et les adresses IP, si nécessaire.
Vérification
Vérifiez que la configuration fonctionne correctement.
Vérification de l’état du voisin
Objet
Assurez-vous que BGP est activé pour transporter les routes unicast IPv6.
Mesures à prendre
À partir du mode opérationnel, entrez la show bgp neighbor commande.
user@R2> show bgp neighbor
Peer: 192.168.10.1+179 AS 100  Local: 192.168.10.10+54226 AS 200
  Type: External    State: Established    Flags: <Sync>
  Last State: OpenConfirm   Last Event: RecvKeepAlive
  Last Error: None
  Export: [ send-direct send-static ]
  Options: <Preference AddressFamily PeerAS Refresh>
  Address families configured: inet-unicast inet6-unicast
  Holdtime: 90 Preference: 170
  Number of flaps: 0
  Peer ID: 10.10.10.1      Local ID: 10.10.0.1         Active Holdtime: 90
  Keepalive Interval: 30         Peer index: 0
  BFD: disabled, down
  Local Interface: fe-1/2/0.2
  NLRI for restart configured on peer: inet-unicast inet6-unicast
  NLRI advertised by peer: inet-unicast inet6-unicast
  NLRI for this session: inet-unicast inet6-unicast
  Peer supports Refresh capability (2)
  Stale routes from peer are kept for: 300
  Peer does not support Restarter functionality
  NLRI that restart is negotiated for: inet-unicast inet6-unicast
  NLRI of received end-of-rib markers: inet-unicast inet6-unicast
  NLRI of all end-of-rib markers sent: inet-unicast inet6-unicast
  Peer supports 4 byte AS extension (peer-as 100)
  Peer does not support Addpath
  Table inet.0 Bit: 10000
    RIB State: BGP restart is complete
    Send state: in sync
    Active prefixes:              1
    Received prefixes:            3
    Accepted prefixes:            2
    Suppressed due to damping:    0
    Advertised prefixes:          4
  Table inet6.0 Bit: 20000
    RIB State: BGP restart is complete
    Send state: in sync
    Active prefixes:              0
    Received prefixes:            1
    Accepted prefixes:            1
    Suppressed due to damping:    0
    Advertised prefixes:          2
  Last traffic (seconds): Received 24   Sent 12   Checked 60
  Input messages:  Total 132    Updates 6       Refreshes 0     Octets 2700
  Output messages: Total 133    Updates 3       Refreshes 0     Octets 2772
  Output Queue[0]: 0
  Output Queue[1]: 0

Peer: 192.168.20.1+179 AS 300  Local: 192.168.20.21+54706 AS 200
  Type: External    State: Established    Flags: <Sync>
  Last State: OpenConfirm   Last Event: RecvKeepAlive
  Last Error: None
  Export: [ send-direct send-static ]
  Options: <Preference AddressFamily PeerAS Refresh>
  Address families configured: inet-unicast inet6-unicast
  Holdtime: 90 Preference: 170
  Number of flaps: 0
  Peer ID: 10.10.20.1      Local ID: 10.10.0.1         Active Holdtime: 90
  Keepalive Interval: 30         Peer index: 1
  BFD: disabled, down
  Local Interface: fe-1/2/1.3
  NLRI for restart configured on peer: inet-unicast inet6-unicast
  NLRI advertised by peer: inet-unicast inet6-unicast
  NLRI for this session: inet-unicast inet6-unicast
  Peer supports Refresh capability (2)
  Stale routes from peer are kept for: 300
  Peer does not support Restarter functionality
  NLRI that restart is negotiated for: inet-unicast inet6-unicast
  NLRI of received end-of-rib markers: inet-unicast inet6-unicast
  NLRI of all end-of-rib markers sent: inet-unicast inet6-unicast
  Peer supports 4 byte AS extension (peer-as 300)
  Peer does not support Addpath
  Table inet.0 Bit: 10000
    RIB State: BGP restart is complete
    Send state: in sync
    Active prefixes:              1
    Received prefixes:            3
    Accepted prefixes:            2
    Suppressed due to damping:    0
    Advertised prefixes:          4
  Table inet6.0 Bit: 20000
    RIB State: BGP restart is complete
    Send state: in sync
    Active prefixes:              0
    Received prefixes:            1
    Accepted prefixes:            1
    Suppressed due to damping:    0
    Advertised prefixes:          2
  Last traffic (seconds): Received 1    Sent 15   Checked 75
  Input messages:  Total 133    Updates 6       Refreshes 0     Octets 2719
  Output messages: Total 131    Updates 3       Refreshes 0     Octets 2734
  Output Queue[0]: 0
  Output Queue[1]: 0
Signification
Les différentes occurrences de inet6-unicast dans la sortie montrent que BGP est activé pour transporter des routes unicast IPv6.
Vérification de la table de routage
Objet
Assurez-vous que l’appareil R2 dispose de routes BGP dans sa table de routage inet6.0.
Mesures à prendre
À partir du mode opérationnel, entrez la show route protocol bgp inet6.0 commande.
user@R2> show route protocol bgp table inet6.0
inet6.0: 7 destinations, 10 routes (7 active, 0 holddown, 0 hidden)
+ = Active Route, - = Last Active, * = Both

::ffff:192.168.10.0/120  [BGP/170] 01:03:49, localpref 100, from 192.168.20.1
                      AS path: 300 I
                    > to ::ffff:192.168.20.21 via fe-1/2/1.3
::ffff:192.168.20.0/120  [BGP/170] 01:03:53, localpref 100, from 192.168.10.1
                      AS path: 100 I
                    > to ::ffff:192.168.10.10 via fe-1/2/0.2
Publicité des routes IPv4 sur BGP Présentation des sessions IPv6
Dans un réseau IPv6, le BGP publie généralement les informations d’accessibilité de la couche réseau IPv6 sur une session IPv6 entre homologues BGP. Dans les versions précédentes, Junos OS ne prenait en charge que l’échange de familles d’adresses étiquetées inet6 unicast, inet6 unicast multicast ou inet6. Cette fonctionnalité permet l’échange de toutes les familles d’adresses BGP. Dans un environnement à double pile basé sur IPv6. Cette fonctionnalité permet à BGP d’annoncer l’accessibilité de l’unicast IPv4 avec un saut suivant IPv4 sur une session BGP IPv6.
Cette fonctionnalité est réservée aux sessions IPv6 BGP, où IPv4 est configuré aux deux points de terminaison. Il peut s’agir local-ipv4-address d’une adresse de bouclage ou de n’importe quelle adresse ipv4 pour une session IBGP ou EBGP à sauts multiples. Pour les haut-parleurs BGP externes à saut unique qui ne font pas partie des confédérations BGP, si l’adresse IPv4 locale configurée n’est pas directement connectée, la session BGP est fermée et reste inactive et une erreur est générée, qui s’affiche dans la sortie de la show bgp neighbor commande.
Pour activer la publication de routes IPv4 sur une session IPv6, configurez local-ipv4-address comme suit :
[edit protocols bgp family inet unicast]
local-ipv4-address local ipv4 address;
Vous ne pouvez pas configurer cette fonctionnalité pour les familles d’adresses inet6 unicast, inet6 multicast ou inet6 labeled-unicast, car BGP a déjà la capacité de publier ces familles d’adresses sur une session IPv6 BGP.
Le configuré local-ipv4-address n’est utilisé que lorsque BGP annonce des routes avec un saut suivant. Lorsque l’IBGP annonce des routes apprises à partir d’homologues EBGP ou que le réflecteur de route annonce des routes BGP à ses clients, BGP ne modifie pas le saut suivant de route, ignore le saut suivant configuré local-ipv4-addresset utilise le saut suivant IPv4 d’origine.
Voir aussi
Exemple : Annonce de routes IPv4 sur des sessions BGP IPv6
Cet exemple montre comment publier des routes IPv4 sur une session IPv6 BGP. Dans un environnement à double pile centré sur IPv6, il est nécessaire d’atteindre des hôtes IPv4 distants. Par conséquent, le BGP annonce les routes IPv4 avec les sauts suivants IPv4 vers les homologues BGP via des sessions BGP à l’aide des adresses source et de destination IPv6. Cette fonctionnalité permet à BGP d’annoncer l’accessibilité IPv4 unicast avec un saut suivant IPv4 sur des sessions BGP IPv6.
Exigences
Cet exemple utilise les composants matériels et logiciels suivants :
-
Trois routeurs avec double empilage
-
Junos OS version 16.1 ou ultérieure s’exécutant sur tous les équipements
Avant d’activer les annonces IPv4 sur des sessions BGP IPv6, veillez à :
-
Configurez les interfaces des appareils.
-
Configurez le double empilage sur tous les appareils.
Vue d’ensemble
À partir de la version 16.1, Junos OS permet à BGP d’annoncer l’accessibilité de l’unicast IPv4 avec le saut suivant IPv4 sur une session BGP IPv6. Dans les versions antérieures Junos OS, BGP ne pouvait annoncer que les familles d’adresses inet6 unicast, inet6 multicast et inet6 étiquetées unicast sur des sessions IPv6 BGP. Cette fonctionnalité permet à BGP d’échanger toutes les familles d’adresses BGP au cours d’une session IPv6. Vous pouvez activer BGP pour annoncer des routes IPv4 avec des sauts suivants IPv4 vers des homologues BGP sur une session IPv6. Le configuré local-ipv4-address n’est utilisé que lorsque BGP annonce des routes avec un saut suivant.
Vous ne pouvez pas configurer cette fonctionnalité pour les familles d’adresses inet6 unicast, inet6 multicast ou inet6 labeled-unicast, car BGP a déjà la capacité de publier ces familles d’adresses sur une session IPv6 BGP.
Topologie
Sur la Figure 2, une session BGP externe IPv6 est en cours d’exécution entre les routeurs R1 et R2. Une session IBGP IPv6 est établie entre le routeur R2 et le routeur R3. Les routes statiques IPv4 sont redistribuées au BGP sur R1. Pour redistribuer les routes IPv4 sur la session IPv6 BGP, la nouvelle fonctionnalité doit être activée sur tous les routeurs au niveau de la [edit protocols bgp address family] hiérarchie.
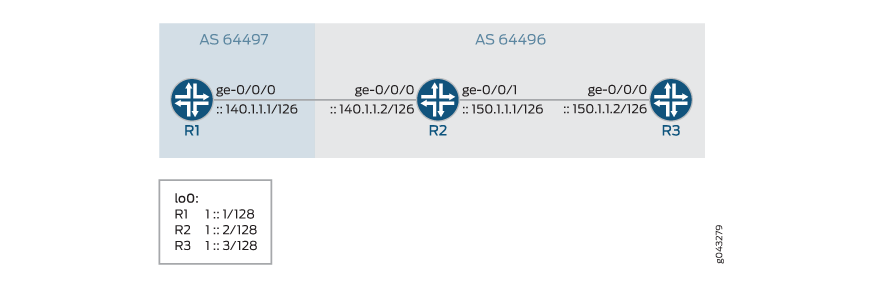 BGP IPv6
La configuration
Configuration rapide de la CLI
Pour configurer rapidement cet exemple, copiez les commandes suivantes, collez-les dans un fichier texte, supprimez les sauts de ligne, modifiez tous les détails nécessaires pour qu’ils correspondent à votre configuration réseau, copiez et collez les commandes dans la CLI au niveau de la [edit] hiérarchie, puis entrez commit en mode configuration.
Routeur R1
set interfaces ge-0/0/0 unit 0 description R1->R2
set interfaces ge-0/0/0 unit 0 family inet address 140.1.1.1/24
set interfaces ge-0/0/0 unit 0 family inet6 address ::140.1.1.1/126
set interfaces lo0 unit 0 family inet6 address 1::1/128
set routing-options static route 11.1.1.1/32 discard
set routing-options static route 11.1.1.2/32 discard
set routing-options autonomous-system 64497
set protocols bgp group ebgp-v6 type external
set protocols bgp group ebgp-v6 export p1
set protocols bgp group ebgp-v6 peer-as 64496
set protocols bgp group ebgp-v6 neighbor ::140.1.1.2 description R2
set protocols bgp group ebgp-v6 neighbor ::140.1.1.2 family inet unicast local-ipv4-address 140.1.1.1
set policy-options policy-statement p1 from protocol static
set policy-options policy-statement p1 then accept
Routeur R2
set interfaces ge-0/0/0 unit 0 description R2->R1
set interfaces ge-0/0/0 unit 0 family inet address 140.1.1.2/24
set interfaces ge-0/0/0 unit 0 family inet6 address ::140.1.1.2/126
set interfaces ge-0/0/1 unit 0 description R2->R3
set interfaces ge-0/0/1 unit 0 family inet address 150.1.1.1/24
set interfaces ge-0/0/1 unit 0 family inet6 address ::150.1.1.1/126
set interfaces lo0 unit 0 family inet6 address 1::2/128
set routing-options autonomous-system 64496
set protocols bgp group ibgp-v6 type internal
set protocols bgp group ibgp-v6 export change-nh
set protocols bgp group ibgp-v6 neighbor ::150.1.1.2 description R3
set protocols bgp group ibgp-v6 neighbor ::150.1.1.2 family inet unicast local-ipv4-address 150.1.1.1
set protocols bgp group ebgp-v6 type external
set protocols bgp group ebgp-v6 peer-as 64497
set protocols bgp group ebgp-v6 neighbor ::140.1.1.1 description R1
set protocols bgp group ebgp-v6 neighbor ::140.1.1.1 family inet unicast local-ipv4-address 140.1.1.2
set policy-options policy-statement change-nh from protocol bgp
set policy-options policy-statement change-nh then next-hop self
set policy-options policy-statement change-nh then accept
Routeur R3
set interfaces ge-0/0/0 unit 0 description R3->R2
set interfaces ge-0/0/0 unit 0 family inet address 150.1.1.2/24
set interfaces ge-0/0/0 unit 0 family inet6 address ::150.1.1.2/126
set interfaces lo0 unit 0 family inet6 address 1::3/128
set routing-options autonomous-system 64496
set protocols bgp group ibgp-v6 type internal
set protocols bgp group ibgp-v6 neighbor ::150.1.1.1 description R2
set protocols bgp group ibgp-v6 neighbor ::150.1.1.1 family inet unicast local-ipv4-address 150.1.1.2
Configuration du routeur R1
Procédure étape par étape
L’exemple suivant nécessite que vous naviguiez à différents niveaux dans la hiérarchie de configuration. Pour plus d’informations sur la navigation dans la CLI, consultez Utilisation de l’éditeur CLI en mode configuration dans le Guide de l’utilisateur de la CLI.
Pour configurer le routeur R1 :
Répétez cette procédure pour d’autres routeurs après avoir modifié les noms d’interface, les adresses et d’autres paramètres appropriés.
-
Configurez les interfaces avec des adresses IPv4 et IPv6.
[edit interfaces]
user@R1# set ge-0/0/0 unit 0 description R1->R2
user@R1# set ge-0/0/0 unit 0 family inet address 140.1.1.1/24
user@R1# set ge-0/0/0 unit 0 family inet6 address ::140.1.1.1/126
-
Configurez l’adresse de bouclage.
[edit interfaces]
user@R1# set lo0 unit 0 family inet6 address 1::1/128
-
Configurez une route statique IPv4 qui doit être publiée.
[edit routing-options]
user@R1# set static route 11.1.1.1/32 discard
user@R1# set static route 11.1.1.2/32 discard
-
Configurez le système autonome pour les hôtes BGP.
[edit routing-options]
user@R1# set autonomous-system 64497
-
Configurez EBGP sur les routeurs de périphérie externes.
[edit protocols]
user@R1# set bgp group ebgp-v6 type external
user@R1# set bgp group ebgp-v6 peer-as 64496
user@R1# set bgp group ebgp-v6 neighbor ::140.1.1.2 description R2
-
Activez la fonctionnalité pour annoncer IPv4 adddress 140.1.1.1 sur les sessions BGP IPv6.
[edit protocols]
user@R1# set bgp group ebgp-v6 neighbor ::140.1.1.2 family inet unicast local-ipv4-address 140.1.1.1
-
Définir une stratégie p1 pour accepter toutes les routes statiques.
[edit policy-options]
user@R1# set policy-statement p1 from protocol static
user@R1# set policy-statement p1 then accept
-
Appliquez la politique p1 sur le groupe EBGP ebgp-v6.
[edit protocols]
user@R1# set bgp group ebgp-v6 export p1
Résultats
En mode configuration, confirmez votre configuration en entrant les show interfacescommandes , show protocolsshow routing-options, , et show policy-options . Si la sortie n’affiche pas la configuration prévue, répétez les instructions de cet exemple pour corriger la configuration.
[edit]
user@R1# show interfaces
ge-0/0/0 {
    unit 0 {
        description R1->R2;
        family inet {
            address 140.1.1.1/24;
        }
        family inet6 {
            address ::140.1.1.1/126;
        }
    }
    lo0 {
        unit 0 {
            family inet {
                address 1::1/128;
            }
        }
    }
}
[edit]
user@R1# show protocols
bgp {
    group ebgp-v6 {
        type external;
        export p1;
        peer-as 64496;
        neighbor ::140.1.1.2 {
            description R2;
            family inet {
                unicast {
                    local-ipv4-address 140.1.1.1;
                }
            }
        }
    }
}
[edit]
user@R1# show routing-options
static {
    route 11.1.1.1/32 discard;
    route 11.1.1.2/32 discard;
}
autonomous-system 64497;
[edit]
user@R1# show policy-options
policy-statement p1 {
    from {
        protocol static;
    }
    then accept;
}
Si vous avez terminé de configurer l’appareil, validez la configuration.
user@R1# commit
Vérification
Vérifiez que la configuration fonctionne correctement.
- Vérification de la disponibilité de la session BGP
- Vérification de l’affichage de l’adresse IPv4
- Vérification que le routeur voisin BGP R2 reçoit l’adresse IPv4 annoncée
Vérification de la disponibilité de la session BGP
Objet
Vérifiez que le protocole BGP est en cours d’exécution sur les interfaces configurées et que la session BGP est active pour chaque adresse voisine.
Mesures à prendre
À partir du mode opérationnel, exécutez la commande sur le show bgp summary routeur R1.
user@R1> show bgp summary
Groups: 1 Peers: 1 Down peers: 0
Table          Tot Paths  Act Paths Suppressed    History Damp State    Pending
inet.0
                       0          0          0          0          0          0
Peer                     AS      InPkt     OutPkt    OutQ   Flaps Last Up/Dwn State|#Active/Received/Accepted/Damped...
::140.1.1.2             64496       4140       4158       0       0  1d 7:10:36 0/0/0/0              0/0/0/0
Signification
La session BGP est en cours d’exécution, et l’appairage BGP est établi.
Vérification de l’affichage de l’adresse IPv4
Objet
Vérifiez que l’adresse IPv4 configurée est annoncée par le routeur R1 aux voisins BGP configurés.
Mesures à prendre
À partir du mode opérationnel, exécutez la commande sur le show route advertising-protocol bgp ::150.1.1.2 routeur R1.
user@R1> show route advertising-protocol bgp ::150.1.1.2
inet.0: 48 destinations, 48 routes (48 active, 0 holddown, 0 hidden)
  Prefix		  Nexthop	       MED     Lclpref    AS path
* 11.1.1.1/32       Self                         64497        64497 I
* 11.1.1.2/32       Self                         64497        64497 I
Signification
La route IPv4 statique est annoncée au routeur voisin BGP R2.
Vérification que le routeur voisin BGP R2 reçoit l’adresse IPv4 annoncée
Objet
Vérifiez que le routeur R2 reçoit l’adresse IPv4 que le routeur R1 annonce au voisin BGP sur IPv6.
Mesures à prendre
user@R2> show route receive-protocol bgp ::140.1.1.1
inet.0: 48 destinations, 48 routes (48 active, 0 holddown, 0 hidden)
  Prefix		  Nexthop	       MED     Lclpref    AS path
* 11.1.1.1/32        140.1.1.1                               64497 I
* 11.1.1.2/32        140.1.1.1                               64497 I

iso.0: 1 destinations, 1 routes (1 active, 0 holddown, 0 hidden)

inet6.0: 9 destinations, 10 routes (9 active, 0 holddown, 0 hidden)
Signification
La présence de la route IPv4 statique dans la table de routage du routeur R2 indique qu’il reçoit les routes IPv4 annoncées par le routeur R1.
Comprendre la redistribution des routes IPv4 avec IPv6 Prochain saut dans BGP
Dans un réseau qui transporte principalement du trafic IPv6, il est nécessaire de router les routes IPv4 si nécessaire. Par exemple, un fournisseur de services Internet qui dispose d’un réseau exclusivement IPv6, mais dont les clients continuent d’acheminer le trafic IPv4. Dans ce cas, il est nécessaire de répondre à ces clients et de transférer le trafic IPv4 sur un réseau IPv6. Comme décrit dans la RFC 5549, Publicité des informations d’accessibilité de la couche réseau IPv4 avec un saut suivant IPv6 , le trafic IPv4 est tunnelisé depuis les équipements CPE (Customer Premises Equipment) vers les passerelles IPv4 sur IPv6. Ces passerelles sont annoncées aux équipements CPE par le biais d’adresses anycast. Les passerelles créent ensuite des tunnels IPv4 sur IPv6 dynamiques vers des équipements CPE distants et annoncent des routes agrégées IPv4 pour orienter le trafic.
La fonctionnalité de tunnel IPv4 sur IPv6 dynamique ne prend pas en charge l’ISSU unifié dans Junos OS version 17.3R1.
Les réflecteurs de route (RR) dotés d’une interface programmable sont connectés via IBGP aux routeurs de passerelle et aux routes hôtes avec l’adresse IPv6 comme saut suivant. Ces RR annoncent les adresses IPv4 /32 pour injecter les informations du tunnel dans le réseau. Les routeurs de passerelle créent des tunnels IPv4 sur IPv6 dynamiques vers la périphérie du fournisseur client distant. Le routeur de passerelle annonce également les routes agrégées IPv4 pour diriger le trafic. Le RR annonce ensuite les routes sources du tunnel au FAI. Lorsque le RR supprime la route du tunnel, BGP la retire également, ce qui entraîne la destruction du tunnel et l’accès au CPE. Le routeur de passerelle retire également les routes agrégées IPv4 et les routes source de tunnel IPv6 lorsque toutes les routes agrégées contributrices sont supprimées. Le routeur de passerelle envoie une route retirée lorsque la carte de ligne du moteur de transfert de paquets d’ancre tombe en panne, de sorte qu’elle redirige le trafic vers d’autres routeurs de passerelle.
Les extensions suivantes sont introduites pour prendre en charge les routes IPv4 avec un saut suivant IPv6 :
- Encodage du saut suivant BGP
- Localisation des tunnels
- Gestion des tunnels
- Gestion des défaillances du moteur de transfert de paquets et équilibrage de charge dans les tunnels et du moteur de transfert de paquets d’ancrage
- Statistiques de flux de bouclage de tunnel
Encodage du saut suivant BGP
BGP est étendu avec la capacité de codage next hop qui est utilisée pour envoyer des routes IPv4 avec des sauts suivants IPv6. Si cette fonctionnalité n’est pas disponible sur l’homologue distant, BGP regroupe les homologues en fonction de cette capacité d’encodage et supprime la famille BGP sans capacité d’encodage de la liste d’informations d’accessibilité de la couche réseau (NLRI) négociée. Junos OS n’autorise qu’une seule table de résolution, telle que inet.0. Pour autoriser les routes BGP IPv4 avec IPv6, BGP crée un arbre de résolution. Cette fonctionnalité permet à une table de routage Junos OS d’avoir plusieurs arbres de résolution.
Outre la RFC 5549, Publicité des informations d’accessibilité de la couche réseau IPv4 avec un saut suivant IPv6 Une nouvelle communauté d’encapsulation spécifiée dans la RFC 5512, l’identificateur de famille d’adresses ultérieures d’encapsulation BGP (SAFI) et l’attribut d’encapsulation de tunnel BGP sont introduits pour déterminer la famille d’adresses de l’adresse de saut suivant. La communauté d’encapsulation indique le type de tunnels que le nœud d’entrée doit créer. Lorsque BGP reçoit des routes IPv4 avec une adresse de saut suivant IPv6 et la communauté d’encapsulation V4oV6, BGP crée des tunnels dynamiques IPv4 sur IPv6. Lorsque BGP reçoit des routes sans la communauté d’encapsulation, les routes BGP sont résolues sans créer le tunnel V4oV6.
Une nouvelle action dynamic-tunnel-attributes dyan-attribute de stratégie est disponible au niveau de la [edit policy-statement policy name term then] hiérarchie pour prendre en charge la nouvelle encapsulation étendue.
Localisation des tunnels
L’infrastructure dynamique des tunnels est améliorée avec la localisation des tunnels afin de prendre en charge un plus grand nombre de tunnels. La localisation des tunnels est nécessaire pour assurer la résilience nécessaire à la gestion du trafic en cas de défaillance de l’ancre. Un ou plusieurs châssis se sauvegardent les uns les autres et laissent le processus RPD (Routing Protocol Process) diriger le trafic du point de défaillance vers le châssis de secours. Le châssis annonce uniquement ces préfixes agrégés au lieu des adresses de bouclage individuelles dans le réseau.
Gestion des tunnels
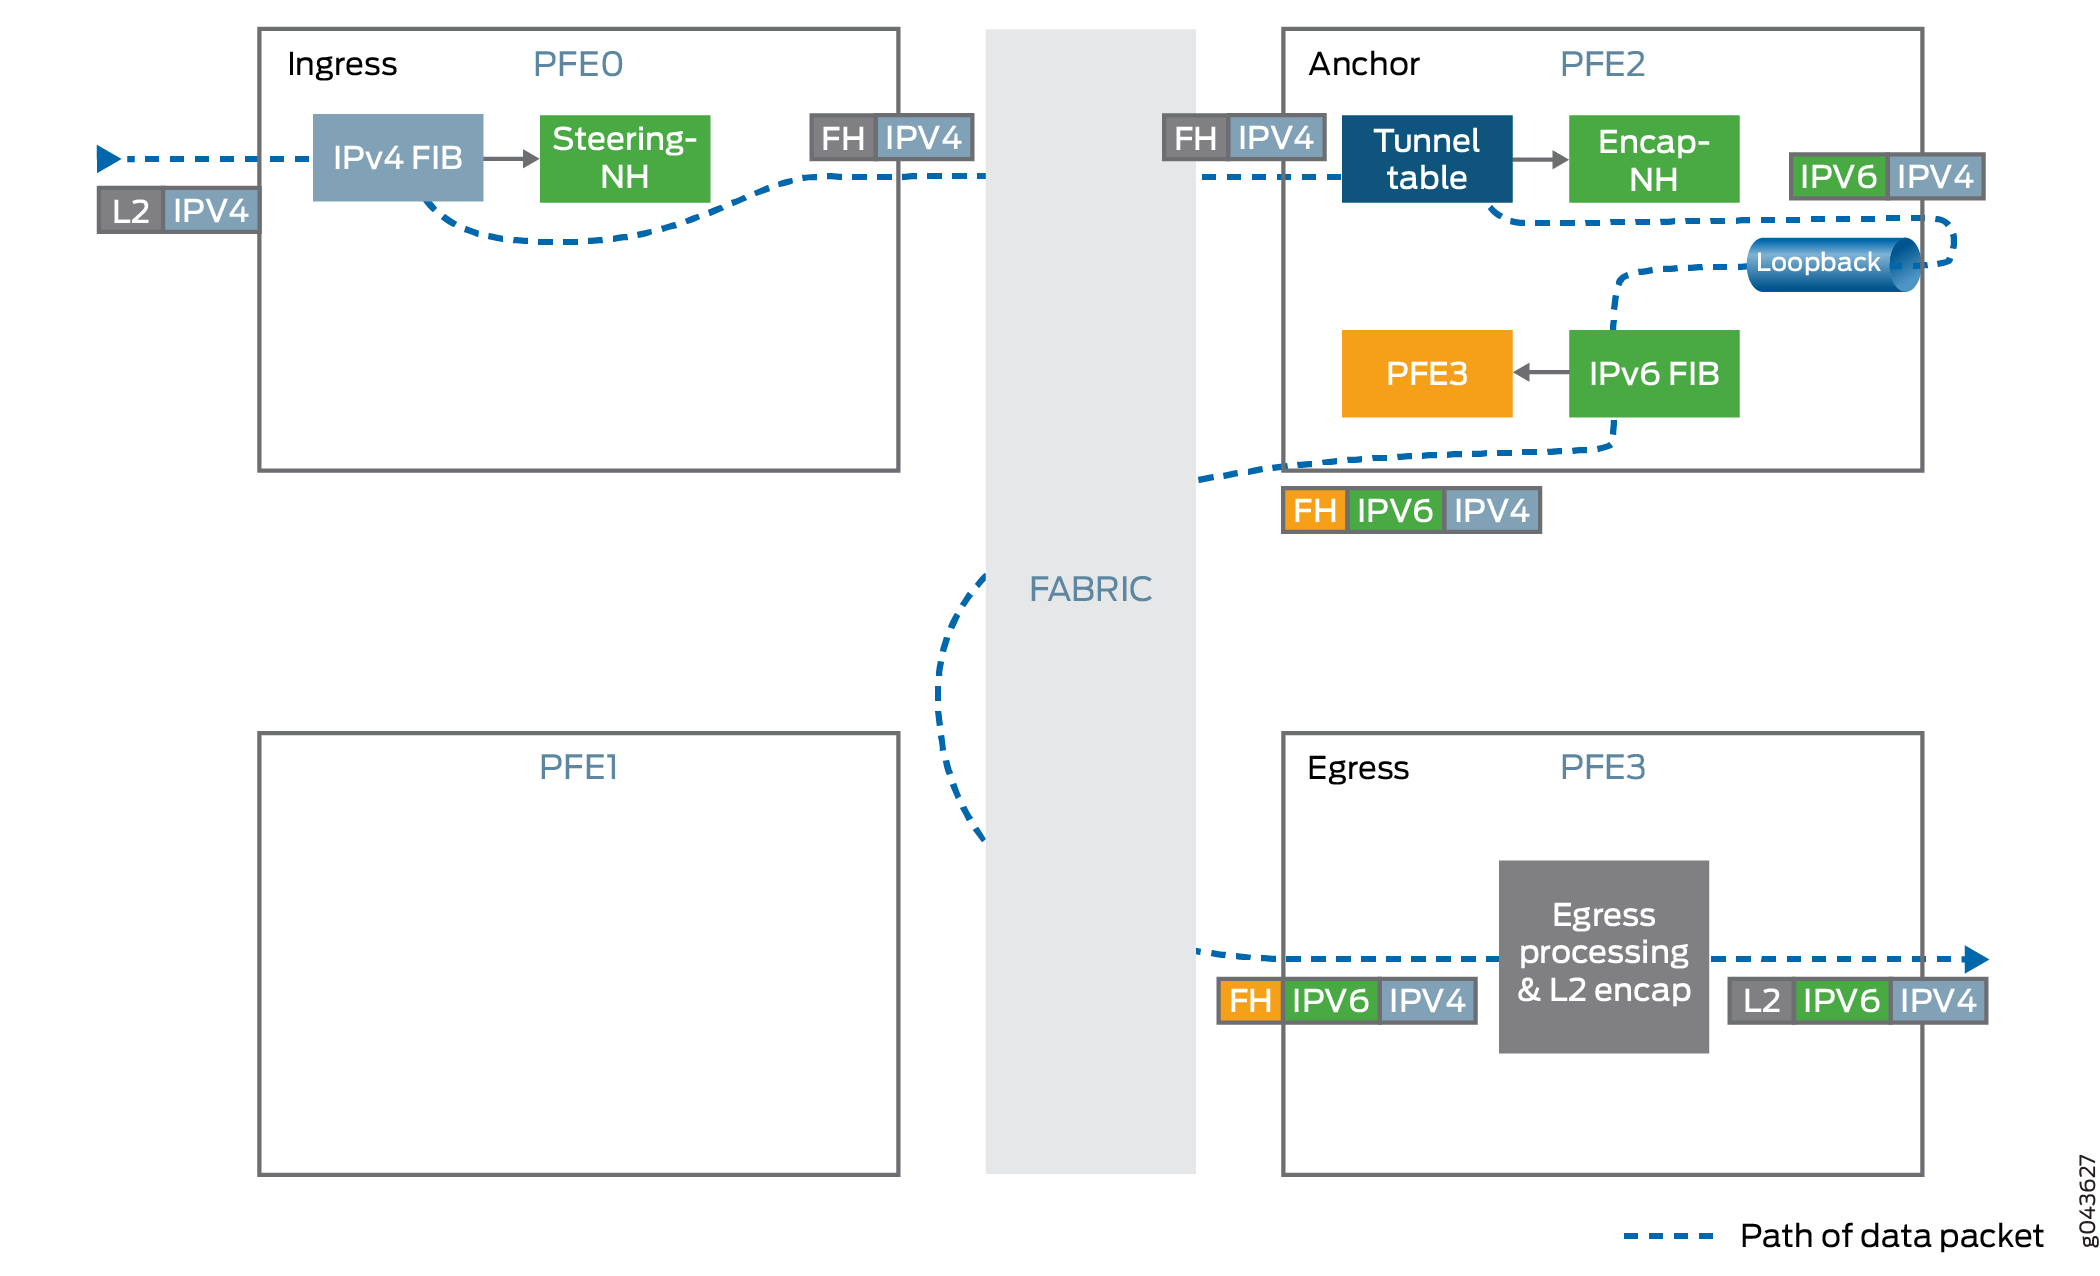
Les tunnels IPv4 sur IPv6 utilisent l’infrastructure de tunnel dynamique avec l’ancrage de tunnel pour prendre en charge l’évolutivité requise sur tout le châssis. L’état du tunnel est localisé en fonction d’un moteur de transfert de paquets, et les autres moteurs de transfert de paquets dirigent le trafic vers l’ancre du tunnel.
Entrée de tunnel
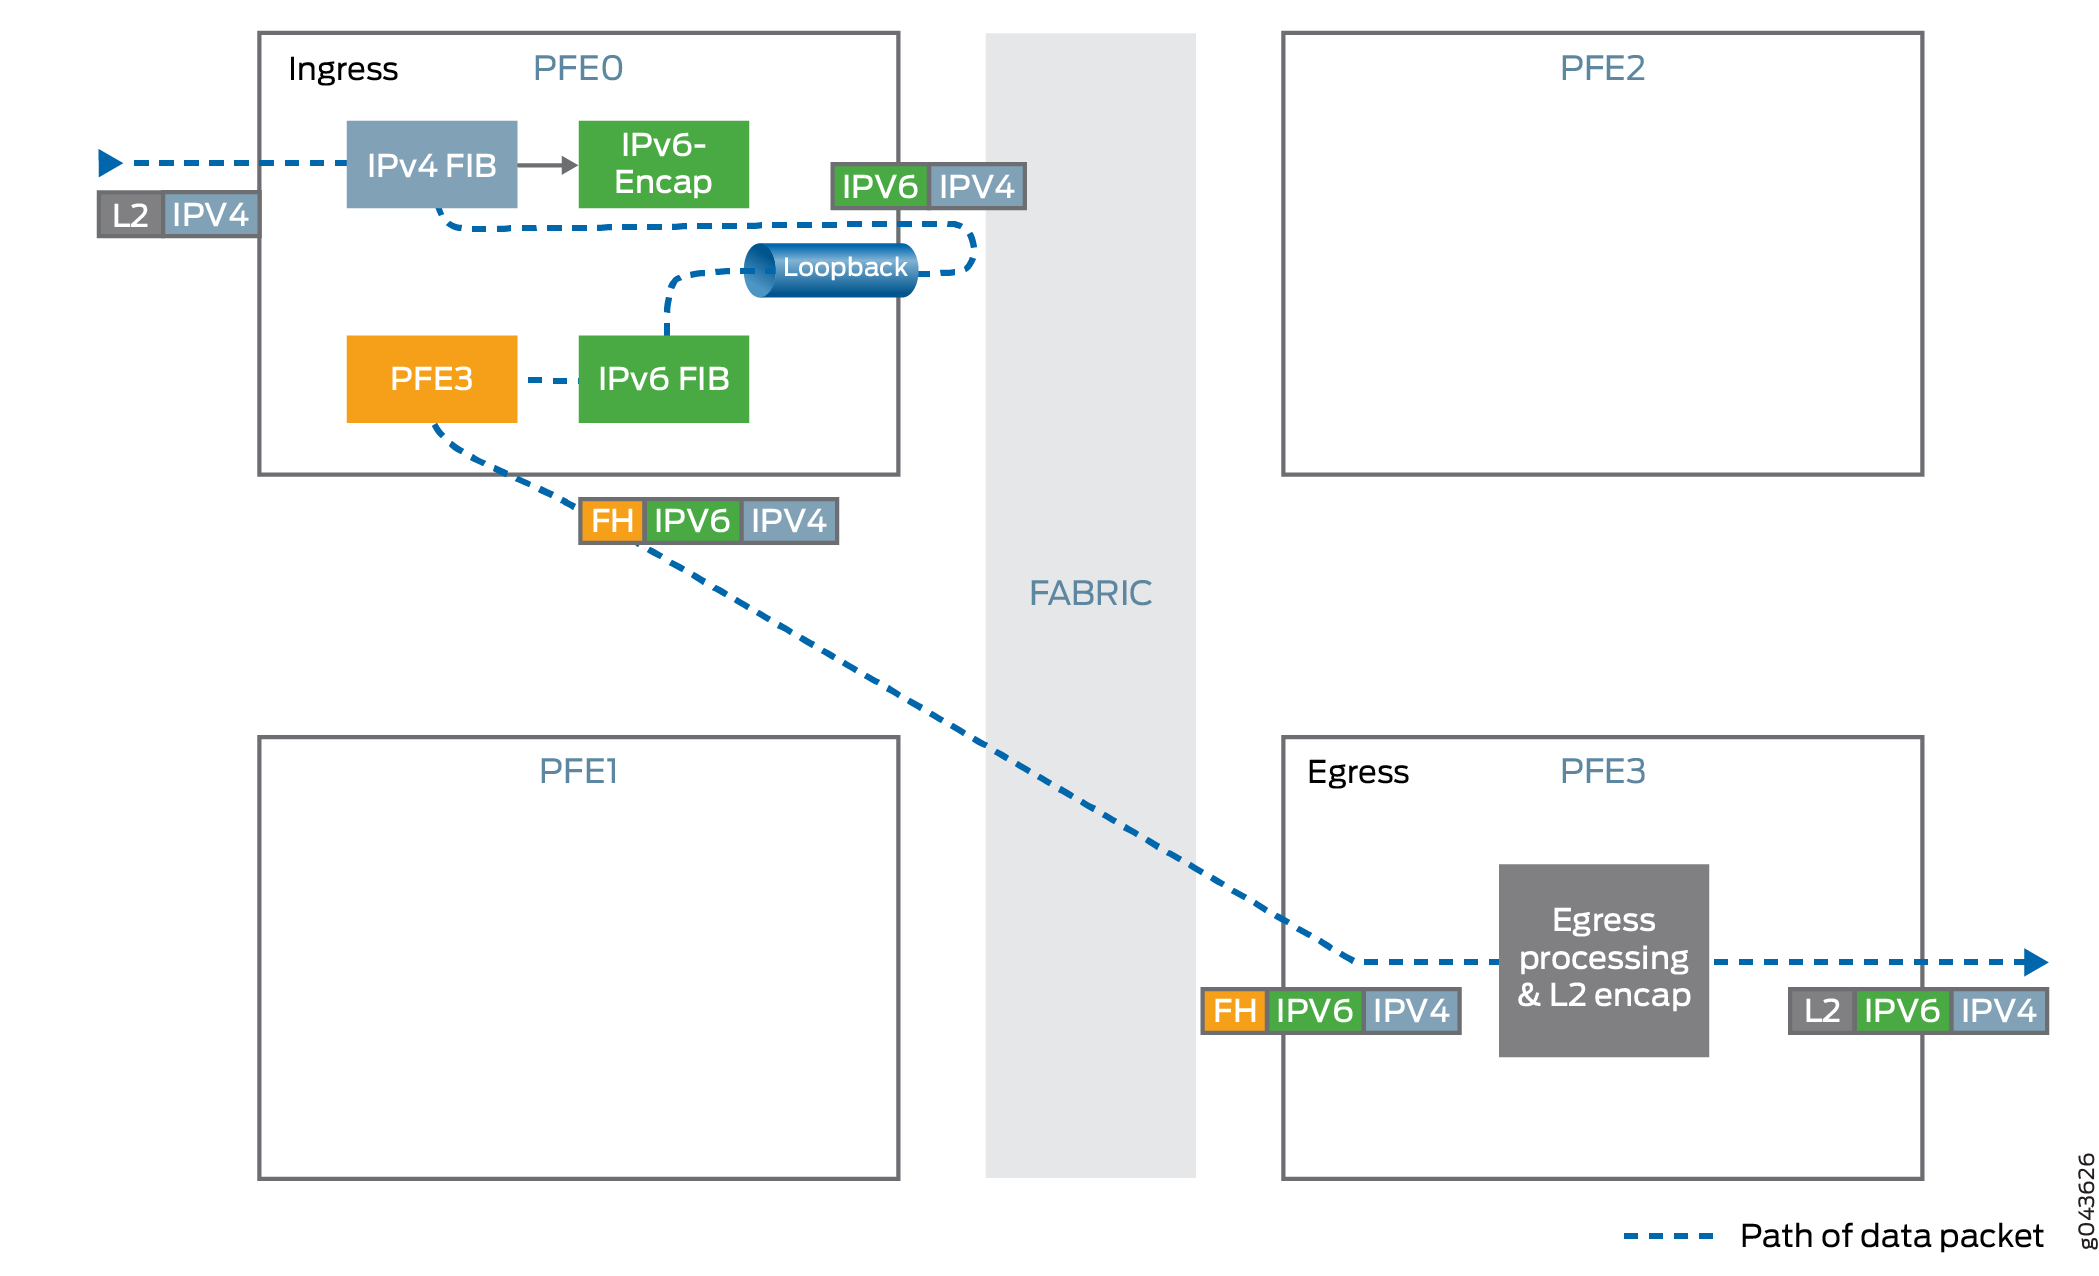
 différent
-
Encapsule le trafic IPv4 dans l’en-tête IPv6.
L’application de l’unité de transmission maximale (MTU) est effectuée avant l’encapsulation. Si la taille du paquet encapsulé dépasse la MTU du tunnel et que celle du
DF-bitpaquet IPv4 n’est pas définie, le paquet est fragmenté et ces fragments sont encapsulés. -
Utilise l’équilibrage de charge du trafic basé sur le hachage sur les en-têtes de paquet internes.
-
Transfère le trafic vers l’adresse IPv6 de destination. L’adresse IPv6 est tirée de l’en-tête IPv6.
Sortie de tunnel
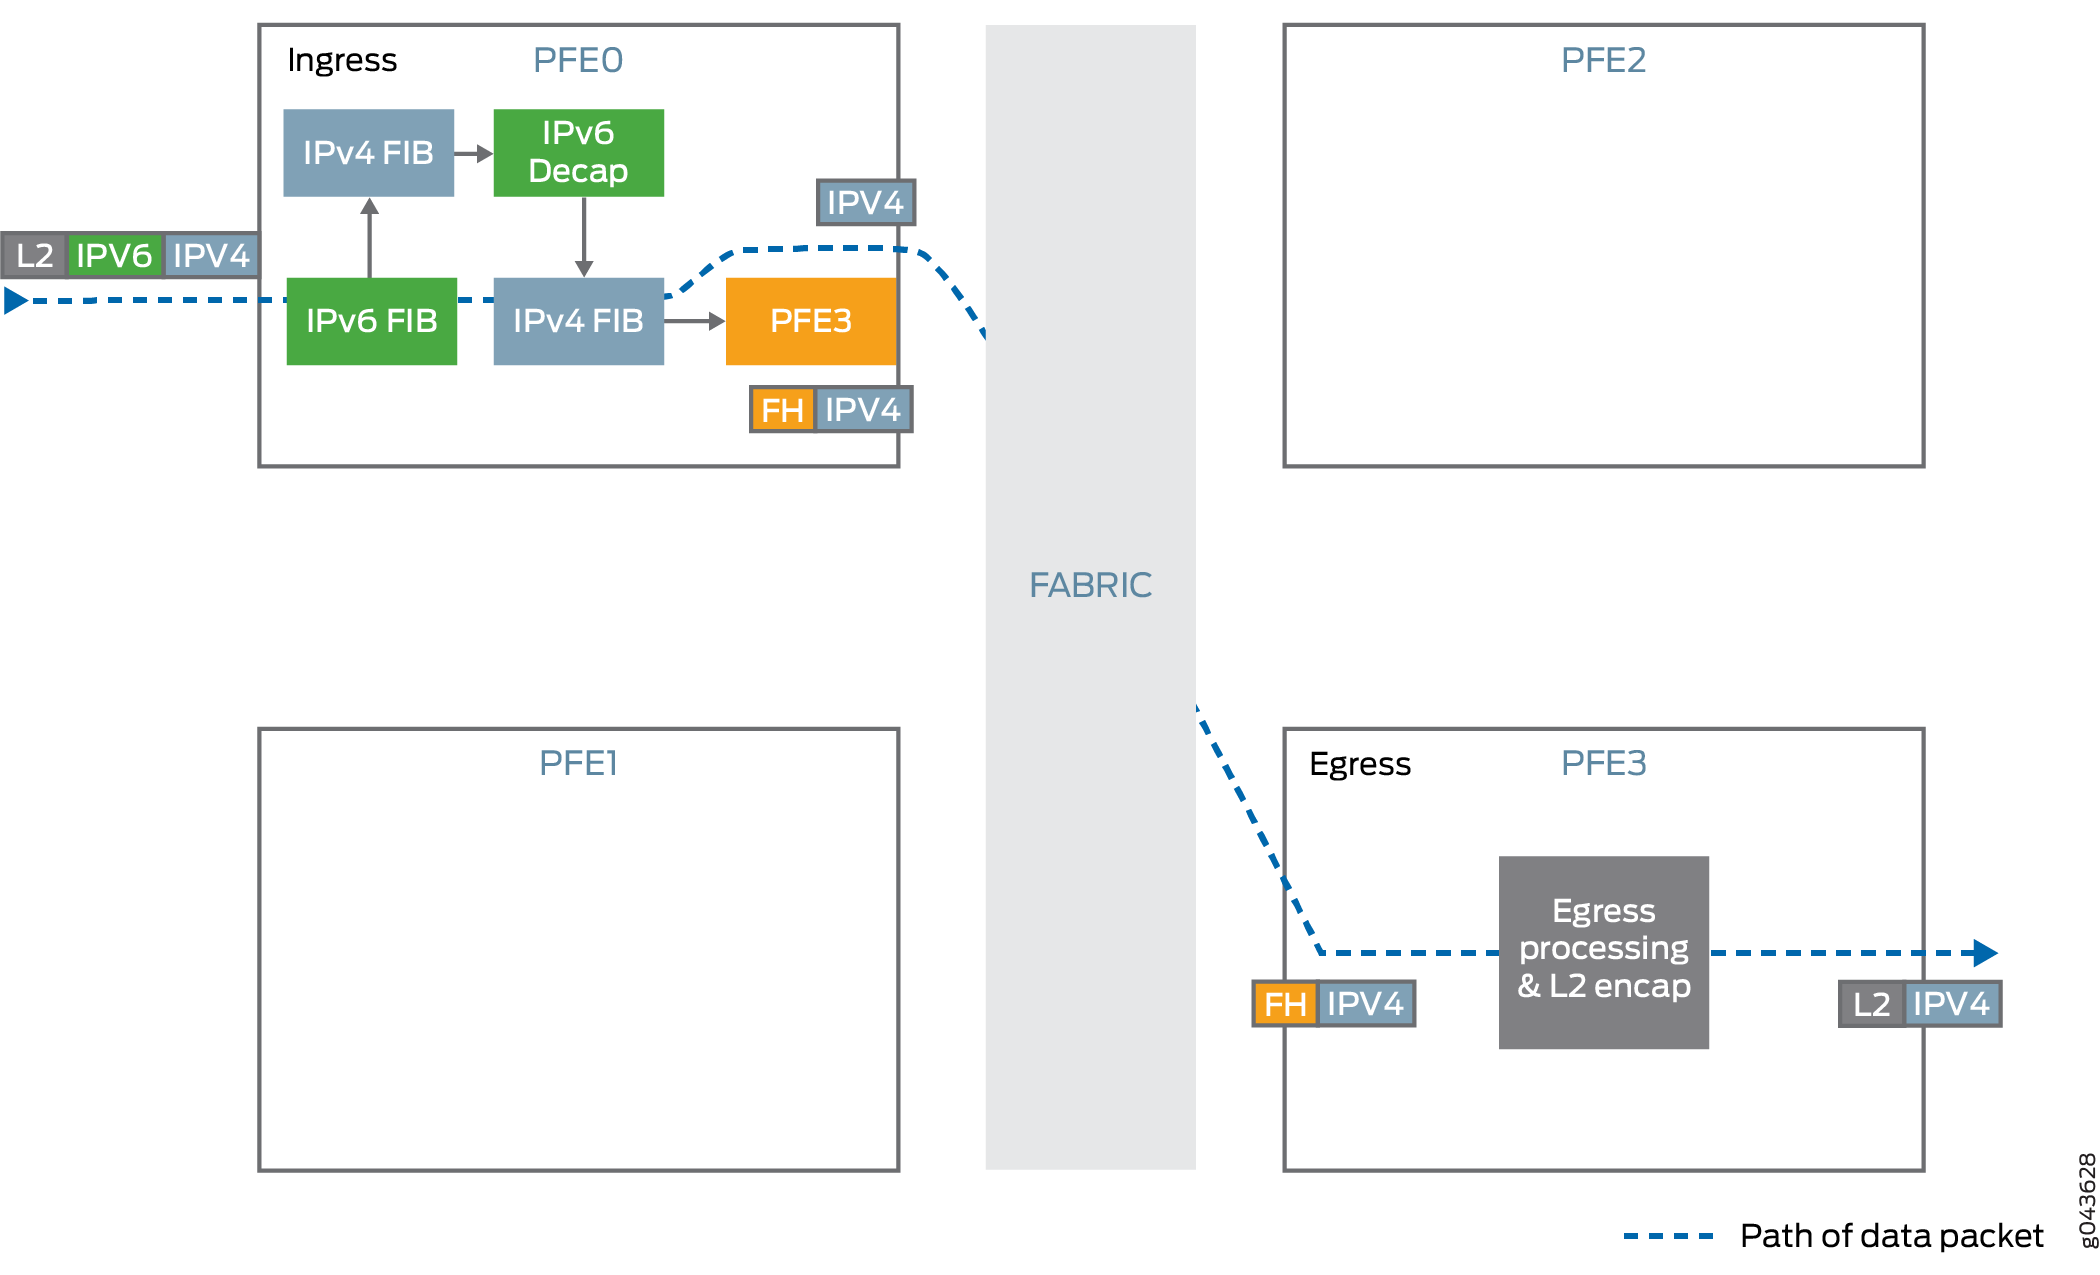
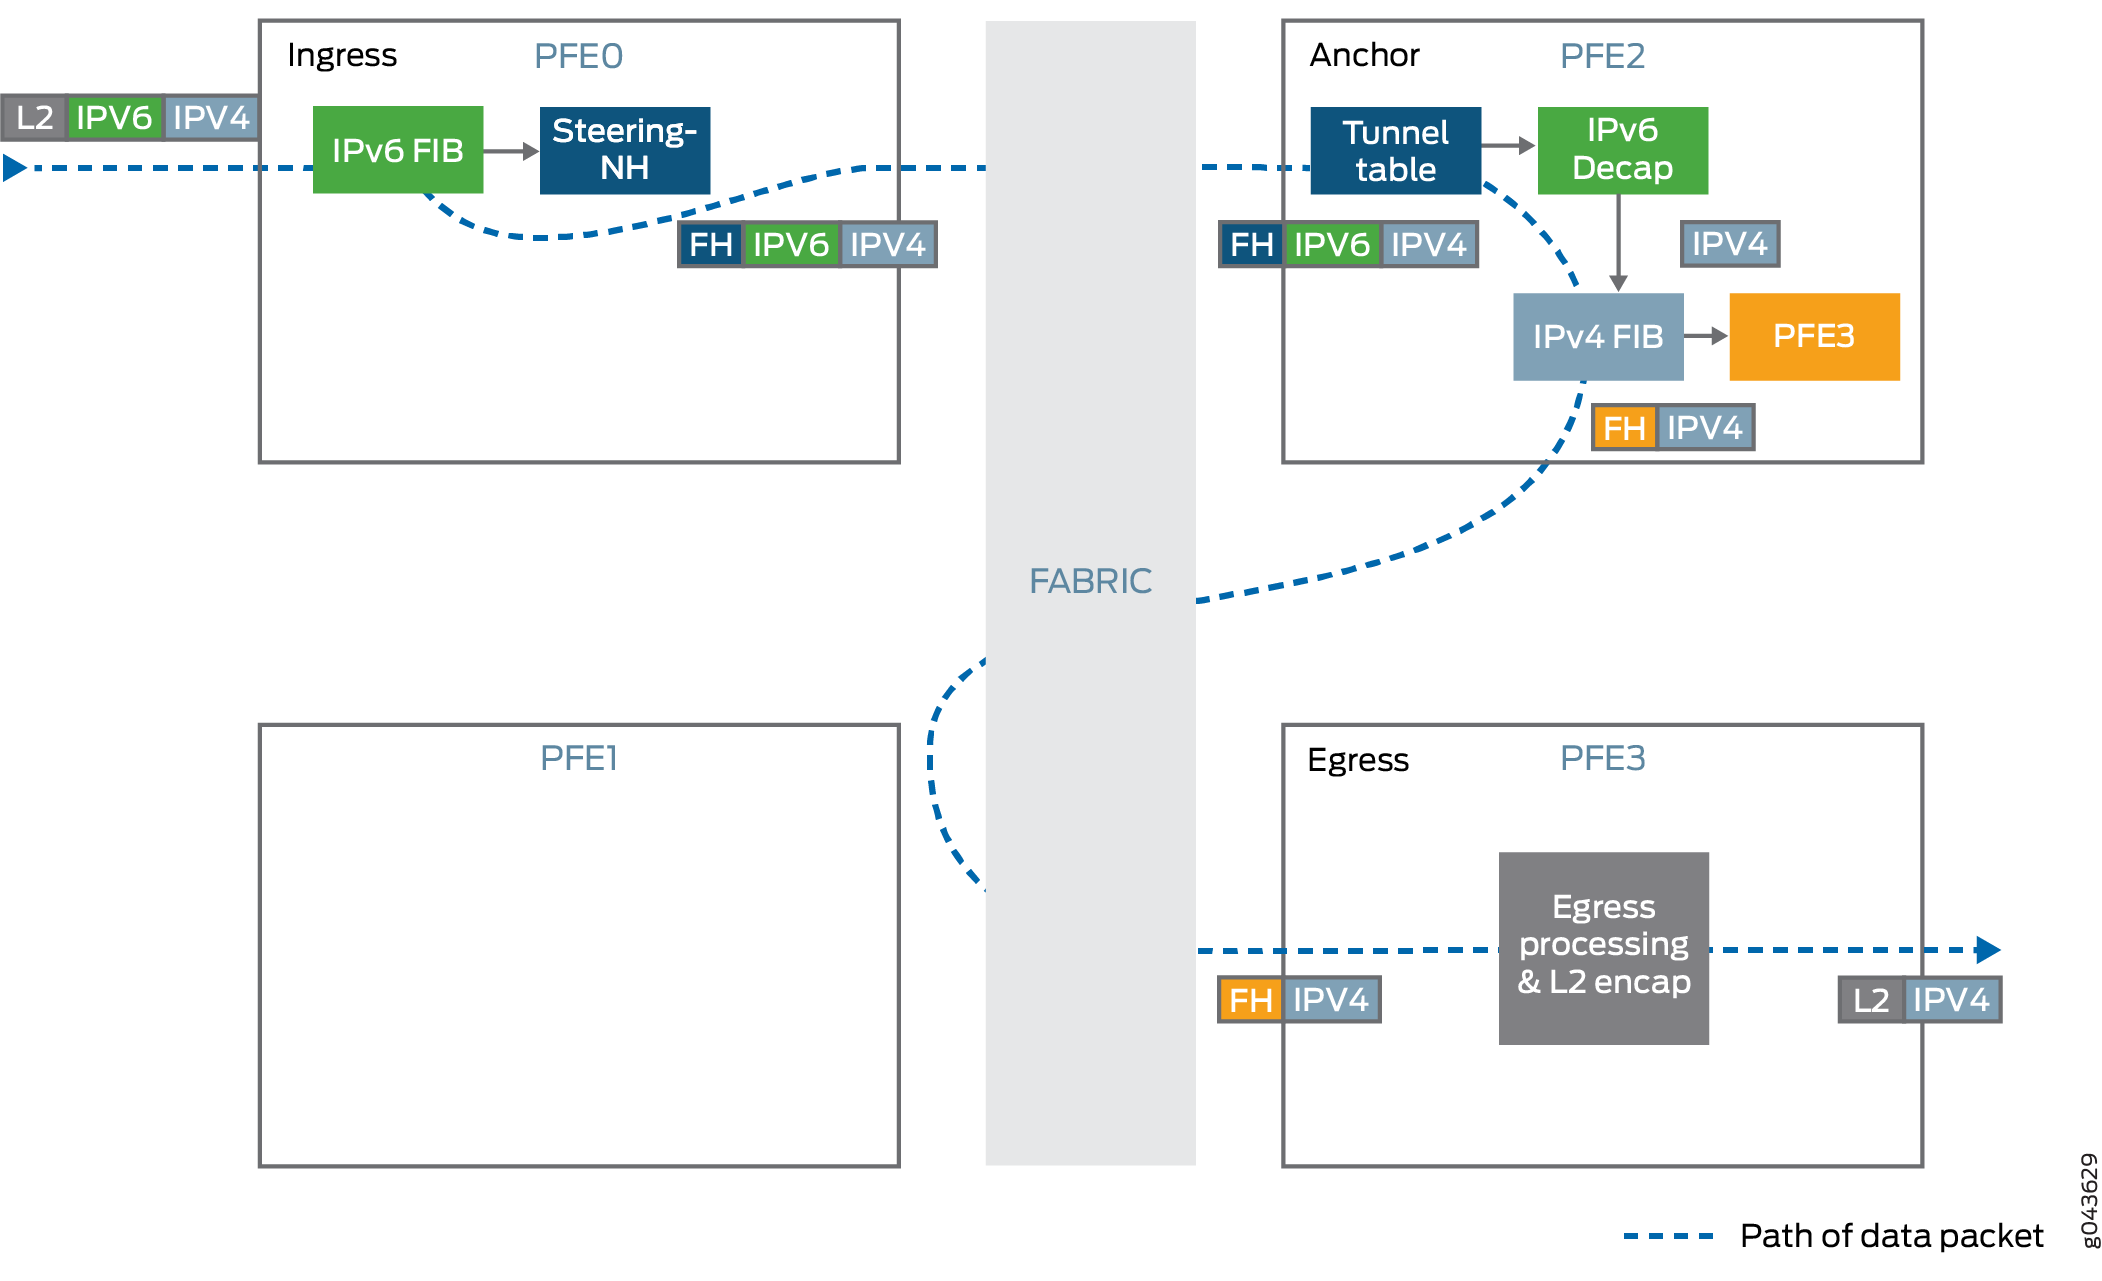 distant
-
Décapsule le paquet IPv4 présent à l’intérieur du paquet IPv6.
-
Effectue une vérification anti-usurpation pour s’assurer que la paire IPv6, IPv4 correspond aux informations utilisées pour configurer le tunnel.
-
Recherche l’adresse de destination IPv4 dans l’en-tête IPv4 du paquet décapsulé et transfère le paquet à l’adresse IPv4 spécifiée.
Gestion des défaillances du moteur de transfert de paquets et équilibrage de charge dans les tunnels et du moteur de transfert de paquets d’ancrage
La défaillance du moteur de transfert de paquets doit être traitée rapidement pour éviter le filtrage par voie nulle du trafic de tunnel ancré sur le moteur de transfert de paquets. La localisation des tunnels implique l’utilisation de messages BGP pour réparer la défaillance globalement. Le trafic du tunnel est détourné du point de défaillance vers un autre châssis de secours contenant le même état de tunnel. Pour l’équilibrage de charge du trafic, le châssis est configuré pour annoncer différentes valeurs de discriminateur de sortie multiple (MED) pour chacun des ensembles de préfixes afin que seul le trafic d’un quart des tunnels passe par chaque châssis. Le trafic CPE est également géré de la même manière en configurant le même ensemble d’adresses anycast sur chaque châssis et en dirigeant seulement un quart du trafic vers chaque châssis.
Le moteur de transfert de paquets Anchor est l’entité unique qui effectue tout le traitement d’un tunnel. La sélection du moteur de transfert de paquets d’ancrage se fait par le biais d’un provisionnement statique et liée aux interfaces physiques du moteur de transfert de paquets. Lorsque l’un des moteurs de transfert de paquets tombe en panne, le démon marque tous les moteurs de transfert de paquets sur la carte de ligne et communique cette information au processus du protocole de routage et aux autres démons. Le processus de protocole de routage envoie des retraits BGP pour les préfixes ancrés sur le moteur de transfert de paquets défaillant et les adresses IPv6 affectées au moteur de transfert de paquets qui est en panne. Ces annonces redirigent le trafic vers d’autres châssis de secours. Lorsque le moteur de transfert de paquets défaillant est à nouveau opérationnel, le châssis marque le moteur de transfert de paquets comme up et met à jour le processus de protocole de routage. Le processus du protocole de routage déclenche des mises à jour BGP à ses homologues indiquant que les tunnels ancrés au moteur de transfert de paquets spécifique sont désormais disponibles pour le routage du trafic. Ce processus peut prendre quelques minutes pour la configuration de tunnels à grande échelle. Par conséquent, le Ack mécanisme est intégré au système pour garantir une perte de trafic minimale lors du basculement du trafic vers le châssis d’origine.
Statistiques de flux de bouclage de tunnel
L’infrastructure de tunnel dynamique utilise des flux de bouclage dans le moteur de transfert de paquets pour boucler le paquet après encapsulation. La bande passante de ce flux de bouclage étant limitée, il est nécessaire de surveiller les performances des flux de bouclage dans les tunnels.
Pour surveiller les statistiques du flux de bouclage, utilisez la commande show pfe statistics traffic detail opérationnelle qui affiche les statistiques agrégées du flux de bouclage, y compris le taux de transfert, le débit de paquets abandonnés et le débit d’octets.
Voir aussi
Configuration de BGP pour redistribuer les routes IPv4 avec des adresses de saut suivant IPv6
À partir de la version 17.3R1, les équipements Junos OS peuvent transférer du trafic IPv4 sur un réseau IPv6 uniquement, qui ne peut généralement pas transférer le trafic IPv4. Comme décrit dans la RFC 5549, le trafic IPv4 est tunnelisé des appareils CPE vers les passerelles IPv4 sur IPv6. Ces passerelles sont annoncées aux équipements CPE par le biais d’adresses anycast. Les passerelles créent ensuite des tunnels IPv4 sur IPv6 dynamiques vers l’équipement des locaux des clients distants et annoncent les routes agrégées IPv4 pour orienter le trafic. Des réflecteurs de route avec des interfaces programmables injectent les informations du tunnel dans le réseau. Les réflecteurs de route sont connectés via IBGP à des routeurs de passerelle, qui annoncent les adresses IPv4 des routes hôtes avec les adresses IPv6 comme saut suivant.
La fonctionnalité de tunnel IPv4 sur IPv6 dynamique ne prend pas en charge l’ISSU unifié dans Junos OS version 17.3R1.
Avant de commencer à configurer BGP pour distribuer des routes IPv4 avec des adresses de saut suivant IPv6, procédez comme suit :
Configurez les interfaces des appareils.
Configurez OSPF ou tout autre protocole IGP.
Configurez MPLS et LDP.
Configurez BGP.
Pour configurer BGP afin de distribuer des routes IPv4 avec des adresses de saut suivant IPv6 :
Voir aussi
Activation des signaux VPN et VPLS de couche 2
Vous pouvez activer BGP pour qu’il transporte les messages VPN de couche 2 et VPLS NLRI.
Pour activer les signaux VPN et VPLS, incluez l’affirmation family :
family {
    l2vpn {
        signaling {
            prefix-limit {
                maximum number;
                teardown <percentage> <idle-timeout (forever | minutes)>;
                drop-excess <percentage>;
                hide-excess <percentage>;            }
        }
    }
}
Pour obtenir la liste des niveaux hiérarchiques auxquels vous pouvez inclure cette instruction, consultez la section résumé de la déclaration de cette déclaration.
Pour configurer un nombre maximal de préfixes, incluez l’instruction prefix-limit :
prefix-limit {
    maximum number;
    teardown <percentage> <idle-timeout (forever | minutes)>;
    drop-excess <percentage>;
    hide-excess <percentage>;}
Pour obtenir la liste des niveaux hiérarchiques auxquels vous pouvez inclure cette instruction, consultez la section résumé de la déclaration de cette déclaration.
Lorsque vous définissez le nombre maximal de préfixes, un message est consigné lorsque ce nombre est atteint. Si vous incluez l’instruction teardown , la session est interrompue lorsque le nombre maximal de préfixes est atteint. Si vous spécifiez un pourcentage, les messages sont enregistrés lorsque le nombre de préfixes atteint ce pourcentage. Une fois la session supprimée, elle est rétablie en peu de temps. Incluez l’instruction idle-timeout de maintenir la session ininterrompue pendant une durée spécifiée, ou pour toujours. Si vous spécifiez forever, la session est rétablie uniquement après l’utilisation de la clear bgp neighbor commande. Si vous incluez l’instruction drop-excess <percentage> et spécifiez un pourcentage, les itinéraires excédentaires sont supprimés lorsque le nombre de préfixes dépasse le pourcentage. Si vous incluez l’instruction hide-excess <percentage> et spécifiez un pourcentage, les itinéraires excédentaires sont masqués lorsque le nombre de préfixes dépasse le pourcentage. Si le pourcentage est modifié, les routes sont réévaluées automatiquement.
Voir aussi
Comprendre les routes de flux BGP pour le filtrage du trafic
Une route de flux est une agrégation de conditions de correspondance pour les paquets IP. Les routes de flux sont installées en tant que filtres de table de transfert d’entrée (implicites) et sont propagées sur le réseau à l’aide de messages NLRI (Network Layer Reachability Information) de spécification de flux, puis installées dans la table de routage de instance-name.inetflow.0flux . Les paquets ne peuvent circuler sur les routes de flux que si des conditions de correspondance spécifiques sont remplies.
Les routes de flux et les filtres de pare-feu sont similaires en ce sens qu’ils filtrent les paquets en fonction de leurs composants et effectuent une action sur les paquets correspondants. Les routes de flux offrent des capacités de filtrage et de limitation du débit du trafic, un peu comme les filtres de pare-feu. En outre, vous pouvez propager des itinéraires d’écoulement sur différents systèmes autonomes.
Les routes de flux sont propagées par BGP via des messages NLRI de spécification de flux. Vous devez activer BGP pour propager ces NLRI.
À partir de la version 15.1 de Junos OS, des modifications sont implémentées pour étendre la prise en charge du routage actif non-stop (NSR) aux familles inet-flow et inetVPN-flow existantes et étendre la validation de routage pour BGP flowspec par draft-ietf-idr-bgp-flowspec-oid-01. Deux nouveaux énoncés sont introduits dans le cadre de cette amélioration. Voir enforce-first-as et no-install.
À partir de la version 16.1 de Junos OS, la prise en charge d’IPv6 est étendue à la spécification de flux BGP qui permet la propagation de règles de spécification de flux de trafic pour les paquets IPv6 et VPN-IPv6. La spécification de flux BGP automatise la coordination des règles de filtrage du trafic afin de limiter les attaques par déni de service distribué pendant le routage actif ininterrompu (NSR).
À partir de la version 16.1R1 de Junos OS, la spécification de flux BGP prend en charge l’action de filtrage du marquage extended-community du trafic. Pour le trafic IPv4, Junos OS modifie les bits DSCP (DiffServ code point) d’un paquet IPv4 en transit à la valeur correspondante de la communauté étendue. Pour les paquets IPv6, Junos OS modifie les six premiers bits du traffic class champ du paquet IPv6 de transmission à la valeur correspondante de la communauté étendue.
À partir de la version 17.1R1 de Junos OS, le protocole BGP peut transmettre des messages d’informations d’accessibilité de la couche réseau (NLRI) spécifiant le flux sur les routeurs PTX Series dotés de FPC de troisième génération (FPC3-PTX-U2 et FPC3-PTX-U3 sur le PTX5000 et FPC3-SFF-PTX-U0 et FPC3-SFF-PTX-U1 sur le PTX3000). La propagation des informations de filtre de pare-feu dans le cadre de BGP vous permet de propager dynamiquement les filtres de pare-feu contre les attaques par déni de service (DOS) sur les systèmes autonomes.
À partir de la version 17.2R1 de Junos OS, BGP peut transporter des messages d’informations d’accessibilité de la couche réseau (NLRI) de spécification de flux sur les routeurs PTX1000 sur lesquels des FPC de troisième génération sont installés. La propagation des informations de filtre de pare-feu dans le cadre de BGP vous permet de propager dynamiquement les filtres de pare-feu contre les attaques par déni de service (DOS) sur les systèmes autonomes.
À partir de la version 20.3R1 de cRPD, les routes de flux et les règles de contrôle propagées via la NLRI de spécification de flux BGP sont téléchargées dans le noyau Linux via le framework Linux Netfilter sur les environnements cRPD.
- Conditions de correspondance pour les routes de flux
- Actions pour les routes de flux
- Validation des routes de flux
- Prise en charge de l’algorithme de spécification de flux BGP version 7 et ultérieure
Conditions de correspondance pour les routes de flux
Vous spécifiez les conditions auxquelles le paquet doit correspondre avant que l’action de l’instruction then ne soit effectuée pour un itinéraire de flux. Toutes les conditions de l’énoncé from doivent correspondre pour l’action à entreprendre. L’ordre dans lequel vous spécifiez les conditions de correspondance n’a pas d’importance, car un paquet doit correspondre à toutes les conditions d’un terme pour qu’une correspondance se produise.
Pour configurer une condition de correspondance, incluez l’instruction match au niveau de la [edit routing-options flow] hiérarchie.
Le Tableau 1 décrit les conditions d’appariement de l’itinéraire d’écoulement.
| Condition de correspondance |
Descriptif |
|---|---|
|
|
Champ d’adresse IP de destination. Vous pouvez utiliser le champ facultatif, qui n’est disponible que sur les |
|
|
Champ de port de destination TCP ou UDP (User Datagram Protocol). Vous ne pouvez pas spécifier à la fois les conditions et les À la place de la valeur numérique, vous pouvez spécifier l’un des synonymes textuels suivants (les numéros de port sont également répertoriés) : |
|
|
DSCP (Differentiated Services Code Point). Le protocole DiffServ utilise l’octet de type de service (ToS) dans l’en-tête IP. Les six bits les plus significatifs de cet octet forment le DSCP. Vous pouvez spécifier DSCP sous forme hexadécimale ou décimale. |
|
|
Faites correspondre la valeur de l’étiquette de flux. La valeur de ce champ est comprise entre 0 et 1048575. Cette condition de correspondance est prise en charge uniquement sur les équipements Junos avec des MPC améliorés configurés pour |
|
|
Champ Type de fragment. Les mots-clés sont regroupés selon le type de fragment auquel ils sont associés :
Cette condition de correspondance est prise en charge uniquement sur les équipements Junos OS avec des MPC améliorés configurés pour |
|
|
Champ de code ICMP. Cette valeur ou mot-clé fournit des informations plus spécifiques que À la place de la valeur numérique, vous pouvez spécifier l’un des synonymes textuels suivants (les valeurs de champ sont également répertoriées). Les mots-clés sont regroupés par type ICMP auquel ils sont associés :
|
|
|
Champ de type de paquet ICMP. Normalement, vous spécifiez cette correspondance conjointement avec l’instruction À la place de la valeur numérique, vous pouvez spécifier l’un des synonymes textuels suivants (les valeurs de champ sont également répertoriées) : |
|
|
Longueur totale des paquets IP. |
|
|
Champ de port source ou de destination TCP ou UDP. Vous ne pouvez pas spécifier à la fois la À la place de la valeur numérique, vous pouvez spécifier l’un des synonymes de texte répertoriés sous |
|
|
Champ de protocole IP. À la place de la valeur numérique, vous pouvez spécifier l’un des synonymes textuels suivants (les valeurs de champ sont également répertoriées) : Cette condition de correspondance est prise en charge pour IPv6 uniquement sur les équipements Junos avec des MPC améliorés configurés pour |
|
|
Champ d’adresse IP source. Vous pouvez utiliser le champ facultatif, qui n’est disponible que sur les |
|
|
Champ de port source TCP ou UDP. Vous ne pouvez pas spécifier les conditions de À la place du champ numérique, vous pouvez spécifier l’un des synonymes de texte répertoriés sous |
|
|
Format d’en-tête TCP. |
Actions pour les routes de flux
Vous pouvez spécifier l’action à entreprendre si le paquet correspond aux conditions que vous avez configurées dans l’itinéraire de flux. Pour configurer une action, incluez l’instruction then au niveau de la [edit routing-options flow] hiérarchie.
Le Tableau 2 décrit les actions de l’itinéraire de flux.
| Action ou modificateur d’action |
Descriptif |
|---|---|
| Actions | |
|
|
Accepter un paquet. Il s’agit de l’option par défaut. |
|
|
Supprimez un paquet en mode silencieux, sans envoyer de message ICMP (Internet Control Message Protocol). |
|
|
Remplacez toutes les communautés de la route par les communautés spécifiées. |
| Marque value |
Définissez une valeur DSCP pour le trafic qui correspond à ce flux. Spécifiez une valeur comprise entre 0 et 63. Cette action n’est prise en charge que sur les équipements Junos avec des MPC améliorés configurés pour |
|
|
Passez à la condition de correspondance suivante pour l’évaluation. |
|
|
Spécifiez une instance de routage à laquelle les paquets sont transférés. |
|
|
Limitez la bande passante sur la route de flux. Exprimez la limite en bits par seconde (bps). À partir de la version 16.1R4 de Junos OS, la plage de limite de débit est de [0 à 100000000000000]. |
|
|
Échantillonnez le trafic sur la route du flux. |
Validation des routes de flux
Junos OS installe les routes de flux dans la table de routage de flux uniquement si elles ont été validées à l’aide de la procédure de validation. Le moteur de routage effectue la validation avant l’installation des routes dans la table de routage de flux.
Les routes de flux reçues à l’aide des messages d’informations d’accessibilité de la couche réseau (NLRI) de BGP sont validées avant d’être installées dans la table de routage de l’instance principale du instance.inetflow.0flux. La procédure de validation est décrite dans le draft-ietf-idr-flow-spec-09.txt, Diffusion des règles de spécification de flux. Vous pouvez contourner le processus de validation des routes de flux à l’aide de messages BGP NLRI et utiliser votre propre stratégie d’importation spécifique.
Pour tracer les opérations de validation, incluez l’instruction validation au niveau de la [edit routing-options flow] hiérarchie.
Prise en charge de l’algorithme de spécification de flux BGP version 7 et ultérieure
Par défaut, Junos OS utilise l’algorithme d’ordonnancement des termes défini dans la version 6 du projet de spécification de flux BGP. À partir de la version 10.0 de Junos OS, vous pouvez configurer le routeur pour qu’il se conforme à l’algorithme d’ordonnancement des termes défini pour la première fois dans la version 7 de la spécification de flux BGP et pris en charge par RFC 5575, Dissemination of Flow Specification Routes.
Nous vous recommandons de configurer Junos OS pour utiliser l’algorithme d’ordonnancement des termes défini pour la première fois dans la version 7 du brouillon de spécification de flux BGP. Nous vous recommandons également de configurer Junos OS pour qu’il utilise le même algorithme de classement des durées sur toutes les instances de routage configurées sur un routeur.
Pour configurer BGP afin d’utiliser l’algorithme de spécification de flux défini pour la première fois dans la version 7 du brouillon Internet, incluez l’instruction standard au niveau de la [edit routing-options flow term-order] hiérarchie.
Pour revenir à l’algorithme d’ordre des termes défini dans la version 6, incluez l’instruction legacy au niveau de la [edit routing-options flow term-order] hiérarchie.
L’ordre des termes configuré n’a qu’une signification locale. En d’autres termes, l’ordre des termes ne se propage pas avec les routes de flux envoyées aux homologues BGP distants, dont l’ordre des termes est entièrement déterminé par leur propre configuration d’ordre des termes. Par conséquent, vous devez être prudent lorsque vous configurez l’action next term dépendante de l’ordre lorsque vous n’avez pas connaissance du terme configuration de l’ordre des homologues distants. Le local next term peut différer de celui next term configuré sur l’homologue distant.
Sur Junos OS Evolved, next term ne peut pas apparaître comme dernier terme de l’action. Un terme de filtre où next term est spécifié en tant qu’action mais sans aucune condition de correspondance configurée n’est pas pris en charge.
À partir de la version 16.1 de Junos OS, vous avez la possibilité de ne pas appliquer le flowspec filtre au trafic reçu sur des interfaces spécifiques. Un nouveau terme est ajouté au début du flowspec filtre qui accepte tout paquet reçu sur ces interfaces spécifiques. Le nouveau terme est une variable qui crée une liste d’exclusion de termes attachés au filtre de la table de transfert dans le cadre du filtre de spécification de flux.
Pour exclure l’application flowspec du filtre au trafic reçu sur des interfaces spécifiques, vous devez d’abord configurer un group-id sur ces interfaces en incluant l’instruction du groupe group-id de filtres de famille inet au niveau de la [edit interfaces] hiérarchie, puis attacher le flowspec filtre au groupe d’interfaces en incluant l’instruction flow interface-group group-id exclude au niveau de la [edit routing-options] hiérarchie. Vous ne pouvez en configurer qu’une seule group-id par instance de routage avec l’instructionset routing-options flow interface-group group-id.
Voir aussi
Exemple : Activation de BGP pour transporter des routes de spécification de flux
Cet exemple montre comment autoriser BGP à transmettre des messages d’informations d’accessibilité de la couche réseau (NLRI) spécifiant le flux.
Exigences
Avant de commencer :
Configurez les interfaces des appareils.
Configurez un Interior Gateway Protocol (IGP).
Configurez BGP.
Configurez une politique de routage qui exporte les routes (telles que les routes directes ou les routes IGP) de la table de routage vers BGP.
Vue d’ensemble
La propagation des informations de filtre de pare-feu dans le cadre de BGP vous permet de propager dynamiquement les filtres de pare-feu contre les attaques par déni de service (DOS) sur les systèmes autonomes. Les routes de flux sont encapsulées dans la spécification de flux NLRI et propagées via un réseau ou des réseaux privés virtuels (VPN), partageant des informations de type filtre. Les routes de flux sont une agrégation des conditions de correspondance et des actions qui en résultent pour les paquets. Ils vous offrent des capacités de filtrage et de limitation du débit du trafic similaires à celles des filtres de pare-feu. Les routes de flux unicast sont prises en charge pour l’instance par défaut, les instances VRF (VPN Routing and Forwarding) et les instances de routeur virtuel.
Les politiques d’importation et d’exportation peuvent être appliquées à la famille inet flow ou à la famille inet-vpn flow NLRI, ce qui affecte les itinéraires de flux acceptés ou annoncés, de la même manière que les stratégies d’importation et d’exportation sont appliquées aux autres familles BGP. La seule différence réside dans le fait que la configuration de la stratégie de flux doit inclure l’instruction from rib inetflow.0 . Cette instruction entraîne l’application de la stratégie aux itinéraires de flux. Une exception à cette règle se produit si la stratégie n’a que l’instruction then reject ou then accept et aucune from instruction. Ensuite, la stratégie affecte toutes les routes, y compris l’unicast IP et le flux IP.
Les filtres de route de flux sont d’abord configurés statiquement sur un routeur, avec un ensemble de critères de correspondance suivis des actions à entreprendre. Ensuite, en plus de family inet unicast, family inet flow (ou family inet-vpn flow) est configuré entre cet équipement compatible BGP et ses homologues.
Par défaut, les routes de flux configurées statiquement (filtres de pare-feu) sont annoncées aux autres équipements compatibles BGP qui prennent en charge le ou family inet-vpn flow NLRIfamily inet flow.
L’équipement BGP destinataire effectue un processus de validation avant d’installer le filtre de pare-feu dans la table de routage des instance-name.inetflow.0flux. La procédure de validation est décrite dans la RFC 5575, Diffusion des règles de spécification de flux.
L’équipement BGP destinataire accepte un itinéraire de flux s’il répond aux critères suivants :
L’expéditeur d’une route de flux correspond à l’expéditeur de la meilleure correspondance unicast itinéraire pour l’adresse de destination incorporée dans l’itinéraire.
Il n’y a plus de routes unicast spécifiques, par rapport à l’adresse de destination de la route de flux, pour laquelle la route active a été reçue d’un autre système autonome de saut suivant.
Le premier critère garantit que le filtre est annoncé par le saut suivant utilisé par le transfert unicast pour l’adresse de destination incorporée dans la route de flux. Par exemple, si un itinéraire de flux est donné comme 10.1.1.1, proto=6, port=80, l’équipement BGP de réception sélectionne l’itinéraire unicast plus spécifique dans le table de routage unicast qui correspond au préfixe de destination 10.1.1.1/32. Sur un table de routage unicast contenant 10.1/16 et 10.1.1/24, ce dernier est choisi comme voie unicast à comparer. Seule l’entrée de route unicast active est prise en compte. Cela suit le concept selon lequel une route de flux est valide si elle est annoncée par l’auteur de la meilleure route unicast.
Le deuxième critère concerne les situations dans lesquelles un bloc d’adresses donné est attribué à différentes entités. Les flux qui se résolvent en une route unicast la meilleure correspondance qui est une route agrégée ne sont acceptés que s’ils ne couvrent pas des routes plus spécifiques qui sont acheminées vers différents systèmes autonomes de saut suivant.
Vous pouvez contourner le processus de validation des routes de flux à l’aide de messages BGP NLRI et utiliser votre propre stratégie d’importation spécifique. Lorsque BGP transporte des messages NLRI de spécification de flux, l’instruction no-validate au niveau de la hiérarchie omet la procédure de validation de l’itinéraire [edit protocols bgp group group-name family inet flow] de flux une fois que les paquets sont acceptés par une stratégie. Vous pouvez configurer la stratégie d’importation pour qu’elle corresponde à l’adresse de destination et aux attributs de chemin tels que community, next-hop et AS path. Vous pouvez spécifier l’action à entreprendre si le paquet correspond aux conditions que vous avez configurées dans l’itinéraire de flux. Pour configurer une action, incluez l’instruction au niveau de la [edit routing-options flow] hiérarchie. Le type NLRI de spécification de flux comprend des composants tels que le préfixe de destination, le préfixe source, le protocole et les ports, tels que définis dans la RFC 5575. La stratégie d’importation peut filtrer une route entrante à l’aide d’attributs de chemin et d’adresse de destination dans l’NLRI de spécification de flux. La stratégie d’importation ne peut filtrer aucun autre composant dans le RFC 5575.
La spécification de flux définit les extensions de protocole requises pour répondre aux applications les plus courantes de unicast IPv4 et de filtrage unicast VPN. Le même mécanisme peut être réutilisé et de nouveaux critères de correspondance peuvent être ajoutés pour traiter un filtrage similaire pour d’autres familles d’adresses BGP (par exemple, IPv6 unicast).
Une fois qu’une route de flux est installée dans la inetflow.0 table, elle est également ajoutée à la liste des filtres de pare-feu dans le noyau.
Sur les routeurs uniquement, les messages NLRI de spécification de flux sont pris en charge dans les VPN. Le VPN compare la communauté étendue cible de route dans le NLRI à la stratégie d’importation. S’il y a une correspondance, le VPN peut commencer à utiliser les routes de flux pour filtrer et limiter le débit du trafic de paquets. Les routes de flux reçus sont installées dans la table de routage de instance-name.inetflow.0flux . Les routes de flux peuvent également être propagées sur un réseau VPN et partagées entre les VPN. Pour permettre à Multiprotocol BGP (MP-BGP) de transporter un NLRI de spécification de flux pour la famille d’adresses inet-vpn , incluez l’instruction flow au niveau de la [edit protocols bgp group group-name family inet-vpn] hiérarchie. Les routes de flux VPN sont prises en charge pour l’instance par défaut uniquement. Les routes de flux configurées pour les VPN avec famille inet-vpn ne sont pas automatiquement validées, de sorte que l’instruction n’est no-validate pas prise en charge au niveau de la [edit protocols bgp group group-name family inet-vpn] hiérarchie. Aucune validation n’est nécessaire si les itinéraires de flux sont configurés localement entre les appareils d’un seul AS.
Les stratégies d’importation et d’exportation peuvent être appliquées au ou family inet-vpn flow au family inet flow NLRI, ce qui affecte les itinéraires de flux acceptés ou annoncés, de la même manière que les stratégies d’importation et d’exportation sont appliquées aux autres familles BGP. La seule différence est que la configuration de la stratégie de flux doit inclure l’instructionfrom rib inetflow.0. Cette instruction entraîne l’application de la stratégie aux itinéraires de flux. Une exception à cette règle se produit si la stratégie n’a que l’instruction then reject ou then accept et aucune from instruction. Ensuite, la stratégie affecte toutes les routes, y compris l’unicast IP et le flux IP.
Cet exemple montre comment configurer les stratégies d’exportation suivantes :
Une stratégie qui permet la publication des routes de flux spécifiées par un filtre de route. Seuls les itinéraires d’écoulement couverts par le bloc 10.13/16 sont annoncés. Cette politique n’affecte pas les routes unicast.
Une stratégie qui permet d’annoncer au voisin toutes les routes de unicast et de flux.
Une stratégie qui interdit à toutes les routes (unicast ou flux) d’être annoncées au voisin.
Topologie
La configuration
- Configuration d’une route de flux statique
- Annonce des routes de flux spécifiées par un filtre de route
- Advertising Toutes les routes unicast et de flux
- Advertising Pas de routes unicast ou de flux
- Limitation du nombre de routes de flux installées dans une table de routage
- Limitation du nombre de préfixes reçus sur une session d’appairage BGP
Configuration d’une route de flux statique
Configuration rapide de la CLI
Pour configurer rapidement cet exemple, copiez les commandes suivantes, collez-les dans un fichier texte, supprimez les sauts de ligne, modifiez tous les détails nécessaires pour qu’ils correspondent à votre configuration réseau, puis copiez-collez les commandes dans le CLI au niveau de la [edit] hiérarchie.
set routing-options flow route block-10.131.1.1 match destination 10.131.1.1/32
set routing-options flow route block-10.131.1.1 match protocol icmp
set routing-options flow route block-10.131.1.1 match icmp-type echo-request
set routing-options flow route block-10.131.1.1 then discard
set routing-options flow term-order standard
Procédure étape par étape
L’exemple suivant nécessite que vous naviguiez à différents niveaux dans la hiérarchie de configuration. Pour plus d’informations sur la navigation dans la CLI, reportez-vous à la section Utilisation de l’éditeur CLI en mode configuration dans le Guide de l’utilisateur de la CLI de Junos OS.
Pour configurer les sessions d’pair BGP :
Configurez les conditions de correspondance.
[edit routing-options flow route block-10.131.1.1]
user@host# set match destination 10.131.1.1/32
user@host# set match protocol icmp
user@host# set match icmp-type echo-request
Configurez l’action.
[edit routing-options flow route block-10.131.1.1]
user@host# set then discard
(Recommandé) Pour l’algorithme de spécification de flux, configurez l’ordre des termes basé sur la norme.
[edit routing-options flow]
user@host# set term-order standard
Dans l’algorithme de classement des termes par défaut, comme spécifié dans le projet de RFC de la version 6 de flowspec, un terme avec des conditions de correspondance moins spécifiques est toujours évalué avant un terme avec des conditions de correspondance plus spécifiques. Cela fait que le terme avec des conditions de correspondance plus spécifiques n’est jamais évalué. La version 7 de la RFC 5575 a apporté une révision à l’algorithme afin que les conditions d’appariement les plus spécifiques soient évaluées avant les conditions d’appariement moins spécifiques. Pour des raisons de rétrocompatibilité, le comportement par défaut n’est pas modifié dans Junos OS, même si le nouvel algorithme est plus logique. Pour utiliser le nouvel algorithme, incluez l’instruction
term-order standarddans la configuration. Cette instruction est prise en charge dans Junos OS version 10.0 et ultérieure.
Résultats
À partir du mode configuration, confirmez votre configuration en entrant la show routing-options commande. Si la sortie n’affiche pas la configuration prévue, répétez les instructions de cet exemple pour corriger la configuration.
[edit]
user@host# show routing-options
flow {
    term-order standard;
    route block-10.131.1.1 {
        match {
            destination 10.131.1.1/32;
            protocol icmp;
            icmp-type echo-request;
        }
        then discard;
    }
}
Si vous avez terminé de configurer l’appareil, entrez en commit mode configuration.
Annonce des routes de flux spécifiées par un filtre de route
Configuration rapide de la CLI
Pour configurer rapidement cet exemple, copiez les commandes suivantes, collez-les dans un fichier texte, supprimez les sauts de ligne, modifiez tous les détails nécessaires pour qu’ils correspondent à votre configuration réseau, puis copiez-collez les commandes dans le CLI au niveau de la [edit] hiérarchie.
set protocols bgp group core family inet unicast
set protocols bgp group core family inet flow
set protocols bgp group core export p1
set protocols bgp group core peer-as 65000
set protocols bgp group core neighbor 10.12.99.5
set policy-options policy-statement p1 term a from rib inetflow.0
set policy-options policy-statement p1 term a from route-filter 10.13.0.0/16 orlonger
set policy-options policy-statement p1 term a then accept
set policy-options policy-statement p1 term b then reject
set routing-options autonomous-system 65001
Procédure étape par étape
L’exemple suivant nécessite que vous naviguiez à différents niveaux dans la hiérarchie de configuration. Pour plus d’informations sur la navigation dans la CLI, reportez-vous à la section Utilisation de l’éditeur CLI en mode configuration dans le Guide de l’utilisateur de la CLI de Junos OS.
Pour configurer les sessions d’pair BGP :
Configurez le groupe BGP.
[edit protocols bgp group core]
user@host# set family inet unicast
user@host# set family inet flow
user@host# set export p1
user@host# set peer-as 65000
user@host# set neighbor 10.12.99.5
Configurez la stratégie de flux.
[edit policy-options policy-statement p1]
user@host# set term a from rib inetflow.0
user@host# set term a from route-filter 10.13.0.0/16 orlonger
user@host# set term a then accept
user@host# set term b then reject
Configurez le numéro du système autonome local (AS).
[edit routing-options]
user@host# set autonomous-system 65001
Résultats
En mode configuration, confirmez votre configuration en entrant les show protocolscommandes , show policy-optionset . show routing-options Si la sortie n’affiche pas la configuration prévue, répétez les instructions de cet exemple pour corriger la configuration.
[edit]
user@host# show protocols
bgp {
    group core {
        family inet {
            unicast;
            flow;
        }
        export p1;
        peer-as 65000;
        neighbor 10.12.99.5;
    }
}
[edit]
user@host# show policy-options
policy-statement p1 {
    term a {
        from {
            rib inetflow.0;
            route-filter 10.13.0.0/16 orlonger;
        }
        then accept;
    }
    term b {
        then reject;
    }
}
[edit]
user@host# show routing-options
autonomous-system 65001;
Si vous avez terminé de configurer l’appareil, entrez en commit mode configuration.
Advertising Toutes les routes unicast et de flux
Configuration rapide de la CLI
Pour configurer rapidement cet exemple, copiez les commandes suivantes, collez-les dans un fichier texte, supprimez les sauts de ligne, modifiez tous les détails nécessaires pour qu’ils correspondent à votre configuration réseau, puis copiez-collez les commandes dans le CLI au niveau de la [edit] hiérarchie.
set protocols bgp group core family inet unicast
set protocols bgp group core family inet flow
set protocols bgp group core export p1
set protocols bgp group core peer-as 65000
set protocols bgp group core neighbor 10.12.99.5
set policy-options policy-statement p1 term a then accept
set routing-options autonomous-system 65001
Procédure étape par étape
L’exemple suivant nécessite que vous naviguiez à différents niveaux dans la hiérarchie de configuration. Pour plus d’informations sur la navigation dans la CLI, reportez-vous à la section Utilisation de l’éditeur CLI en mode configuration dans le Guide de l’utilisateur de la CLI de Junos OS.
Pour configurer les sessions d’pair BGP :
Configurez le groupe BGP.
[edit protocols bgp group core]
user@host# set family inet unicast
user@host# set family inet flow
user@host# set export p1
user@host# set peer-as 65000
user@host# set neighbor 10.12.99.5
Configurez la stratégie de flux.
[edit policy-options policy-statement p1]
user@host# set term a then accept
Configurez le numéro du système autonome local (AS).
[edit routing-options]
user@host# set autonomous-system 65001
Résultats
En mode configuration, confirmez votre configuration en entrant les show protocolscommandes , show policy-optionset . show routing-options Si la sortie n’affiche pas la configuration prévue, répétez les instructions de cet exemple pour corriger la configuration.
[edit]
user@host# show protocols
bgp {
    group core {
        family inet {
            unicast;
            flow;
        }
        export p1;
        peer-as 65000;
        neighbor 10.12.99.5;
    }
}
[edit]
user@host# show policy-options
policy-statement p1 {
    term a {
        prefix-list inetflow;
        }
        then accept;
    }
}
[edit]
user@host# show routing-options
autonomous-system 65001;
Si vous avez terminé de configurer l’appareil, entrez en commit mode configuration.
Advertising Pas de routes unicast ou de flux
Configuration rapide de la CLI
Pour configurer rapidement cet exemple, copiez les commandes suivantes, collez-les dans un fichier texte, supprimez les sauts de ligne, modifiez tous les détails nécessaires pour qu’ils correspondent à votre configuration réseau, puis copiez-collez les commandes dans le CLI au niveau de la [edit] hiérarchie.
set protocols bgp group core family inet unicast
set protocols bgp group core family inet flow
set protocols bgp group core export p1
set protocols bgp group core peer-as 65000
set protocols bgp group core neighbor 10.12.99.5
set policy-options policy-statement p1 term a then reject
set routing-options autonomous-system 65001
Procédure étape par étape
L’exemple suivant nécessite que vous naviguiez à différents niveaux dans la hiérarchie de configuration. Pour plus d’informations sur la navigation dans la CLI, reportez-vous à la section Utilisation de l’éditeur CLI en mode configuration dans le Guide de l’utilisateur de la CLI de Junos OS.
Pour configurer les sessions d’pair BGP :
Configurez le groupe BGP.
[edit protocols bgp group core]
user@host# set family inet unicast
user@host# set family inet flow
user@host# set export p1
user@host# set peer-as 65000
user@host# set neighbor 10.12.99.5
Configurez la stratégie de flux.
[edit policy-options policy-statement p1]
user@host# set term a then reject
Configurez le numéro du système autonome local (AS).
[edit routing-options]
user@host# set autonomous-system 65001
Résultats
En mode configuration, confirmez votre configuration en entrant les show protocolscommandes , show policy-optionset . show routing-options Si la sortie n’affiche pas la configuration prévue, répétez les instructions de cet exemple pour corriger la configuration.
[edit]
user@host# show protocols
bgp {
    group core {
        family inet {
            unicast;
            flow;
        }
        export p1;
        peer-as 65000;
        neighbor 10.12.99.5;
    }
}
[edit]
user@host# show policy-options
policy-statement p1 {
    term a {
        then reject;
    }
}
[edit]
user@host# show routing-options
autonomous-system 65001;
Si vous avez terminé de configurer l’appareil, entrez en commit mode configuration.
Limitation du nombre de routes de flux installées dans une table de routage
Configuration rapide de la CLI
Pour configurer rapidement cet exemple, copiez les commandes suivantes, collez-les dans un fichier texte, supprimez les sauts de ligne, modifiez tous les détails nécessaires pour qu’ils correspondent à votre configuration réseau, puis copiez-collez les commandes dans le CLI au niveau de la [edit] hiérarchie.
set routing-options rib inetflow.0 maximum-prefixes 1000
set routing-options rib inetflow.0 maximum-prefixes threshold 50
Procédure étape par étape
L’exemple suivant nécessite que vous naviguiez à différents niveaux dans la hiérarchie de configuration. Pour plus d’informations sur la navigation dans la CLI, reportez-vous à la section Utilisation de l’éditeur CLI en mode configuration dans le Guide de l’utilisateur de la CLI de Junos OS.
L’application d’une limite de route peut entraîner un comportement imprévisible et dynamique du protocole de route. Par exemple, une fois la limite atteinte et les routes rejetées, BGP ne tente pas nécessairement de réinstaller les routes rejetées une fois que le nombre de routes est tombé en dessous de la limite. Pour résoudre ce problème, il peut être nécessaire d’effacer les sessions BGP.
Pour limiter les itinéraires de flux :
Définissez une limite supérieure pour le nombre de préfixes installés dans
inetflow.0la table.[edit routing-options rib inetflow.0] user@host# set maximum-prefixes 1000
Définissez une valeur seuil de 50 %, où lorsque 500 routes sont installées, un avertissement est enregistré dans le journal système.
[edit routing-options rib inetflow.0]
user@host# set maximum-prefixes threshold 50
Résultats
À partir du mode configuration, confirmez votre configuration en entrant la show routing-options commande. Si la sortie n’affiche pas la configuration prévue, répétez les instructions de cet exemple pour corriger la configuration.
[edit]
user@host# show routing-options
rib inetflow.0 {
    maximum-prefixes 1000 threshold 50;
}
Si vous avez terminé de configurer l’appareil, entrez en commit mode configuration.
Limitation du nombre de préfixes reçus sur une session d’appairage BGP
Configuration rapide de la CLI
Pour configurer rapidement cet exemple, copiez les commandes suivantes, collez-les dans un fichier texte, supprimez les sauts de ligne, modifiez tous les détails nécessaires pour qu’ils correspondent à votre configuration réseau, puis copiez-collez les commandes dans le CLI au niveau de la [edit] hiérarchie.
set protocols bgp group x1 neighbor 10.12.99.2 family inet flow prefix-limit maximum 1000
set protocols bgp group x1 neighbor 10.12.99.2 family inet flow prefix-limit teardown 50
set protocols bgp group x1 neighbor 10.12.99.2 family inet flow prefix-limit drop-excess 50
set protocols bgp group x1 neighbor 10.12.99.2 family inet flow prefix-limit hide-excess 50
Vous pouvez inclure l’option , drop-excess <percentage>ou hide-excess<percentage> l’instruction teardown <percentage>une par une.
Procédure étape par étape
L’exemple suivant nécessite que vous naviguiez à différents niveaux dans la hiérarchie de configuration. Pour plus d’informations sur la navigation dans la CLI, reportez-vous à la section Utilisation de l’éditeur CLI en mode configuration dans le Guide de l’utilisateur de la CLI de Junos OS.
La configuration d’une limite de préfixe pour un voisin spécifique permet de contrôler de manière plus prévisible quel homologue peut annoncer le nombre de routes de flux.
Pour limiter le nombre de préfixes :
Définissez une limite de 1000 routes BGP à partir du voisin 10.12.99.2.
[edit protocols bgp group x1]
user@host# set neighbor 10.12.99.2 family inet flow prefix-limit maximum 1000
-
Configurez la session voisine ou les préfixes pour exécuter
teardown <percentage>l’option d’instruction ,drop-excess <percentage>ouhide-excess<percentage>lorsque la session ou les préfixes atteignent leur limite.[edit routing-options rib inetflow.0] user@host# set neighbor 10.12.99.2 family inet flow prefix-limit teardown 50 set neighbor 10.12.99.2 family inet flow prefix-limit drop-excess 50 set neighbor 10.12.99.2 family inet flow prefix-limit hide-excess 50
Si vous spécifiez l’instruction
teardown <percentage>et spécifiez un pourcentage, les messages sont consignés lorsque le nombre de préfixes atteint ce pourcentage. Une fois la session arrêtée, elle est rétablie en peu de temps, sauf si vous incluez laidle-timeoutdéclaration.Si vous spécifiez l’instruction
drop-excess <percentage>et spécifiez un pourcentage, les routes excédentaires sont supprimées lorsque le nombre de préfixes dépasse ce pourcentageSi vous spécifiez l’instruction
hide-excess <percentage>et spécifiez un pourcentage, les itinéraires excédentaires sont masqués lorsque le nombre de préfixes dépasse ce pourcentage.
Résultats
À partir du mode configuration, confirmez votre configuration en entrant la show protocols commande. Si la sortie n’affiche pas la configuration prévue, répétez les instructions de cet exemple pour corriger la configuration.
[edit]
user@host# show protocols
bgp {
    group x1 {
        neighbor 10.12.99.2 {
                flow {
                    prefix-limit {
                        maximum 1000;
                        teardown 50;
                        drop-excess <percentage>;
                        hide-excess <percentage>;
                    }
                }
            }
        }
    }
}
Si vous avez terminé de configurer l’appareil, entrez en commit mode configuration.
Vérification
Vérifiez que la configuration fonctionne correctement.
- Vérification du NLRI
- Vérification des routes
- Vérification de la validation des flux
- Vérification des filtres de pare-feu
- Vérification de la journalisation du système en cas de dépassement du nombre de routes de flux autorisées
- Vérification de la journalisation du système en cas de dépassement du nombre de préfixes reçus sur une session d’appairage BGP
Vérification du NLRI
Objet
Regardez le NLRI activé pour le voisin.
Mesures à prendre
À partir du mode opérationnel, exécutez la show bgp neighbor 10.12.99.5 commande. inet-flow Recherchez dans le résultat.
user@host> show bgp neighbor 10.12.99.5
Peer: 10.12.99.5+3792 AS 65000 Local: 10.12.99.6+179 AS 65002
Type: External State: Established Flags: <Sync>
Last State: OpenConfirm Last Event: RecvKeepAlive
Last Error: None
Export: [ direct ]
Options: <Preference HoldTime AddressFamily PeerAS Refresh>
Address families configured: inet-unicast inet-multicast inet-flow
Holdtime: 90 Preference: 170
Number of flaps: 1
Error: 'Cease' Sent: 0 Recv: 1
Peer ID: 10.255.71.161 Local ID: 10.255.124.107 Active Holdtime: 90
Keepalive Interval: 30 Peer index: 0
Local Interface: e1-3/0/0.0
NLRI advertised by peer: inet-unicast inet-multicast inet-flow
NLRI for this session: inet-unicast inet-multicast inet-flow
Peer supports Refresh capability (2)
Table inet.0 Bit: 10000
RIB State: BGP restart is complete
Send state: in sync
Active prefixes: 2
Received prefixes: 2
Suppressed due to damping: 0
Advertised prefixes: 3
Table inet.2 Bit: 20000
RIB State: BGP restart is complete
Send state: in sync
Active prefixes: 0
Received prefixes: 0
Suppressed due to damping: 0
Advertised prefixes: 0
Table inetflow.0 Bit: 30000
RIB State: BGP restart is complete
Send state: in sync
Active prefixes: 0
Received prefixes: 0
Suppressed due to damping: 0
Advertised prefixes: 0
Last traffic (seconds): Received 29 Sent 15 Checked 15
Input messages: Total 5549 Updates 2618 Refreshes 0 Octets 416486
Output messages: Total 2943 Updates 1 Refreshes 0 Octets 55995
Output Queue[0]: 0
Output Queue[1]: 0
Output Queue[2]: 0
Vérification des routes
Objet
Regardez les itinéraires d’écoulement. L’exemple de sortie montre un itinéraire de flux appris à partir de BGP et un itinéraire de flux configuré statiquement.
Pour les routes de flux configurées localement (configurées au niveau de la [edit routing-options flow] hiérarchie), les routes sont installées par le protocole de flux. Par conséquent, vous pouvez afficher les itinéraires de flux en spécifiant la table, comme dans show route table inetflow.0 ou show route table instance-name.inetflow.0, où instance-name est le nom de l’instance de routage. Vous pouvez également afficher toutes les routes de flux configurées localement sur plusieurs instances de routage en exécutant la show route protocol flow commande.
Si une route de flux n’est pas configurée localement, mais reçue du pair BGP du routeur, cette route de flux est installée dans la table de routage par BGP. Vous pouvez afficher les itinéraires de flux en spécifiant le tableau ou en exécutant show route protocol bgp, qui affiche tous les itinéraires BGP (flux et non-flux).
Mesures à prendre
À partir du mode opérationnel, exécutez la show route table inetflow.0 commande.
user@host> show route table inetflow.0
inetflow.0: 2 destinations, 2 routes (2 active, 0 holddown, 0 hidden)
+ = Active Route, - = Last Active, * = Both

100.100.100.100,*,proto=1,icmp-type=8/term:1
                   *[BGP/170] 00:00:18, localpref 100, from 100.0.12.2
                      AS path: 2000 I, validation-state: unverified
                      Fictitious
200.200.200.200,*,proto=6,port=80/term:2
                   *[BGP/170] 00:00:18, localpref 100, from 100.0.12.2
                      AS path: 2000 I, validation-state: unverified
                      Fictitious
user@host> show route table inetflow.0 extensive
inetflow.0: 3 destinations, 3 routes (3 active, 0 holddown, 0 hidden)
7.7.7.7,8.8.8.8/term:1 (1 entry, 1 announced)
TSI:
KRT in dfwd;
Action(s): accept,count
        *Flow   Preference: 5
                Next hop type: Fictitious
                Address: 0x8d383a4
                Next-hop reference count: 3
                State: <Active>
                Local AS: 65000
                Age: 9:50
                Task: RT Flow
                Announcement bits (1): 0-Flow
                AS path: I
user@host> show route hidden
inetflow.0: 2 destinations, 2 routes (0 active, 0 holddown, 2 hidden)
+ = Active Route, - = Last Active, * = Both

100.100.100.100,*,proto=1,icmp-type=8/term:N/A
                    [BGP ] 00:00:17, localpref 100, from 100.0.12.2
                      AS path: 2000 I, validation-state: unverified
                      Fictitious
200.200.200.200,*,proto=6,port=80/term:N/A
                    [BGP ] 00:00:17, localpref 100, from 100.0.12.2
                      AS path: 2000 I, validation-state: unverified
                      Fictitious
Signification
Une route de flux représente un terme d’un filtre de pare-feu. Lorsque vous configurez un itinéraire de flux, vous spécifiez les conditions de correspondance et les actions. Dans les attributs de correspondance, vous pouvez faire correspondre une adresse source, une adresse de destination et d’autres qualificatifs tels que le port et le protocole. Pour un itinéraire de flux unique qui contient plusieurs conditions de correspondance, toutes les conditions de correspondance sont encapsulées dans le champ de préfixe de la route. Lorsque vous exécutez la show route commande sur un itinéraire de flux, le champ de préfixe de l’itinéraire s’affiche avec toutes les conditions de correspondance. 10.12.44.1,* signifie que la condition de correspondance est match destination 10.12.44.1/32. Si le préfixe dans la sortie était *,10.12.44.1, cela signifierait que la condition de correspondance était match source 10.12.44.1/32. Si les conditions de correspondance contiennent à la fois une source et une destination, l’astérisque est remplacé par l’adresse.
Les numéros d’ordre des termes indiquent la séquence des termes (itinéraires de flux) évalués dans le filtre de pare-feu. La show route extensive commande affiche les actions pour chaque terme (route).
Vérification de la validation des flux
Objet
Afficher les informations sur l’itinéraire du flux.
Mesures à prendre
À partir du mode opérationnel, exécutez la show route flow validation detail commande.
user@host> show route flow validation detail
inet.0:
0.0.0.0/0
                Internal node: best match, inconsistent
10.0.0.0/8
                Internal node: no match, inconsistent
10.12.42.0/24
                Internal node: no match, consistent, next-as: 65003
                Active unicast route
                    Dependent flow destinations: 1
                    Origin: 10.255.124.106, Neighbor AS: 65003
10.12.42.1/32
                Flow destination (1 entries, 1 match origin)
                    Unicast best match: 10.12.42.0/24
                    Flags: Consistent
10.131.0.0/16
                Internal node: no match, consistent, next-as: 65001
                Active unicast route
                    Dependent flow destinations: 5000
                    Origin: 10.12.99.2, Neighbor AS: 65001
10.131.0.0/19
                Internal node: best match
10.131.0.0/20
                Internal node: best match
10.131.0.0/21
Vérification des filtres de pare-feu
Objet
Affichez les filtres de pare-feu installés dans le noyau.
Mesures à prendre
À partir du mode opérationnel, exécutez la show firewall commande.
user@host> show firewall
Filter: __default_bpdu_filter__
Filter: __flowspec_default_inet__
Counters:
Name                                                Bytes              Packets
10.12.42.1,*                                            0                    0
196.1.28/23,*                                           0                    0
196.1.30/24,*                                           0                    0
196.1.31/24,*                                           0                    0
196.1.32/24,*                                           0                    0
196.1.56/21,*                                           0                    0
196.1.68/24,*                                           0                    0
196.1.69/24,*                                           0                    0
196.1.70/24,*                                           0                    0
196.1.75/24,*                                           0                    0
196.1.76/24,*                                           0                    0
Vérification de la journalisation du système en cas de dépassement du nombre de routes de flux autorisées
Objet
Si vous configurez une limite sur le nombre de routes de flux installées, comme décrit dans Limitation du nombre de routes de flux installées dans une table de routage, affichez le message du journal système lorsque le seuil est atteint.
Mesures à prendre
À partir du mode opérationnel, exécutez la show log <message> commande.
user@host> show log message
Jul 12 08:19:01  host rpd[2748]: RPD_RT_MAXROUTES_WARN: Number of routes (1000) in
table inetflow.0 exceeded warning threshold (50 percent of configured maximum 1000)
Vérification de la journalisation du système en cas de dépassement du nombre de préfixes reçus sur une session d’appairage BGP
Objet
Si vous configurez une limite sur le nombre de routes de flux installées, comme décrit dans Limitation du nombre de préfixes reçus sur une session d’appairage BGP, affichez le message du journal système lorsque le seuil est atteint.
Mesures à prendre
À partir du mode opérationnel, exécutez la show log message commande.
Si vous spécifiez l’option d’instruction teradown <percentage> :
user@host> show log message
Jul 12 08:44:47  host rpd[2748]: 10.12.99.2 (External AS 65001): Shutting down peer due to
exceeding configured maximum  prefix-limit(1000) for inet-flow nlri: 1001
Si vous spécifiez l’option d’instruction drop-excess <percentage> :
user@host> show log message
Jul 27 15:26:57  R1_re rpd[32443]: BGP_DROP_PREFIX_LIMIT_EXCEEDED: 1.1.1.2 (Internal
AS 1): Exceeded drop-excess maximum prefix-limit(4) for inet-unicast nlri: 5 (instance master)
Si vous spécifiez l’option d’instruction hide-excess <percentage> :
user@host> show log message
Jul 27 15:26:57  R1_re rpd[32443]: BGP_HIDE_PREFIX_LIMIT_EXCEEDED: 1.1.1.2 (Internal
AS 1): Exceeded hide-excess maximum prefix-limit(4) for inet-unicast nlri: 5 (instance master)
Exemple : configuration de BGP pour transporter des routes de spécification de flux IPv6
Cet exemple montre comment configurer la spécification de flux IPv6 pour le filtrage du trafic. La spécification de flux BGP peut être utilisée pour automatiser la coordination interdomaine et intradomaine des règles de filtrage du trafic afin de limiter les attaques par déni de service.
Exigences
Cet exemple utilise les composants matériels et logiciels suivants :
-
Deux routeurs MX Series
-
Junos OS version 16.1 ou ultérieure
Avant d’activer BGP pour transporter des routes de spécification de flux IPv6 :
-
Configurez les adresses IP sur les interfaces des appareils.
-
Configurez BGP.
-
Configurez une politique de routage qui exporte des routes (telles que des routes statiques, des routes directes ou des routes IGP) de la table de routage vers BGP.
Vue d’ensemble
La spécification de flux fournit une protection contre les attaques par déni de service et limite le trafic malveillant qui consomme la bande passante et l’arrête près de la source. Dans les versions antérieures de Junos OS, des règles de spécification de flux étaient propagées pour IPv4 sur BGP en tant qu’informations d’accessibilité de la couche réseau. À partir de la version 16.1 de Junos OS, la fonctionnalité de spécification de flux est prise en charge sur la famille IPv6 et permet la propagation des règles de spécification de flux de trafic pour IPv6 et les VPN IPv6.
Topologie
La figure 7 montre l’exemple de topologie. Le routeur R1 et le routeur R2 appartiennent à des systèmes autonomes différents. La spécification de flux IPv6 est configurée sur le routeur R2. L’ensemble du trafic entrant est filtré en fonction des conditions de spécification du flux, et le trafic est traité différemment selon l’action spécifiée. Dans cet exemple, tout le trafic se dirigeant vers abcd ::11:11:11:10/128 qui correspond aux conditions de spécification de flux est ignoré ; En revanche, le trafic destiné à ABCD ::11:11:11:30/128 et correspondant aux conditions de spécification de flux est accepté.
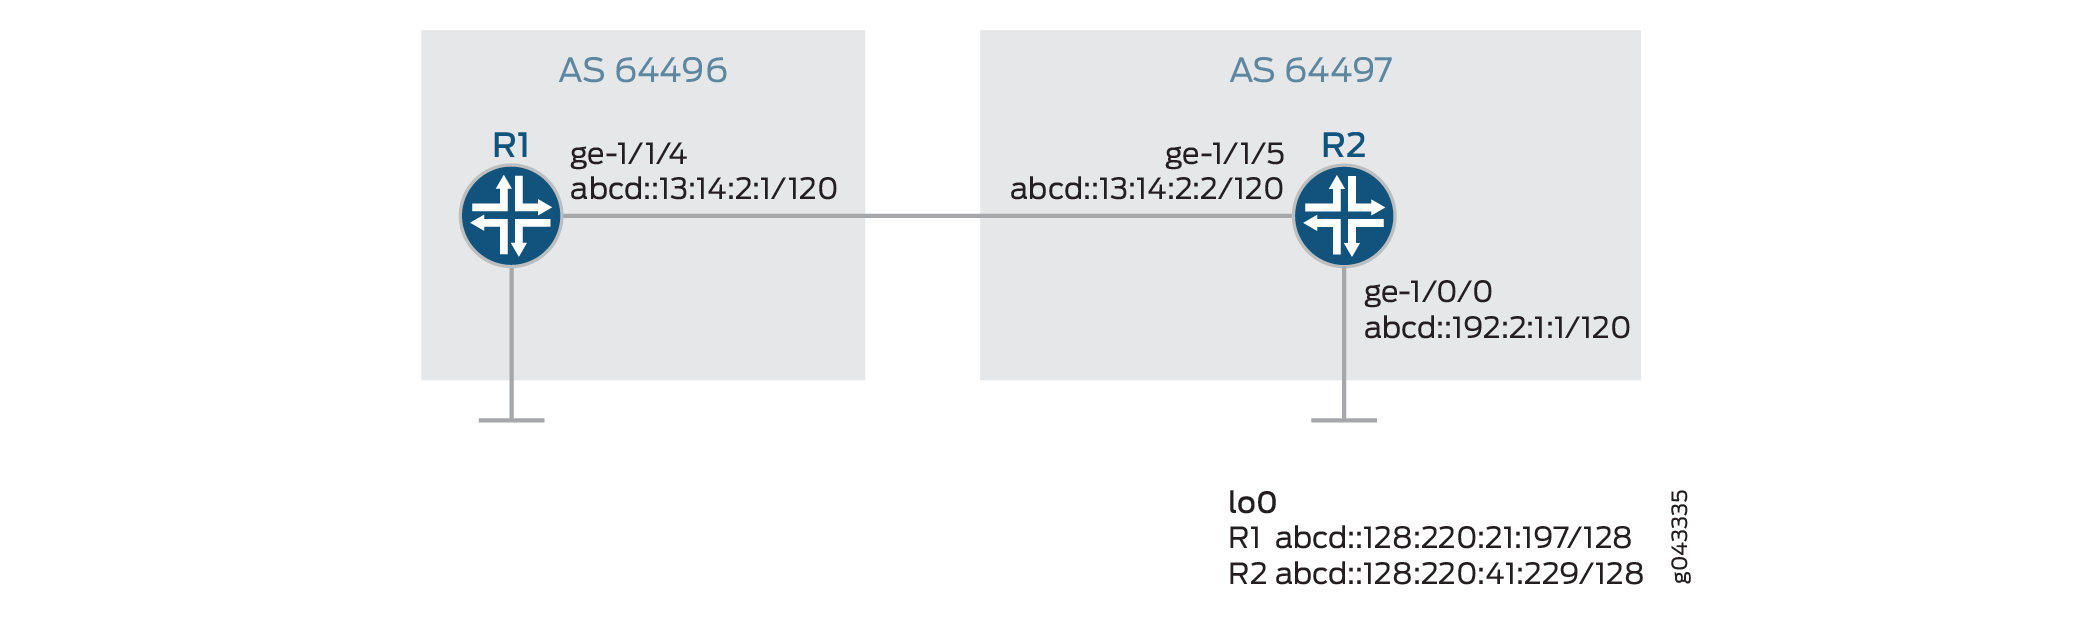 de flux IPv6
La configuration
Configuration rapide de la CLI
Pour configurer rapidement cet exemple, copiez les commandes suivantes, collez-les dans un fichier texte, supprimez les sauts de ligne, modifiez tous les détails nécessaires pour qu’ils correspondent à votre configuration réseau, copiez et collez les commandes dans la CLI au niveau de la [edit] hiérarchie, puis entrez commit en mode configuration.
Routeur R1
set interfaces ge-1/1/4 unit 0 family inet6 address abcd::13:14:2:1/120
set interfaces lo0 unit 0 family inet6 address abcd::128:220:21:197/128
set routing-options router-id 128.220.21.197
set routing-options autonomous-system 64496
set protocols bgp group ebgp type external
set protocols bgp group ebgp family inet6 unicast
set protocols bgp group ebgp family inet6 flow
set protocols bgp group ebgp peer-as 64497
set protocols bgp group ebgp neighbor abcd::13:14:2:2
Routeur R2
set interfaces ge-1/0/0 unit 0 family inet6 address abcd::192:2:1:1/120
set interfaces ge-1/1/5 unit 0 family inet6 address abcd::13:14:2:2/120
set interfaces lo0 unit 0 family inet6 address abcd::128:220:41:229/128
set routing-options rib inet6.0 static route abcd::11:11:11:0/120 next-hop abcd::192:2:1:2
set routing-options rib inet6.0 flow route route-1 match destination abcd::11:11:11:10/128
set routing-options rib inet6.0 flow route route-1 match protocol tcp
set routing-options rib inet6.0 flow route route-1 match destination-port http
set routing-options rib inet6.0 flow route route-1 match source-port 65535
set routing-options rib inet6.0 flow route route-1 then discard
set routing-options rib inet6.0 flow route route-2 match destination abcd::11:11:11:30/128
set routing-options rib inet6.0 flow route route-2 match icmp6-type echo-request
set routing-options rib inet6.0 flow route route-2 match packet-length 100
set routing-options rib inet6.0 flow route route-2 match dscp 10
set routing-options rib inet6.0 flow route route-2 then accept
set routing-options router-id 128.220.41.229
set routing-options autonomous-system 64497
set protocols bgp group ebgp type external
set protocols bgp group ebgp family inet6 unicast
set protocols bgp group ebgp family inet6 flow
set protocols bgp group ebgp export redis
set protocols bgp group ebgp peer-as 64496
set protocols bgp group ebgp neighbor abcd::13:14:2:1
set policy-options policy-statement redis from protocol static
set policy-options policy-statement redis then accept
Configuration du routeur R2
Procédure étape par étape
L’exemple suivant nécessite que vous naviguiez à différents niveaux dans la hiérarchie de configuration. Pour plus d’informations sur la navigation dans la CLI, consultez Utilisation de l’éditeur CLI en mode configuration dans le Guide de l’utilisateur de la CLI.
Pour configurer le routeur R2 :
Répétez cette procédure pour le routeur R1 après avoir modifié les noms, adresses et autres paramètres d’interface appropriés.
-
Configurez les interfaces avec des adresses IPv6.
[edit interfaces]
user@R2# set ge-1/0/0 unit 0 family inet6 address abcd::192:2:1:1/120
user@R2# set ge-1/1/5 unit 0 family inet6 address abcd::13:14:2:2/120
-
Configurez l’adresse de bouclage IPv6.
[edit interfaces]
user@R2# set lo0 unit 0 family inet6 address abcd::128:220:41:229/128
-
Configurez l’ID du routeur et le numéro du système autonome (AS).
[edit routing-options]
user@R2# set router-id 128.220.41.229
user@R2# set autonomous-system 64497
-
Configurez une session d’appairage EBGP entre le routeur R1 et le routeur R2.
[edit protocols]
user@R2# set bgp group ebgp type external
user@R2# set bgp group ebgp family inet6 unicast
user@R2# set bgp group ebgp family inet6 flow
user@R2# set bgp group ebgp export redis
user@R2# set bgp group ebgp peer-as 64496
user@R2# set bgp group ebgp neighbor abcd::13:14:2:1
-
Configurez une route statique et un saut suivant. Ainsi, une route est ajoutée à la table de routage pour vérifier la fonctionnalité dans cet exemple.
[edit routing-options]
user@R2# set rib inet6.0 static route abcd::11:11:11:0/120 next-hop abcd::192:2:1:2
-
Spécifier les conditions de spécification de flux.
[edit routing-options]
user@R2# set rib inet6.0 flow route route-1 match destination abcd::11:11:11:10/128
user@R2# set rib inet6.0 flow route route-1 match protocol tcp
user@R2# set rib inet6.0 flow route route-1 match destination-port http
user@R2# set rib inet6.0 flow route route-1 match source-port 65535
-
Configurez une discard action pour ignorer les paquets qui correspondent aux conditions de correspondance spécifiées.
[edit routing-options]
user@R2# set rib inet6.0 flow route route-1 then discard
-
Spécifier les conditions de spécification de flux.
[edit routing-options]
user@R2# set rib inet6.0 flow route route-2 match destination abcd::11:11:11:30/128
user@R2# set rib inet6.0 flow route route-2 match icmp6-type echo-request
user@R2# set rib inet6.0 flow route route-2 match packet-length 100
user@R2# set rib inet6.0 flow route route-2 match dscp 10
-
Configurer une accept action pour accepter les paquets qui correspondent aux conditions de correspondance spécifiées
[edit routing-options]
user@R2# set rib inet6.0 flow route route-2 then accept
-
Définissez une stratégie permettant à BGP d’accepter des routes statiques.
[edit policy-options]
user@R2# set policy-statement redis from protocol static
user@R2# set policy-statement redis then accept
Résultats
En mode configuration, confirmez votre configuration en entrant les show interfacescommandes , show protocolsshow routing-options, , et show policy-options . Si la sortie n’affiche pas la configuration prévue, répétez les instructions de cet exemple pour corriger la configuration.
[edit]
user@R2# show interfaces
ge-1/0/0 {
    unit 0 {
        family inet6 {
            address abcd::192:2:1:1/120;
        }
    }
}
ge-1/1/5 {
    unit 0 {
        family inet6 {
            address abcd::13:14:2:2/120;
        }
    }
}
lo0 {
    unit 0 {
        family inet6 {
            address abcd::128:220:41:229/128;
        }
    }
}
[edit]
user@R2# show protocols
bgp {
    group ebgp {
        type external;
        family inet6 {
            unicast;
            flow;
        }
        export redis;
        peer-as 64496;
        neighbor abcd::13:14:2:1;
    }
}
[edit]
user@R2# show routing-options
rib inet6.0 {
    static {
        route abcd::11:11:11:0/120 next-hop abcd::192:2:1:2;
    }
    flow {
        route route-1 {
            match {
                destination abcd::11:11:11:10/128;
                protocol tcp;
                destination-port http;
                source-port 65535;
            }
            then discard;
        }
        route route-2 {
            match {
                destination abcd::11:11:11:30/128;
                icmp6-type echo-request;
                packet-length 100;
                dscp 10;
            }
            then accept;
        }
    }
}
router-id 128.220.41.229;
autonomous-system 64497;
[edit]
user@R2# show policy-options
policy-statement redis {
    from protocol static;
    then accept;
}
Vérification
Vérifiez que la configuration fonctionne correctement.
- Vérification de la présence de routes de spécification de flux IPv6 dans la table inet6flow
- Vérification des informations récapitulatives de BGP
- Vérification de la validation des flux
- Vérification de la spécification de flux des routes IPv6
Vérification de la présence de routes de spécification de flux IPv6 dans la table inet6flow
Objet
Affichez les routes dans le inet6flow tableau des routeurs R1 et R2 et vérifiez que BGP a appris les routes de flux.
Mesures à prendre
À partir du mode opérationnel, exécutez la commande sur le show route table inet6flow.0 extensive routeur R1.
user@R1>
                  show route table inet6flow.0 extensive
inet6flow.0: 2 destinations, 2 routes (2 active, 0 holddown, 0 hidden)
abcd::11:11:11:10/128,*,proto=6,dstport=80,srcport=65535/term:1 (1 entry, 1 announced)
TSI:
KRT in dfwd;
Action(s): discard,count
        *BGP    Preference: 170/-101
                Next hop type: Fictitious, Next hop index: 0
                Address: 0x9b24064
                Next-hop reference count: 2
                State:<Active Ext>
                Local AS:   64496 Peer AS:  64497
                Age: 20:55
                Validation State: unverified
                Task: BGP_64497.abcd::13:14:2:2
                Announcement bits (1): 0-Flow
                AS path: 64497 I
                Communities: traffic-rate:64497:0
                Accepted
                Validation state: Accept, Originator: abcd::13:14:2:2, Nbr AS: 64497
                Via: abcd::11:11:11:0/120, Active
                Localpref: 100
                Router ID: 128.220.41.229

abcd::11:11:11:30/128,*,icmp6-type=128,len=100,dscp=10/term:2 (1 entry, 1 announced)
TSI:
KRT in dfwd;
Action(s): accept,count
        *BGP    Preference: 170/-101
                Next hop type: Fictitious, Next hop index: 0
                Address: 0x9b24064
                Next-hop reference count: 2
                State:  <Active Ext>
                Local AS:   64496 Peer AS:  64497
                Age: 12:51
                Validation State: unverified
                Task: BGP_64497.abcd::13:14:2:2
                Announcement bits (1): 0-Flow
                AS path: 64497 I
                Accepted
                Validation state: Accept, Originator: abcd::13:14:2:2, Nbr AS: 64497
                Via: abcd::11:11:11:0/120, Active
                Localpref: 100
                Router ID: 128.220.41.229
À partir du mode opérationnel, exécutez la commande sur le show route table inet6flow.0 extensive routeur R2.
user@R2> show route table inet6flow.0 extensive
inet6flow.0: 2 destinations, 2 routes (2 active, 0 holddown, 0 hidden)
abcd::11:11:11:10/128,*,proto=6,dstport=80,srcport=65535/term:1 (1 entry, 1 announced)
TSI:
KRT in dfwd;
Action(s): discard,count
Page 0 idx 0, (group pe-v6 type External) Type 1 val 0xaec8850 (adv_entry)
   Advertised metrics:
     Nexthop: Self
     AS path: [64497]
     Communities: traffic-rate:64497:0
Path abcd::11:11:11:10/128,*,proto=6,dstport=80,srcport=65535 Vector len 4.  Val: 0
        *Flow   Preference: 5
                Next hop type: Fictitious, Next hop index: 0
                Address: 0x9b24064
                Next-hop reference count: 3
                State:  <Active>
                Local AS:  64497
                Age: 14:21
                Validation State: unverified
                Task: RT Flow
                Announcement bits (2): 0-Flow 1-BGP_RT_Background
                AS path: I
                Communities: traffic-rate:64497:0


abcd::11:11:11:30/128,*,proto=17,port=65535/term:2 (1 entry, 1 announced)
TSI:
KRT in dfwd;
Action(s): accept,count
Page 0 idx 0, (group pe-v6 type External) Type 1 val 0xaec8930 (adv_entry)
 Advertised metrics:
  Nexthop: Self
  AS path: [64497]
  Communities:
Path abcd::11:11:11:30/128,*,proto=17,port=65535 Vector len 4.  Val: 0
*Flow   Preference: 5
    Next hop type: Fictitious, Next hop index: 0
    Address: 0x9b24064
    Next-hop reference count: 3
    State: <Active>
    Local AS:  64497
    Age: 14:21
    Validation State: unverified
    Task: RT Flow
    Announcement bits (2): 0-Flow 1-BGP_RT_Background
    AS path: I
Signification
La présence des routes abcd ::11:11:11:10/128 et abcd ::11:11:11:30/128 confirme inet6flow que BGP a appris les routes de flux.
Vérification des informations récapitulatives de BGP
Objet
Vérifiez que la configuration de BGP est correcte.
Mesures à prendre
À partir du mode opérationnel, exécutez la commande sur les show bgp summary routeurs R1 et R2.
user@R1> show bgp summary

Groups: 1 Peers: 1 Down peers: 0
Table          Tot Paths  Act Paths Suppressed    History Damp State    Pending
inet6.0
                       1          1          0          0          0          0
inet6flow.0
                       2          2          0          0          0          0
Peer                     AS      InPkt     OutPkt    OutQ   Flaps Last Up/Dwn State|#Active/Received/Accepted/Damped...
abcd::13:14:2:2        2000         58         58       0       2       19:48 Establ
  inet6.0: 1/1/1/0
  inet6flow.0: 2/2/2/0
user@R2> show bgp summary
 Groups: 1 Peers: 1 Down peers: 0
Table          Tot Paths  Act Paths Suppressed    History Damp State    Pending
inet6.0
                       0          0          0          0          0          0
inet6flow.0
                       0          0          0          0          0          0
Peer                     AS      InPkt     OutPkt    OutQ   Flaps Last Up/Dwn State|#Active/Received/Accepted/Damped...
abcd::13:14:2:1         64496         51         52       0       0       23:03 Establ
  inet6.0: 0/0/0/0
  inet6flow.0: 0/0/0/0
Signification
Vérifiez que la inet6.0 table contient l’adresse du voisin BGP et qu’une session d’appairage a été établie avec son voisin BGP.
Vérification de la validation des flux
Objet
Afficher les informations sur l’itinéraire du flux.
Mesures à prendre
À partir du mode opérationnel, exécutez la commande sur le show route flow validation routeur R1.
user@R1> show route flow validation
inet6.0:
abcd::11:11:11:0/120
                Active unicast route
                    Dependent flow destinations: 2
                    Origin: abcd::13:14:2:2, Neighbor AS: 64497
abcd::11:11:11:10/128
                Flow destination (1 entries, 1 match origin, next-as)
                    Unicast best match: abcd::11:11:11:0/120
                    Flags: Consistent
abcd::11:11:11:30/128
                Flow destination (1 entries, 1 match origin, next-as)
                    Unicast best match: abcd::11:11:11:0/120
                    Flags: Consistent
Signification
La sortie affiche les itinéraires de flux dans le inet6.0 tableau.
Vérification de la spécification de flux des routes IPv6
Objet
Affiche le nombre de paquets qui sont ignorés et acceptés en fonction des itinéraires de spécification de flux spécifiés.
Mesures à prendre
À partir du mode opérationnel, exécutez la commande sur le show firewall filter_flowspec_default_inet6_ routeur R2.
user@R2> show firewall filter __flowspec_default_inet6__
Filter: __flowspec_default_inet6__
Counters:
Name                                                																Bytes              Packets
abcd::11:11:11:10/128,*,proto=6,dstport=80,srcport=65535            0                     0
abcd::11:11:11:30/128,*,proto=17,port=65535              			  6395472                88826
Signification
La sortie indique que les paquets destinés à abcd ::11:11:11:11:10/128 sont ignorés et que 88826 paquets ont été acceptés pour l’itinéraire abcd ::11:11:11:11:11:30/128.
Configuration de la spécification de flux BGP Redirection vers IP
La fonctionnalité de redirection vers IP de spécification de flux de BGP améliore les capacités d’ingénierie du trafic en permettant la redirection du trafic en fonction des règles de spécification de flux (FlowSpec). Cette fonctionnalité prend en charge la redirection vers une adresse IPv4 ou IPv6, comme décrit dans le projet Internet BGP Flow-Spec : draft-ietf-idr-flowspec-redirect-ip-02.txt, Rediriger vers IP Action. Il est particulièrement utile pour atténuer les attaques DDoS dans les réseaux des fournisseurs de services (SP) et pour le transfert basé sur des politiques dans les environnements de services virtualisés (vSCG).
Cas d’usage
-
Atténuation des DDoS : redirige le trafic malveillant vers les centres de nettoyage pour analyse et nettoyage.
-
Transfert basé sur les stratégies : permet une gestion avancée du trafic en dirigeant les flux de trafic vers des destinations spécifiques en fonction de règles prédéfinies.
Topologie
-
Figure 8 : Flux
 existant
-
Lorsqu’une attaque est détectée, la redirection FlowSpec vers VRF est appliquée au routeur PE (Provider Edge) entrant .
-
Le VRF défectueux redirige ensuite le trafic vers un épurateur connecté à l’EP principal (HE-PE).
-
Une fois le trafic nettoyé, le HE-PE le transmet vers la destination prévue.
-
-
Figure 9 : Nouveau flux
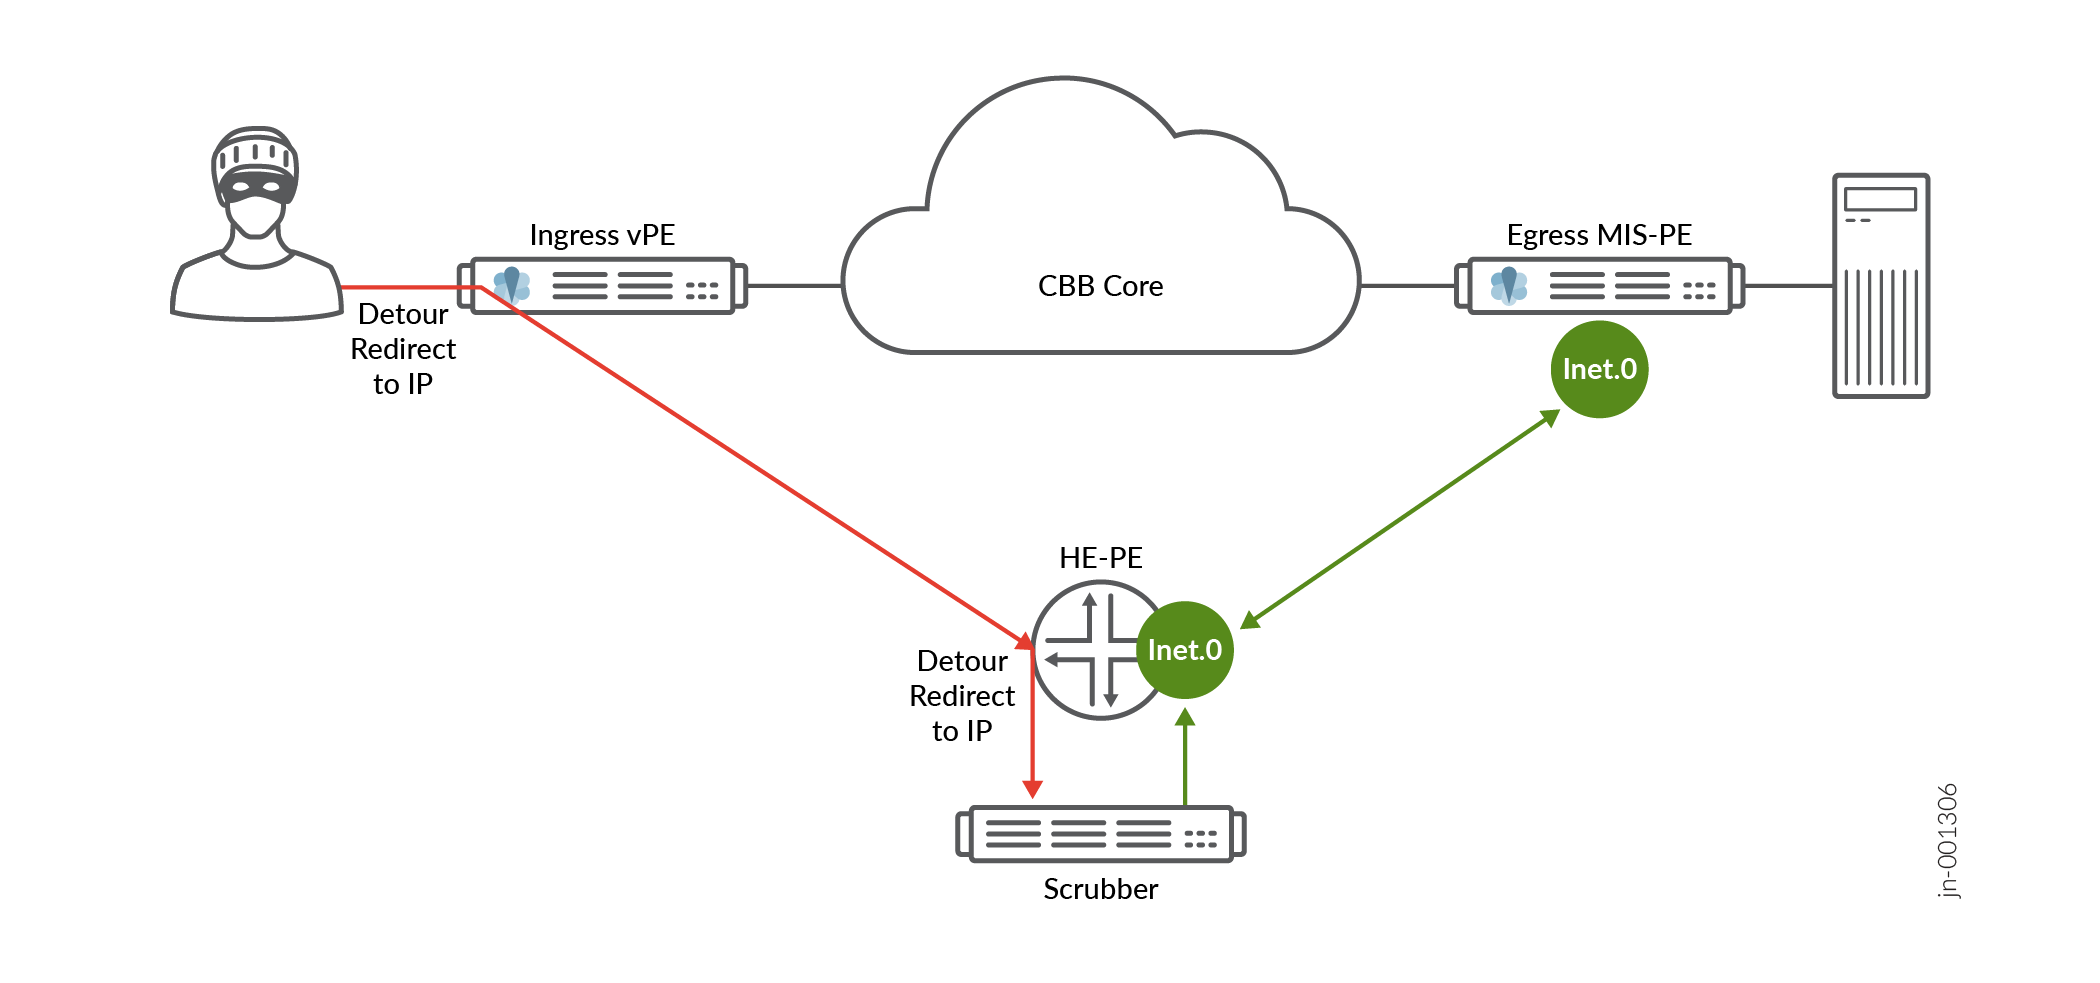
-
Au lieu d’une redirection vers VRF, la redirection FlowSpec vers IP est appliquée aux interfaces externes du PE entrant.
-
Le trafic malveillant est directement transféré à l’HE-PE.
-
LE HE-PE REDIRIGE ENSUITE LE TRAFIC VERS L’ÉPURATEUR EN FONCTION DE LA RÈGLE DE REDIRECTION VERS IP.
-
Le trafic nettoyé est transféré à sa destination sans nécessiter de VRF dédié et sale.
-
Plateformes ciblées
-
Routeurs vMX, MX Series
Objectifs de performances et d’évolutivité
-
La fonctionnalité vise à prendre en charge 1 000 routes FlowSpec de ce type afin de gérer efficacement la redirection du trafic.
Commandes de vérification :
show firewall filter FLOWSPEC
Cette fonctionnalité garantit une meilleure évolutivité, une latence réduite et une atténuation efficace des attaques DDoS en simplifiant le processus de redirection grâce à une gestion du trafic basée sur IP plutôt que sur une segmentation VRF.
Voir aussi
Configuration de l’action de spécification de flux BGP Rediriger vers IP pour filtrer le trafic DDoS
À partir de Junos OS version 18.4R1, BGP spécification de flux telle que décrite dans BGP ébauche Internet de Flow-Spec draft-ietf-idr-flowspec-redirect-ip-02.txt, la redirection vers IP Action est prise en charge. L’action de redirection vers IP utilise la communauté BGP étendue pour fournir des options de filtrage du trafic afin d’atténuer les attaques DDoS dans les réseaux des fournisseurs de services. La redirection de spécification de flux héritée vers IP utilise l’attribut nexthop BGP. Par défaut, Junos OS annonce une redirection vers l’action de spécification de flux IP à l’aide de la communauté étendue. Cette fonctionnalité est nécessaire pour prendre en charge le chaînage de services dans la passerelle de contrôle de services virtuelle (vSCG). L’action Rediriger vers IP permet de détourner le trafic correspondant de spécification de flux vers une adresse accessible globalement qui pourrait être connectée à un périphérique de filtrage capable de filtrer le trafic DDoS et d’envoyer le trafic propre vers le périphérique de sortie.
IPv6 n’est pris en charge qu’avec l’ancien mode d’encodage redirect vers Nexthop. Nous ne prenons pas en charge le nouveau format de codage redirect vers IP pour IPv6.
Avant de commencer à rediriger le trafic vers IP pour les routes de spécification de flux BGP, procédez comme suit :
Configurez les interfaces des appareils.
Configurez OSPF ou tout autre protocole IGP.
Configurez MPLS et LDP.
Configurez BGP.
Configurez la fonctionnalité de redirection vers IP à l’aide de la communauté étendue BGP.
Configurez la redirection de spécification de flux héritée vers la fonctionnalité IP à l’aide de l’attribut nexthop.
Vous ne pouvez pas configurer des stratégies pour rediriger le trafic vers une adresse IP à l’aide de la communauté étendue BGP et de l’ancienne redirection vers l’adresse IP du saut suivant.
Configurer la redirection de spécification de flux héritée vers l’adresse IP spécifiée dans le brouillon Internet draft-ietf-idr-flowspec-redirect-ip-00.txt , BGP Communauté étendue Flow-Spec pour la redirection du trafic vers IP saut suivant inclure au niveau de la hiérarchie.
[edit group bgp-group neighbor bgp neighbor family inet flow]
user@host# set legacy-redirect-ip-action
Définissez une stratégie pour qu’elle corresponde à l’attribut de saut suivant.
[edit policy options]
user@host#policy statement policy_name
user@host#from community community-name
user@host#from next-hop ip-address
Par exemple, définissez une stratégie p1 pour rediriger le trafic vers l’adresse IP du saut suivant 10.1.1.1.
[edit policy options]
user@host#policy statement p1
user@host#from community redirnh
user@host#from next-hop 10.1.1.1
Définissez une stratégie pour définir, ajouter ou supprimer la communauté BGP à l’aide de l’ancienne spécification de flux redirection vers l’action IP.
[edit policy-options]
user@host# policy-statement policy_name
user@host# then community set community-name
user@host# then community add community-name
user@host# then community delete community-name
user@host# then next-hop next-hop-address
Par exemple, définissez une stratégie p1 et définissez, ajoutez ou supprimez une redirnh de communauté BGP pour rediriger le trafic DDoS vers l’adresse IP du saut suivant 10.1.1.1.
[edit policy-options policy-statement p1]
user@host# then community set redirnh
user@host# then community add redirnh
user@host# then community delete redirnh
user@host# then next-hop 10.1.1.1
Voir aussi
Transfert du trafic à l’aide de l’action DSCP de spécification de flux BGP
Configurez l’action DSCP de la spécification de flux BGP (FlowSpec) pour transférer efficacement les paquets à l’aide de la classe de transfert et des informations de priorité de perte sur l’ensemble du réseau.
Avantages de l’action DSCP de BGP FlowSpec pour transférer des paquets
-
Transfère le trafic vers les files d’attente CoS prévues, où les politiques CoS sont correctement appliquées au trafic.
-
Influence le comportement de transfert local (par exemple, la sélection du tunnel) en fonction de la valeur DSCP provisionnée.
-
Aide à gérer efficacement le trafic sur votre réseau.
Lorsqu’un paquet entre dans un routeur, il passe par les fonctionnalités (telles que le pare-feu, le COS, etc.) appliquées à l’interface entrante. Lorsque vous configurez le filtre BGP FlowSpec sur l’interface entrante, le filtre est appliqué aux paquets par instance de routage en fonction de l’action DSCP. L’action DSCP classe et réécrit les paquets, ainsi que la modification du code DSCP via le filtre BGP FlowSpec. En fonction de la classe de transfert et des informations de priorité de perte, les paquets sont placés dans la file d’attente de transfert appropriée. Les paquets ne circulent par les itinéraires de flux que si des conditions de correspondance spécifiques sont remplies. Les conditions de correspondance peuvent être l’adresse IP source et de destination, le port source et de destination, le DSCP, le numéro de protocole, etc. Les informations sur la classe de transfert et la priorité de perte sont mises à jour via la table de mappage inverse.
Voici la topologie d’une session BGP établie entre le fournisseur de services et les réseaux de l’entreprise cliente.
Dans cette topologie, une session BGP est configurée entre le fournisseur de services et le réseau du client d’entreprise pour BGP FlowSpec. Le filtre BGP FlowSpec est appliqué aux routeurs PE1 et PE2. Les paquets entrant dans ces routeurs sont réécrits en fonction du filtre BGP FlowSpec et de l’action DSCP.
Pour activer le filtre BGP FlowSpec sur un appareil, vous devez ajouter l’instruction dscp-mapping-classifier de configuration au niveau de la hiérarchie [edit forwarding-options family (inet | inet6)] :
forwarding-options {
    family inet {
        dscp-mapping-classifier ipv4-classifer;
    }
    family inet6 {
        dscp-mapping-classifier ipv6-classifer;
    }
}
L’exemple suivant de mappage de configuration de classe de service indique que le code DSCP renvoie à la classe de transfert et à la priorité de perte :
class-of-service {
	classifiers {
		dscp dscp1 {
        		forwarding-class best-effort {
            		loss-priority low code-points 000000;
        		}
		}
      }
}
Configuration des stratégies pour la validation de l’itinéraire de flux
Lorsque la spécification de flux est utilisée pour distribuer des filtres via le réseau vers les points d’appairage, le format des filtres de spécification de flux est validé à la source. Si vous souhaitez acheminer des flux de signaux sur une session EBGP vers les pairs, les filtres de spécification de flux doivent être validés au niveau des routeurs de périphérie.
Des stratégies peuvent être utilisées pour effectuer cette validation supplémentaire des itinéraires de flux. Une stratégie peut filtrer les conditions de correspondance de la route de flux pour empêcher l’admission de routes de flux incorrectes, non prises en charge ou indésirables injectées à partir de la source. Il peut également empêcher les routes de flux de bloquer accidentellement ou malicieusement les sessions de protocole.
Les stratégies peuvent être utilisées pour
-
Vérifiez s’il existe une condition particulière de correspondance/d’action de spécification de flux
-
Empêchez la programmation de conditions de correspondance non valides ou indésirables.
- Configuration de stratégies pour vérifier s’il existe une condition de correspondance/d’action de spécification de flux
- Configuration des stratégies pour vérifier les attributs de correspondance des spécifications de flux
Configuration de stratégies pour vérifier s’il existe une condition de correspondance/d’action de spécification de flux
Vous pouvez configurer des stratégies pour vérifier si une condition de correspondance/d’action de flux particulière est annoncée à partir de la source et prendre les mesures nécessaires. Chaque route de flux a une condition de correspondance et une condition d’action. Configurez les instructions suivantes en spécifiant la condition de correspondance et l’action à entreprendre en cas de correspondance.
set policy-options flowspec-attribute <> match condition <>
set policy-options flowspec-attribute < Flow Route action >
Ces configurations de stratégie recherchent des correspondances exactes ou partielles dans l’itinéraire de flux et, lorsqu’elle est trouvée, la stratégie correspond à l’itinéraire de flux. Si vous configurez plusieurs conditions de correspondance, la correspondance ne se produit que lorsque toutes les conditions sont remplies.
Vous pouvez utiliser l’option de correspondance « inverser » pour exclure une certaine condition de correspondance. Par exemple ; Dans les instructions de configuration ci-dessous, la stratégie fait correspondre les routes de flux 'sans protocole TCP, puis correspond à 'avec la valeur DSCP 'X'. Si les deux correspondances sont trouvées, la stratégie accepte les itinéraires de flux.
set policy-options flowspec-attribute fl1 invert-match protocol value tcp

set policy-options flowspec-attribute fl1 match dscp value <x>

set policy-options policy-statement pl1 term 1 from flowspec-attribute fl1
set policy-options policy-statement pl1 term 1 then accept
Configuration des stratégies pour vérifier les attributs de correspondance des spécifications de flux
Vous pouvez configurer des stratégies pour vérifier si l’itinéraire de flux correspond à la valeur spécifique d’une condition de correspondance de flux. Cela peut empêcher les routes de flux de bloquer accidentellement ou malicieusement les sessions de protocole.
Configurez l’instruction suivante en spécifiant la valeur spécifique de l’attribut.
set policy-options flowspec-attribute < match value >
Les attributs de correspondance de la stratégie de visualisation de flux spécifiques à IPv4 n’ont pas d’impact sur les routes de flux IPv6 et vice-versa.
Tableau de l’historique des modifications
La prise en charge des fonctionnalités est déterminée par la plateforme et la version que vous utilisez. Utilisez l’explorateur de fonctionnalités pour déterminer si une fonctionnalité est prise en charge sur votre plateforme.
extended-community du trafic.